

Python代码加密方案对比:混淆、Cython与Nuitka的安全性差异

在将商业项目分发给客户或部署到不受信的私有环境时,保护Python源代码是常见的工程需求。由于Python原生依靠字节码解释执行,直接分发 .py 或 .pyc 文件几乎等同于公开源码。目前主流的保护路径主要有三类:源码混淆、借助 Cython 编译成 C 扩展模块(.so / .pyd),以及使用 Nuitka 深度编译为机器码二进制。本文将直接对比这三种方案的底层防御原理、反编译门槛及实际操作方式,帮助你根据项目场景做出合理的安全技术选型。
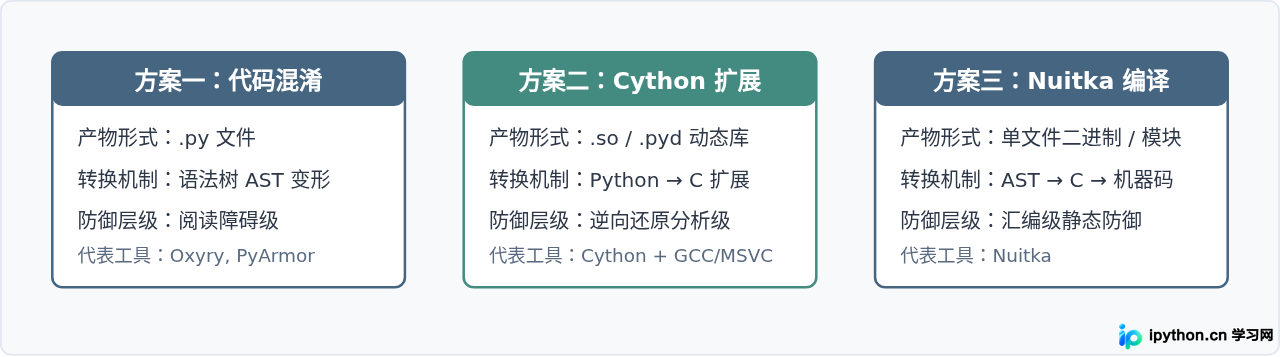
一、代码混淆(Obfuscation):门槛与脆弱点
代码混淆并不改变程序的解释执行本质,它是在源码或字节码阶段做等价变换。常见的操作包括删除注释与文档、重命名变量与函数为十六进制或无意义字符(如 _0x1a2b)、将明文字符串拆解为编码数组、以及插入不执行的死代码打乱控制流。
混淆方案的核心脆弱点在于:只要 Python 虚拟机能够执行该代码,其内部逻辑在内存中就是完全透明的。例如,攻击者无需阅读混淆后的文本,只需挂载 sys.settrace 或在运行时挂钩(Hook)全局命名空间,即可直接截获执行流程与真实参数。
ast 模块)配合自动化重命名工具,几秒内即可去除控制流平坦化以外的大部分干扰,仅能防范非技术人员直接查阅。
二、Cython 转换:将逻辑固化为 C 扩展动态库
Cython 的设计初衷是为 Python 编写高效的 C 语言扩展,但在代码保护场景下,它可以将 .py 脚本直接翻译为 .c 源码,再通过宿主编译器(如 GCC、Clang 或 MSVC)编译为平台原生二进制模块(Linux 下为 .so,Windows 下为 .pyd)。
分发给下游时,原始的 .py 文件被移除,只留下编译后的动态链接库。Python 可以直接通过 import 载入并调用该模块,使用体验与原生模块完全一致。
操作步骤:使用 Cython 批量构建动态库
假设项目根目录下存在关键逻辑模块 core_logic.py,构建流程如下:
1. 创建构建脚本 setup.py:
from setuptools import setup
from Cython.Build import cythonize

setup(
    ext_modules=cythonize(["core_logic.py"], compiler_directives={'language_level': "3"})
)
2. 在终端执行就地构建命令:
# Linux/macOS 下执行
python setup.py build_ext --inplace
3. 构建完成后会生成对应的动态库文件,例如 core_logic.cpython-310-x86_64-linux-gnu.so。此时删除中间生成的 core_logic.c 与原始的 core_logic.py,即可将动态库提供给外部调用:
import core_logic

result = core_logic.calculate_secret(10, 20)
print(result)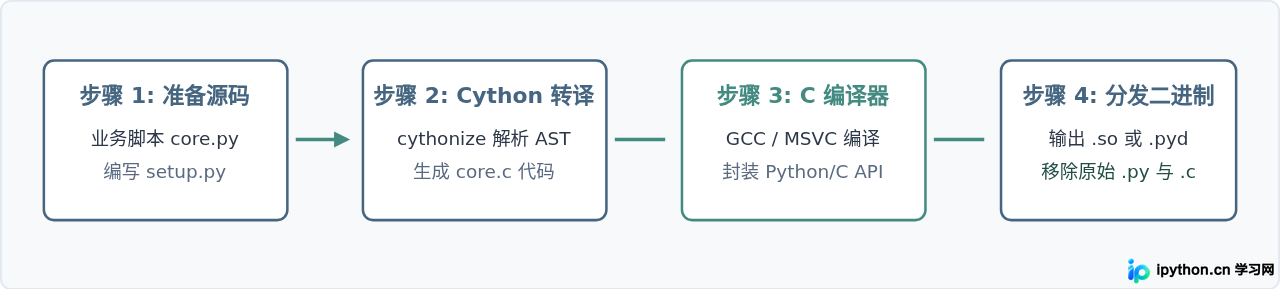
Cython 的安全性表现:逆向工程工具(如 uncompyle6、decompyle++)对 .so 文件完全失效。攻击者如果想要还原逻辑,必须在 IDA Pro 或 Ghidra 中对反汇编出的 C 代码进行静态分析。然而,Cython 翻译出的 C 代码中包含大量标准 Python C-API 的调用标记(如 PyObject_GetItem、PyDict_SetItem),函数的参数名与内部明文字符串通常仍然保存在常量池中,逆向人员可以通过分析 API 调用轨迹推断出大部分控制逻辑。
三、Nuitka:真正的 Python 机器码静态编译
与 Cython 充当扩展生成器不同,Nuitka 专注于将整个 Python 程序深度编译为原生二进制文件。它深入理解 Python 的数据模型与内置语义,不仅直接将 Python 抽象语法树(AST)重写为高效的 C 语言实现,还会执行类型推断、常量折叠与内联展开,最后调用 C 编译器输出原生的 ELF 或 PE 机器指令。
操作步骤:使用 Nuitka 编译主程序
以主入口文件 app.py 为例,Nuitka 支持生成独立运行的二进制单文件:
1. 安装 Nuitka(需预装 C 编译器,如 Linux 下的 GCC,Windows 下的 MinGW64 或 Visual Studio):
pip install nuitka2. 执行独立编译命令:
nuitka --standalone --onefile --remove-output app.py3. 编译器经过转译与优化后,会生成一个可直接执行的原生二进制文件(如 Linux 下的 app.bin 或 Windows 下的 app.exe)。
--standalone 表示打包运行时依赖环境,--onefile 会将运行时环境与已编译的二进制代码压缩到一个独立执行档中,运行时在临时目录解压执行;如果只希望保护特定算法模块,可以使用 --module 参数将其编译为模块动态库。
四、核心机制与逆向难度横向对比
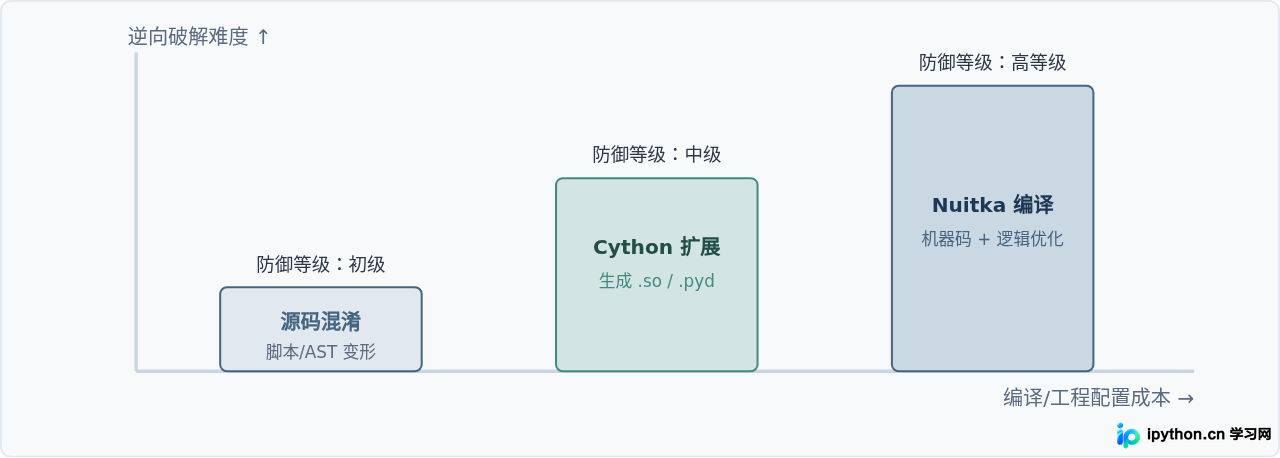
为了直观评估不同保护手段的防御边界,我们可以从源码暴露程度、依赖还原难度以及攻击者常用的破解成本几个维度进行详细比较:
| 对比维度 | 代码混淆 (如 Oxyry) | Cython 编译 (.so / .pyd) | Nuitka 深度编译 |
|---|---|---|---|
| 交付产物形态 | 文本脚本 (.py) 或字节码 (.pyc) | C 扩展动态库 (.so / .pyd) | 原生可执行文件或模块动态库 |
| 执行媒介 | 标准 Python 解释器 | Python 解释器加载 C 扩展模块 | 原生 CPU 机器码 + 嵌入式 CPython 运行时 |
| 字节码反编译 | 极易(直接提取 bytecode 并还原) | 完全免疫(无 Python 字节码结构) | 完全免疫(无 Python 字节码结构) |
| IDA / Ghidra 逆向难度 | 不适用(无原生机器码) | 中等(大量暴露的 Python C-API 调用) | 高(内联优化、常量折叠、控制流混合) |
| 运行时动态 Hook | 极易(挂钩全局变量及函数) | 较难(需对 C 导出符号或底层 API 下断点) | 极难(逻辑融合度高,符号大部分剥离) |
| 构建与维护成本 | 极低(纯文本替换,无编译依赖) | 中等(需维护 setup.py 及 C 编译器) | 较高(编译耗时较长,对第三方依赖要求高) |
五、工程落地选型与落地决策
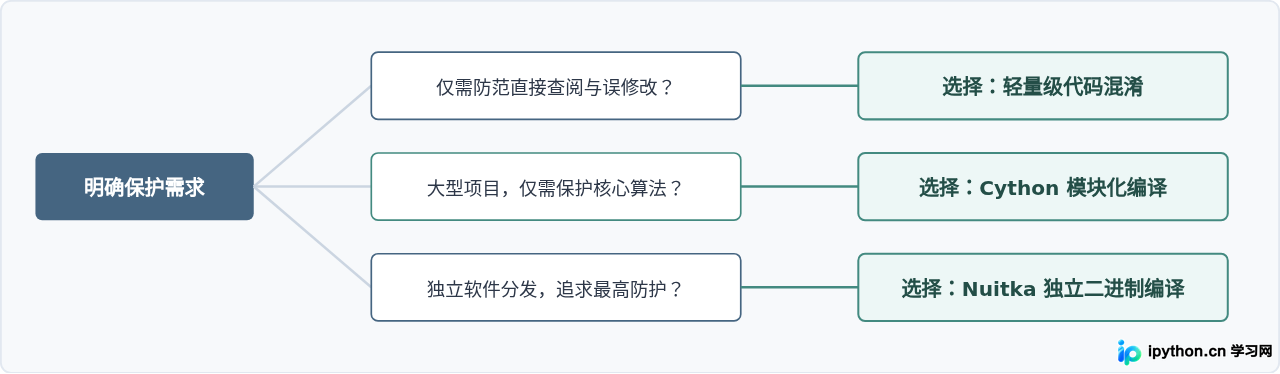
在实际生产中,追求绝对的“无法破解”并不现实,工程目标是让逆向工程的时间成本与技术成本远超代码本身的商业价值。根据软件的分发模式与工程复杂度,可以按以下策略进行选择:
- 敏捷交付或开源辅助项目:如果仅是交付轻量级运维脚本,防止普通运维人员误修改核心配置或简单查看,使用源码混淆工具是最经济的选择,无需引入 C 编译器和复杂的跨平台交叉构建流程。
- 大型工程的部分核心算法保护:对于已有庞大依赖库(如 NumPy、Pandas、TensorFlow)的项目,整包编译为单一二进制文件往往容易遭遇打包失效或动态依赖丢失。此时最优方案是模块化保护:业务胶水层仍然保持
.py,仅将授权验证模块、核心计算模块使用 Cython 编译为.so/.pyd动态库。 - 客户端独立分发或高机密算法部署:需要将完整的独立客户端软件直接发给终端客户,且不希望客户机器预装 Python 环境,或者代码中包含专利级专有逻辑时,推荐优先使用 Nuitka 进行全量编译。配合
strip工具剥离 ELF 符号表后,逆向者需要面对复杂的汇编指令流,防护强度最为稳固。
六、安全边界与加固建议
无论采用上述哪种技术,都无法在客户端做到绝对的理论安全。只要软件在用户控制的机器上运行,内存调试、API 监控与网络抓包始终是攻击者可用的手段。为了进一步提高逆向成本,建议在工程实践中配合以下防护措施:
- 移除二进制符号信息:使用 GCC 编译 Cython 或 Nuitka 时,通过参数传递
-s,或者在构建后运行strip <filename>,清除动态库中残留的调试信息与本地函数符号名。 - 关键密钥切勿硬编码:不可在代码中直接写死加密密钥、数据库连接密码或 API Token。编译为二进制文件后,使用简单的
strings命令就能一键扫描出全部明文字符串。敏感鉴权应通过服务端动态下发与非对称握手完成。 - 核心业务上云:将最为核心、涉及知识产权的模型推理或专利算法部署在己方控制的 API 服务器中,分发出去的客户端仅充当调用中介,从根本上杜绝核心资产被本地逆向的风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









