

Python文件读写操作的基础代码示例
本文系统介绍Python中文件读写操作的基础代码示例与核心原理,涵盖open函数参数、with上下文管理器、文本与二进制模式对比、逐行与批量读取性能考量及异常排查。
假设你正在编写一个自动记录系统状态的脚本,需要把当前时间写入日志文件;或者你接收到了一个由传感器导出的数据文件,需要将里面的内容读取到程序中进行统计分析。这类场景在实际开发中十分普遍。Python 内置了 open() 函数与上下文管理语法,无需安装任何第三方库,就能稳定、高效地完成本地磁盘文件的读取与保存。本文将通过简洁具体的基础代码示例,展示 Python 文件读写操作的完整步骤、常用模式与避坑要点。
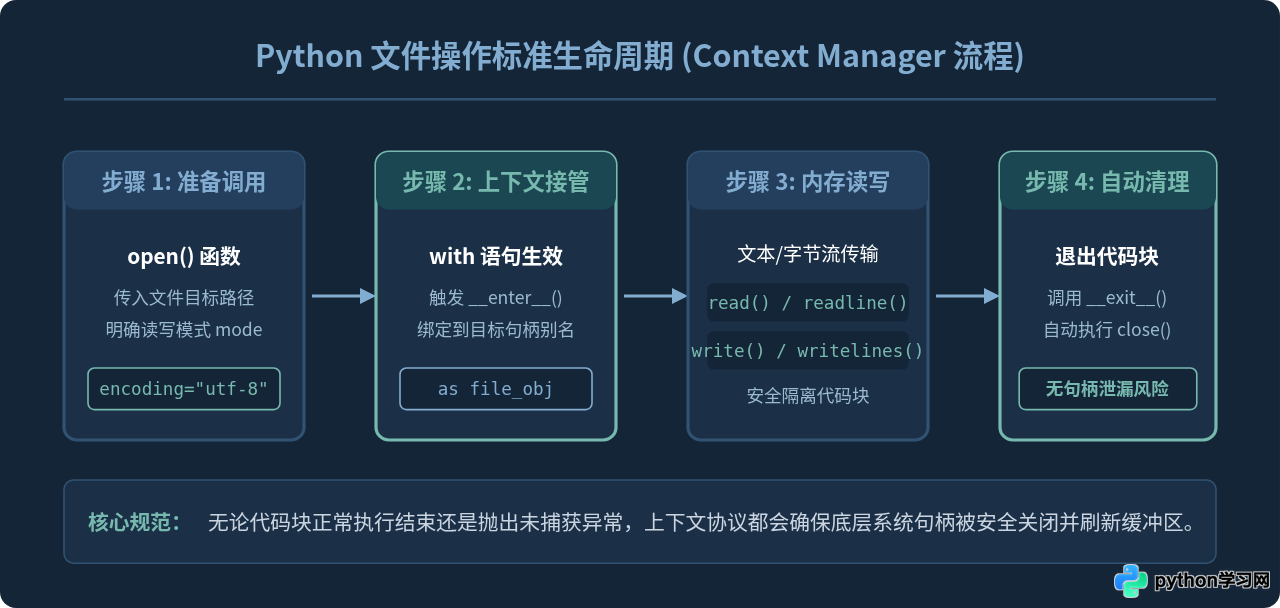
一、文件操作的标准流程与 with 语句
在 Python 中,与操作系统底层文件交互遵循固定的三步生命周期:通过路径与指定模式打开文件、执行读写交互、关闭释放系统句柄。传统做法通常显式调用 f.close(),但如果在读写过程中发生语法错误或运行时异常,程序可能会在执行到 close() 之前提前终止,导致文件句柄泄漏或写入缓冲区未及时刷盘。因此,官方推荐使用 with 语句管理文件生命周期。
1. 基础文本写入代码示例
当需要新建一个文件并写入内容时,可以使用 'w' 模式。代码如下:
# 示例:创建并写入文本文件
file_path = "example.txt"
content = "你好,Python!\n这是写入的第一条测试数据。"

# 使用 with 语句,并显式指定 utf-8 编码
with open(file_path, mode="w", encoding="utf-8") as file:
    bytes_written = file.write(content)
print(f"成功写入字符数:{bytes_written}")在上面的代码中:
mode="w":表示以只写方式打开文件。如果文件不存在,系统会自动创建;若文件已存在,其原有内容将被完全清空。encoding="utf-8":显式指定文本字符集。如果不传该参数,Python 会采用操作系统默认编码(例如在中文 Windows 上通常是 GBK),这可能导致跨平台传输时出现乱码。file.write(...):接收一个字符串并将其写入文件缓冲区,返回值是实际写入的字符数量。
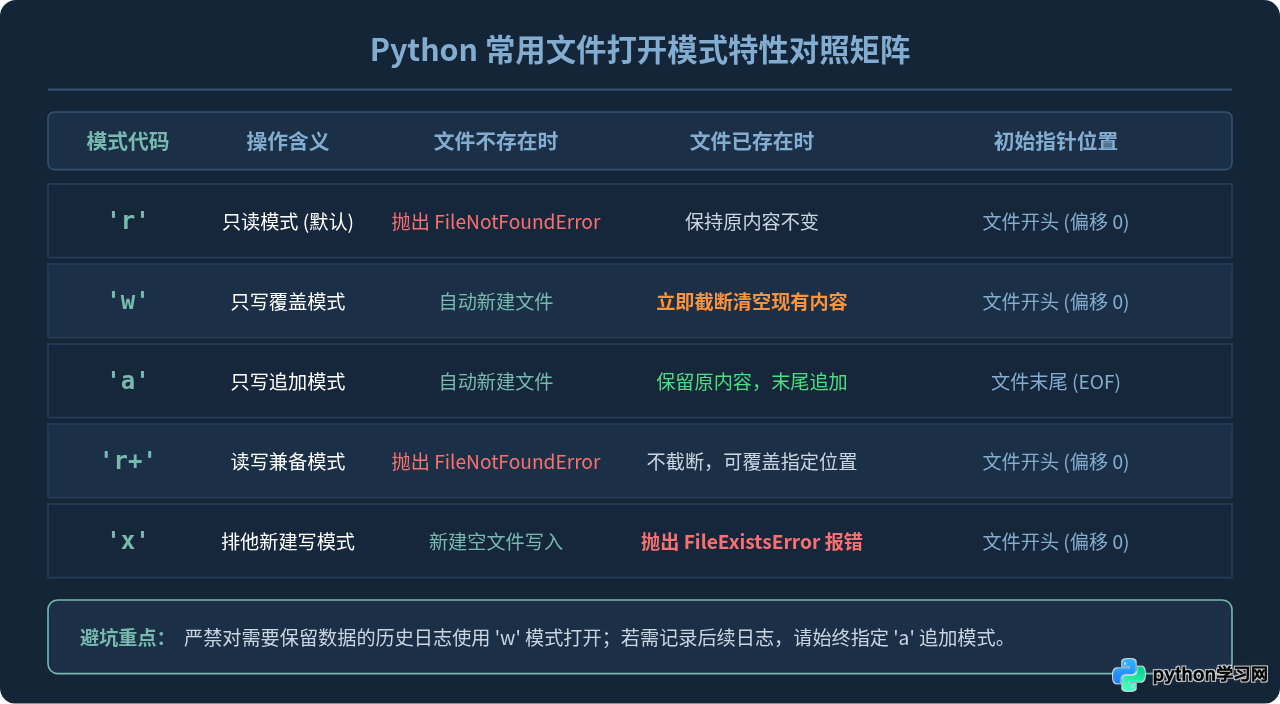
二、常用文件打开模式与读写行为对比
在调用 open() 时,mode 参数直接决定了文件的访问权限、初始指针位置以及对现有内容的处理策略。选择错误的模式可能导致历史数据被意外清空。
2. 追加写入与批量写入示例
如果希望在保留原有日志的前提下新增内容,应使用 'a' 模式;若手头有由多个字符串组成的列表,则可以使用 writelines() 进行高效写入:
# 示例:追加多行文本
log_file = "example.txt"
new_lines = [
    "\n[2026-10-17 17:00:00] 系统启动成功\n",
    "[2026-10-17 17:00:05] 网络检测正常\n"
]

with open(log_file, mode="a", encoding="utf-8") as file:
    # writelines 接收可迭代对象,但不会自动追加换行符,需手动包含 \n
    file.writelines(new_lines)

print("日志已追加完毕。")三、文本读取的三种核心方法及内存表现
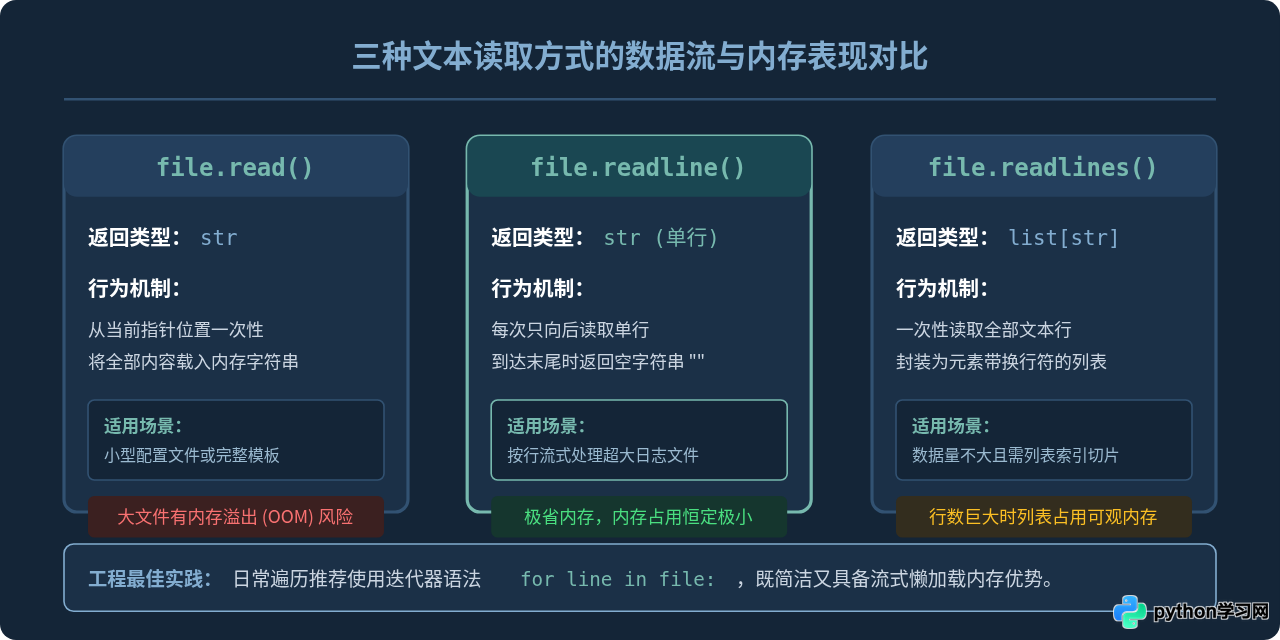
对于现有文件的读取,Python 提供了 read()、readline() 与 readlines() 三个内置方法。另外,直接遍历文件对象迭代器也是一种极其常用的手段。它们在数据返回结构和内存占用特性上存在显著区别。
3. 读取代码示例
下面分别演示一次性读取与逐行迭代读取的具体代码:
# 示例 1:一次性读取全部内容
with open("example.txt", mode="r", encoding="utf-8") as file:
    full_text = file.read()
    print("【完整内容】\n" + full_text)

# 示例 2:按行遍历(流式处理,推荐方式)
print("【逐行处理输出】")
with open("example.txt", mode="r", encoding="utf-8") as file:
    for line_num, line in enumerate(file, start=1):
        # strip() 用于去除行末原有的换行符与多余空白
        clean_content = line.strip()
        if clean_content:
print(f"第 {line_num} 行 -> {clean_content}")你好,Python!
这是写入的第一条测试数据。
[2026-10-17 17:00:00] 系统启动成功
[2026-10-17 17:00:05] 网络检测正常
【逐行处理输出】
第 1 行 -> 你好,Python!
第 2 行 -> 这是写入的第一条测试数据。
第 3 行 -> [2026-10-17 17:00:00] 系统启动成功
第 4 行 -> [2026-10-17 17:00:05] 网络检测正常
四、二进制模式与图片等媒体文件操作
当处理的文件不是纯文本(例如 PNG 图片、PDF 文档、压缩包或序列化二进制文件)时,不能使用默认的字符解码。此时必须在模式字符串中追加 'b'(如 'rb'、'wb'),并且不能传入 encoding 参数,读写的数据类型是 bytes 字节串。
# 示例:复制一张图片文件(二进制读写)
source_image = "logo.png"
target_image = "logo_backup.png"

# 以二进制只读方式读取源文件,以二进制写入方式创建备份
try:
    with open(source_image, mode="rb") as src_file:
        raw_bytes = src_file.read()

    with open(target_image, mode="wb") as dest_file:
        dest_file.write(raw_bytes)

    print(f"成功备份图片,共写入 {len(raw_bytes)} 字节。")
except FileNotFoundError:
print(f"未找到指定的源文件:{source_image}")read() 一次性读取,而应当设定分块大小循环读取:while chunk := src_file.read(1024 * 64): dest_file.write(chunk)。
五、常见异常处理与代码健壮性规范
在实际工程中,文件 I/O 极容易受到外部环境影响。例如目标文件可能不存在、当前用户无权访问该目录,或者文件使用了非 UTF-8 编码导致解码崩溃。因此,健壮的文件读写应当结合 try-except 结构精准捕获特定异常。
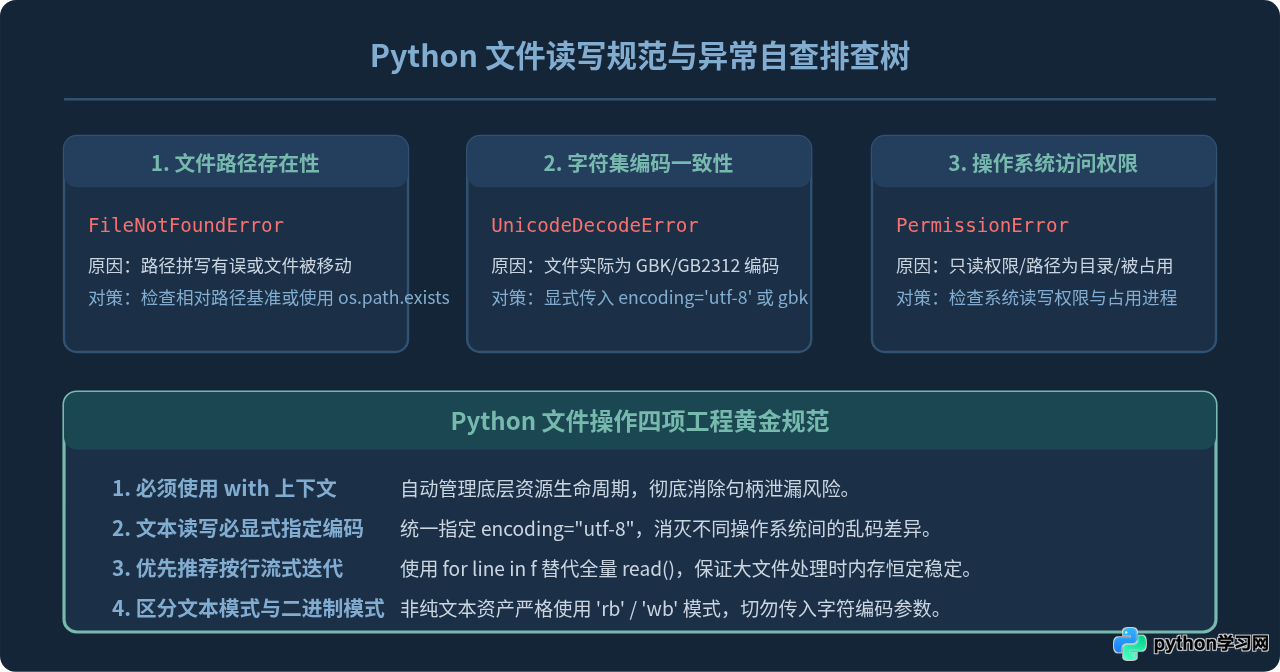
4. 完备的异常处理代码示例
结合 try-except 与 with 的标准工程写法如下:
# 示例:健壮的文件读取封装函数
def safe_read_file(target_path: str) -> str:
    """安全读取指定路径的文本文件,包含常见异常捕获"""
    try:
        with open(target_path, mode="r", encoding="utf-8") as file:
            return file.read()
    except FileNotFoundError:
        print(f"[错误] 找不到指定文件:{target_path},请核实路径。")
    except UnicodeDecodeError:
        print(f"[错误] 文件 {target_path} 不是 UTF-8 编码,尝试以 GBK 重新读取...")
        try:
            with open(target_path, mode="r", encoding="gbk") as file:
                return file.read()
        except Exception as e:
            print(f"[错误] GBK 读取仍失败:{e}")
    except PermissionError:
        print(f"[错误] 权限不足,无法访问文件:{target_path}")
    except Exception as e:
        print(f"[未知异常] 读取文件发生意外错误:{e}")
    return ""

# 执行读取测试
result = safe_read_file("non_existent_data.txt")六、总结
掌握 Python 文件读写操作的核心并不在于死记硬背 API,而在于建立清晰的生命周期与内存意识:
- 使用
with保持闭环:放弃手动的f.close(),让上下文管理器处理句柄关闭与异常安全。 - 区分
w与a模式:需要全量覆盖重写时使用w,保存连续日志或增量数据时始终使用a。 - 明确指定
encoding="utf-8":消除跨操作系统平台的文本解析乱码隐患。 - 选择适合体量的读取方式:小型配置文件可以直接调用
read(),对于未知体积或大文件,使用for line in file:迭代处理以避免内存耗尽。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









