

Python基础语法代码示例:变量、循环与函数的详细注释解析
深入解析Python基础核心语法:变量内存引用、for与while循环控制流、函数参数传递与LEGB作用域机制,提供详尽行内注释的代码示例与原理架构图。
学习编程的核心在于建立“代码指令如何驱动底层状态流转”的清晰模型。Python 以简洁著称,但表面简单的语法背后隐藏着对象引用、迭代器协议与调用栈帧等核心机制。本文紧扣变量、循环与函数三大核心要素,结合逐行详尽注释的完整代码示例与多维原理图示,帮助读者透彻理解底层逻辑并掌握高可靠的编码模式。
一、变量本质与数据类型:标签绑定与内存模型
在 C 或 Java 等静态语言中,变量常被视作特定大小的“内存盒子”,声明类型后便在固定地址中存取数据。而在 Python 中,变量并非存储数据的盒子,而是贴在内存对象上的“引用标签”(Name Binding)。
当执行赋值操作 x = 100 时,Python 解释器首先在内存堆区开辟空间创建整数对象 100,随后将变量名 x 绑定至该对象。理解这一特性是避免后续浅拷贝、可变默认参数等常见陷阱的关键前提。
# -------------------------------------------------------------------------
# 代码示例 1:变量绑定机制、类型探查与解包赋值
# -------------------------------------------------------------------------

# 1. 变量名绑定与内存地址探查
user_age = 25                   # 创建整数对象 25,并将标识符 user_age 绑定到该对象
print("user_age 值:", user_age)   # 输出: 25
print("内存地址 id:", id(user_age)) # id() 返回对象在内存中的唯一身份标识(CPython下为虚拟内存地址)
print("对象数据类型:", type(user_age)) # type() 查看运行时对象的类型,此处为 <class 'int'>

# 2. 动态类型切换:变量本身没有类型,它指向的对象才有类型
user_age = "二十五岁"            # user_age 解除与原整数对象的绑定,重新指向新的字符串对象
print("重新绑定后的类型:", type(user_age)) # 输出: <class 'str'>

# 3. 序列解包(Unpacking):一次性为多个变量绑定对应元素
coord_x, coord_y, coord_z = (10, 20, 30) # 元组元素按位置顺序对应绑定至三个独立变量
print("解包坐标:", coord_x, coord_y, coord_z) # 输出: 10 20 30

# 4. 星号表达式解包:收集剩余项为列表
head_item, *rest_items = [1, 2, 3, 4, 5]
print("首项:", head_item)        # 输出: 1
print("剩余项集合:", rest_items)  # 输出: [2, 3, 4, 5]
除动态绑定外,Python 数据类型分为两大家族:不可变对象(Immutable)与可变对象(Mutable)。不可变对象(如 int、float、str、tuple)一旦在内存中生成,其值便不能被改变;若修改变量,实际上是生成了新对象并重新贴标签。可变对象(如 list、dict、set)则支持在保持原内存地址不变的前提下“就地修改”(In-place Mutation)。
# -------------------------------------------------------------------------
# 代码示例 2:可变对象与不可变对象的赋值与引用行为对比
# -------------------------------------------------------------------------

# --- 实验 A:不可变对象(整数) ---
num_a = 500
num_b = num_a                  # num_b 与 num_a 共同指向内存中同一个整数对象 500
print("修改前 num_a 内存地址:", id(num_a))
print("修改前 num_b 内存地址:", id(num_b)) # 两者地址完全一致

num_a += 1                     # 整数不可变,该操作产生新整数 501,num_a 指向新地址
print("num_a 修改后的值:", num_a)  # 输出: 501
print("num_b 当前的值:", num_b)    # 输出: 500(原对象未受影响)
print("修改后 num_a 地址变化:", id(num_a) != id(num_b)) # 输出: True

# --- 实验 B:可变对象(列表) ---
list_origin = [10, 20, 30]
list_alias = list_origin       # 两个变量共享同一块列表内存空间
print("原始列表地址:", id(list_origin))
print("别名列表地址:", id(list_alias))  # 地址完全相同

list_alias.append(40)          # 通过别名向列表末尾追加元素,发生“就地修改”
print("原列表内容:", list_origin)  # 输出: [10, 20, 30, 40](原始变量同步受影响!)
print("别名修改后两者地址仍相同:", id(list_origin) == id(list_alias)) # 输出: True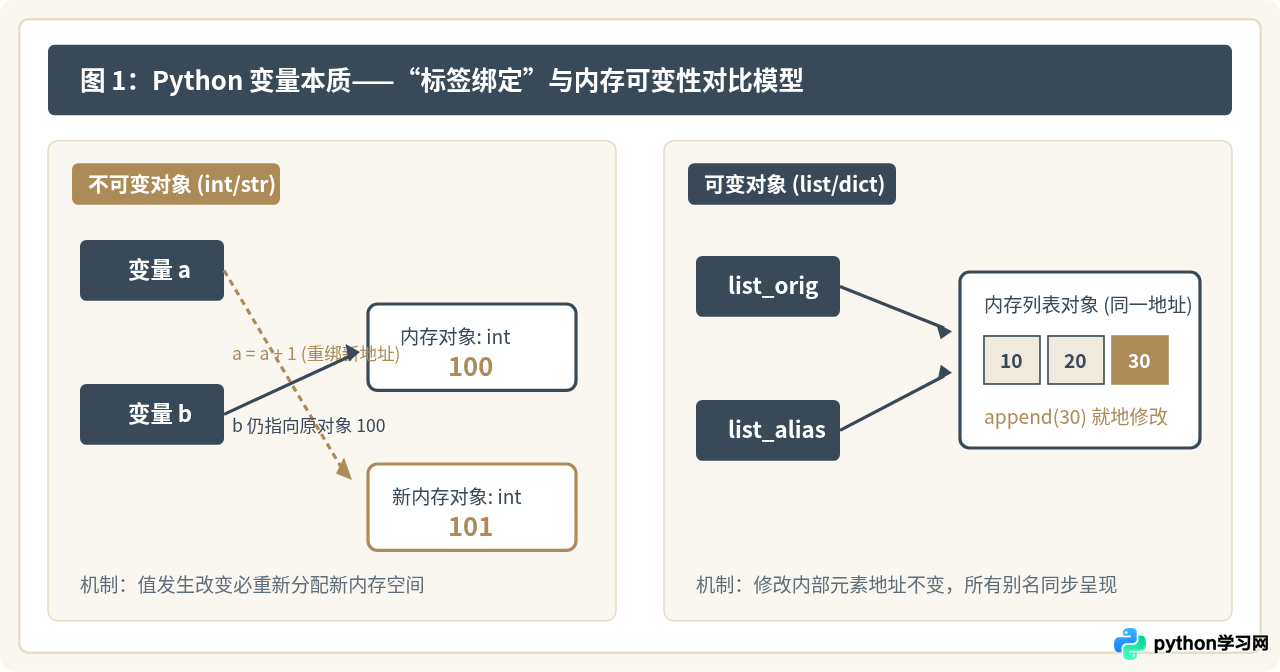
二、循环结构:序列遍历、条件迭代与跳转控制
循环是程序处理批量数据与状态轮转的骨架。Python 提供了两种基础循环模式:for 循环与while 循环。
不同于基于递增下标的传统循环,Python 的 for 循环本质是迭代器协议消费者。它依次从可迭代对象(Iterable)中提取元素,直到对象耗尽。配合 range()、enumerate() 以及 zip(),可以写出极其优雅且高效的数据遍历逻辑。
# -------------------------------------------------------------------------
# 代码示例 3:for 循环进阶遍历技巧与内置辅助函数
# -------------------------------------------------------------------------

data_scores = [78, 85, 92, 60, 99]

# 1. 基础范围迭代:range(start, stop, step) 左闭右开
print("--- 步长为 2 的数字序列 ---")
for num in range(1, 10, 2):    # 产生 1, 3, 5, 7, 9,不包含 10
    print(f"数值: {num}")

# 2. 索引与数值同时获取:enumerate(iterable, start=0)
print("\n--- 成绩列表与排位序号 ---")
for index, score in enumerate(data_scores, start=1):
    # enumerate 在每轮迭代返回一个 (索引, 元素) 元组并解包
    print(f"第 {index} 名考生成绩: {score} 分")

# 3. 多个序列并行迭代:zip(seq1, seq2, ...)
students = ["张三", "李四", "王五"]
subjects = ["数学", "英语", "物理"]
print("\n--- 多列表配对遍历 ---")
for name, subject in zip(students, subjects):
    # zip 以最短序列为截断边界,将对应位置元素打包为元组
    print(f"学员: {name} 正在考核科目: {subject}")
while 循环根据布尔条件决定是否继续循环,适用于循环轮次事先不可知、需动态检测收敛状态的场景。在两类循环中,控制流跳转由 break、continue 以及 Python 独有的 for...else / while...else 结构联合把控:
continue:立即终止当前轮次后续代码,跳入下一轮迭代或条件判断。break:强制中断整个循环体,直接跳出。else子句:仅在循环正常耗尽(即没有触发 break)时执行。常用于搜索匹配场景,省去额外设置布尔状态标志变量(flag)的麻烦。
# -------------------------------------------------------------------------
# 代码示例 4:while 边界迭代与 break / continue / else 逻辑组合
# -------------------------------------------------------------------------

# 1. while 循环安全边界控制与动态步进
countdown = 3
print("--- while 倒计时演示 ---")
while countdown > 0:           # 循环维持条件:数值必须严格大于 0
    print(f"系统启动倒计时: {countdown}")
    countdown -= 1             # 核心步进语句:必须保证条件向终止状态演进,防止死循环
print("启动完成!\n")

# 2. 循环跳转与 else 块的完整搜索机制
search_targets = [12, 45, 68, 79, 93, 105]
threshold = 70
print("--- 查找首个大于 70 的偶数 ---")

for item in search_targets:
    if item % 2 != 0:
        continue               # 遇到奇数直接跳过,本轮后续逻辑不执行,推进至下一项

    print(f"正在核验偶数项: {item}")
    if item > threshold:
        print(f">> 成功命中目标: {item} > {threshold},终止搜索!")
        break                  # 满足业务要求,强行终止循环
else:
    # 仅当整张列表遍历完毕且未触发一次 break 时执行此处代码
    print(f">> 遍历完毕,未找到大于 {threshold} 的偶数!")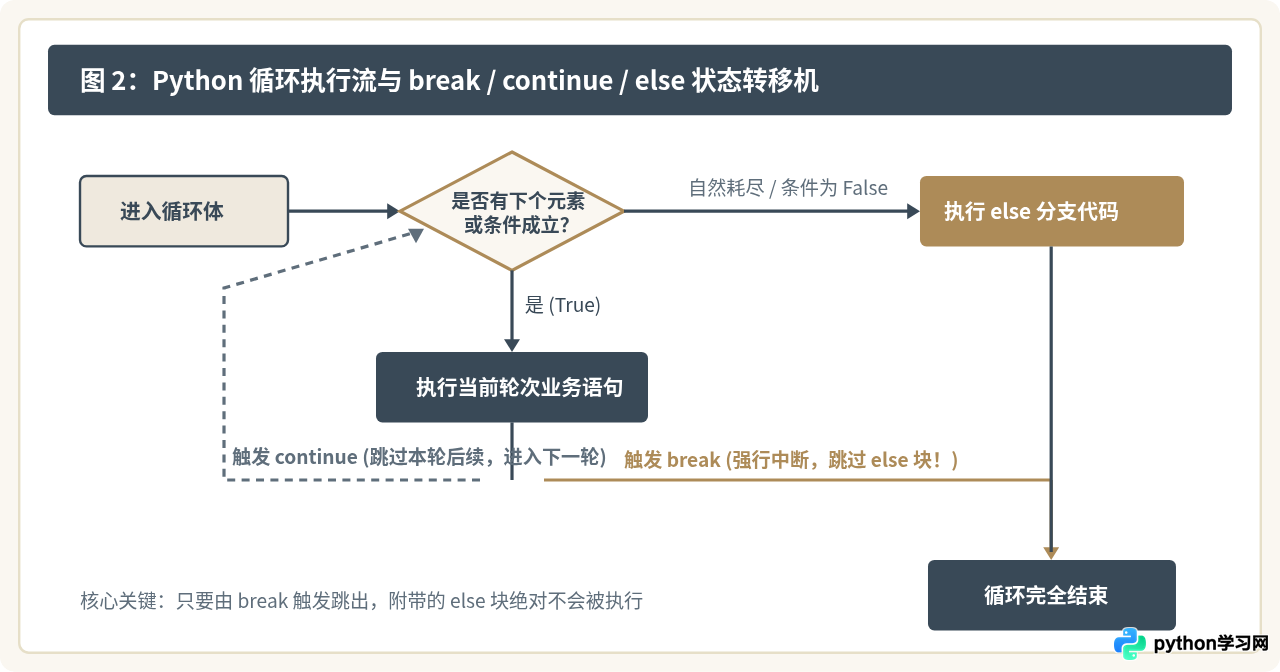
三、函数设计:参数解包、调用栈帧与 LEGB 作用域
函数是构建可维护、可复用程序的基石。在 Python 中,函数是一等公民(First-class Citizens),可以像普通变量一样被传递、赋值或作为高阶函数返回值。
Python 函数参数机制高度灵活,支持位置参数、关键字参数、默认参数,以及通过 *args 和 **kwargs 实现的可变参数打包。
def add_item(val, target=[])),该默认列表会在多次调用间被全局共享,产生意料之外的数据累积。最佳实践是使用 None 作为占位符,并在函数内部动态初始化。
# -------------------------------------------------------------------------
# 代码示例 5:多范式函数参数设计与可变默认参数的最佳解法
# -------------------------------------------------------------------------

# 1. 规范的函数定义:涵盖必选参数、默认参数、动态打包参数
def generate_order_report(title, *items, discount=0.0, **extra_metadata):
    """
    生成格式化订单报表
    :param title: 必选位置参数,报告标题
    :param items: *args 可变位置参数,收集任意数量的商品名,在函数内被打包为元组 (tuple)
    :param discount: 命名关键字默认参数,折扣比例
    :param extra_metadata: **kwargs 可变关键字参数,收集额外元数据,打包为字典 (dict)
    :return: 包含聚合信息的结果字典
    """
    # 局部计算与数据汇总
    total_count = len(items)
    summary_data = {
        "report_title": title,
        "item_list": list(items),
        "total_items": total_count,
        "effective_discount": discount,
        "metadata": extra_metadata
    }
    return summary_data

# 调用示例:灵活传参
report = generate_order_report(
    "季度采购清单",
    "固态硬盘", "4K显示器", "机械键盘",   # 自动被 *items 收集为元组
    discount=0.15,                     # 关键字参数覆盖默认值
    operator="系统管理员",               # 自动被 **extra_metadata 收集为字典项
    created_at="2026-10-17"
)
print("函数返回的汇总字典:", report)

# 2. 防御式设计:避免可变默认参数共享陷阱
def safe_append_log(message, log_history=None):
    """
    安全的消息追加函数
    若使用 log_history=[],多次调用会共享同一个底层列表;使用 None 并在运行时判断可消除隐患。
    """
    if log_history is None:
        log_history = []               # 每次调用若未传参,均独立创建全新的局部列表对象
    log_history.append(message)
    return log_history

batch_one = safe_append_log("任务 A 启动")
batch_two = safe_append_log("任务 B 启动")
print("独立批次 A:", batch_one)          # 输出: ['任务 A 启动']
print("独立批次 B:", batch_two)          # 输出: ['任务 B 启动'](两者彻底隔离)
当函数被调用时,Python 会在运行时调用栈(Call Stack)上压入一个全新的局部栈帧(Frame)。变量名称的解析严格遵循 LEGB 作用域原则:
- L(Local 局部作用域):当前函数内部声明的变量与形参。
- E(Enclosing 闭包外层作用域):外部嵌套函数的作用域。
- G(Global 全局作用域):当前模块文件最顶层定义的变量。
- B(Built-in 内置作用域):Python 预定义的内置函数与常量(如
len、range、print)。
若在函数内部试图直接修改全局变量,必须通过 global 关键字进行显式声明;若在闭包中修改外层嵌套变量,则需使用 nonlocal 声明。
# -------------------------------------------------------------------------
# 代码示例 6:LEGB 作用域查找与 global / nonlocal 穿透修改
# -------------------------------------------------------------------------

system_version = "v3.0.0"       # Global 全局作用域变量
access_counter = 0

def outer_service_builder(service_name):
    """构建闭包服务的外部函数"""
    local_worker_id = "WORKER-99" # Enclosing 闭包环境变量

    def execute_task():
        nonlocal local_worker_id # 显式声明:修改外层嵌套函数的局部变量,而非创建新局部变量
        global access_counter    # 显式声明:修改模块级全局变量

        access_counter += 1
        local_worker_id += "-ACTIVE"

        # 作用域检索演示:
        # local_worker_id 在当前为 Local;service_name 从 Enclosing 查找;
        # system_version 从 Global 查找;len 从 Built-in 查找
        print(f"[{system_version}] 正在执行: {service_name}")
        print(f"工作单元 ID: {local_worker_id}, 当前全局访问频次: {access_counter}")

    return execute_task

service_instance = outer_service_builder("数据清洗流水线")
service_instance()              # 第一次执行任务
service_instance()              # 第二次执行,闭包状态与全局状态持续保留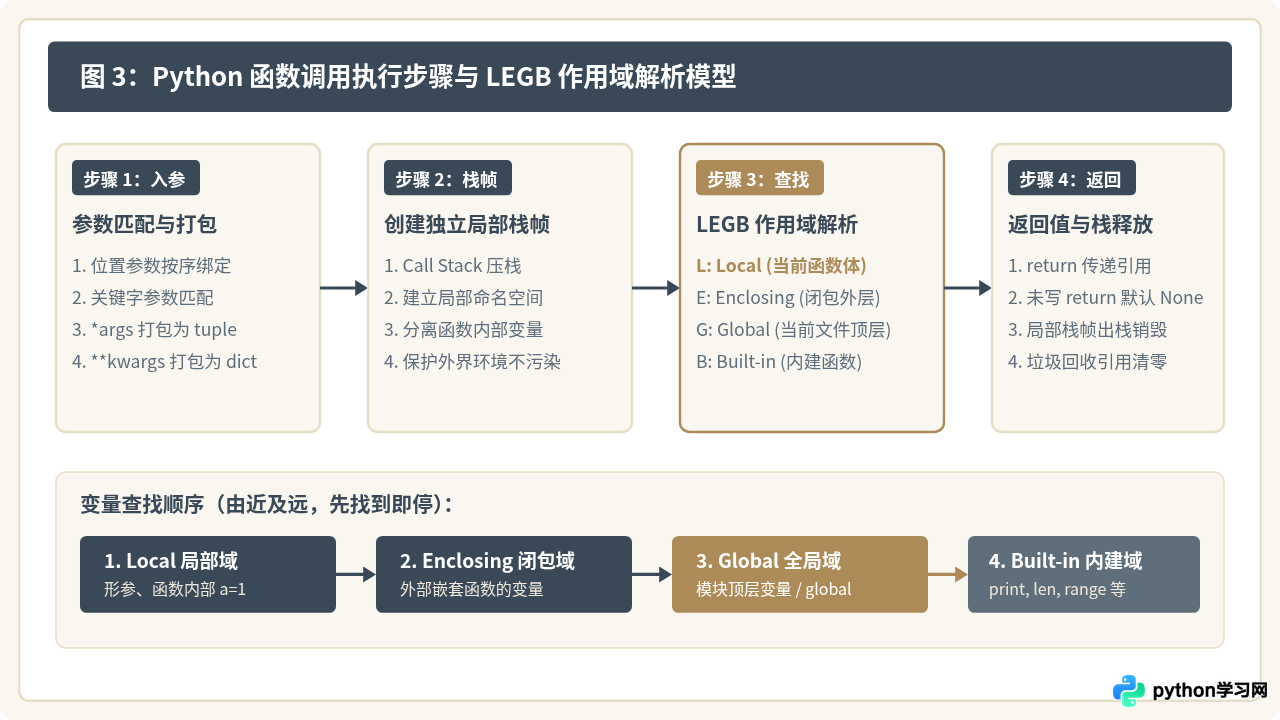
四、综合实践:变量、循环与函数的协同应用
在实际工程开发中,变量用于承载状态与缓存中间结果,循环用于遍历数据并驱动状态推进,函数则作为边界分明的业务逻辑胶囊。三者紧密配合,构成完备的业务处理单元。
下面给出一个典型场景:从包含噪声与缺失值的原始日志记录中,通过函数封装进行数据过滤、字段解析、统计计算并输出规范化结构体。
# -------------------------------------------------------------------------
# 代码示例 7:变量、循环与函数综合实战——传感器数据清洗与指标聚合器
# -------------------------------------------------------------------------

# 原始批次日志数据(模拟包含正常项、异常空项、错误类型的异构数据源)
raw_telemetry_logs = [
    {"sensor_id": "SN-01", "temp": 24.5, "status": "OK"},
    {"sensor_id": "SN-02", "temp": None, "status": "ERROR"},       # 缺失值
    {"sensor_id": "SN-03", "temp": 31.2, "status": "OK"},
    {"sensor_id": "SN-04", "temp": "INVALID", "status": "WARN"},   # 类型脏数据
    {"sensor_id": "SN-05", "temp": 28.7, "status": "OK"},
    {"sensor_id": "SN-06", "temp": 42.1, "status": "CRITICAL"},   # 高温临界
]

def analyze_sensor_cluster(logs, temp_alert_limit=35.0, require_ok_status=True):
    """
    清洗并汇总传感器监测数据

    :param logs: 待清洗的原始字典列表(可迭代对象)
    :param temp_alert_limit: 温度报警阈值,默认为 35.0 度
    :param require_ok_status: 是否仅处理 status 为 'OK' 的记录
    :return: 包含清洗后记录、均值及告警列表的汇总字典
    """
    # 1. 局部状态变量初始化(累加器与容器)
    valid_temperatures = []            # 保存有效温度数值的列表
    alert_sensors = []                 # 保存触发告警的传感器编号
    skipped_count = 0                  # 统计跳过的脏数据行数

    # 2. 循环遍历日志列表
    for index, record in enumerate(logs, start=1):
        # 提取字段
        current_id = record.get("sensor_id", f"UNKNOWN-{index}")
        status = record.get("status")
        raw_temp = record.get("temp")

        # 条件过滤:检测 status 约束
        if require_ok_status and status != "OK":
            skipped_count += 1
            continue                   # 状态非 OK,直接跳过本轮后续处理

        # 异常防护与类型判定:确保数值计算安全
        if not isinstance(raw_temp, (int, float)):
            skipped_count += 1
            continue                   # 非有效数值类型,跳过

        # 收集有效数据
        valid_temperatures.append(raw_temp)

        # 阈值对比检测
        if raw_temp >= temp_alert_limit:
            alert_sensors.append(current_id)

    # 3. 统计计算(处理极端边界:防止空列表导致除以零错误)
    if len(valid_temperatures) > 0:
        average_temp = sum(valid_temperatures) / len(valid_temperatures)
    else:
        average_temp = 0.0

    # 4. 构建结构化返回结果并交出控制权
    result_summary = {
        "total_records_received": len(logs),
        "valid_count": len(valid_temperatures),
        "skipped_count": skipped_count,
        "average_temperature": round(average_temp, 2),
        "alert_sensor_ids": alert_sensors
    }
    return result_summary

# 执行分析
analysis_result = analyze_sensor_cluster(raw_telemetry_logs, temp_alert_limit=30.0, require_ok_status=False)

# 格式化输出最终报告
print("=== 传感器遥测数据分析报告 ===")
for key, value in analysis_result.items():
    print(f"- {key}: {value}")
五、排错速查与防坑指南
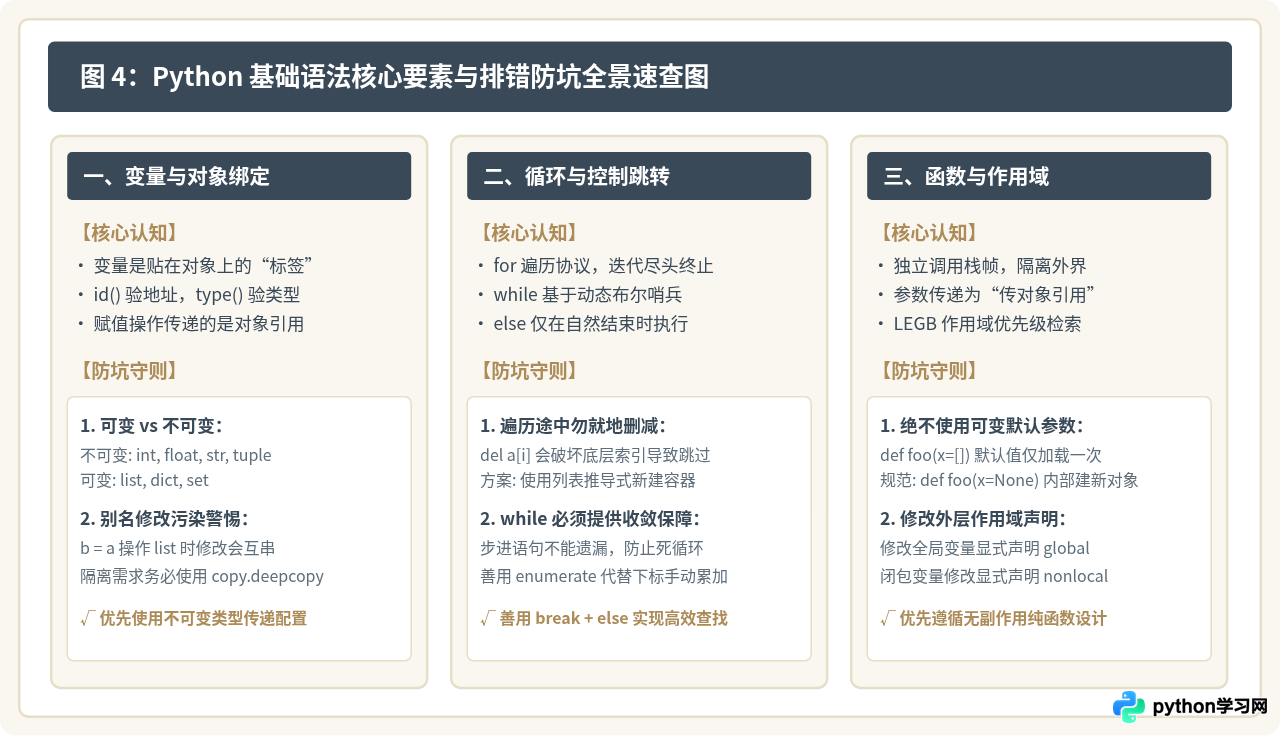
为了帮助读者在日常编码中快速排查语法与逻辑疑难,下表梳理了初学者最容易踩中的三个语法陷阱及其标准防护方案:
| 高频陷阱 | 底层发生机制 | 标准解决范式 |
|---|---|---|
| 可变默认参数跨调用累积 | def f(l=[]) 的默认列表在函数定义阶段生成且仅生成一次,多次无参调用将共享同一对象并累加内容。 |
使用 def f(l=None),在函数内部通过 if l is None: l = [] 动态初始化。 |
| 在 for 循环中就地删除列表元素 | for x in my_list 底层基于递增偏移量索引取值;删除元素会导致后续元素前移,产生漏项跳过。 |
使用列表推导式生成新列表 [x for x in l if cond],或使用切片浅拷贝 for x in l[:]:。 |
| UnboundLocalError 未绑定变量 | 在函数内部给变量赋值(如 count += 1),解释器将其标记为局部变量,导致右侧读取先于左侧赋值抛出异常。 |
若想读取并修改全局变量,在函数开头显式声明 global count;闭包则使用 nonlocal。 |
结语
写出健壮且优雅的 Python 程序,关键不在于记住多少零碎的内置 API,而在于时刻对底层运行模型保持清醒:变量是贴在对象上的标签指针,循环是驱动状态向前推进的迭代引擎,函数则是划分作用域边界与抽象职责的积木。掌握了变量引用的流向、循环跳转的判定条件以及函数栈帧的生命周期,便能从容构建出逻辑自洽、运行稳定且易于排错的高质量系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









