

Python 3.7之后字典是有序的吗?插入顺序保留机制解析
深入解析Python 3.7及之后版本字典的有序性特征。本文明确回答字典有序的具体含义,通过紧凑字典结构图解底层实现原理,解析内存优化机制,并对比普通字典与collections.OrderedDict的适用场景。
dict)在语言规范层面正式保证保留键值对的插入顺序。需要注意,这里的“有序”特指插入顺序(Insertion Order),而非按键大小自动升序或降序排列(Sorted Order)。这一特性最初在 Python 3.6 作为 CPython 的内部实现细节引入,到了 Python 3.7 则被写入语言标准,成为所有合规 Python 解释器的强制要求。
一、从无序到有序:Python 字典的演进与行为表现
在很多初学者的印象中,字典与数学中的“散列表”一样,遍历顺序是不可预测的。事实确实如此——在 Python 3.5 及更早版本中,字典的遍历顺序完全取决于哈希碰撞分布与哈希表的扩容历史,多次运行同一段代码甚至可能得到不同的键排列顺序。
自 Python 3.7 起,这一行为得到了根本性的确定。无论是在迭代键(keys())、值(values())还是键值对(items())时,取出的顺序严格等于这些键最初被写入字典时的先后次序。
# 演示环境:Python 3.7+
data = {}
data["banana"] = 3
data["apple"] = 5
data["pear"] = 2

# 遍历字典的所有键
keys_list = list(data.keys())
print("字典键序列:", keys_list)
需要特别注意一个细节:更新已有键的值不会改变其在序列中的原有位置。只有先将键显式删除(例如通过 del),再次赋值插入时,该键才会被视作新条目移动到当前字典的末尾。
# 修改已有键的值:位置保持不变
data["banana"] = 10
print("更新 banana 后的序列:", list(data.keys()))

# 删除后重新插入:条目移动至末尾
del data["apple"]
data["apple"] = 5
print("删除并重插 apple 后的序列:", list(data.keys()))删除并重插 apple 后的序列: ['banana', 'pear', 'apple']
二、底层实现原理:紧凑字典(Compact Dict)架构
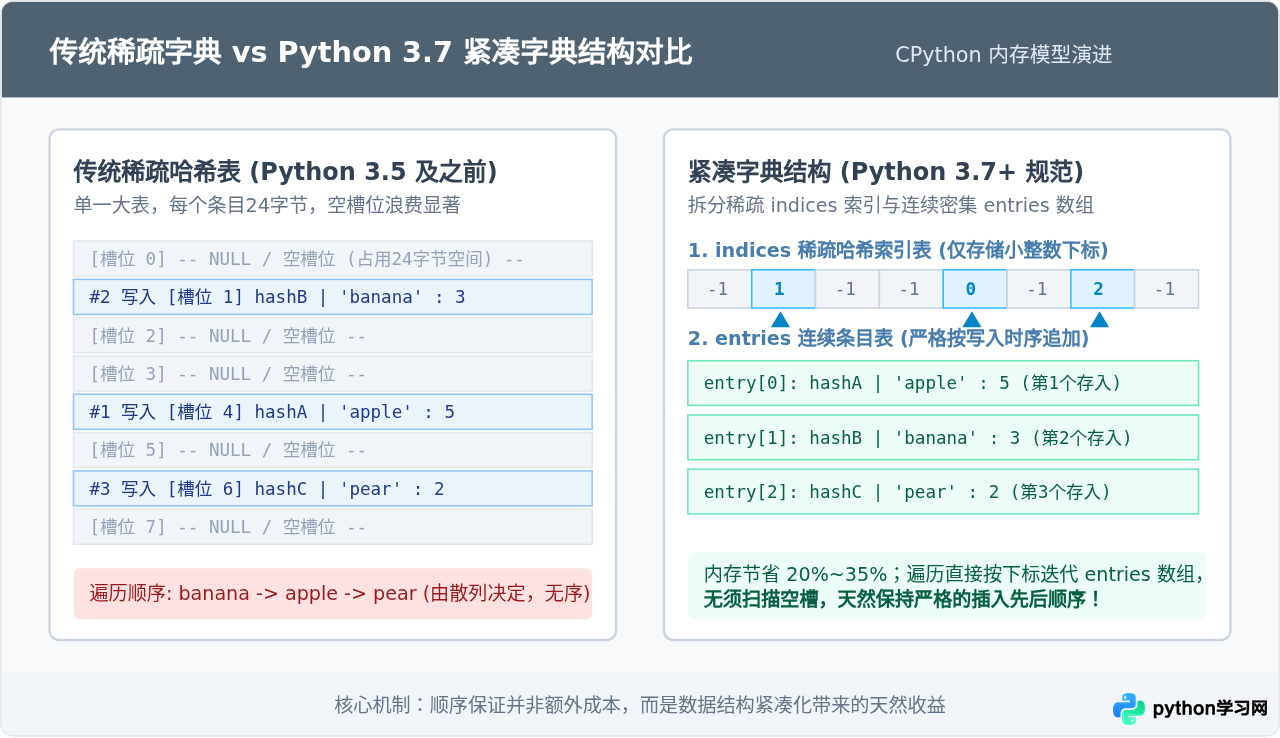
Python 官方之所以在 3.6/3.7 版本改变字典结构,最初的核心动力并非为了追求“有序”,而是为了大幅缩减字典的内存占用。这一设计源于核心开发者 Raymond Hettinger 提出的紧凑字典(Compact Dict)构想,并由 Inada Naoki 在 CPython 3.6 中正式工程化实现。
在传统实现中,字典是一个单一的稀疏哈希表(Sparse Hash Table)。每个槽位必须预留存放 [hash, key, value] 的空间(在 64 位系统上至少占 24 字节),且为了防止哈希碰撞剧烈恶化,哈希表通常保持 1/3 到 2/3 的空闲率。这意味着大量槽位处于闲置状态,造成了严重的内存浪费,且遍历时必须跳过这些空槽。
新版紧凑字典将这套结构解耦为两个相互配合的独立数组:
- indices 索引数组:一个稀疏数组,仅存放紧凑的条目下标(例如
int8或int16)。哈希取模后直接落在该数组中,空槽位仅占用 1 个字节(标记为 -1),大大降低了稀疏阵列的内存开销。 - entries 条目数组:一个连续存放
[hash, key, value]结构的密集数组。所有新插入的元素直接按顺序追加(append)到该数组末尾。
三、字典键值存取与哈希定位执行步骤
了解了双数组的设计之后,字典的具体读写过程就非常清晰了。无论是执行读取操作还是写入操作,Python 都通过固定的四步推导来完成定位。
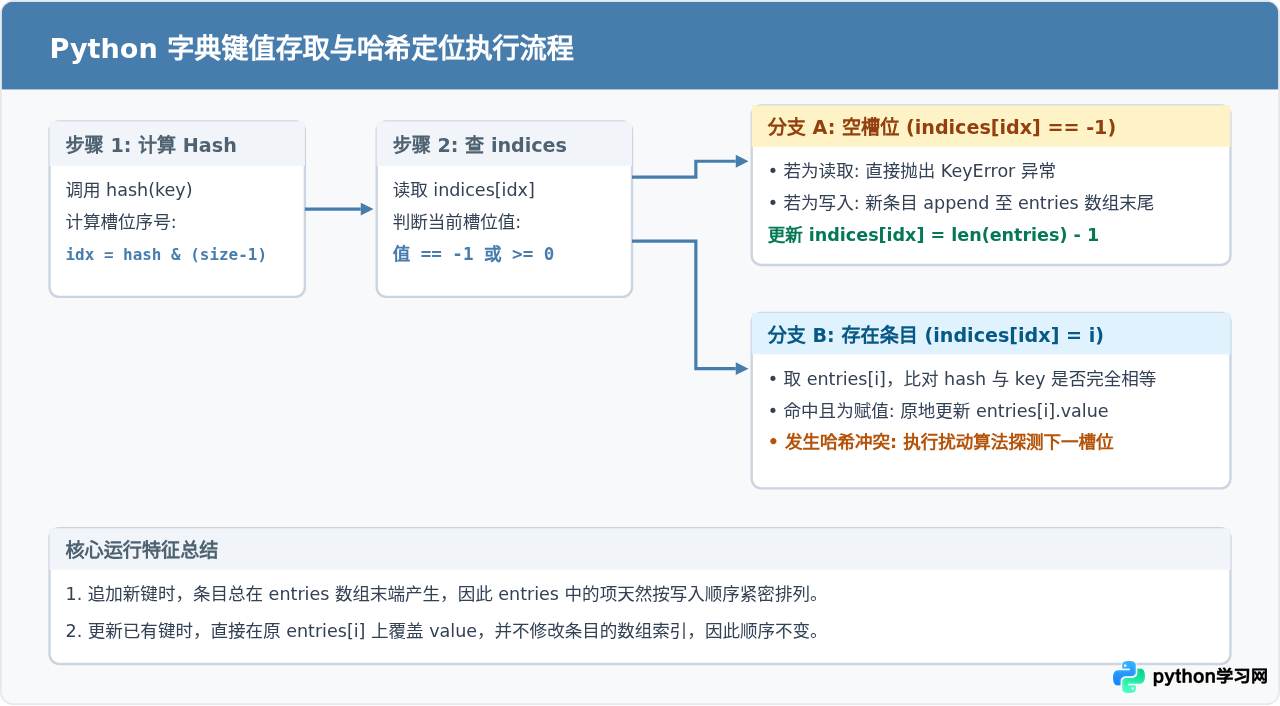
按照上述流程,每次插入全新的键值对时,该键值对都被严格追加至 entries 列表的最末位。由于后续所有循环遍历(如 for k in d:)在底层都直接顺序遍历 entries 连续数组,这就从根本上保证了遍历顺序与插入顺序完全吻合。
四、元素删除(del)与空间重构
既然 entries 是一个按顺序追加的连续密集数组,那么当开发者调用 del d[key] 移除中间某个条目时,底层是如何维护的?
如果直接将 entries 数组后续的所有元素向前平移填补空缺,虽然可以维持数组的致密性,但平移的时间复杂度将退化为 O(n),并且会导致 indices 中所有指向平移后条目的索引全部失效、需要全量更新,性能开销不可接受。
因此,CPython 采取了“墓碑标记(Tombstone / Dummy)”策略:
- 就地打标:当删除某项时,CPython 仅将对应
indices中的槽位以及entries[i]的键替换为一个特殊的“Dummy”占位符,不移动其他任何现有条目,保证删除操作依然具备O(1)的时间复杂度。 - 紧凑重构(Resizing / Compacting):只有当字典因为持续插入需要扩容,或者被删除的“墓碑”占位符累积过多时,Python 才会触发一次全量重构。在重构过程中,解释器会遍历
entries数组,剔除所有 Dummy 条目,将剩余有效条目紧密压实,并重新计算生成一套全新的indices索引。压实过程同样保持原有条目的先后顺序不变。
五、既然普通字典已有序,还需要 collections.OrderedDict 吗?
很多开发者会产生疑问:既然 Python 3.7+ 的标准 dict 已经具备了完整的顺序保留能力,标准库中的 collections.OrderedDict 是否已经过时?答案是:普通字典并不能完全替代 OrderedDict。
OrderedDict 最初在 Python 2.7 引入,它的底层基于双向链表维护次序,在设计语义和功能接口上与普通字典存在几个明确的边界划分:
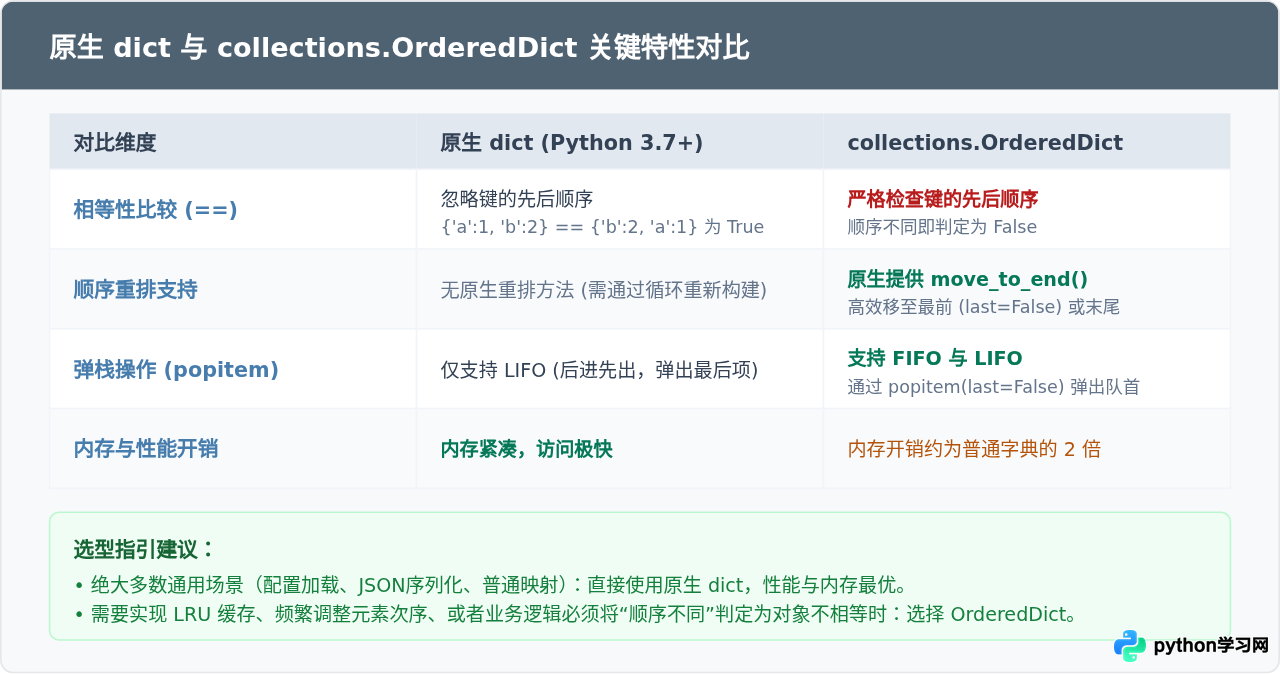
通过下面这段简短代码,可以直观看到两者在判断等价性时的关键差异:
from collections import OrderedDict

# 1. 原生普通字典:顺序不同,但内容相同,依然判定为相等
d1 = {'x': 1, 'y': 2}
d2 = {'y': 2, 'x': 1}
print("普通字典 d1 == d2:", d1 == d2)

# 2. OrderedDict:不仅比较键值,还强制检验插入次序
od1 = OrderedDict([('x', 1), ('y', 2)])
od2 = OrderedDict([('y', 2), ('x', 1)])
print("OrderedDict od1 == od2:", od1 == od2)OrderedDict od1 == od2: False
六、实践中的关键注意事项与总结
掌握 Python 3.7+ 字典的有序性特征,能让我们在日常开发中写出更加精炼、安全的代码。以下梳理了三项在开发中最易混淆的认知要点:
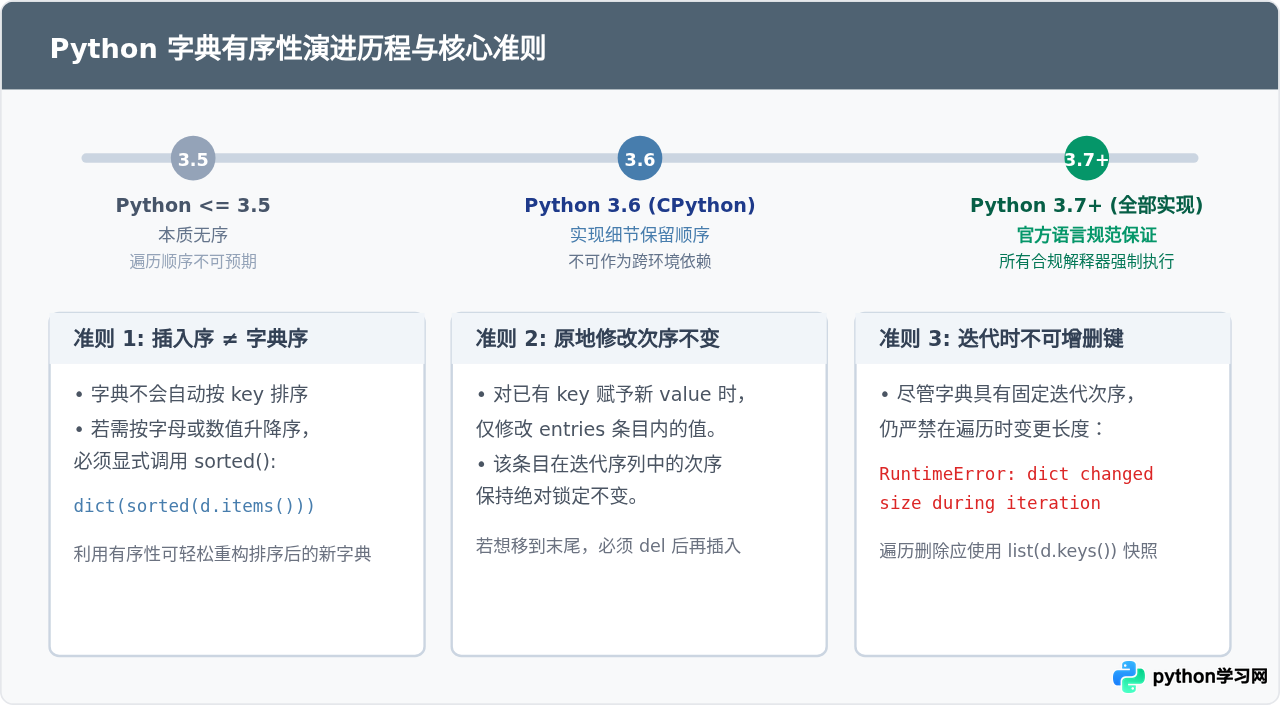
Python 3.7+ 字典的有序性是语言规范级别的保证,依赖的是“紧凑字典”分离存储 indices 索引与 entries 条目的底层架构。日常编码中,如果需要保留写入顺序、保证 JSON 键值对顺序一致或简化映射处理,可以直接信赖普通字典;只有在需要针对次序进行相等性判别、构建 LRU 缓存或频繁移位时,才需要引入 collections.OrderedDict。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









