

python函数怎么返回多个值元组

深入讲解 Python 函数如何通过逗号语法返回多个值元组、底层打包与解包机制、常见接收方式及工程实践中的避坑指南。
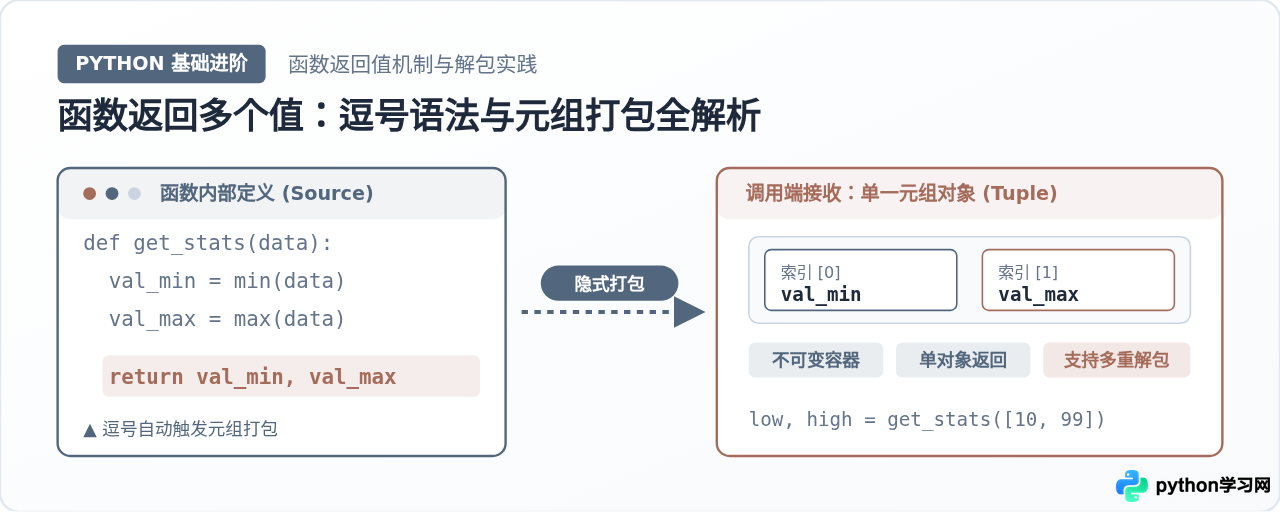
在 Python 中,函数如果需要返回多个结果,最直接且标准的方法是在 return 语句后直接列出各个变量或表达式,并用英文逗号分隔。此时 Python 会在底层自动将这些值组合封装为一个不可变元组(tuple)返回。调用该函数时,既可以把结果作为一个整体元组接收,也可以利用序列解包(Unpacking)语法,直接将各个元素分发给对应的独立变量。
一、核心语法:逗号驱动的元组打包机制
许多初学 Python 的开发者常以为返回多个值必须显式书写圆括号,例如 return (a, b)。实际上,在 Python 的语法规则中,英文逗号才是构造元组的实质运算符,外层的圆括号通常只在存在语法歧义或需要跨行排版时充当定界符。在 return 上下文里,圆括号完全可以省略。
来看一个计算两个整数“商”和“余数”的典型函数:
def divide_with_remainder(dividend, divisor):
    quotient = dividend // divisor
    remainder = dividend % divisor
    return quotient, remainder  # 逗号触发自动元组打包 (Tuple Packing)
当执行到 return quotient, remainder 时,Python 解释器在编译阶段就会将其解析为一个元组构造动作。我们可以通过内置的 type() 函数直接验证这一行为:
# 示例调用
result = divide_with_remainder(17, 5)

print("返回值内容:", result)       # 示例输出: 返回值内容: (3, 2)
print("返回值类型:", type(result)) # 示例输出: 返回值类型: <class 'tuple'>从输出中可以看到,尽管我们在函数定义时没有编写任何圆括号,result 依然是一个货真价实的 tuple 对象。这种由逗号自动组合多项数据形成元组的过程,在 Python 官方规范中称为元组打包(Tuple Packing)。
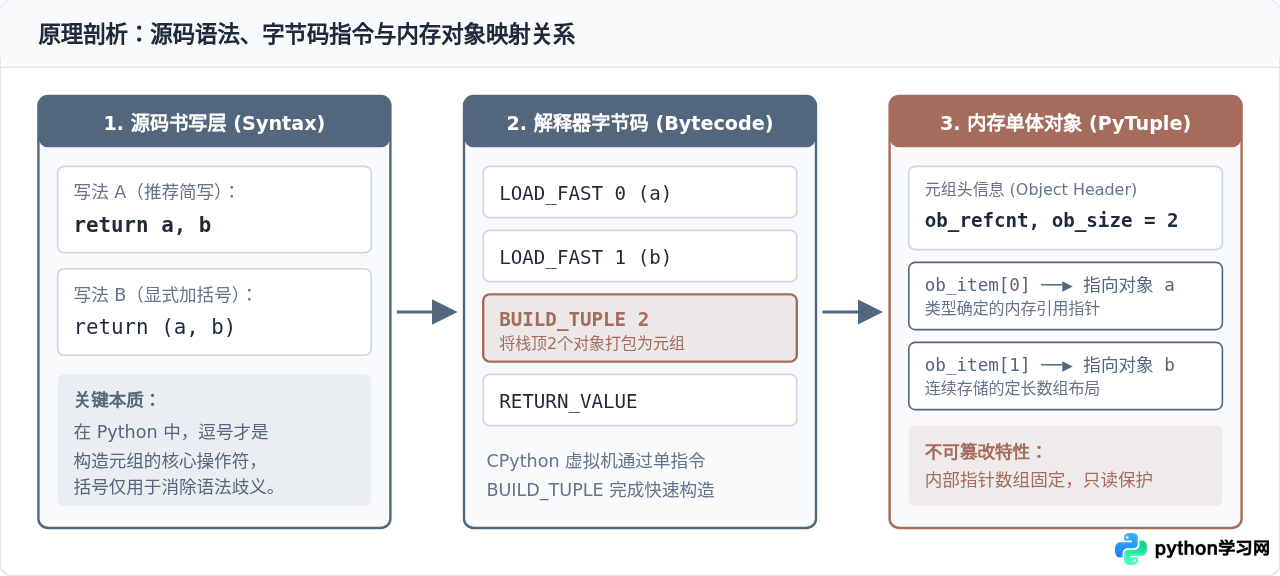
如图 1 所示,从底层的 CPython 虚拟机实现来看,无论是写 return a, b 还是 return (a, b),生成的字节码指令流均完全一致:先后执行 LOAD_FAST 将各个变量压入调用栈,随后执行一条 BUILD_TUPLE 指令在堆上分配一个定长的 PyTupleObject,最后通过 RETURN_VALUE 将该元组对象的指针返回。这意味着在性能、内存结构和运行语义上,两者没有任何差异。
二、编写与接收多值元组的完整四步流程
掌握函数返回多个值的关键,不仅在于如何在函数内部组织输出,更在于调用方如何根据实际需求以恰当的方式接收这些值。标准的操作与调用过程通常包含以下四个步骤:
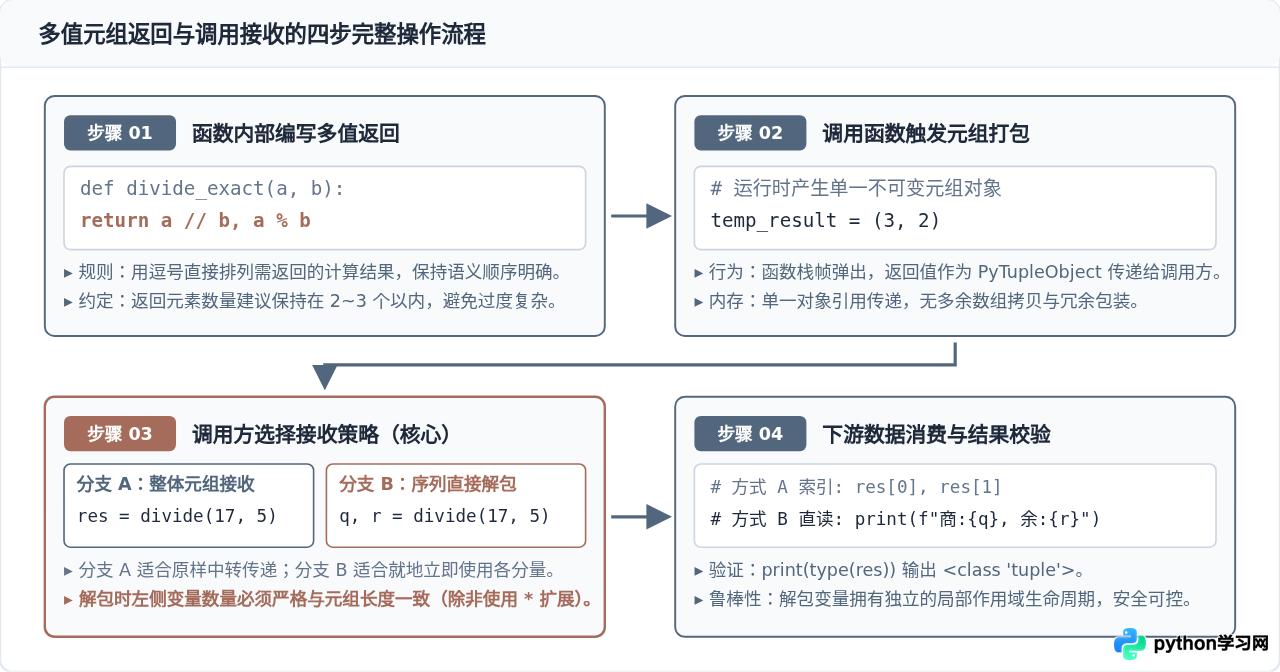
步骤 1:在函数体内定义多值返回项
在编写函数业务逻辑时,将需要输出的各项结果按固定顺序排列在 return 之后。为了保证调用方易于维护,各返回值的顺序应具备明确的业务逻辑。例如在统计分析函数中,约定按照“最小值、最大值、平均值”的顺序输出:
def analyze_numbers(numbers):
    if not numbers:
        return 0, 0, 0.0
    val_min = min(numbers)
    val_max = max(numbers)
    val_avg = sum(numbers) / len(numbers)
    return val_min, val_max, val_avg
步骤 2:执行函数触发元组打包
当调用端发起执行时,函数完成计算并退出栈帧。此时 Python 会在内存中创建并返回一个长度为 3 的元组对象。整个返回动作只传递一次单一引用,具备低开销和原子性。
步骤 3:选择合适的接收策略
在调用端,我们主要有两种接收模式可供选择:
- 策略 A(整体元组接收):使用单个变量承接整个元组,例如
stats = analyze_numbers([12, 45, 68])。这种模式适合不需要立刻拆解字段、或者需要将整个结果完整传给下一级函数的场景。 - 策略 B(序列解包接收):在赋值符号左侧使用等量的逗号分隔变量,例如
low, high, avg = analyze_numbers([12, 45, 68])。Python 会自动将元组中的各项按顺序赋给对应变量,使后续代码无需通过数字索引即可直观引用。
步骤 4:下游数据消费与结果校验
如果采用策略 A,可以通过索引下标 stats[0]、stats[1] 访问各项;如果采用策略 B,则可以直接使用变量名 low、high、avg。在实际项目中,解包接收通常是首选,因为它具备更强的自解释性,避免了“魔法数字索引”导致的维护困难。
三、元组解包的高级模式与实用技巧
除了基础的等量一一映射外,Python 还提供了多种实用的解包语法糖,帮助我们在不同业务场景下优雅处理返回的多个值。
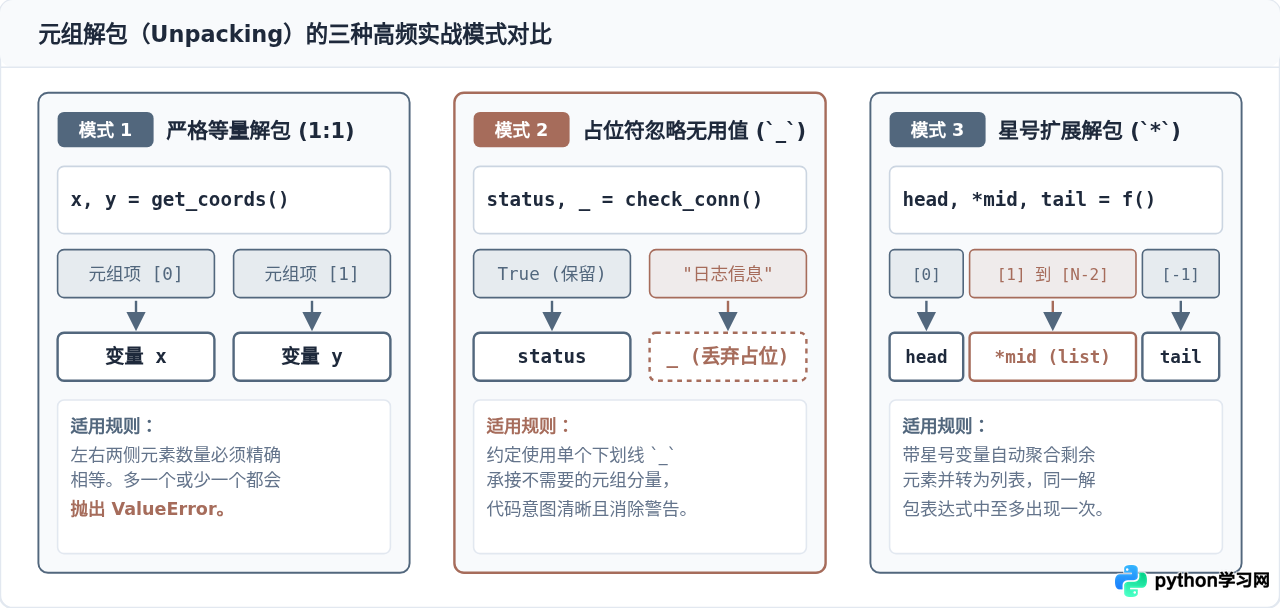
1. 模式一:严格等量解包 (1:1 Exact Match)
这是最标准的解包模式。赋值运算符左侧声明的变量数量,必须与函数返回元组中的元素个数完全相等:
def get_user_coordinates(user_id):
    # 模拟查询经度和纬度
    longitude = 116.4074
    latitude = 39.9042
    return longitude, latitude

# 严格等量接收
lng, lat = get_user_coordinates(1001)
print(f"用户经度: {lng}, 纬度: {lat}")
如果左侧变量数量与元组元素数量不一致,解释器会立即中断执行并抛出异常,这将在后文的常见问题中详细展开说明。
2. 模式二:使用占位符 `_` 忽略不关心的值
在某些场景下,函数虽然返回了多个值,但当前调用方只需要其中的某一项或某几项。如果在左侧随意定义临时变量,容易在代码静态检查中产生“未使用变量”的警告,同时也增加了阅读者的理解负担。Python 社区广泛通用的规范是使用单个下划线 _ 作为哑变量(Dummy Variable):
def execute_task(task_name):
    success = True
    elapsed_time = 0.42
    log_summary = "Task finished successfully"
    return success, elapsed_time, log_summary

# 场景:当前逻辑仅关心任务是否成功,忽略耗时与日志
is_ok, _, _ = execute_task("sync_cache")
if is_ok:
    print("任务执行成功,继续后续流程")
3. 模式三:星号扩展解包 (`*`) 捕获变长分量
从 Python 3 起,引入了扩展迭代解包(Extended Iterable Unpacking)语法。如果在某个变量名前加上星号 *,该变量就会自动聚合元组中多余的元素为一个 list(列表)。这一特性特别适合拆分首尾元素或变长返回值:
def parse_log_entry():
    # 假定返回:时间戳、多个日志参数、最终状态码
    return "2026-11-19 12:00:00", "module_a", "worker_3", "retry_1", 200

# 将首项赋给 timestamp,末项赋给 status,中间所有项聚合到 details 列表中
timestamp, *details, status = parse_log_entry()

print("时间戳:", timestamp)    # 示例输出: 2026-11-19 12:00:00
print("详细记录:", details)      # 示例输出: ['module_a', 'worker_3', 'retry_1']
print("状态码:", status) # 示例输出: 200* 变量,解释器将无法确定各个变量应容纳的元素边界,从而直接报 SyntaxError: multiple starred expressions in assignment。
四、常见陷阱与排查方法
1. 陷阱一:解包变量数量不匹配导致 ValueError
这是在接收函数返回值时最容易遭遇的运行时错误。当左侧变量数量与元组长度不吻合时,根据多与少的情况,分别会触发以下两种报错:
def get_dimensions():
    return 1920, 1080

# 错误示例 A:左侧变量过少
# w = get_dimensions()  # 这不会报错,因为这是策略 A(整体作为元组赋给 w)
# w, = get_dimensions() # 报错:ValueError: too many values to unpack (expected 1)

# 错误示例 B:左侧变量过多
# width, height, depth = get_dimensions()
# 报错:ValueError: not enough values to unpack (expected 3, got 2)排查与修复方法:确认函数的实际返回值数量。如果函数返回项数目可能动态改变,应改为使用 res = func() 接收整体元组并检查 len(res),或者采用带星号的 first, *rest = func() 进行弹性解包。
2. 陷阱二:单值误加逗号导致的“意外元组”
正如前文强调的“逗号构造元组”,如果在只打算返回单个值的语句末尾不小心多敲了一个英文逗号,函数就会悄悄返回一个包含单一元素的元组:
def calculate_tax(amount):
    tax = amount * 0.08,  # 注意末尾误输入了逗号
    return tax

result = calculate_tax(100)
print(result)        # 示例输出: (8.0,)
print(type(result))  # 示例输出: <class 'tuple'>
此时如果下游代码将 result 当作浮点数直接进行数学运算(例如 result + 10),就会立即抛出 TypeError: can only concatenate tuple (not "int") to tuple。排查这类问题时,重点检查赋值语句或 return 语句末尾是否存在多余的逗号。
五、工程最佳实践与技术选型决策
虽然返回元组在 Python 中极为简便,但并不意味着所有多值返回场景都适合使用原生元组。在实际工程项目中,随着返回值数量的增加,纯位置元组的可读性和可维护性会急剧下降。
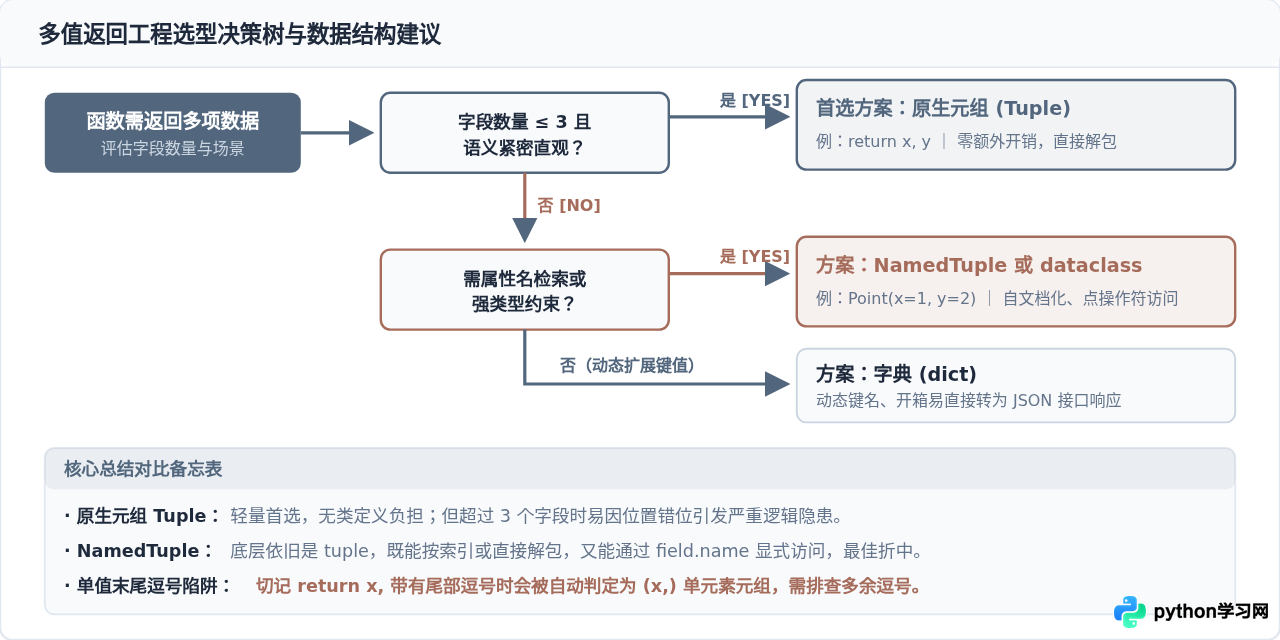
| 方案 | 典型语法形式 | 适用场景 | 主要优缺点 |
|---|---|---|---|
| 原生元组 (Tuple) | return a, b |
返回 2~3 个字段,含义紧密且不易混淆(如 x/y 坐标、商/余数) | 优点:零语法样板、性能极致、解包原生支持。 缺点:无字段名称,超过 3 个字段极易发生位置颠倒。 |
| typing.NamedTuple | class Resp(NamedTuple): ... |
返回 3 个以上固定字段,需要兼顾解包便利与字段名可读性 | 优点:保留元组轻量与解包能力,同时支持 resp.code 属性访问与类型提示。 |
| 数据类 (dataclass) | @dataclass class UserState: ... |
领域模型、复杂业务返回对象,可能包含默认值或后续扩展行为 | 优点:结构化清晰、扩展性极强、IDE 代码补全友好。 缺点:原生不支持直接序列解包(需自定义或显式转元组)。 |
| 字典 (dict) | return {"status": 200, "data": ...} |
动态字段集合、直接对接外部 REST API 或 JSON 序列化 | 优点:键值自由增减,天然兼容 JSON。 缺点:键名缺少编译期校验,容易发生拼写错误。 |
六、总结速记
要让 Python 函数返回多个值元组,只需在 return 后用逗号罗列数据(如 return a, b),Python 会自动完成元组打包;而在调用端,根据使用场景选择整体接收 res = func() 或序列解包 x, y = func()。记住以下三个核心原则:
- 逗号是元组的灵魂:圆括号是语法外壳,真正触发多值打包的是英文逗号。
- 解包数量必须对齐:严格解包要求两端数量一致,善用
_忽略冗余项,善用*捕获变长部分。 - 控制元组规模:当返回字段超过 3 个或字段含义容易混淆时,果断升级为
NamedTuple或dataclass,让代码更加清晰健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









