

Python直接输入e报错NameError?正确引用自然常数e的方法
在Python中直接输入字母e会触发NameError报错。本文详细解析报错原因、科学计数法与常数的区别,并给出使用math、numpy等标准库正确引用自然常数e的方法与最佳实践。
在Python中直接输入单个字母 e 并执行,解释器会抛出 NameError: name 'e' is not defined。这是因为Python的核心语法中并没有将 e 设为内置全局关键字或预设变量;要使用数学上的自然常数 \(e \approx 2.71828\),最直接的标准做法是通过内置数学模块 import math 并调用 math.e,或者在数值计算中使用 numpy.e。本文将从报错根源、科学计数法混淆场景,到标准引用及高精度计算方法,逐一进行排查与说明。
一、报错复现与根本原因排查
许多刚接触Python或从事数据分析的开发者,习惯了数学符号书写,会在交互式环境(如REPL或Jupyter Notebook)中直接输入表达式:
# 交互式环境执行示例
>>> e
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
NameError: name 'e' is not defined
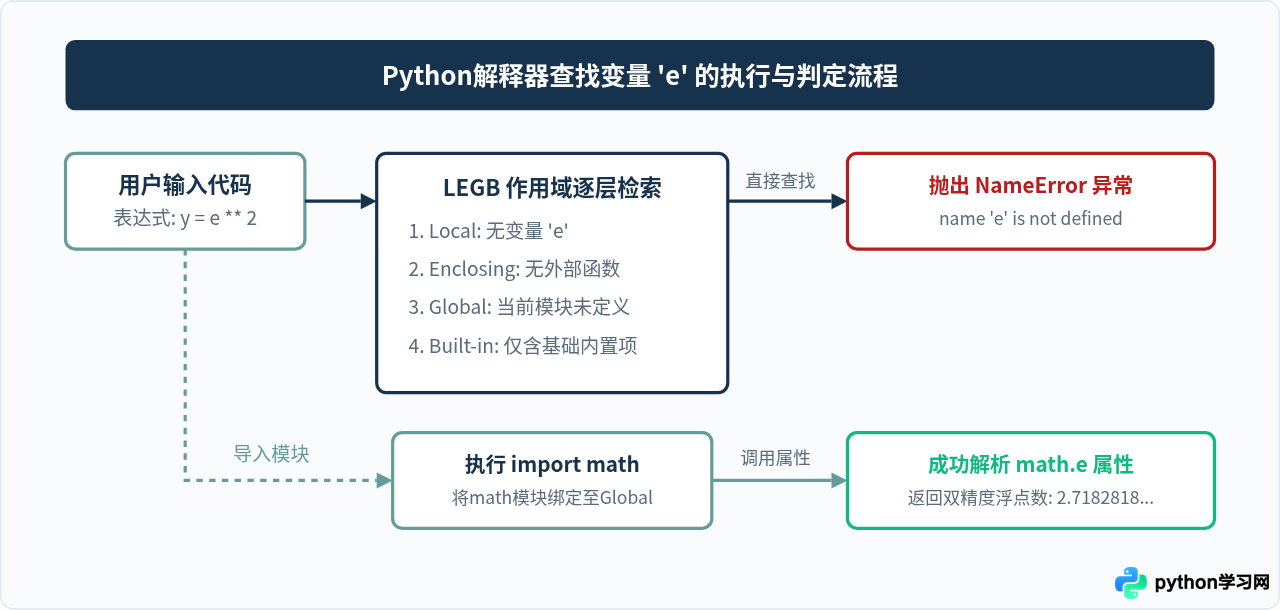
出现该报错的原因非常明确:Python的命名查找遵循 LEGB规则(Local 本地作用域 → Enclosing 嵌套作用域 → Global 全局作用域 → Built-in 内置作用域)。在最底层的内置作用域(builtins)中,只预设了如 True、False、None、print()、len() 等基础常量与函数,并没有包含像 \(e\) 或 \(\pi\) 这样的特定领域数学常数。当你在作用域中未提前定义变量 e 却尝试读取它时,解释器遍历四层命名空间均无法定位,最终抛出 NameError。
二、常见认知误区:科学计数法中的 'e' 与常数 'e'
另一个导致混淆的原因是:部分初学者在代码中见过 1e-3、2e5 等写法,因此误以为可以直接用 e 参与乘法或幂运算。
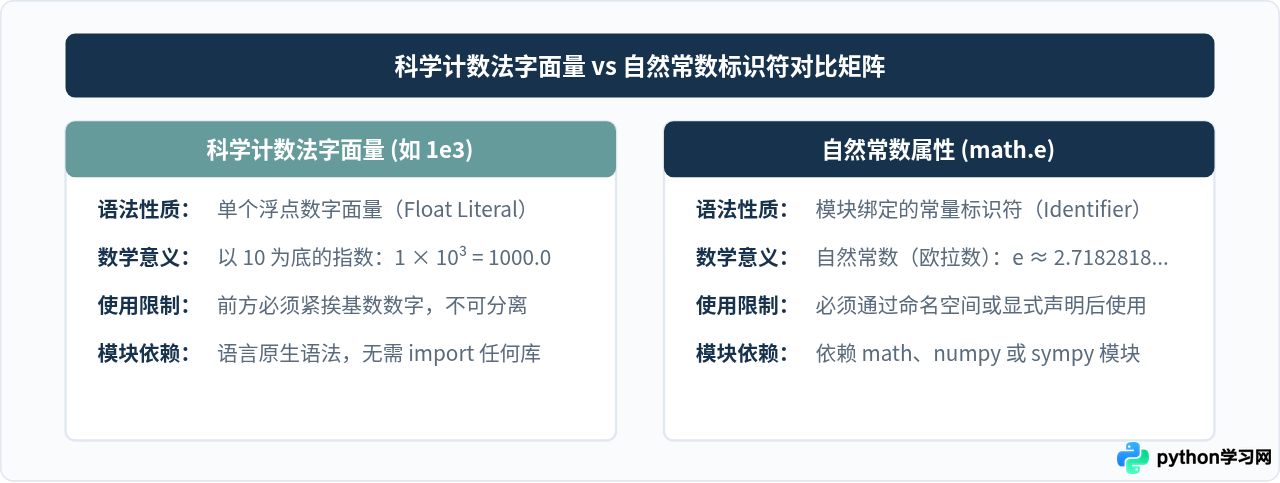
在Python词法解析器中,字母 e 或 E 紧跟在数字后面时,被解析为浮点数字面量的科学计数法指数符号(代表 \(10\) 的幂次),例如:
1e3代表 \(1 \times 10^3 = 1000.0\)2.5e-2代表 \(2.5 \times 10^{-2} = 0.025\)1e1代表 \(1 \times 10^1 = 10.0\)(注意:并不是 \(1 \times e\))
这里的 e 纯粹是数字字面量的一部分,并不代表欧拉数(自然对数的底)。脱离了前导数字单独出现的 e,只会被语法分析器视作普通变量名标识符。
三、正确引用自然常数e的标准操作步骤
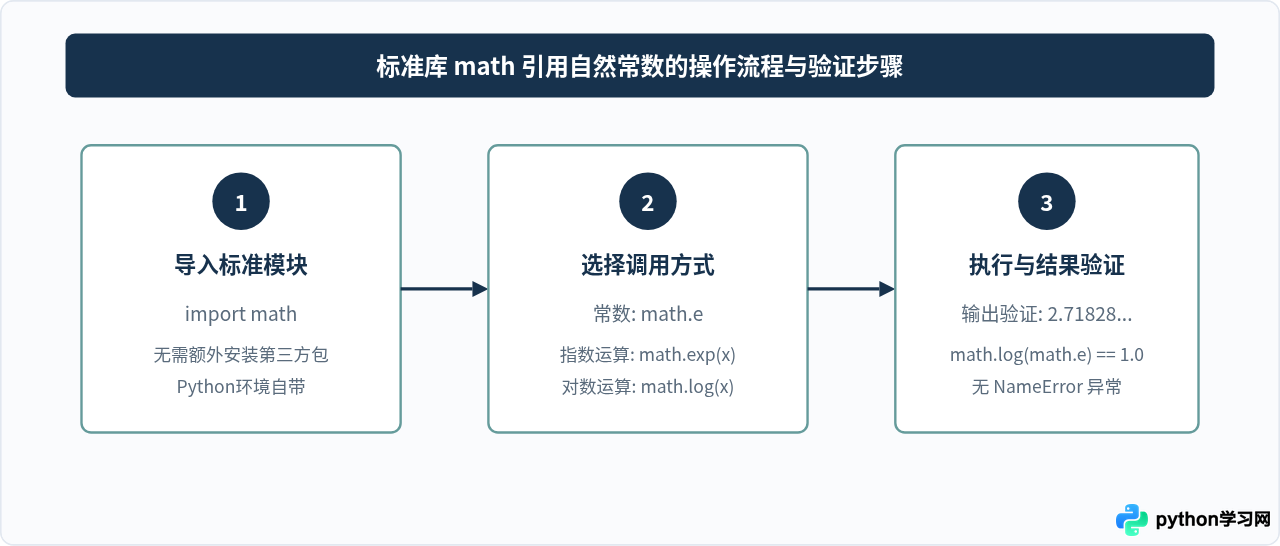
在日常开发与科学计算中,最推荐的做法是按需导入官方标准库或第三方成熟计算库。以下是具体操作流程:
方法 1:使用标准库 math.e(最通用标准解法)
Python内置的 math 模块提供了高精度的常用数学常数,不需要安装任何外部依赖。操作步骤如下:
import math

# 1. 打印常数数值
print(math.e)
# 示例输出: 2.718281828459045

# 2. 计算以e为底的自然指数 (例如 e^2)
result_pow = math.e ** 2
print("e的平方 (幂运算符):", result_pow)

# 3. 最佳实践:使用专用指数函数 math.exp(x),计算更稳定且精度更高
result_exp = math.exp(2)
print("e的平方 (exp函数):", result_exp)
# 示例输出: 7.38905609893065注意:在进行指数运算 \(e^x\) 时,推荐使用 math.exp(x) 而非 math.e ** x。math.exp() 直接利用底层 C 库的高精度算法,能有效降低多次浮点舍入带来的累积误差。
方法 2:直接导入常量名称 from math import e
如果你希望在当前文件中直接书写 e 而不需要每次前缀 math.,可以使用特定导入:
from math import e

print("直接调用:", e)
# 示例输出: 2.718281828459045
但需要提醒:在同一个代码块或循环中,如果后续将 e 误用作变量(例如 for e in elements: 或 except Exception as e:),原有的常数绑定就会被覆盖,因此大型项目中建议保留命名空间前缀 math.e。
四、科学计算与高精度场景的其他引用途径
在工程计算、矩阵运算或高精度数学建模中,还可以根据具体技术栈选用以下模块:
1. 向量化运算:NumPy (numpy.e)
处理多维数组或广播运算时,使用 numpy.e 和 numpy.exp() 可以避免逐个循环计算:
import numpy as np

# 引用常数
print("NumPy 常数 e:", np.e)

# 数组广播计算指数
arr = np.array([0, 1, 2])
print("向量化指数计算:", np.exp(arr))
# 示例输出: [1.         2.71828183 7.3890561 ]
2. 符号数学与微积分:SymPy (sympy.E)
如果是在做代数推导或符号微积分,不希望常数过早转为近似浮点数,可使用 sympy.E:
import sympy as sp

# 保持符号形式
x = sp.Symbol('x')
expr = sp.E ** x
print("符号表达式:", expr)
# 计算一阶导数,结果仍为 E**x
print("求导结果:", sp.diff(expr, x))
3. 任意高精度浮点:Decimal
在金融计量或要求数十位小数精度的物理模拟中,可以通过 decimal 模块的高精度自然对数算法动态逼近求解:
from decimal import Decimal, getcontext

# 设置计算精度为 30 位有效数字
getcontext().prec = 30
# 通过 1 的指数反解高精度 e
e_high_prec = Decimal(1).exp()
print("高精度 e:", e_high_prec)
# 示例输出: 2.71828182845904523536028747135
五、常见避坑与决策选型总结
为便于开发者在不同场景下快速做出选择,避免命名冲突与精度陷阱,下表对各类引用方式的适用环境进行了系统总结:
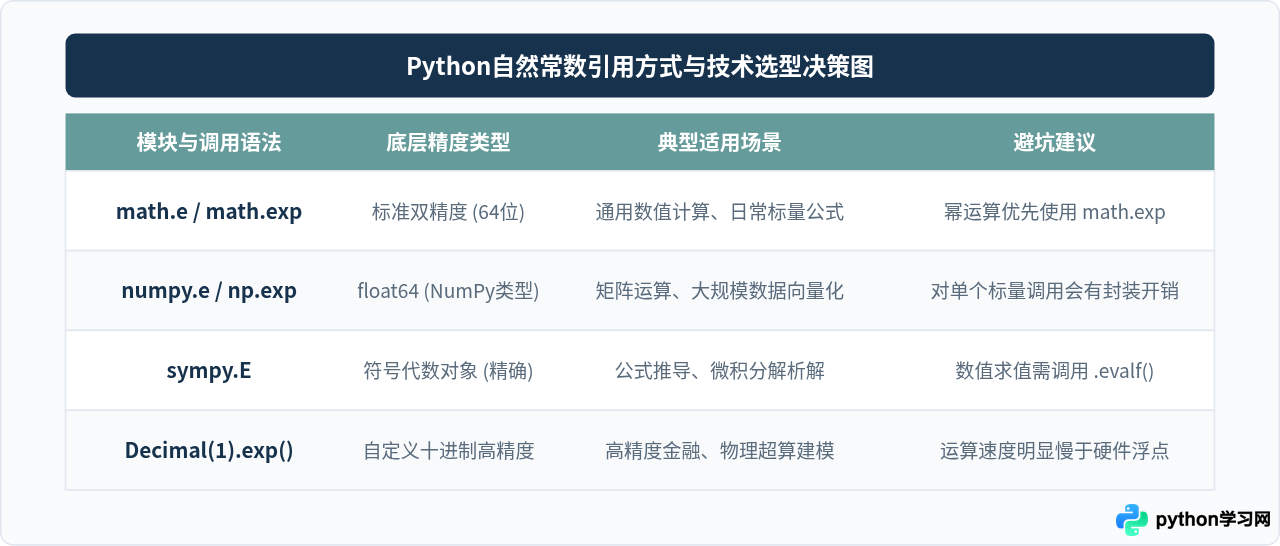
总结来说,直接输入 e 报错是因为未将其纳入当前作用域;在标准开发中,只需牢记写入 import math 并通过 math.e 或 math.exp() 调用,即可规范且高效地完成所有与自然常数相关的数学计算。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









