

python必背源代码变量交换a,b=b,a一行写法
深入解析Python经典语法a,b=b,a实现变量交换的一行写法,从元组打包与序列解包的底层机制、内存模型对比、执行步骤到实战避坑与多变量轮换,提供详尽易懂的实用讲解。
一、代码写法与基本验证
在 Python 中,如果需要将变量 a 和变量 b 的数值互换,标准的一行代码写法为:
# 准备初始变量
a = 10
b = 20

# 一行代码完成变量交换
a, b = b, a

# 验证输出结果
print(f"a = {a}, b = {b}")  # 示例输出: a = 20, b = 10
运行这段代码后,可以看到 a 的值由 10 变为 20,而 b 的值由 20 变为 10。这种写法不仅适用于数字,还完全适用于字符串、列表、字典、元组以及自定义类的实例等任何 Python 对象:
# 交换字符串与列表类型变量
x = "hello"
y = [1, 2, 3]

x, y = y, x

print(x)  # 示例输出: [1, 2, 3]
print(y)  # 示例输出: hello
很多初学者接触这一写法时往往会产生一个疑问:在普通思维中,如果先执行 a = b,那么 a 原本的值就会被覆盖丢失;为什么写成 a, b = b, a 却能毫发无损地完成安全交换?这需要了解 Python 的赋值规则与执行顺序。
二、执行过程拆解:先求值后解包
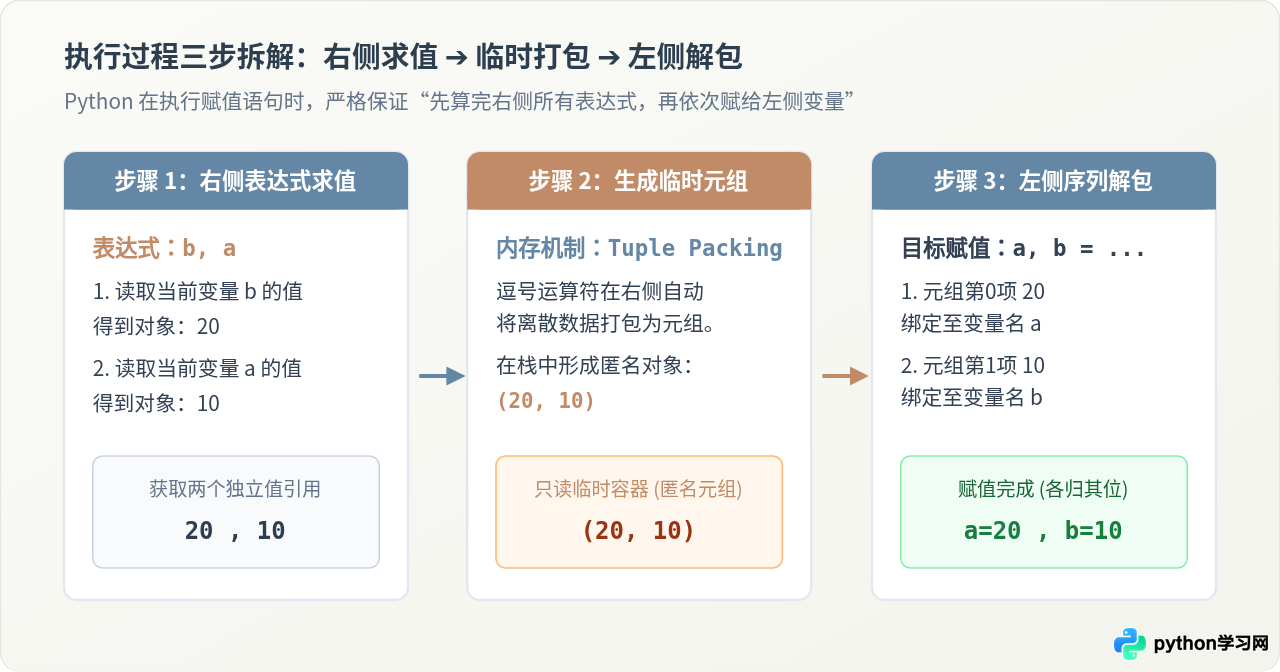
Python 解释器在执行赋值语句时,严格遵循一条铁律:先完全计算出等号右侧(Right-Hand Side)所有表达式的结果,再依次绑定到等号左侧(Left-Hand Side)的目标变量中。
对于语句 a, b = b, a,其执行过程可以清晰地划分为三个阶段:
- 右侧求值与元组打包(Tuple Packing):解释器首先读取当前环境变量
b和a的值。由于逗号在 Python 表达式中具有构建元组的作用(无需强制写括号),表达式b, a实际上创建了一个匿名的只读元组(20, 10),存放在临时执行栈中。 - 临时结构安全驻留:此时内存中保存着由原变量数据构成的临时元组对象。在这个阶段,左侧的变量尚未发生任何改变,因此即使后续给变量赋新值,也不会影响临时元组中已锁定的数据。
- 左侧序列解包(Sequence Unpacking):解释器根据左侧声明的变量顺序,将右侧临时元组中的元素按索引提取并赋值。第 0 个元素(原
b的值 20)赋给a,第 1 个元素(原a的值 10)赋给b。赋值完成,临时元组即被释放。
从字节码层面看,Python 对该操作有着极致的优化。通过标准库 dis 模块可以观察到其编译后的字节码指令:
import dis

def swap(a, b):
    a, b = b, a
    return a, b

dis.dis(swap)
在 Python 3.10 及更早版本中,该操作通常直接由一条专门的优化指令 ROT_TWO(在栈顶交换两个元素)完成;在较新的 Python 版本中,解释器会通过 LOAD_FAST 加载变量后直接进行快速解包。无论是哪种底层实现,都保证了交换操作的不可逆破坏性被完全阻隔。
三、底层机制:名字标签与引用重定向
为了更深刻地理解 Python 中的变量交换,需要认识到 Python 与 C/C++ 等编译型语言在变量本质上的巨大区别:
在 C 语言中,变量是固定大小的内存空间容器,给变量赋值意味着把数据拷贝进该内存单元;而在 Python 中,变量仅仅是贴在对象上的“标签”(或者说是对象的指针引用)。对象本身独立存在于堆内存中,变量通过引用指向这些对象。
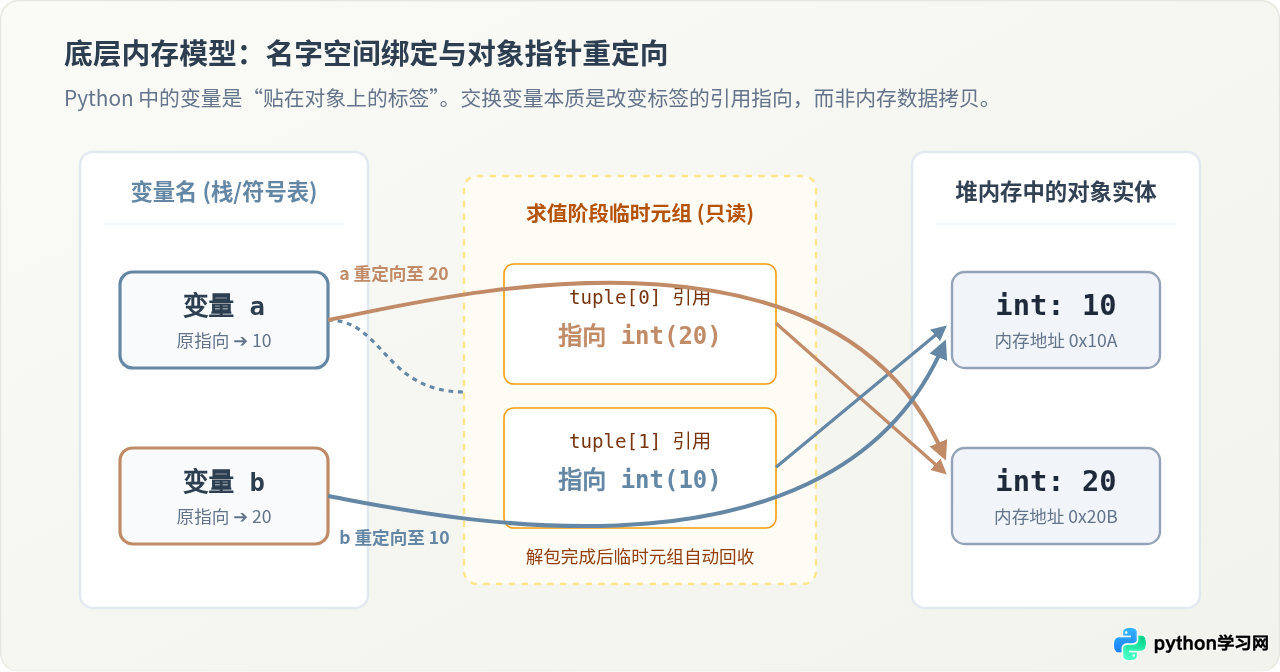
如图 3 所示:
- 执行前,栈上的变量名
a指向内存地址0x10A(整数对象 10),变量名b指向内存地址0x20B(整数对象 20)。 - 执行
a, b = b, a时,右侧构建临时引用元组(0x20B, 0x10A)。 - 解包时,变量
a撕下旧标签并贴到0x20B上;变量b撕下旧标签并贴到0x10A上。 - 整个过程中没有任何数据被拷贝,只有两组指针引用的重新定向。这也是为什么 Python 的变量交换既快又安全,且对大对象(例如包含几万个元素的列表)进行变量交换时开销极低。
四、常见交换方案对比
在实际编码中,解决变量交换通常有三种写法。下表与图 4 详细对比了它们的特性:
| 实现方案 | 代码形式 | 代码行数 | 适用类型 | 额外开销与缺陷 | 推荐指数 |
|---|---|---|---|---|---|
| Python 一行写法 | a, b = b, a |
1 行 | 所有 Python 对象 | 无命名污染,底层由解释器优化 | ★★★★★ 官方首选 |
| 传统临时变量法 | temp = a; a = b; b = temp |
3 行 | 所有 Python 对象 | 引入多余的 temp 局部变量,书写冗长 | ★★★☆☆ 不够优雅 |
| 加减算术 / 异或运算 | a = a + b; b = a - b; a = a - b |
3 行 | 仅限整数/数值 | 字符串或列表直接报错,浮点数损失精度,极难维护 | ★☆☆☆☆ 严禁使用 |
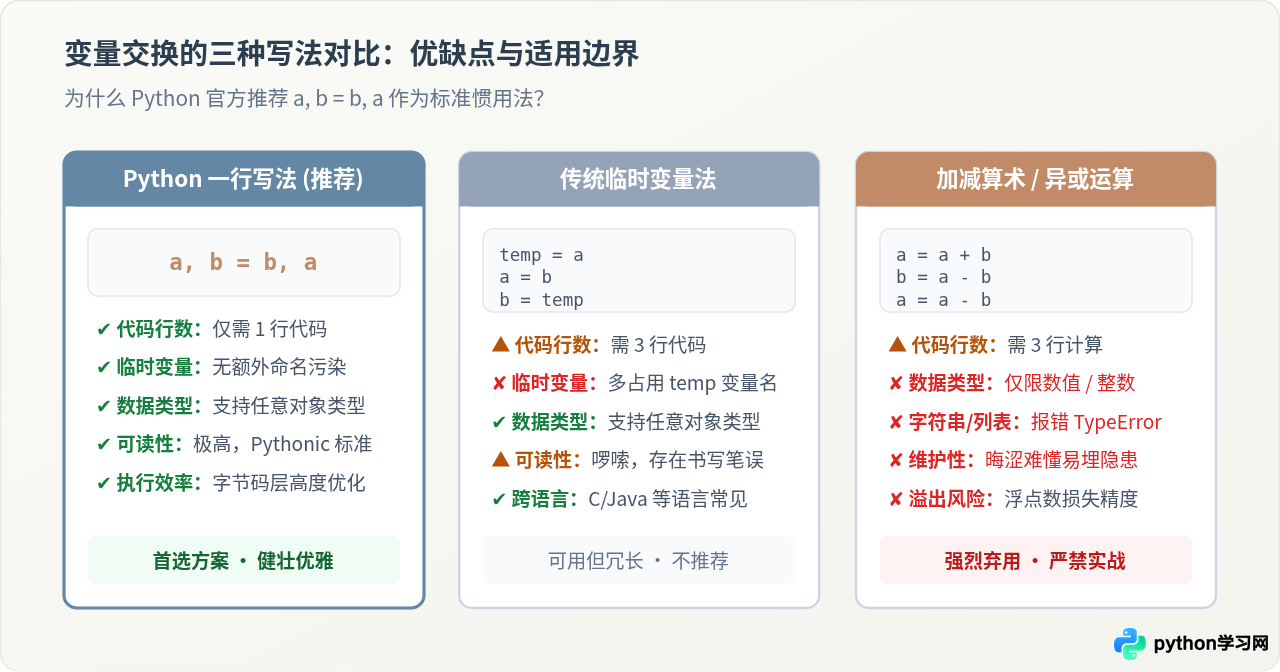
在许多低级语言面试题中,常常要求“不使用临时变量交换两数”,于是催生了 a = a ^ b 等巧妙写法。但在 Python 中,这种“炫技”写法不仅无法发挥作用,反而会破坏代码的通用性与安全性:
s1 = "foo", s2 = "bar"),执行 s1 - s2 会立即抛出 TypeError: unsupported operand type(s) for -: 'str' and 'str'。因此在 Python 中,唯一标准、安全且推荐的做法就是 a, b = b, a。
五、拓展应用与经典避坑场景
掌握了 a, b = b, a 的本质之后,我们可以将这一思路延伸到日常算法和数据结构的各类实战场景中。
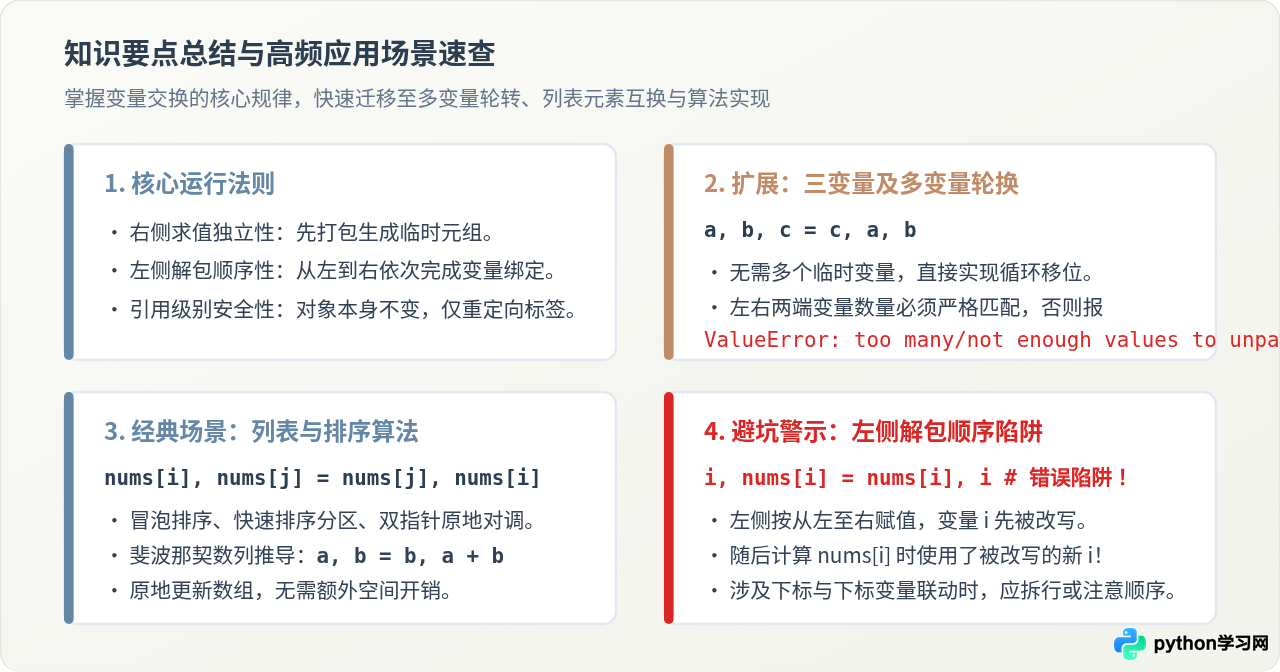
1. 多变量循环轮换
元组解包不仅限于两个变量,支持任意数量变量的并行赋值与位置轮换:
# 三个变量循环右移:a -> b, b -> c, c -> a
a, b, c = 1, 2, 3
a, b, c = c, a, b

print(a, b, c)  # 示例输出: 3 1 2
如果使用传统临时变量法,三个变量的轮转需要至少两个临时变量且极易写错对应关系,而一行写法逻辑直观且绝不会产生覆盖失误。
2. 列表原地元素互换(排序算法必备)
在冒泡排序、快速排序或双指针反转列表中,经常需要交换数组中两个指定索引的值:
nums = [10, 20, 30, 40]

# 对调下标 0 和下标 3 处的元素
nums[0], nums[3] = nums[3], nums[0]

print(nums)  # 示例输出: [40, 20, 30, 10]
3. 斐波那契数列生成
在计算斐波那契数列时,每次迭代都需要将当前数推进到下一项,这行语法能将状态转移压缩为纯粹的数学表达:
# 生成前 10 个斐波那契数
a, b = 0, 1
fib_sequence = []
for _ in range(10):
    fib_sequence.append(a)
    a, b = b, a + b  # 同时更新 a 为原 b,更新 b 为两者之和

print(fib_sequence)  # 示例输出: [0, 1, 1, 2, 3, 5, 8, 13, 21, 34]
4. 避坑指南:左侧解包顺序引发的索引联动陷阱
虽然右侧表达式是完全求值打包的,但是左侧解包是按照从左到右的顺序逐一赋值的。当左侧变量之间存在联动依赖关系时,必须格外小心:
# 典型错误陷阱示例:
i = 0
nums = [10, 20]

# 假设原意是交换 i 与 nums[i]
i, nums[i] = nums[i], i  # 潜在危险代码!
在这段代码中:
- 右侧
nums[i], i求值得到临时元组(10, 0)。 - 左侧首先将 10 赋给变量
i,此时i的值已经变为 10! - 接着执行第二个赋值目标
nums[i] = 0,此时访问的是nums[10],直接触发IndexError: list assignment index out of range。
nums[i] 与 i),应调整书写顺序,确保下标表达式先赋值(例如 nums[i], i = ...),或者直接拆解为独立语句,避免执行顺序错乱带来的隐蔽 Bug。
六、总结
a, b = b, a 是 Python 语言中最具代表性的“Pythonic”(符合 Python 哲学)代码片段之一。它利用了语言本身的元组自动打包(Tuple Packing)与多重序列解包(Sequence Unpacking)特性:
- 核心保障:等号右侧完全求值并暂存于执行栈,隔绝了覆盖风险;
- 本质过程:对象指针引用的快速重定向,不涉及内存数据深拷贝,轻量高效;
- 编码习惯:无中间变量污染,代码清晰优雅,跨类型通用性极佳。
牢固掌握这一原理,不仅能帮助读者写出简洁稳健的代码,更为深入理解 Python 的数据模型、函数多返回值传递以及生成器推导奠定了扎实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









