

Python列表与字典操作函数汇总:增删改查常用方法
全面汇总Python列表(list)与字典(dict)的增删改查核心内置方法,配合底层原理、时间复杂度分析与操作流程图,帮助开发者快速掌握高频数据结构操作。
一、列表(List)常用增删改查操作汇总
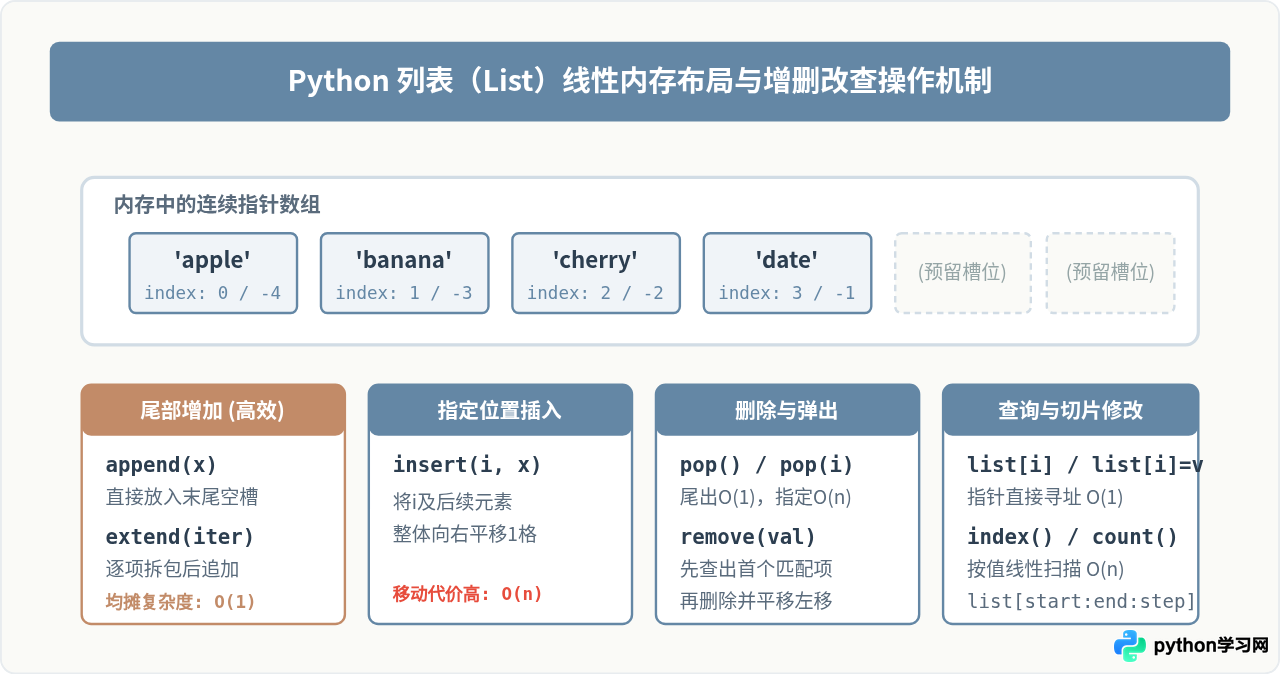
Python 列表是基于连续内存地址实现的动态数组(Array of Pointers)。其每个槽位存储的是指向 Python 对象的指针。因为支持双向索引与动态扩容,列表在尾部操作时效率极高,而在中间或头部插入、删除时需要移动后续元素。
1. 列表增加操作(Create / Add)
向列表中添加新元素有三种最常用的内置方法,以及一种切片方式:
append(x):将元素x作为一个整体直接追加到列表末尾。均摊时间复杂度为O(1)。extend(iterable):接收一个可迭代对象,将其内部的所有元素逐一提取出来追加到列表末尾。与加法赋值运算符+=等价。insert(index, x):在指定索引index前插入元素x。若index为 0,表示在表头插入。此操作需要将该索引之后的所有元素向后移动一位,时间复杂度为O(n)。- 切片赋值追加:
lst[len(lst):] = [x, y]效果同extend。
# 示例:列表增加元素
fruits = ['apple', 'banana']

# 1. append 追加单一元素
fruits.append('cherry')
# 结果: ['apple', 'banana', 'cherry']

# 2. extend 追加可迭代对象的每个元素
fruits.extend(['date', 'elderberry'])
# 结果: ['apple', 'banana', 'cherry', 'date', 'elderberry']

# 3. insert 在指定索引处插入元素
fruits.insert(1, 'blueberry')
# 结果: ['apple', 'blueberry', 'banana', 'cherry', 'date', 'elderberry']append() 传入一个列表 [1, 2],它会将整个子列表当成一个单一元素加入;而 extend([1, 2]) 则会展开该列表,将 1 和 2 分别作为独立元素并入。
2. 列表删除操作(Delete / Remove)
根据删除的依据(按值删除、按索引删除、弹出返回值、清空整个列表),Python 提供了不同的函数与语句:
remove(value):从左向右搜索列表中第一次出现的value并将其移除。如果指定值不存在,会直接抛出ValueError。pop([index]):移除并返回指定索引位置的元素;如果不指定index,默认弹出末尾元素(index=-1)。末尾弹出为O(1),中间弹出需要前移后续元素为O(n)。若列表为空或索引越界,抛出IndexError。del lst[index]或del lst[start:end]:Python 内置语句,根据索引或切片区间直接从内存中删除元素,不返回被删除的值。clear():移除列表中的所有元素,使其变为长度为 0 的空列表,保留原列表对象的内存引用。
# 示例:列表删除元素
nums = [10, 20, 30, 20, 40]

# 1. remove:删除首个匹配项
nums.remove(20)
# 结果: [10, 30, 20, 40]

# 2. pop:弹出末尾或指定索引的值
last_val = nums.pop()       # 弹出 40,nums 变为 [10, 30, 20]
first_val = nums.pop(0)     # 弹出 10,nums 变为 [30, 20]

# 3. del 语句删除
del nums[0]                 # 删除索引0处的元素,nums 变为 [20]

# 4. clear 清空列表
nums.clear()                # 变为 []
3. 列表修改操作(Update / Modify)
修改列表元素主要依赖索引赋值、切片替换或重排函数:
- 单元素索引修改:
lst[index] = new_value,直接重写指针,时间复杂度为O(1)。 - 切片批量修改:
lst[start:end] = iterable,可一次性替换一个连续区间,右侧元素的数量无需与原切片长度相同。 sort(key=None, reverse=False):就地(in-place)对列表元素进行排序,返回None,直接修改原列表。底层采用高效的 Timsort 算法。reverse():就地将列表中的元素反转,无返回值。
# 示例:列表修改操作
colors = ['red', 'green', 'blue']

# 单元素修改
colors[1] = 'yellow'        # ['red', 'yellow', 'blue']

# 切片批量修改
colors[0:2] = ['purple', 'orange', 'pink']
# 结果: ['purple', 'orange', 'pink', 'blue']

# 就地排序与反转
colors.sort()               # 字典序排序
colors.reverse()            # 翻转顺序
4. 列表查询操作(Read / Search)
查询列表主要包括访问具体槽位、判断存在性、定位索引以及统计频次:
- 索引与切片访问:
lst[i]获得单一元素(O(1));lst[start:end:step]浅拷贝并返回一个新列表。 - 成员测试:
item in lst或item not in lst。由于列表无序且无哈希索引,判断存在性需要线性遍历,最坏情况下时间复杂度为O(n)。 index(value, [start, [end]]):返回元素value在列表中首次出现的正索引。若不存在,抛出ValueError。count(value):返回元素value在列表中出现的总次数;若不存在则返回0,不会报错。
二、字典(Dictionary)常用增删改查操作汇总
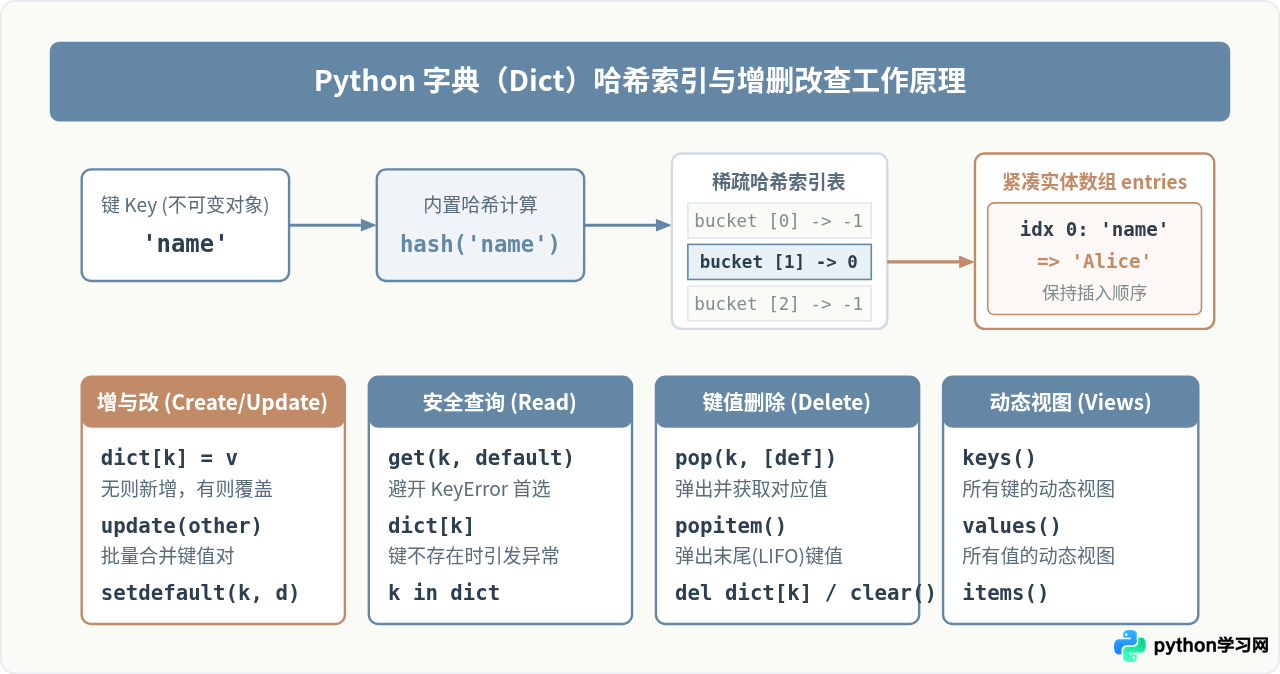
Python 字典是基于哈希表(Hash Table)实现的高效映射类型。自 Python 3.6+ 开始,底层重构为紧凑数组与稀疏索引表的结合架构,不仅节省了大量内存,还天然保持了键的插入顺序。在理想哈希分布下,字典的增、删、改、查均可在 O(1) 常数时间内完成。
1. 字典增加与修改操作(Create & Update)
在字典中,“增”与“改”的语法形态高度统一,核心在于键是否已经存在于字典中:
- 方括号直接赋值:
d[key] = value。若key存在,则覆盖旧值;若key不存在,则在字典末尾追加新键值对。 update([other]):接收另一个字典或键值对迭代器,批量更新当前字典。相同键的值会被覆盖,新键会被插入。Python 3.9+ 还可以直接使用合并运算符d1 | d2或d1 |= d2。setdefault(key, default=None):如果key存在,返回其对应的值;如果key不存在,则将d[key] = default写入字典并返回default。常用于分组统计或嵌套结构的初始化。
# 示例:字典增改操作
user = {'id': 101, 'name': 'Alice'}

# 1. 直接赋值:新增与修改
user['role'] = 'Admin'       # 新增键 'role'
user['name'] = 'Alice Smith' # 修改已有键 'name'

# 2. update 批量合并
user.update({'age': 28, 'city': 'Shanghai'})

# 3. setdefault 设置初始默认值
tags = user.setdefault('tags', [])
tags.append('python')
# user['tags'] 成功初始化为 ['python']
2. 字典删除操作(Delete)
从字典中移除指定键值对的方法包括:
pop(key, [default]):移除key并返回对应的值。若key不存在且提供了default,则返回default;若未提供default且键不存在,触发KeyError。popitem():以元组(key, value)形式弹出并返回字典中的最后一项(后进先出 LIFO)。若字典为空,引发KeyError。del d[key]:直接删除字典中的指定键。若键不存在,抛出KeyError。clear():清空字典内的所有项,使其变为{}。
# 示例:字典删除操作
config = {'host': 'localhost', 'port': 8080, 'debug': True}

# 1. pop 安全删除并获取
port = config.pop('port')             # 返回 8080
ssl = config.pop('ssl', False)        # 不存在时返回默认值 False,不报错

# 2. popitem 弹出最后一项
last_pair = config.popitem()          # ('debug', True)

# 3. del 语句
del config['host']                    # 删除 'host'
3. 字典查询操作(Read & Search)
字典提供了高效直观的检索与视图遍历机制:
get(key, default=None):安全获取key对应的值。若不存在则返回default,绝不抛出KeyError。这是生产代码中最推荐的读键方式。d[key]:直接取值,效率极高(O(1)),但如果键不存在会触发KeyError,适用于确信键存在的场景。key in d:检查指定键是否存在于字典中,底层仅需计算哈希并寻址,平均复杂度为O(1)。keys()、values()、items():分别返回字典键、值、键值对的动态视图对象(View Objects)。视图对象会实时反映字典的变更,且keys()支持集合运算符(如交集&、并集|)。
三、列表与字典增删改查特质与性能对比
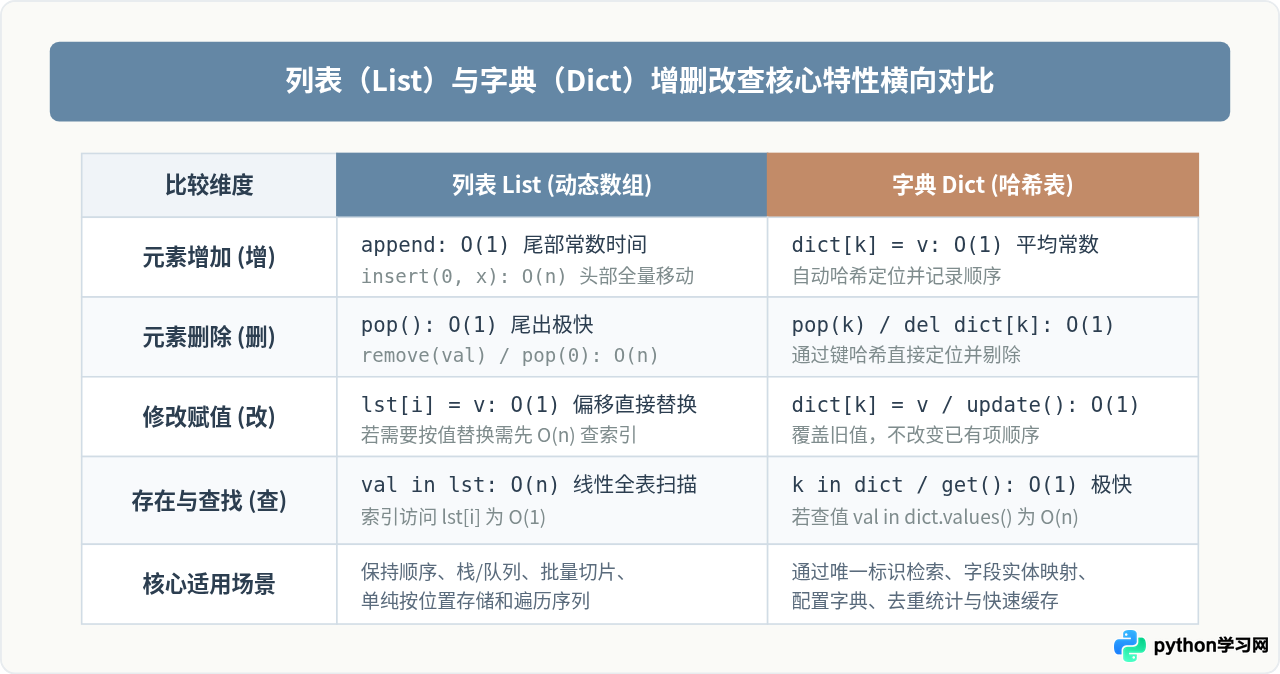
理解两者的复杂度差异有助于在实际业务中进行合理的技术选型。列表适合关注相对次序、频繁利用索引定位或单纯追加流水记录的场景;字典则专门为根据唯一标识(Key)进行高速查找与关联而生。
| 数据结构 | 操作分类 | 推荐内置方法 / 语法 | 平均时间复杂度 | 异常防范 / 注意事项 |
|---|---|---|---|---|
| 列表 (List) | 增 | append(x), extend(iter) |
O(1) 均摊 | 避免在头部频繁 insert(0, x),频繁头部操作宜用 collections.deque。 |
| 删 | pop(), remove(val), del |
尾出 O(1),其余 O(n) | remove 元素不存在抛 ValueError;循环遍历中禁止直接删除。 |
|
| 改 | lst[i] = v, sort() |
单改 O(1),排序 O(n log n) | 单改索引越界抛 IndexError;sort() 是就地修改,无返回值。 |
|
| 查 | lst[i], x in lst, index() |
索引 O(1),搜值 O(n) | index() 找不到抛 ValueError,建议先用 in 判断。 |
|
| 字典 (Dict) | 增 / 改 | d[k] = v, update() |
O(1) | Key 必须为不可变(可哈希)类型,如 str, int, tuple。 |
| 删 | pop(k, def), popitem() |
O(1) | 使用 pop(k, None) 可有效避免无键时的 KeyError。 |
|
| 查 (键) | d.get(k, def), k in d |
O(1) | 不要使用 d.keys() 做 in 检查,直接 k in d 更快更直观。 |
|
| 查 (值) | val in d.values() |
O(n) | 字典针对 Key 构建哈希,按值搜索仍需线性遍历。 |
四、实际编码中的避坑准则与高频模式
在日常开发中,仅记住函数名字往往不够,还需要注意避免常见的反模式与隐蔽 Bug:
1. 陷阱:在迭代遍历列表时直接删除元素
如果直接在一个正在用 for 循环遍历的列表中调用 remove() 或 del,会导致内部索引偏移错乱,造成跳过后续元素的隐蔽 Bug。
# 错误做法:在循环本体中直接修改被遍历列表
nums = [1, 2, 2, 3, 4]
for n in nums:
    if n == 2:
        nums.remove(n)
# 结果并非预期的 [1, 3, 4],而是 [1, 2, 3, 4](第二个2被跳过了!)

# 正确做法一:使用列表推导式生成新列表(最推荐)
nums = [n for n in nums if n != 2]

# 正确做法二:遍历副本切片
for n in nums[:]:
    if n == 2:
        nums.remove(n)
2. 字典安全检索与默认值填充的选型
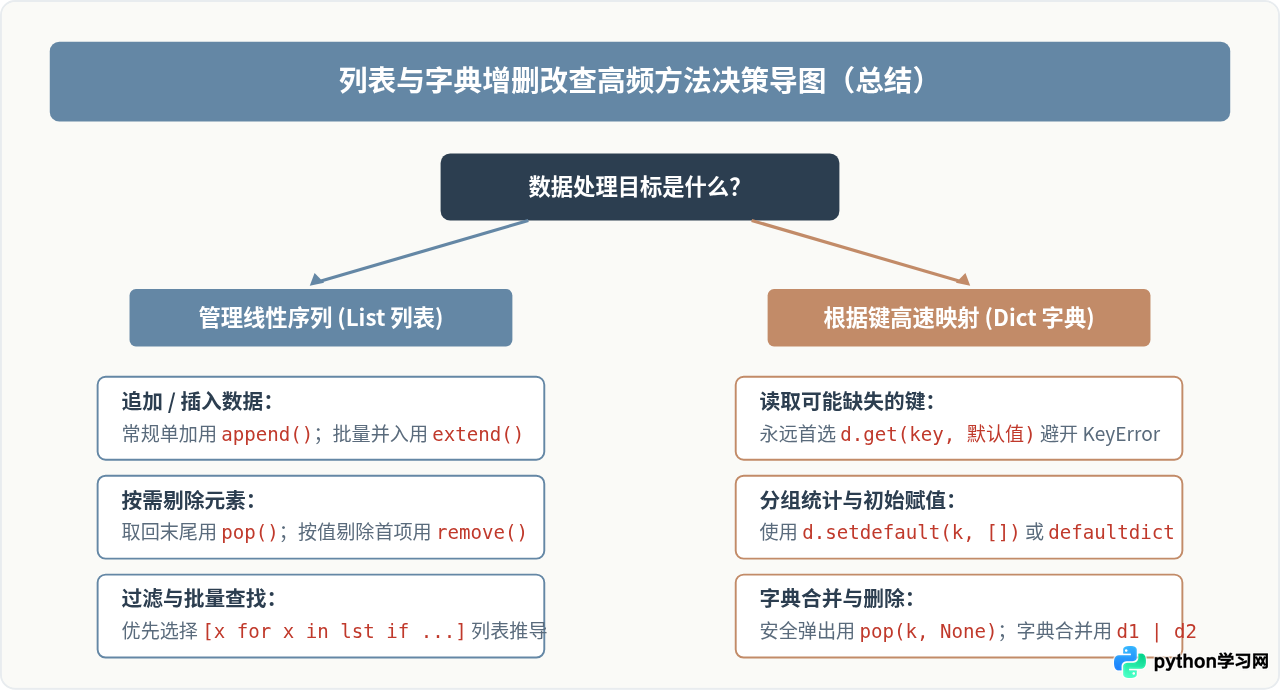
当读取可能不存在的键时,直接使用 d[key] 会使程序崩溃。根据业务目的不同,有清晰的分工策略:
- 仅仅是读取并给一个替补值:使用
d.get(key, 0),字典本身内容不会改变。 - 需要将该默认值同时存回字典中供后续追加:使用
d.setdefault(key, []),或者引入标准库collections.defaultdict。
五、核心结论速览
牢记以下几条核心法则,能够帮助你在绝大多数业务编码中写出既地道又高性能的 Python 代码:
- 查字典用键,查列表慎用值:字典基于键的哈希寻址(
k in d)是O(1)操作;而在包含海量元素的列表中检查val in lst是O(n)操作。有高频存在性判断需求时,应优先使用字典或集合(set)。 - 尾部操作最快:列表的
append()与无参数pop()均为O(1),天然具备高效栈(Stack)特性;若业务需要频繁在头部插入或弹出(队列模型),请直接选用collections.deque。 - 防御性编程:字典读写优先使用
get()与setdefault();删除优先使用pop(key, None)设定默认返回值,防止未知输入引发的KeyError或ValueError。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









