

Python嵌套for循环中continue只影响当前层级的注意事项
深入解析Python嵌套for循环中continue语句的作用机制与边界,剖析仅影响当前内层循环的注意事项、常见认知误区,并提供跳出多层循环的实用方案与代码示例。
continue 语句的作用是提前结束本次循环迭代并直接进入下一次循环。当代码包含多层嵌套 for 循环时,continue 的作用范围严格限定于直接包含它的当前最内层循环,外层循环的轮次推进和执行逻辑完全不受其直接影响。本文系统剖析这一机制的内部原理、常见认知偏差,并给出跨层级控制与循环优化的标准解决方案。
一、continue 在嵌套循环中的核心运行机制
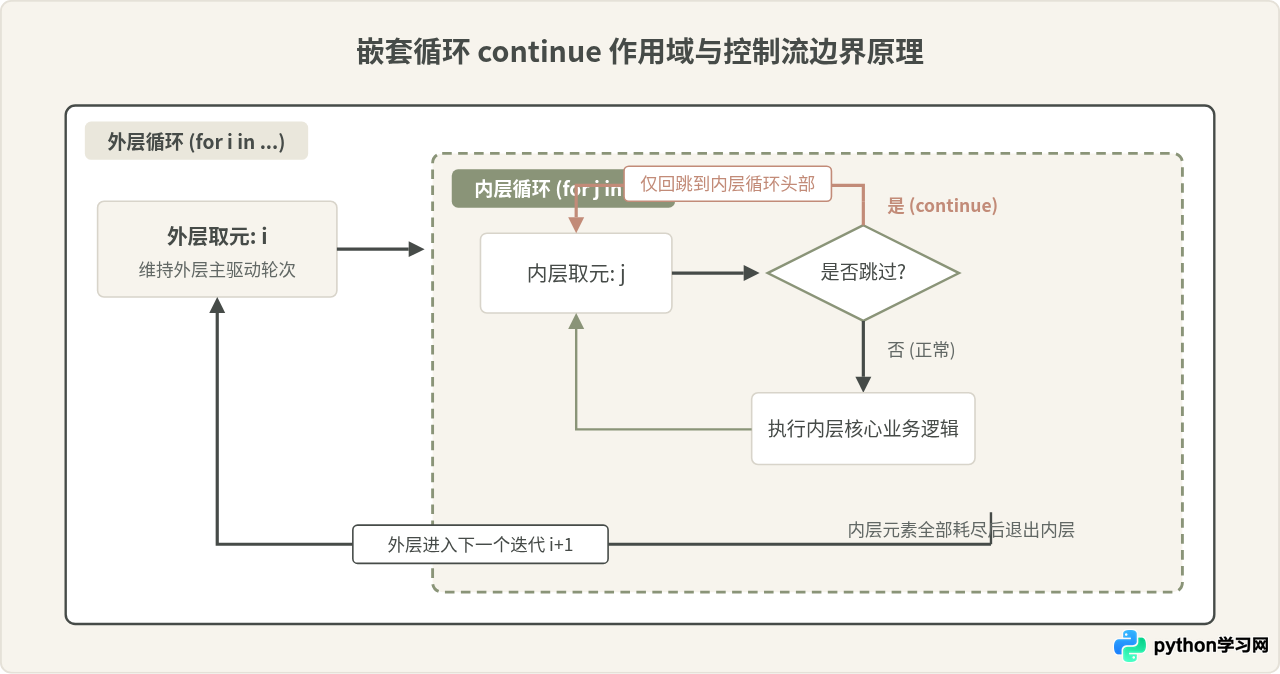
Python 解释器在执行到 continue 语句时,会立即放弃执行当前循环体内位于 continue 之后的其余代码,同时将控制权交还给该循环头部的迭代器,尝试获取下一个元素。在两层或多层嵌套结构中,每一层 for 都有自己独立的迭代上下文和控制流边界。
无论内层循环的嵌套层次有多深,语法层面的 continue 始终只向外寻找到物理层面上距离其最近的那个循环块。当内层循环触发 continue 时,内层循环指针步进,外层循环既不会跳过当前轮次,也不会被提前终止。
为了具体展现上述控制流,下面是一段两层循环的基准代码。在内层循环中,当检测到 j == 1 时执行 continue:
# 嵌套循环中 continue 的基础行为示例
for i in range(2):
    print(f"--- 开始外层循环: i = {i} ---")
    for j in range(3):
        if j == 1:
            print(f"[跳过] 触发内层 continue: i={i}, j={j}")
            continue
        print(f"处理任务节点: i={i}, j={j}")
    print(f"--- 结束外层循环: i = {i} ---\n")
处理任务节点: i=0, j=0
[跳过] 触发内层 continue: i=0, j=1
处理任务节点: i=0, j=2
--- 结束外层循环: i = 0 ---
--- 开始外层循环: i = 1 ---
处理任务节点: i=1, j=0
[跳过] 触发内层 continue: i=1, j=1
处理任务节点: i=1, j=2
--- 结束外层循环: i = 1 ---
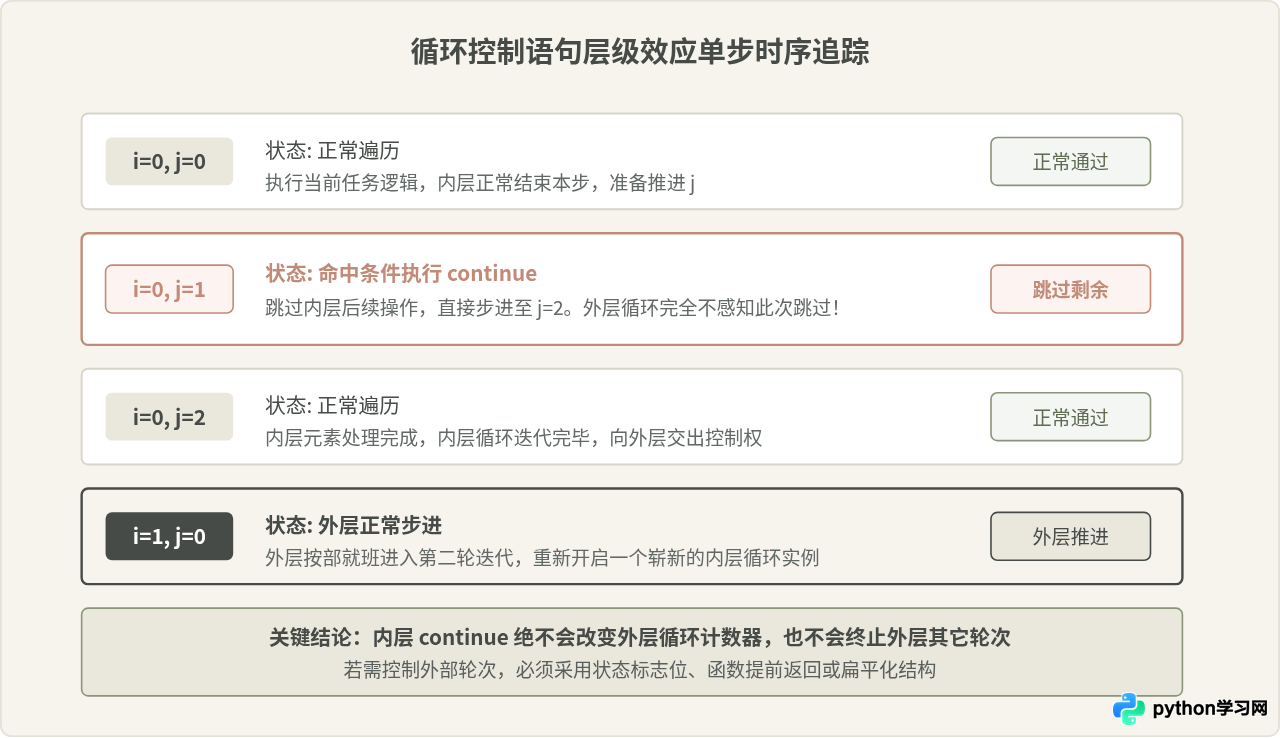
从运行结果可以清晰地看到:
- 当
j == 1时,后续的print("处理任务节点...")确实被跳过了; - 但随后的
j == 2依然正常运行,表明内层循环并没有被销毁; - 更重要的是,外层循环在
i = 0的内层全部走完后,继续平稳推进到了i = 1。这证明continue对外层没有任何穿透效应。
二、常见认知误区与反例剖析
在实际编写或重构复杂算法时,开发者容易对 continue 产生一些看似合理但与 Python 语言标准不符的假定。我们需要清晰地辨析这些误区。
误区一:误认为内层 continue 可以“连带跳过”本次外层循环
部分初学者在遇到“当某项内层数据异常时,放弃处理当前整组数据”的业务需求时,习惯性在内层直接写一个 continue。其潜意识认为只要条件触发,当前整轮计算就会终止并跳转到下一个外部批次。
现实后果:内层仅仅跳过了当前单一元素,剩下的内层元素依旧会逐个被传入并处理,这极易导致本该放弃批次的后续数据出现脏写入或逻辑错误。
误区二:误认为 continue 与 break 存在作用域穿透差异
有人认为 break 是一层一层向上跳,而 continue 能根据上下文决定跨几层。事实上,在 Python 语法定义中,二者的作用域层级完全一致,即:
break:直接终止其所属的当前最近一层循环,跳转到该层循环体之后;continue:直接跳过其所属的当前最近一层循环的剩余代码,跳转到该层循环头进行下一步迭代。
两者都无法在原生语法中跨越自身的局部作用域去影响上一级。
三、实现“跳过外层循环”的常用有效方案
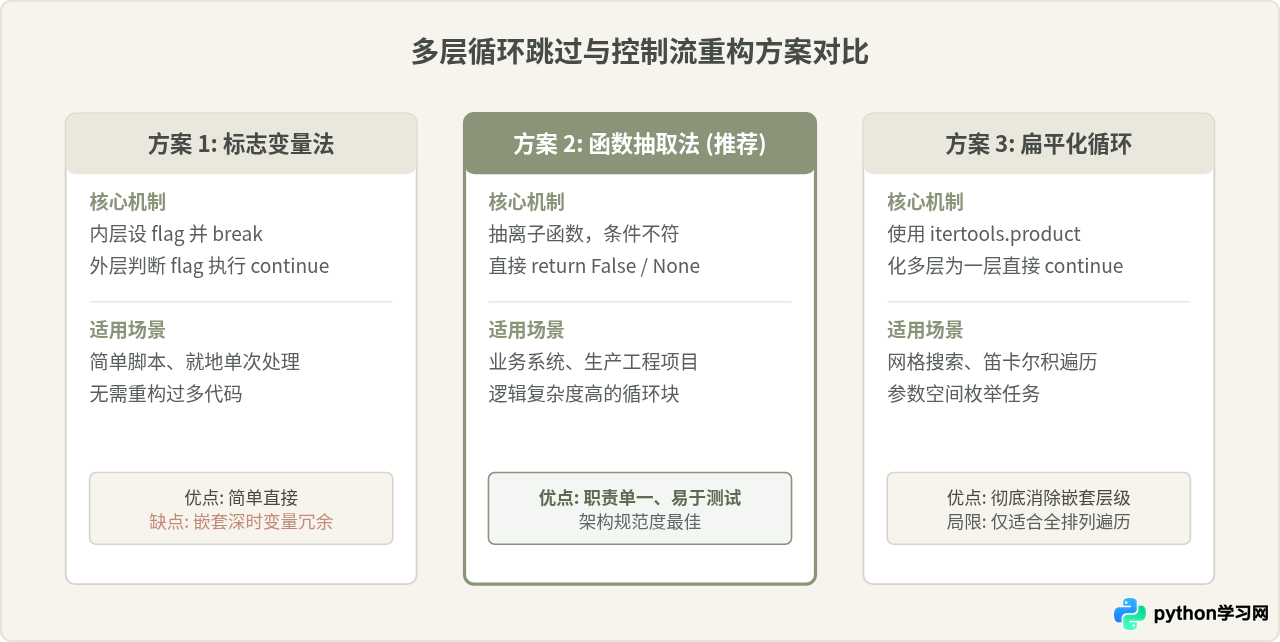
既然原生的 continue 无法越级控制,那么当业务逻辑确实需要在内层检测到某种条件并直接跳过当前外层循环时,应该如何规范编写?以下介绍三种最通用且符合 Python 习惯的解法。
方案 1:辅助布尔标志位(Flag 变量法)
这是最基础也最容易直观理解的方法。在外层循环开始前设立一个状态标志变量,在内层循环满足条件时将其翻转并 break 退出内层;随后在外层检查该标志,若符合条件则由外层的 continue 执行外层跳过。
# 方案一:使用布尔标志变量联动跳过
matrix = [
    [10, 20, -1],  # 包含负数无效数据
    [30, 40, 50],
    [60, -5, 70]
]

for row_idx, row in enumerate(matrix):
    skip_current_row = False

    for item in row:
        if item < 0:
            print(f"行 {row_idx} 包含非法数据 {item},跳过整行处理")
            skip_current_row = True
            break  # 终止内层循环,不再浪费算力检查本行后续元素

    if skip_current_row:
        continue  # 外层 continue:真正跳过该整行

    print(f"-> 成功提交整行数据有效计算: {row}")
-> 成功提交整行数据有效计算: [30, 40, 50]
行 2 包含非法数据 -5,跳过整行处理
方案 2:将循环逻辑封装为独立函数(推荐实践)
在工程代码中,多层嵌套往往意味着职责过于臃肿。将内层逻辑提取为独立的辅助函数,利用 return 可以在发现不合格条件时立即优雅地退出子过程,外层根据函数返回值直接决定是否执行 continue。
# 方案二:封装函数与提前返回
def is_valid_batch(batch_items):
    """验证单批次内所有数据是否合规"""
    for item in batch_items:
        if item < 0:
            return False  # 遇到异常立即返回,逻辑干净彻底
    return True

data_batches = [[1, 2, 3], [4, -1, 6], [7, 8, 9]]

for idx, batch in enumerate(data_batches):
    if not is_valid_batch(batch):
        print(f"批次 {idx} 质检不合格,跳过本次批次")
        continue
    print(f"批次 {idx} 质检合格,正在入库: {batch}")
批次 1 质检不合格,跳过本次批次
批次 2 质检合格,正在入库: [7, 8, 9]
方案 3:利用 itertools.product 将多层嵌套压平为单层
如果多层嵌套循环仅仅是为了穷举所有网格坐标、笛卡尔积组合,可以使用标准库 itertools.product 将其合并为一个单层循环。在单层循环中,continue 的语义天然就是跳过当前这一组完整的组合。
# 方案三:itertools.product 扁平化循环
import itertools

# 原本的两层循环压平为单一层级
for x, y in itertools.product(range(3), range(3)):
    # 当坐标满足特定条件时,一个 continue 即可跳过该点对
    if x == y:
        continue
    print(f"点对坐标: ({x}, {y})")
四、工程开发中的注意事项与避坑指南
在实际编写复杂的业务循环时,牢记以下几项核心开发准则,能够有效规避因混淆循环层级而导致的隐蔽缺陷:
Python 的 for 循环支持 else 子句。当循环正常结束(即没有被 break 打断)时,else 块会被执行。需要特别注意的是:在循环体内执行 continue 并不会破坏循环的正常完结状态。如果内层循环所有的元素都通过 continue 走完了,内层的 else 仍然会被触发。若业务意图是“出现异常则不走 else”,必须使用 break 而非 continue。
在嵌套层级达到 3 层及以上时,continue 的物理作用范围往往难以通过人眼快速辨识,极易产生“误以为跳过了上一层循环”的逻辑漏洞。工程规范通常建议嵌套深度不要超过 2 层。一旦发现嵌套过深,应立即考虑提取辅助函数或使用生成器表达式。
与其在内层循环执行了一半甚至调用了大量耗时 I/O 之后才执行 continue,不如在外层或者内层入口处通过列表推导式、生成器或前置条件提前过滤掉无效项。将过滤逻辑与处理逻辑解耦,能使循环结构清晰明了。
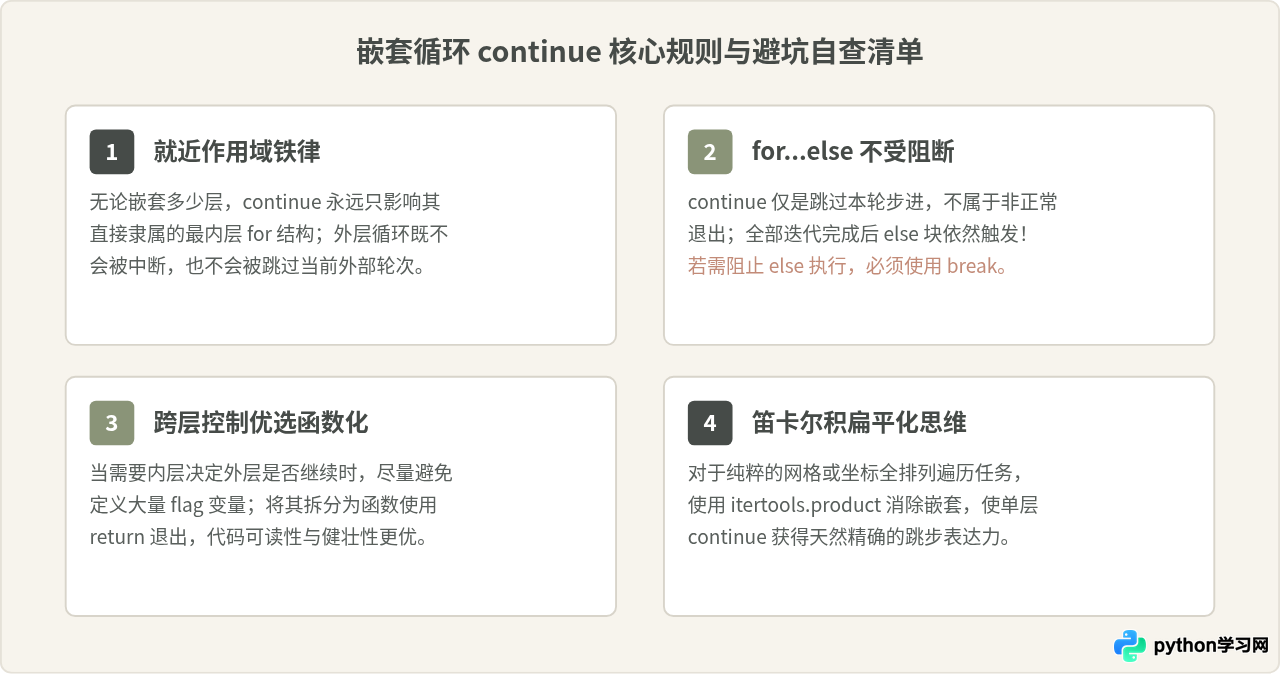
五、总结
理解 Python 嵌套 for 循环中 continue 的作用边界,是写出可靠控制流的关键。归纳而言:
continue严格遵循就近原则,其有效射程仅限于当前最内层循环;- 内层循环触发
continue后,内层继续尝试下一次迭代,外层循环节奏毫发无伤; - 若业务需求要求内层条件联动终止或跳过外层,应采用状态标志位(Flag)、函数化提取(return 返回)或
itertools.product扁平化循环等成熟范式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









