

python函数修改列表等可变参数坑

深入解析Python函数中修改列表等可变对象引发的各种陷阱:包括对象引用传递导致的外部实参意外修改、默认参数在定义期求值引发的数据残留污染、+=与赋值的本质差异,并提供标准的防御性拷贝与Sentinel None解决方案。
一、现象复现:为什么传入函数的列表在外部被篡改了?
许多初学者接触 Python 函数时,常直觉地认为“函数传参会把外部数据复制一份交由内部处理”。然而在实际运行中,一旦函数内部对传入的列表执行了元素修改操作,外部传入的变量内容也会同步变化。
请看下面这段简短的典型代码:
def append_task(task_list, new_task):
    # 在传入的列表末尾追加新任务
    task_list.append(new_task)
    return task_list

# 调用方准备的原始数据
original_tasks = ["阅读文档", "编写代码"]

# 调用函数
append_task(original_tasks, "单元测试")

# 打印调用方的 original_tasks
print(original_tasks)

# 示例输出:
# ['阅读文档', '编写代码', '单元测试']
在这段代码中,调用方虽然只是把 original_tasks 当作实参传入 append_task,但执行完毕后,调用方作用域内的 original_tasks 却被追加了 "单元测试"。如果调用方后续的代码假定该列表只包含两个原始项,就会在此处产生极为隐蔽的逻辑偏差。
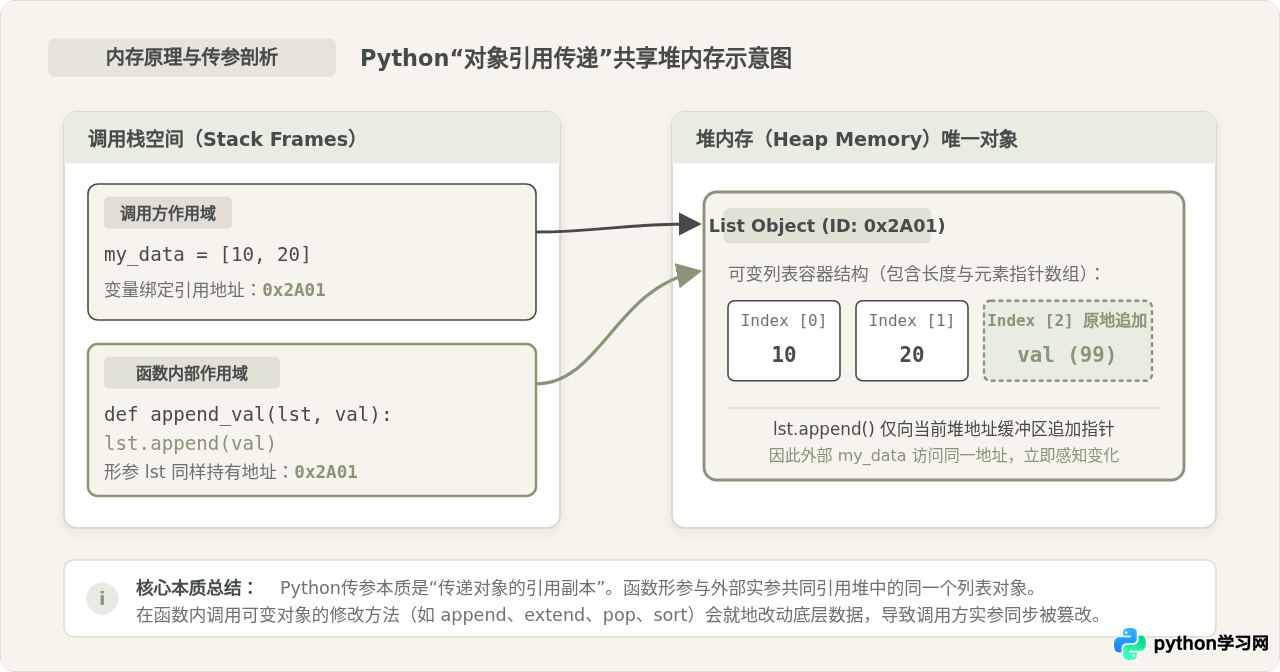
为什么会出现这种现象? Python 的参数传递模型被称为“对象引用传递”(Call-by-Sharing)。在执行 append_task(original_tasks, "单元测试") 时,Python 既没有拷贝一份全新的列表传进函数,也没有建立 C 语言式的指针别名,而是将外部变量 original_tasks 所引用的堆内存对象地址复制给了局部形参 task_list。
此时,调用方的 original_tasks 与函数内部的 task_list 指向堆中同一个列表实例。task_list.append() 是在原对象所占据的内存空间内就地增加元素指针,并没有新建对象。由于底层的内存块仅此一份,外部变量再次读取时,自然会看到已被改动后的内容。
二、辨析:重新赋值(`=`)与原地修改(`.append()` / `+=`)的本质差异
在日常讨论中,常能听到一种说法:“Python 函数内不能修改外部变量,除非用 global”。这种说法看似有道理,但它混淆了变量名重新绑定(Rebinding)与可变对象就地修改(In-Place Mutation)两个完全不同的操作。
我们通过对比两组操作来清晰划分这一界限:
# 模式 A:重新赋值操作(创建新对象并重定向局部变量)
def reset_with_add(items, val):
    items = items + [val]  # 使用 + 生成了新列表,并将局部变量 items 重新绑定
    print("函数内部 items:", items)

raw_a = [1, 2]
reset_with_add(raw_a, 3)
print("外部原始 raw_a:", raw_a)

# 示例输出:
# 函数内部 items: [1, 2, 3]
# 外部原始 raw_a: [1, 2]
在上面的模式 A 中,表达式 items + [val] 会开辟一块新的堆内存空间来存放合并后的列表,随后等号 = 仅把函数局部命名空间里的 items 重新指向了这个新对象。此时局部变量与外部实参脱钩,外部的 raw_a 依然安然无恙地指向旧列表 [1, 2]。
# 模式 B:复合赋值操作符 +=(容易被误解的就地修改)
def mutate_with_iadd(items, val):
    items += [val]  # 对列表而言,+= 会调用 __iadd__ 执行就地修改
    print("函数内部 items:", items)

raw_b = [1, 2]
mutate_with_iadd(raw_b, 3)
print("外部原始 raw_b:", raw_b)

# 示例输出:
# 函数内部 items: [1, 2, 3]
# 外部原始 raw_b: [1, 2, 3]
很多人误以为 items += [val] 只是 items = items + [val] 的语法糖简写,但事实并非如此。在 Python 内部,对于不可变类型(如整型、元组、字符串),+= 确实会回退为生成新对象再重新绑定;但对于列表等可变容器,+= 优先寻找并执行内部的 __iadd__ 特殊方法,该方法等同于调用 items.extend([val]),是在原对象上直接追加数据,不会改变变量引用的内存地址。
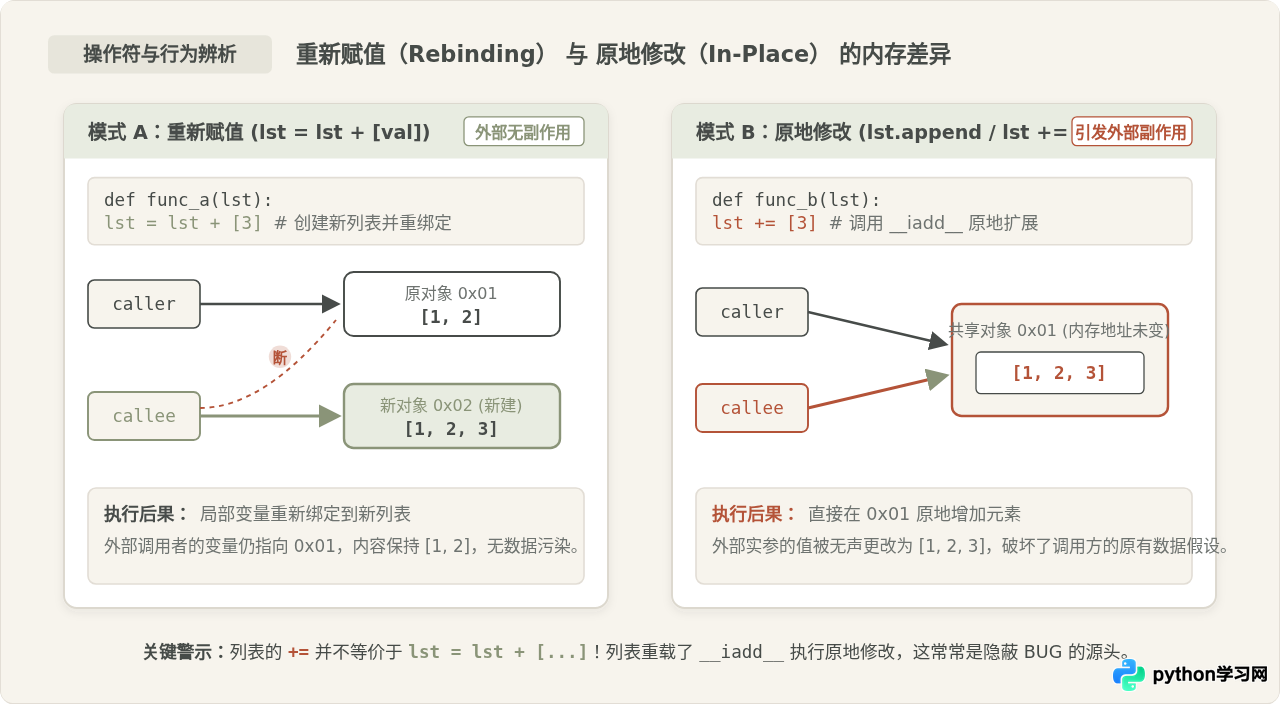
lst += [x] 时必须高度警惕。如果你并不希望影响调用方传入的原列表,请切勿使用 +=,而应采用防御性拷贝或显式的 lst = lst + [x]。
三、经典陷阱:默认参数使用可变对象(`cache=[]`)
如果说传入参数被意外修改是“调用时副作用”,那么将可变对象写在函数的默认参数定义中,则是 Python 初学者最容易踏入的“设计期陷阱”。
我们来看一个希望“默认提供空列表作为容器”的函数:
def collect_records(item, container=[]):
    container.append(item)
    return container

# 连续三次不传 container,期望每次获得只包含当前项的新列表
print(collect_records("记录A"))
print(collect_records("记录B"))
print(collect_records("记录C"))

# 示例输出:
# ['记录A']
# ['记录A', '记录B']
# ['记录A', '记录B', '记录C']
运行结果出人意料:第二次和第三次调用并没有按直觉生成全新的空列表,而是把之前调用的历史数据全部累积了下来。
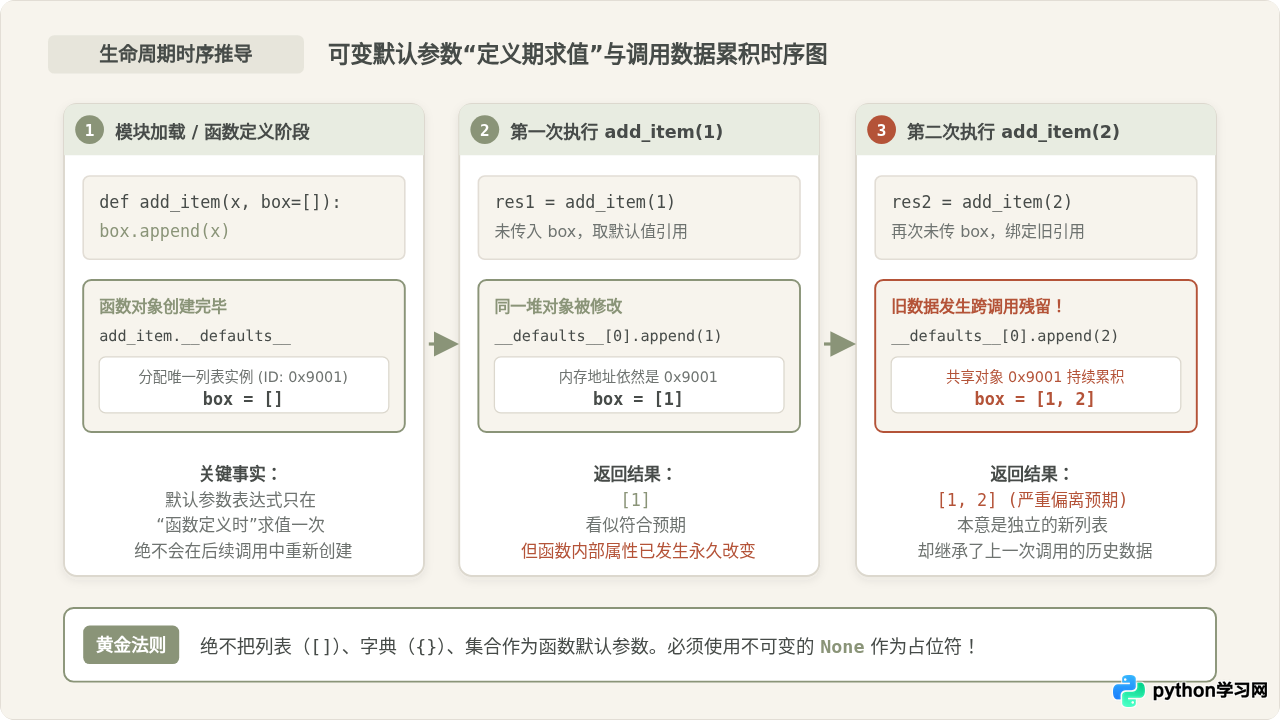
为什么默认列表会跨调用共享? 关键原因在于 Python 解释器处理 def 语句的时机:
-
定义时求值:当 Python 解释器首次扫描并执行
def collect_records(item, container=[]):这行代码时,函数对象被创建,右侧的默认参数表达式[]会被立即执行求值一次,在堆内存中生成一个列表实例。 -
存入函数内部属性:这个唯一的列表对象会被打包进一个元组,存放在该函数对象的
collect_records.__defaults__属性中,伴随函数的整个生命周期。 -
调用时复用:在随后的每次函数调用中,只要调用方没有显式传入
container实参,Python 就会把__defaults__中保存的那个既有列表直接绑定给形参container。
由于 container.append() 原地修改了这个列表,函数对象内部的 __defaults__ 所引用的内容便被永久改写了。可以通过检查函数属性验证这一点:
print(collect_records.__defaults__)
# 示例输出:
# (['记录A', '记录B', '记录C'],)
四、避坑指南:四种标准安全编码方案
理解了对象引用的共享本质与定义期求值机制后,我们可以针对不同的业务场景,采用成熟的标准写法来规避以上所有陷阱。
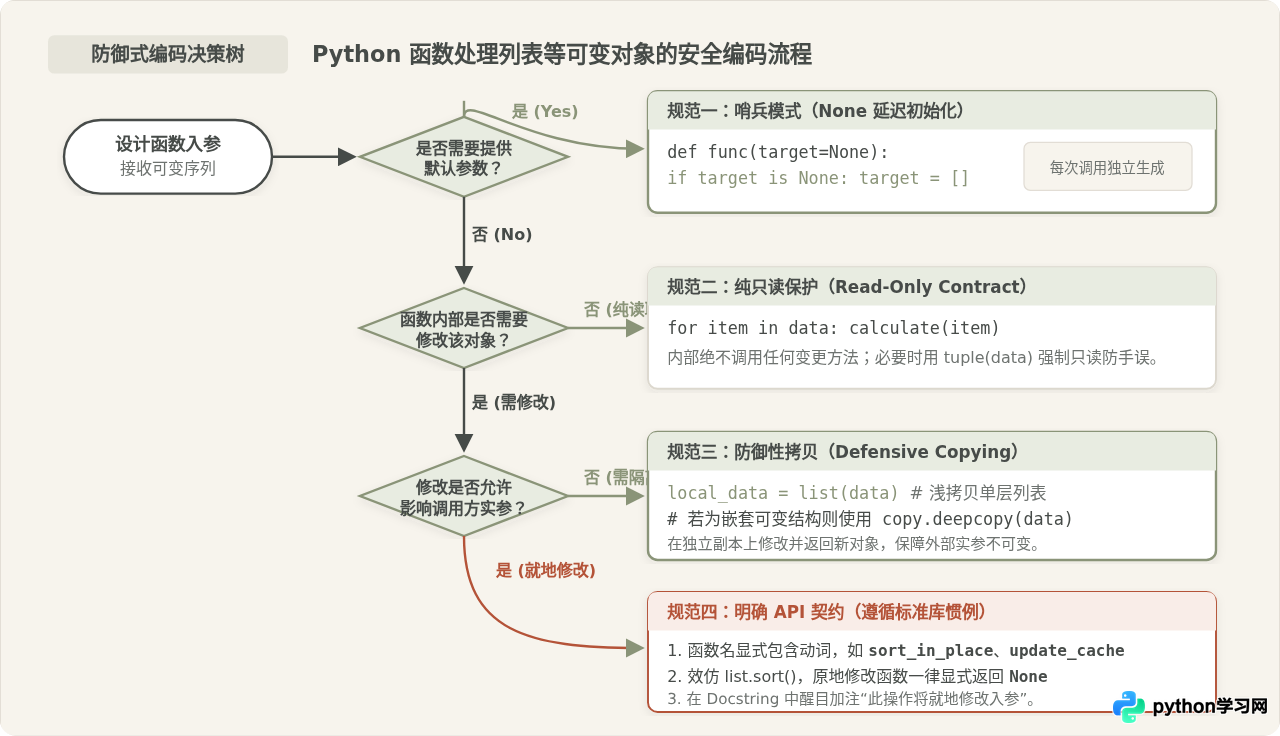
方案一:默认参数统一使用 `None` 哨兵(Sentinel Pattern)
对于需要可变默认值的函数,Python 社区的标准惯用法是将形参默认值显式设置为不可变的 None,在函数执行期进行判断并动态分配新实例:
def safe_collect(item, container=None):
    # 在每次函数调用时独立判断与创建
    if container is None:
        container = []
    container.append(item)
    return container

print(safe_collect("X"))  # ['X']
print(safe_collect("Y"))  # ['Y'],不再受上次调用影响
通过这种方式,只有在每次函数真正被调用时,container = [] 才会执行,确保每次生成的都是一个独立的全新列表对象。
方案二:函数内部实施防御性浅拷贝(Defensive Copying)
如果函数接收外部传入的列表,但只是为了在内部进行排序、截断或过滤等临时变换,绝不应直接对形参就地操作,而应在函数开头制作浅拷贝:
def process_scores(scores):
    # 制作独立拷贝,切断与外部实参的就地关联
    local_scores = list(scores)  # 或 scores.copy()
    local_scores.sort(reverse=True)
    return local_scores[:3]

user_scores = [68, 92, 74, 85]
top3 = process_scores(user_scores)

print("最高分:", top3)
print("原分数列表未被颠倒:", user_scores)

# 示例输出:
# 最高分: [92, 85, 74]
# 原分数列表未被颠倒: [68, 92, 74, 85][{"id": 1}, {"id": 2}]),单层的 list.copy() 或 list() 属于浅拷贝,子对象依然被共享。此时若需修改子字典的内容,应使用标准库的 import copy; work_data = copy.deepcopy(data)。
方案三:调用方传递切片副本
如果调用的第三方库函数内部本身就包含 .sort() 或 .pop() 等就地修改逻辑,而你作为调用方无权修改该函数代码,可以在传入实参时主动切片:
# 通过 [:] 切片操作生成并传入一个新列表
result = third_party_inplace_function(my_data[:])
方案四:明确原地修改的 API 契约(遵循 Python 原生惯例)
有时候业务场景确实需要“就地修改大列表”以节省内存开销。此时应当严格遵守 Python 官方内置库的设计哲学(例如 list.sort() 与 random.shuffle()):
- 函数命名使用祈使动词:如
sort_in_place()、normalize_vector_(),警示调用方。 - 显式返回
None:绝不返回被修改的原对象。Python 设计者刻意让原地修改方法返回None,就是为了防止使用者写出a = b.sort()导致数据丢失。 - Docstring 明确注明副作用:在函数文档中用大写字样提示“Side Effects: Modifies the input list in-place”。
五、总结与自查清单
列表等可变对象在 Python 函数中的行为特征,是 Python 内存模型直接映射的结果。掌握这些规律后,可以通过以下速查图与自查表在日常编码和 Code Review 中快速排查问题。
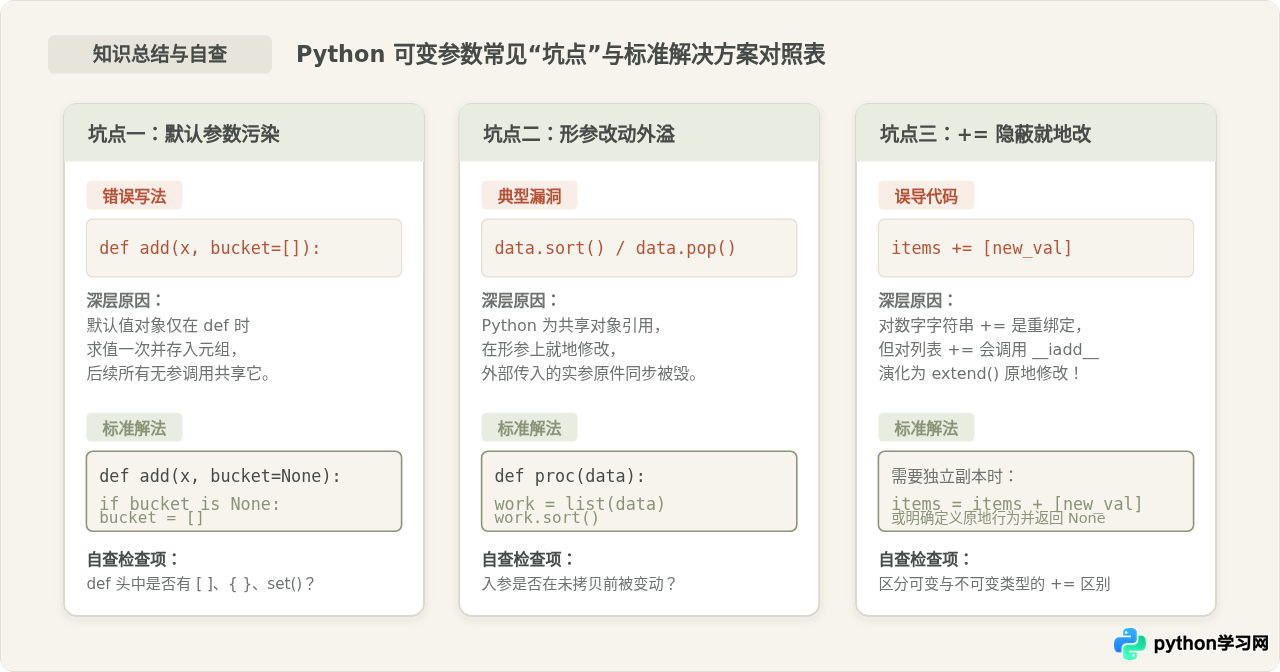
| 场景分类 | 危险写法 / 易踩坑点 | 底层产生原因 | 推荐安全写法 |
|---|---|---|---|
| 默认参数定义 | def f(cache=[]): |
默认参数在定义期仅求值一次,存放在 __defaults__ 中全局复用 |
def f(cache=None): |
| 参数计算与清洗 | 直接在函数内执行 data.sort()、data.pop() |
形参与实参引用同一内存地址,就地操作直接改变外部实参 | 内部先建立副本:work = list(data),或使用非原地函数 sorted(data) |
| 列表增量拼接 | data += [new_item] |
列表的 += 重载了 __iadd__,等价于 extend 原地扩容 |
需保留实参时使用 data = data + [new_item] 或提前拷贝 |
| 深层嵌套容器 | copy.copy(nested_list) 处理二级字典/列表 |
浅拷贝仅复制外层列表结构,内层元素引用依然指向相同地址 | 使用 copy.deepcopy(nested_list) 进行完全独立复制 |
牢记核心原则:“不可变对象放默认,可变参数防改动;需改本地先浅拷,默认占位必用 None”。遵循这一设计准则,就能彻底告别可变参数带来的难以追踪的外部副作用与数据污染 Bug。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









