

初学者怎么高效利用Python 100题提升编码能力?
深入解析初学者如何科学利用Python 100题提升实际编码能力,避开被动抄代码的误区,建立拆解、编码、调试、重构与项目迁移的完整学习闭环。
初学者练习“Python 100题”的核心价值,不在于追求在短时间内打卡完成的题目数量,而在于通过逐道题目的“独立需求拆解、键盘编码实现、报错定位排查、代码对比重构”,将孤立被动的语法知识转化为解决实际业务逻辑的肌肉记忆。许多人在刷完100题后依然感到“看着空白的编辑器无从下手”,根本原因在于陷入了“看一眼题目不会做即看题解、顺着答案照抄一遍就以为掌握”的被动学习惯性中。要让这100道题目真正转化为编码能力,关键在于改变练习机制,建立主动编码与工程复盘的闭环。
一、认清定位:Python 100题在学习路径中的真实阶段
很多初学者误把“Python 100题”当成了考试冲刺题库,以为全部背一遍就能掌握编程。事实上,经典的Python 100题涵盖了从基础变量运算、控制循环,到列表字典操作、函数递归与简单算法设计等多个层级。它的定位是初学者跨越“听得懂语法教学”到“写得出完整程序”之间的过渡训练场。
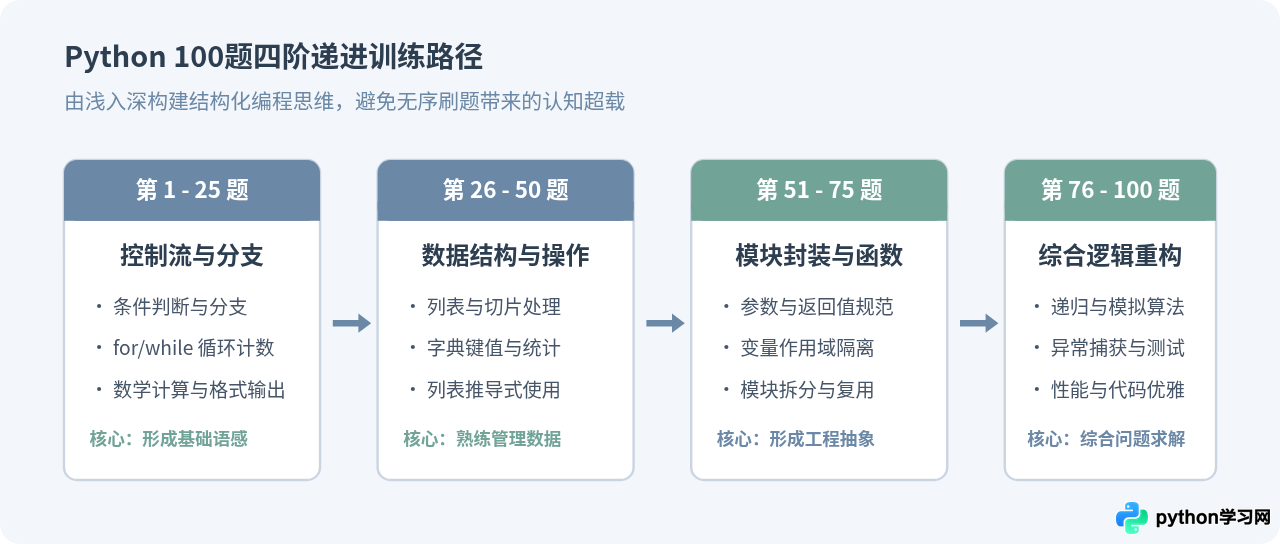
在开始做题前,不建议毫无次序地从第1题盲目做到底。合理的方式是按照认知规律将这100道题目划分为四个循序渐进的阶段:
- 第一阶段(第1-25题):基础控制流与简单运算。主要考察变量运算、
for与while循环、if-elif-else条件分支。重点在于训练思维把脑海中的步骤翻译为代码次序。 - 第二阶段(第26-50题):内置容器与数据处理。集中在列表(list)、元组(tuple)、字典(dict)和集合(set)的操作,包括查找、去重、推导式与键值统计。重点在于掌握不同数据结构的存取特性与典型应用场景。
- 第三阶段(第51-75题):函数封装与逻辑解耦。从写单文件流水式脚本过渡到编写带入参、返回值、局部作用域的规范函数。重点在于学会把复杂问题拆解为多个单一职责的子任务。
- 第四阶段(第76-100题):综合逻辑与边界排查。涉及递归逻辑、文本格式化、排序算法与基础数学模拟。重点在于锤炼边界值处理能力与代码健壮性。
二、单题高效攻关:五步深度练习闭环
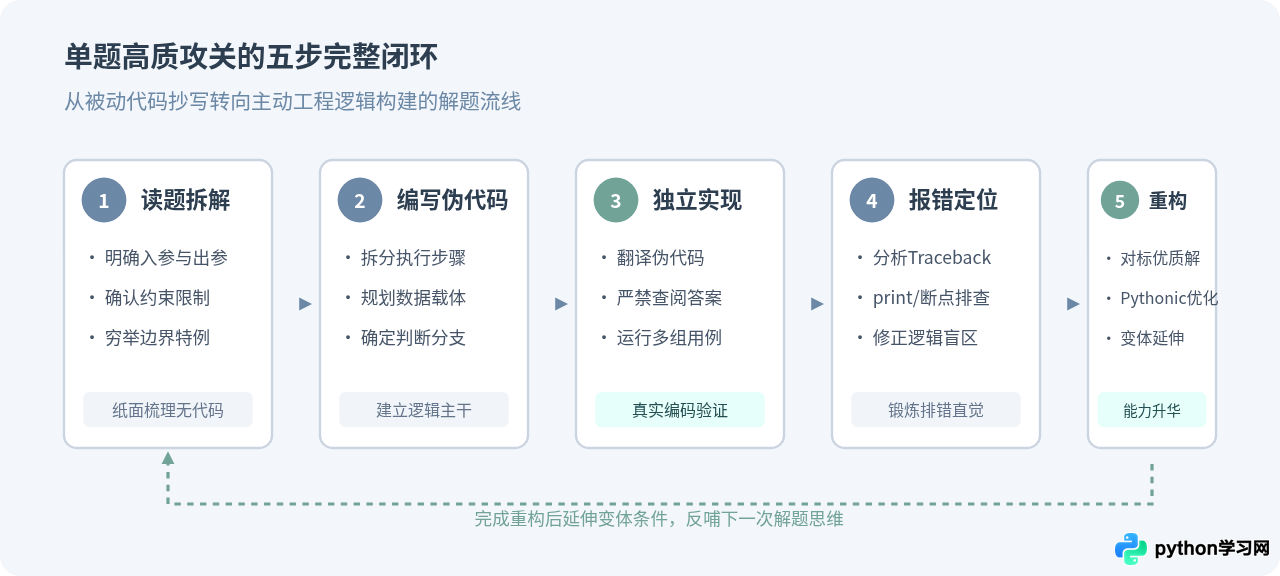
做一道题目的真正收益,来自于从零推导出答案并反思改进的全过程。如果只是机械地将网络题解复制到编辑器里运行一遍,大脑实际上并未参与“问题建模”与“逻辑组装”。为了最大化每道题目的训练效率,建议对每道题执行标准五步闭环流程:
- 第一步:读题并明确输入输出边界。在敲击键盘前,先在草稿纸或注释中写下:“入参是什么数据类型?期望返回值是什么?是否有特殊情况(如空列表、负数、重复元素)?”
- 第二步:书写自然语言伪代码。将大问题拆成几个连续的小步骤。例如:“1. 遍历列表;2. 检查字典中是否已有该字符;3. 若有则计数加1,若无则初始化为1;4. 返回排序后的键值列表”。
- 第三步:独立编码与本地自测。关掉题解网页,仅依靠官方文档或本地环境编写代码,并构造至少3组不同的测试数据(正常数据、边界数据、极端数据)进行验证。
- 第四步:自主排查报错(Traceback)。运行出错时,切忌立刻搜索答案。先仔细阅读终端输出的错误类型(如
IndexError、KeyError、TypeError)及指向的代码行数,尝试利用print()打印关键变量状态定位原因。 - 第五步:对标优质解答与重构优化。题目做对后,才是学习的真正起点。此时打开参考答案,重点观察:“别人的写法比我简洁在哪里?是否使用了更适合的数据结构?时间复杂度如何?”随后对自己的代码进行重构。
实战案例演示:从“能跑通”到“工程优雅”
以第100题中常见的经典问题——“统计列表中出现频次最高的元素并返回其频次”为例。初学者的第一版代码通常使用嵌套循环或冗余变量,虽然能得出结果,但效率和表达都不够成熟:
# 示例:初学者初版(基础循环实现)
def find_most_frequent_v1(numbers):
    if not numbers:
        return None, 0

    unique_items = []
    for item in numbers:
        if item not in unique_items:
            unique_items.append(item)

    best_item = None
    max_count = 0
    for u in unique_items:
        current_count = 0
        for item in numbers:
            if item == u:
                current_count += 1
        if current_count > max_count:
            max_count = current_count
            best_item = u

    return best_item, max_count

# 测试输出(示例输出):
# numbers = [1, 3, 2, 3, 4, 3, 2, 1] -> 输出结果: (3, 3)
在第五步对照重构时,初学者会发现内部嵌套遍历的时间复杂度是 O(N^2)。此时可以引导自己使用字典进行 O(N) 单次遍历统计,甚至使用标准库 collections.Counter:
# 示例:第五步重构版(利用字典哈希优化,清晰且符合工程习惯)
def find_most_frequent_v2(numbers):
    if not numbers:
        return None, 0

    counts = {}
    for num in numbers:
        counts[num] = counts.get(num, 0) + 1

    # 使用 max 配合 key 函数,避免手动比较
    most_item = max(counts, key=counts.get)
    return most_item, counts[most_item]

# 进一步探索标准库(Pythonic 最佳实践):
# from collections import Counter
# def find_most_frequent_v3(numbers):
#     if not numbers:
#         return None, 0
# return Counter(numbers).most_common(1)[0]counts.get(num, 0) 的经典字典统计模式,还理解了为什么哈希表比双重循环快,实现了从“语法拼凑”到“算法意识”的跃迁。
三、警惕误区:低效刷题与高效编码模式对比
许多初学者之所以觉得刷题效率低下、容易遗忘,往往是因为不知不觉中落入了低效模式。将两者的关键行为进行对照,有助于及时校正学习习惯:
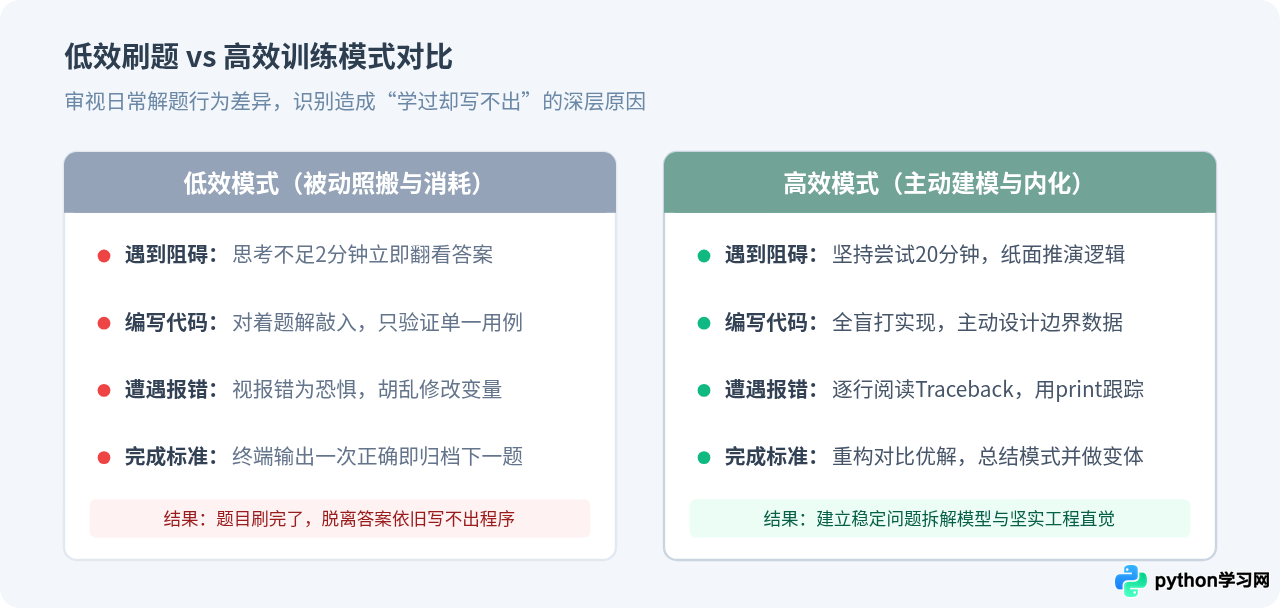
在练习过程中,务必坚决遵守“20分钟探索法则”:面对毫无思路的题目,先不要去搜完整答案代码。用20分钟的时间,通过搜索引擎或官方教程只检索“题目涉及的特定知识点函数”(例如“Python中如何按字典值倒序排列”、“Python中如何将字符串逆序”),尝试自己将检索到的积木块拼接成完整逻辑。只有当经过20分钟推演依然完全卡死时,才去查阅题解,并且在阅读答案后,必须完全合上题解窗口,在空白文件内重新盲写一遍。
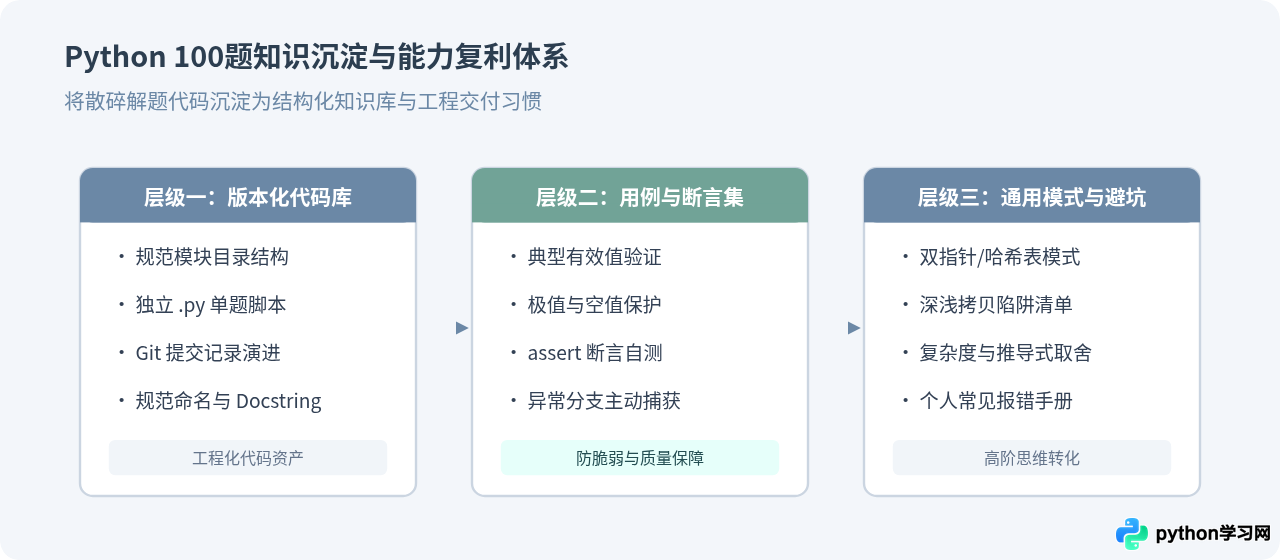
四、沉淀资产:把100题转化为个人代码库
散落在桌面各个临时文件里的代码片段无法带来长期的复利。高效的学习者会将这100道题目视为自己的第一个微型开源项目,从规范的文件管理中学习软件工程的基础组织习惯。
1. 规范的项目目录组织
建议在本地建立一个专门的练习目录,按题目编号与模块分类管理:
python-100-practice/
├── 01_control_flow/
│   ├── q001_multiplication_table.py
│   └── q002_leap_year.py
├── 02_data_structures/
│   ├── q026_list_deduplicate.py
│   └── q027_char_frequency.py
├── notes/
│   └── common_pitfalls.md
└── README.md
2. 编写自说明的完整代码文件
每个代码文件不仅应包含解法函数,还应附带题目描述文档字符串以及独立的测试调用区(使用 if __name__ == '__main__': 保护):
"""
题目 026:列表去重且保持原有次序
描述:给定一个包含重复元素的列表,返回去重后的列表,且保留元素首次出现的相对顺序。
"""

def deduplicate_keep_order(items):
    """
    使用集合辅助记录已见元素,实现时间复杂度 O(N) 的保序去重
    """
    seen = set()
    result = []
    for item in items:
        if item not in seen:
            seen.add(item)
            result.append(item)
    return result

if __name__ == '__main__':
    # 示例测试用例
    test_data = [4, 2, 1, 2, 4, 3, 5, 1]
    expected = [4, 2, 1, 3, 5]
    actual = deduplicate_keep_order(test_data)
    assert actual == expected, f"测试未通过: 预期 {expected}, 实际得到 {actual}"
    print("示例验证通过,输出结果:", actual)
3. 建立踩坑手记与易错清单
在 common_pitfalls.md 中,把日常遇到的经典错误记录下来。初学者高频踩坑点通常包括:
- 列表遍历修改陷阱:在
for item in my_list:遍历的同时对my_list进行remove(),导致漏判元素; - 默认可变参数陷阱:函数定义如
def append_item(val, container=[]):,多次调用间共享同一个列表对象; - 浅拷贝与深拷贝混淆:多维嵌套列表使用
list.copy()仅复制第一层引用,修改子项影响原列表; - 整数除法与浮点精度:混淆
/与//,以及浮点数比较0.1 + 0.2 != 0.3。
五、完成100题之后:如何平滑过渡到真实项目
当完整、扎实地攻克完这100道题后,初学者已经具备了基本的语法功底和逻辑组织能力。但必须清楚认识到:100题大多运行在内存和控制台标准输入输出中,而真实世界的Python开发需要面对外部文件、网络延迟、第三方库依赖以及更为复杂的软件生命周期。
为了防止“刷完题后失去方向”,建议在100题完成度达到70%至80%时,启动以下三个方向的轻量实战项目,完成从“做题”到“做产品”的跨越:
- 项目一:本地命令行实用工具(CLI记账或待办管理)。结合
json或csv模块实现本地数据持久化,练习字典增删改查、参数解析及异常文件处理。 - 项目二:自动化办公或数据清洗脚本。使用标准库
os、pathlib批量重命名整理混乱文件夹,或利用csv提取关键数据并生成汇总报表,体会代码解放重复劳动的实际威力。 - 项目三:轻量API数据抓取与展示。使用
urllib或第三方requests库调用公开天气接口或新闻接口,将获取的JSON数据解析后格式化打印。
通过“分阶推进、五步闭环、对标重构、工程沉淀”这套体系,Python 100题将不再是一份枯燥的题库打卡单,而是帮助你建立坚实编程直觉与工程严谨度的跳板。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









