

数据科学python用Jupyter还是PyCharm
在Python数据科学领域,Jupyter与PyCharm并非非此即彼的对立关系,而是取决于项目所处的阶段与工程目标。本文深入剖析二者在运行机制、数据探查、工程重构、版本控制和调试测试等核心维度的差异,并给出清晰的阶段选型决策与平滑协作指南。
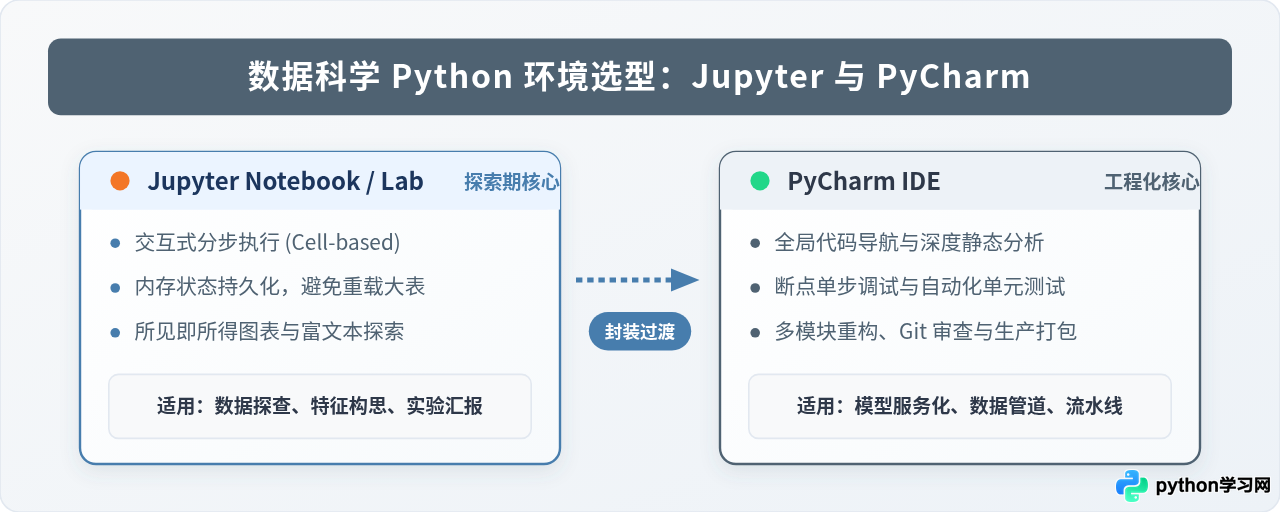
对于从事 Python 数据科学工作的开发者而言,Jupyter 与 PyCharm 并不是非此即彼的对立工具,而是服务于数据科学不同生命周期的专业搭档。核心结论非常明确:在数据探查、特征构思、实验建模与结果汇报阶段,首选 Jupyter(或 JupyterLab);而在系统重构、编写自动化管道、构建单元测试以及生产交付阶段,必须切换到 PyCharm。理解两者的根本差异并掌握平滑过渡的工作流,是提升数据科学研发效率与代码质量的关键。
一、核心定位与运行机制的本质分工
很多开发者在两者之间摇摆,根源在于混淆了“探索性编程(Exploratory Programming)”与“工程化软件开发(Software Engineering)”的目标差异。这两种工具底层的运行机制截然不同:
- Jupyter 的交互式内存驻留机制(REPL 模式):Jupyter 由一个后台持久运行的 Python Kernel 和前端网页组成。用户以单元格(Cell)为粒度执行代码,数据载入内存后会一直常驻。这意味着当你载入一个 2GB 的 CSV 文件或拟合了一个耗时 10 分钟的模型后,后续调整图表参数或提取新特征时,只需重新运行单个 Cell 即可在毫秒级内获得反馈,无须每次重跑整个脚本。
- PyCharm 的项目全生命周期与静态分析能力:PyCharm 是一款重型集成开发环境(IDE)。在默认运行模式下,Python 解释器以完整进程自顶向下运行脚本,执行结束后进程退出、内存释放。PyCharm 的杀手级优势在于代码静态解析:它能跨数十个文件索引全局函数、类与变量,提供严密的语法检查、类型推断、安全重构(如一键重命名函数并同步全工程引用)以及深度的调用栈单步断点调试。
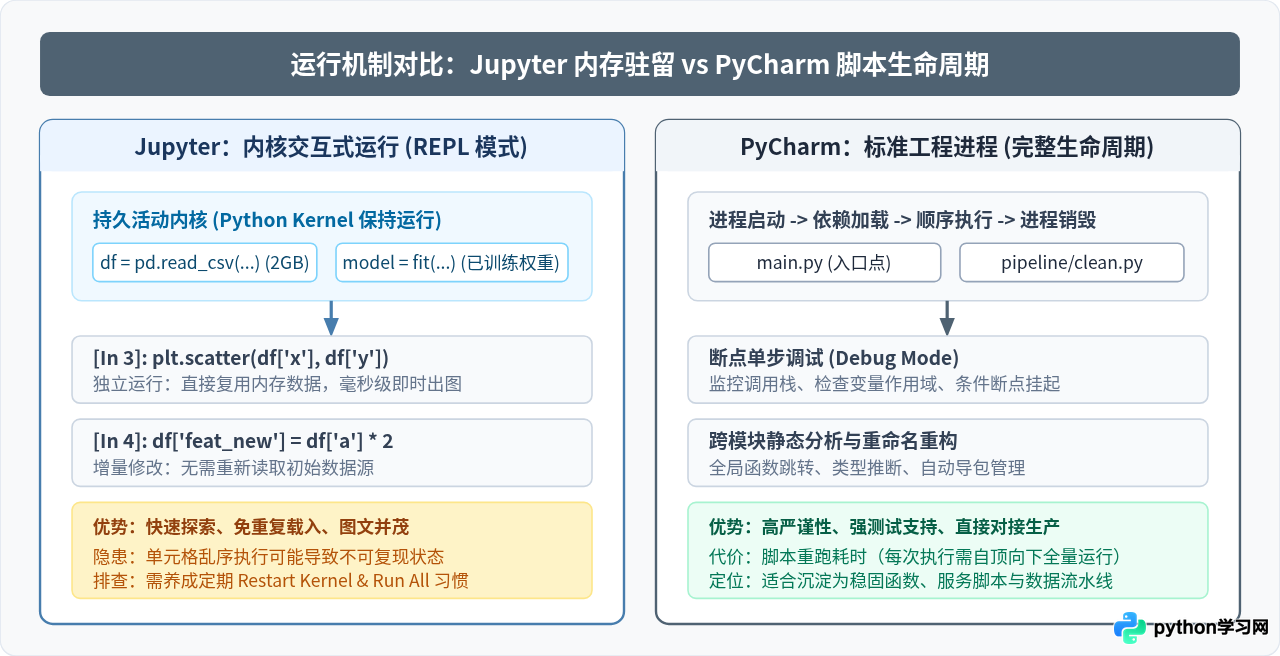
Jupyter 的单元格可以随意上下乱序执行。如果后续单元格依赖了前面被修改或删除的全局变量,就会产生“当前结果看起来正确,但重启内核后无法复现”的隐式状态问题。在得出分析结论或准备共享代码前,务必点击 Kernel -> Restart Kernel and Run All Cells 验证执行的确定性。
二、典型场景能力对比:何时选 Jupyter,何时选 PyCharm?
根据日常具体任务的特征,可以快速锁定最合适的开发环境:
1. 探索性数据分析(EDA)与图表呈现:首选 Jupyter
面对一份未清洗的数据集,首要任务是查看缺失值、字段分布、相关性矩阵及绘制散点图。Jupyter 支持内联渲染 Pandas DataFrame 的 HTML 表格与 Matplotlib/Seaborn/Plotly 图表,所见即所得。配合 Markdown 单元格,分析师可以边写思考笔记边调整统计策略,最终直接导出为 HTML 或 PDF 报告提交给业务团队。
2. 复杂逻辑排查与断点调试:首选 PyCharm
当数据处理逻辑包含复杂的递归、条件分支或多层继承时,单纯在 Jupyter 里依靠 print() 打印变量排查极其低效。PyCharm 拥有业界顶尖的调试器,支持设置条件断点(例如当 df['amount'] < 0 时才暂停)、检查当前帧的作用域变量、单步跳入(Step Into)第三方库源码,以及在暂停状态下即时通过 Evaluate Expression 窗口动态求值。
3. Git 版本协同与团队评审:PyCharm 完胜
Jupyter Notebook 的底层存储格式是包含大量元数据、执行计数字段及 Base64 图像数据的 JSON 字符串。在团队通过 Git 进行协作时,只要两人同时运行过同一个 notebook,就会导致极其臃肿且难以阅读的代码冲突(Diff Conflict)。而在 PyCharm 中,所有代码以规范的 .py 纯文本管理,PyCharm 提供了清晰的三方合并工具,能够直观比对每一行代码修改,是团队 Code Review 的标准载体。
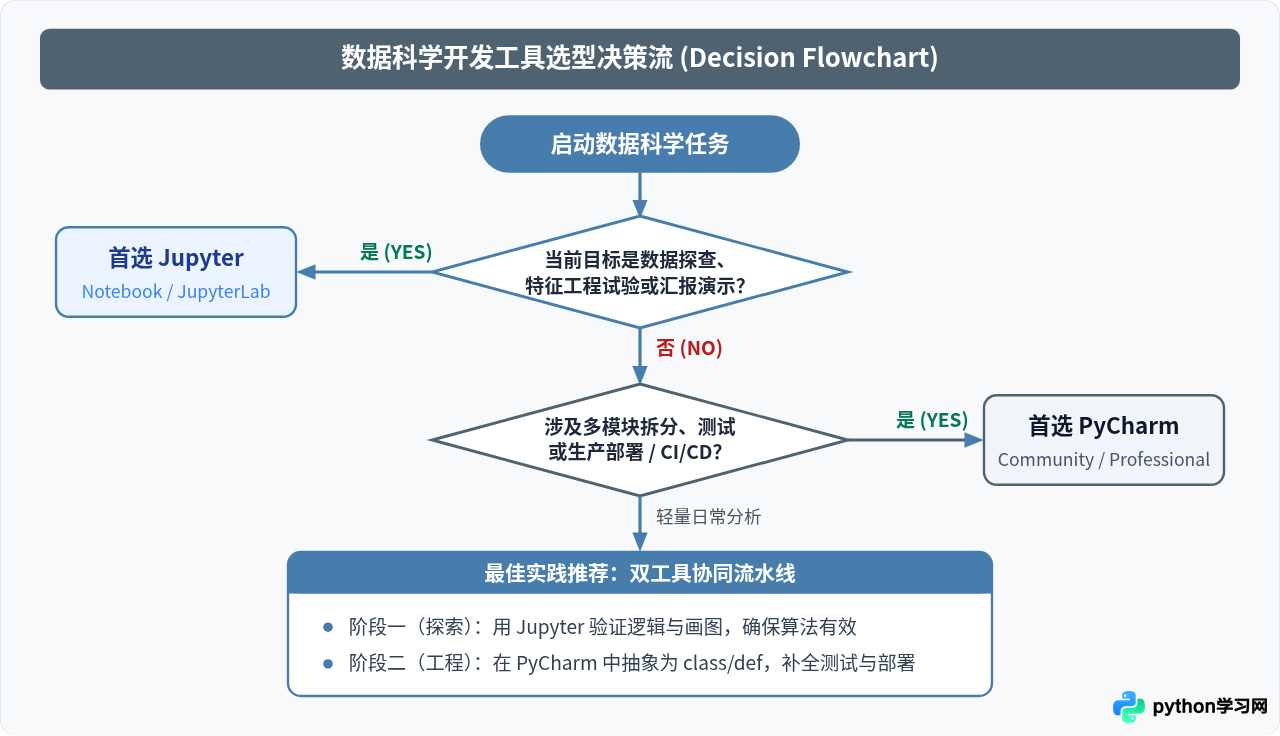
三、实际操作指南:从 Jupyter 探索到 PyCharm 工程化的四步过渡
成熟的数据科学项目绝不应长期停留在单一几千行的 .ipynb 文件中。以下是通过四步将探索成果迁移为稳健工程的规范步骤:
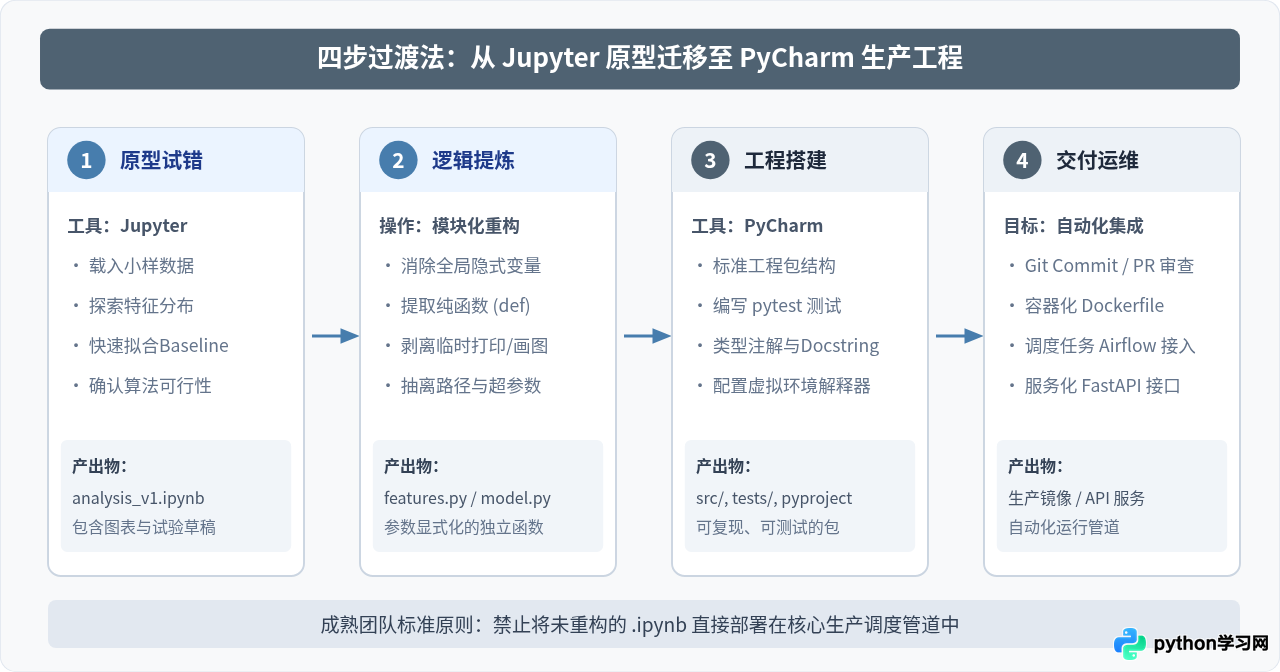
第一步:在 Jupyter 中完成最小可行探索(MVP)
在 Notebook 中快速验证数据预处理与模型思路。例如,读取数据样张,验证特定特征编码方法是否能有效提升评估指标:
# Jupyter Cell 探索示例
import pandas as pd
from sklearn.preprocessing import StandardScaler

df = pd.read_csv("data/raw_sample.csv")
scaler = StandardScaler()
df["norm_val"] = scaler.fit_transform(df[["val"]])
# 即时观察分布
df["norm_val"].describe()
第二步:提取逻辑为标准 Python 函数与模块
确认处理逻辑有效后,消除 notebook 中的全局硬编码变量与临时打印代码,将其重构为纯函数(Pure Function),明确输入参数与返回值,保存为 features.py:
# src/features.py
import pandas as pd
from sklearn.preprocessing import StandardScaler

def normalize_feature_columns(data: pd.DataFrame, col_name: str) -> pd.DataFrame:
    """标准化指定列,返回包含新字段的副本"""
    df_copy = data.copy()
    scaler = StandardScaler()
    df_copy[f"{col_name}_norm"] = scaler.fit_transform(df_copy[[col_name]])
    return df_copy
第三步:在 PyCharm 中搭建规范工程架构并补充单元测试
在 PyCharm 中打开项目目录,按照工业标准组织代码结构,配置独立的虚拟环境(venv 或 conda),并在 tests/ 目录下使用 pytest 编写自动化检验:
my_ds_project/
├── data/               # 本地测试数据(加入 .gitignore)
├── notebooks/          # 保留用于探索和汇报的 .ipynb 文件
├── src/                # 生产源码模块
│   ├── __init__.py
│   ├── features.py     # 特征提取函数
│   ├── pipeline.py     # 端到端运行管道
│   └── train.py        # 模型训练脚本
├── tests/              # 自动化单元测试
│   └── test_features.py
├── requirements.txt    # 明确依赖库版本
└── README.md
第四步:编写入口脚本并接入生产调度
通过提供标准命令行入口参数,使脚本可以脱离开发环境,在 Linux 服务器、Airflow 调度节点或 Docker 容器中无人值守运行:
# src/pipeline.py
import argparse
from features import normalize_feature_columns

def run_pipeline(input_path: str, output_path: str):
    df = pd.read_csv(input_path)
    processed = normalize_feature_columns(df, "val")
    processed.to_parquet(output_path)

if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="Data Processing Pipeline")
    parser.add_argument("--input", required=True, help="输入文件路径")
    parser.add_argument("--output", required=True, help="输出路径")
    args = parser.parse_args()
    run_pipeline(args.input, args.output)
四、综合能力对比与选型速查矩阵
为了让不同背景的工程师与分析师能一目了然地根据实际需求选择工具,下表与图 4 总结了六大关键技术维度的具体表现:
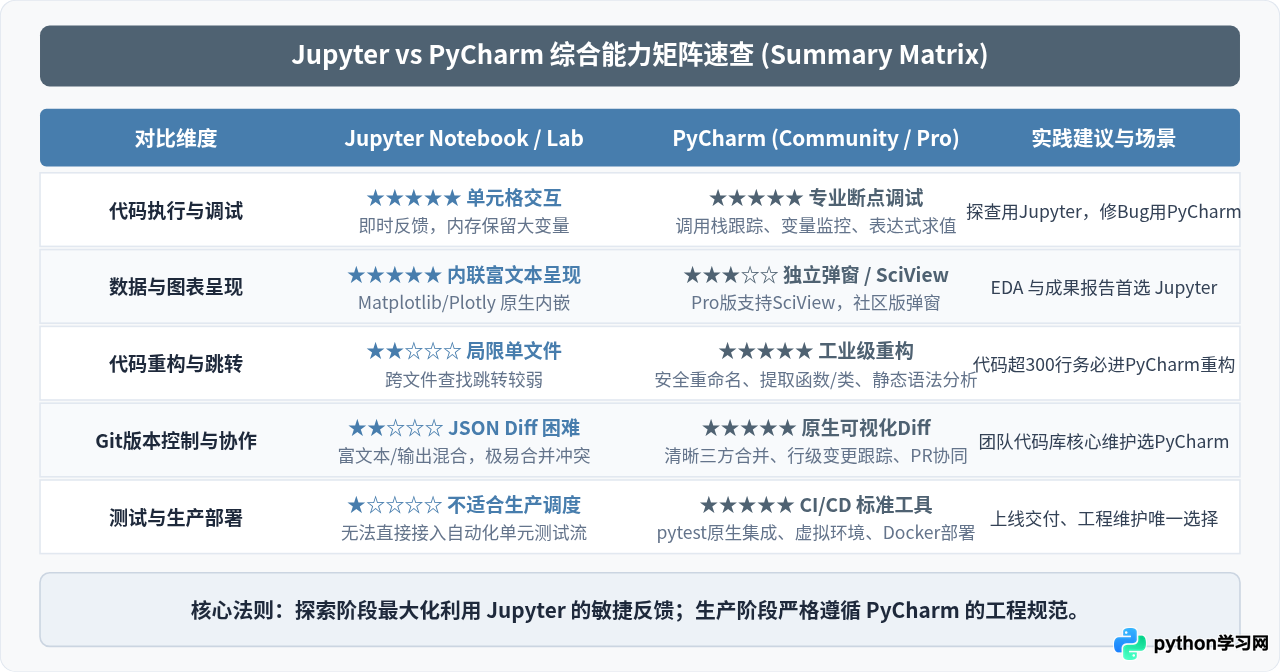
| 特性指标 | Jupyter Notebook / Lab | PyCharm (Community / Pro) | 典型推荐场景 |
|---|---|---|---|
| 反馈延迟 | 毫秒级(单元格即时返回) | 取决于全脚本启动开销 | 参数频繁微调、快速验算选 Jupyter |
| 内存占用处理 | 常驻内存,无需重复加载 | 进程退出即释放(除Python控制台) | 超大表格探查首选 Jupyter |
| 代码重构能力 | 弱(仅支持单文件文本替换) | 极强(跨文件安全重命名、提取类方法) | 项目超300行务必在 PyCharm 中维护 |
| 单步调试能力 | 较弱(依赖 print 或简易 pdb) | 极强(条件断点、帧调用栈、动态表达式计算) | 排查隐蔽业务逻辑 Bug 必用 PyCharm |
| 版本协同 (Git) | 容易产生大量 JSON 冲突 | 原生支持纯文本分支比对与冲突消解 | 团队主干分支管理首选 PyCharm |
| 生产交付支持 | 不推荐作为生产调度依赖 | 完整支持虚拟环境、Docker、CI/CD 构建 | 最终上线与微服务化必须使用 PyCharm |
五、提升效率的进阶技巧:打破工具壁垒
在日常工作中,你完全不必在两者之间做非黑即白的切割。以下三种技巧能帮助你在两者之间流畅穿梭:
- 在 Jupyter 中使用
%autoreload 2机制:当你在 PyCharm 中修改src/features.py时,无需重启 Jupyter 内核。只需在 notebook 开头添加:这样你在 PyCharm 里每改一行代码并保存,Jupyter 下一次调用该函数时就会自动同步最新逻辑,既享受了 IDE 的重构优势,又保留了交互运行的高效。%load_ext autoreload %autoreload 2 from src.features import normalize_feature_columns
- 使用 Jupytext 实现双向无损同步:安装
jupytext插件后,可将.ipynb实时与配对的纯文本.py脚本同步。平时在 Jupyter 中交互画图,向 Git 仓库提交时仅提交轻量的.py脚本,彻底根除 JSON 冲突困扰。 - PyCharm Professional 版的原生 Jupyter 支持:如果拥有 PyCharm 专业版授权,可以在 IDE 内直接打开并执行
.ipynb文件。右侧分栏直接提供交互式变量监视器(Variable Viewer)与图表预览窗口,兼顾 IDE 的代码补全与 Notebook 的分块运行。
初学者切忌“一把梭”:不要试图在单份 Notebook 里塞进几千行代码直接跑生产,也不要在连数据字段含义都没摸清时就急于在 PyCharm 中搭建过度封装的复杂面向对象框架。“以 Jupyter 探明未知,以 PyCharm 固化确定”,才是兼顾迭代敏捷性与系统工程质量的最优路线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









