

Polars1.39相比pandas做数据分析快在哪?
深入解析Polars 1.39相比传统pandas在数据分析中实现数倍至数十倍加速的核心原因。从Apache Arrow连续内存、查询优化器下推流水线、Rayon多线程并行调度到无索引流式计算,全面剖析两者的架构差异与实战选型指南。
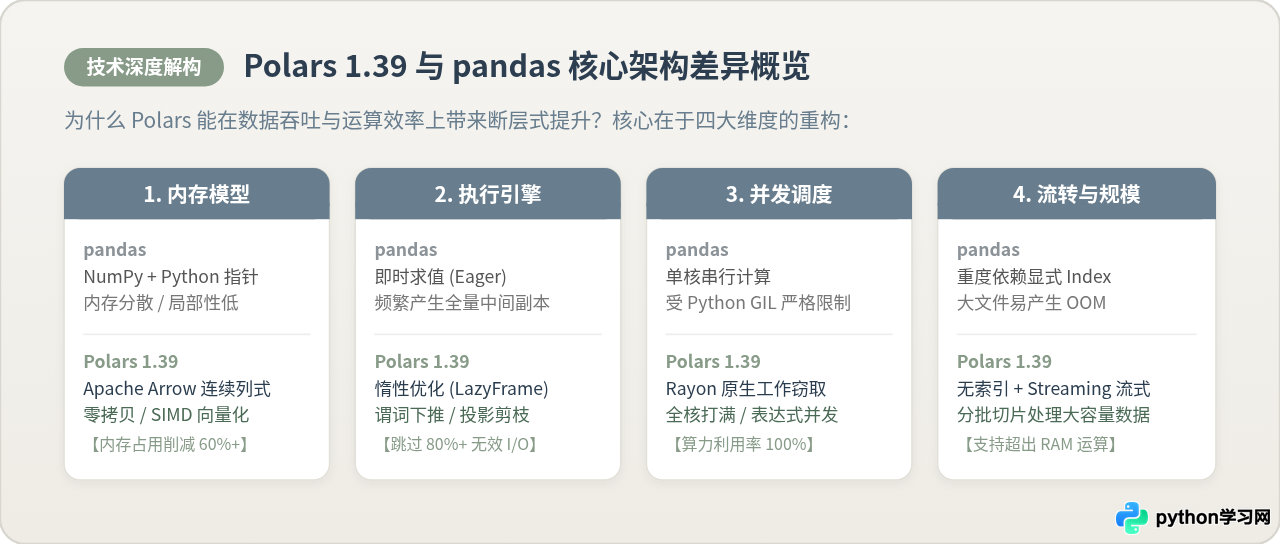
一、内存模型差异:Apache Arrow 列式连续内存 vs Python 对象指针
数据分析库在底层如何组织与存储数据,直接决定了运算的瓶颈所在。pandas 诞生于单核与内存相对充裕但结构简单的时期,其底层依赖 NumPy 数组。在处理纯浮点数或定长整数时,NumPy 表现稳定;但现代数据分析中包含大量字符串、时间戳、嵌套结构和缺失值(NaN/None)。
在 pandas 处理字符串或混合列时,其内存并非真正连续存储字符串内容,而是构建一个包含大量 Python 对象指针的数组(PyObject*)。每个指针指向堆内存中离散分配的 Python 字符串对象。这种布局带来了两个致命瓶颈:
- 极高的 CPU 缓存失效(Cache Miss): 现代 CPU 读取内存依赖高带宽的 L1/L2/L3 缓存行(Cache Line,通常为 64 字节)。当 CPU 试图遍历 pandas 字符串列时,每次通过指针访问堆内存都会跳跃到不同的内存地址,导致 CPU 缓存预取彻底失效,大量时钟周期浪费在等待内存控制器加载数据上。
- 显著的内存膨胀: 一个简单的字符串在 Python 解释器中除了自身内容外,还需要附带类型指针、引用计数等头部开销(至少数十字节)。这使得读取 1GB 的原始 CSV 文件,在 pandas 内存中常常膨胀为 3GB 至 5GB。
与此相反,Polars 1.39 原生以 Apache Arrow 规范作为核心数据结构。在 Arrow 格式下,所有列数据在物理内存中均是紧凑、连续对齐的二进制缓冲区,同时配合 Arrow 现代的 StringView 架构:较短的字符串直接内联存储,较长字符串则存储在连续的 Buffer 池中。
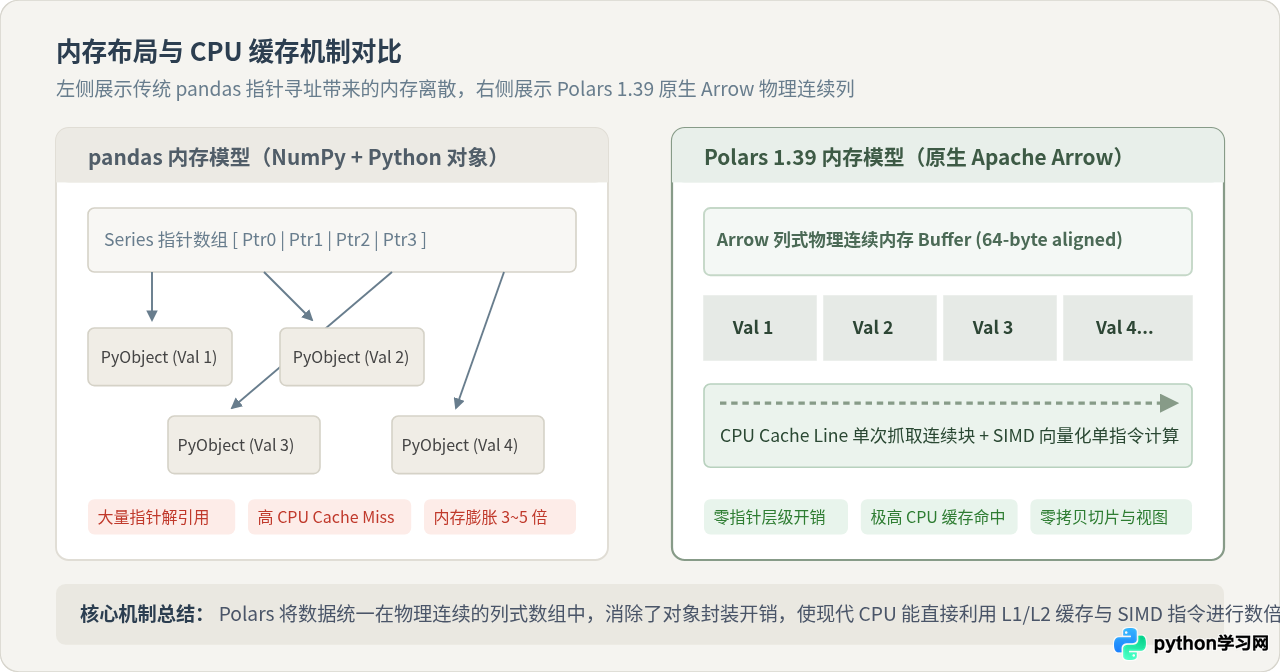
由于内存完全连续,CPU 在遍历数据时单次 Cache Line 即可填满多个连续字段,大幅提升了缓存命中率。更重要的是,连续的定长缓冲区允许现代编译器直接生成 SIMD(单指令多数据流,Single Instruction Multiple Data)指令集(如 AVX-512、NEON),单条指令即可并发对 8 个或 16 个数值执行运算。此外,在切片和投影操作中,Polars 可以直接复用底层 Arrow 缓冲区的内存偏移,实现真正的零拷贝(Zero-copy)。
代码场景示例:创建并统计混合类型数据
# 环境要求:Python 3.9+,安装 polars 1.39 与 pandas 2.x
# 执行位置:标准 Python 交互环境或脚本

# pandas 处理方式(存在大量指针解引用与内存开销)
import pandas as pd
df_pd = pd.DataFrame({
    "category": ["A", "B", "C", "A"] * 250000,
    "value": [10.5, 20.1, 15.3, 8.8] * 250000
})
# 运算时需遍历指针数组与单核计算
mean_pd = df_pd.groupby("category")["value"].mean()

# Polars 1.39 原生方式(Arrow 连续列与零拷贝切片)
import polars as pl
df_pl = pl.DataFrame({
    "category": ["A", "B", "C", "A"] * 250000,
    "value": [10.5, 20.1, 15.3, 8.8] * 250000
})
mean_pl = df_pl.group_by("category").agg(pl.col("value").mean())
二、执行引擎差异:惰性求值与查询优化器(LazyFrame)
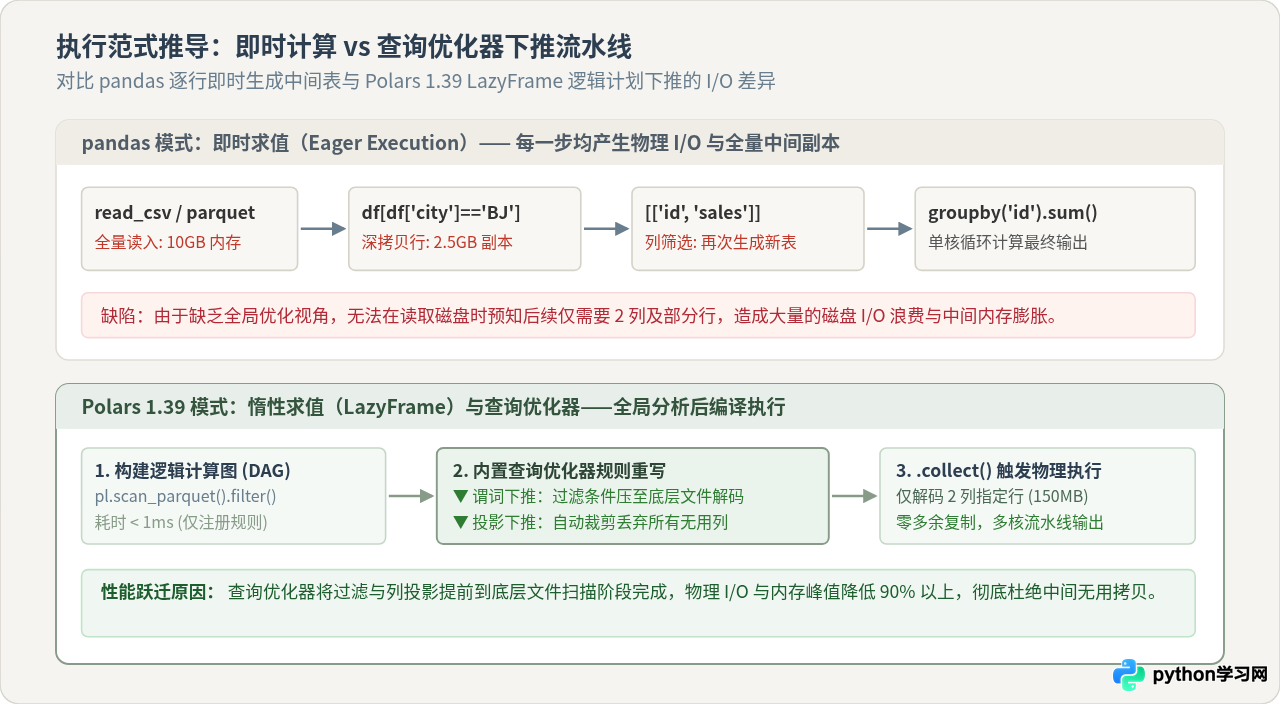
pandas 本质是一个即时求值(Eager Execution)系统。读者在编写 pandas 链式操作时,每一行代码的调用都会立即触发底层物理计算,并生成一个新的中间 DataFrame。
例如,面对一个 10GB 的日志文件,如果读者的意图仅仅是“筛选状态为活跃的用户并提取其订单总金额”,pandas 依然会先将整个 10GB 数据完整解析并分配到内存中;接着执行过滤操作,深拷贝生成一份 2GB 的活跃用户新表;最后再切片出所需字段。每一步的中间结果都需要分配内存、写入数据并在用完后等待垃圾回收(GC),造成了极大的 I/O 浪费与内存峰值风险。
Polars 1.39 则将惰性求值(Lazy Evaluation)作为一等公民推荐使用。当使用 pl.scan_csv() 或 pl.scan_parquet() 配合 .lazy() 时,Polars 并不立即读取数据,而是先构建抽象语法树和有向无环图(DAG 逻辑计划)。在调用 .collect() 触发真正的物理执行之前,Polars 内置的查询优化器(Query Optimizer)会自动执行一系列类似专业关系型数据库的优化规则:
- 谓词下推(Predicate Pushdown): 优化器将过滤条件(如
pl.col("status") == "active")一直推进到存储解码层。在读取 Parquet 或 CSV 时,Polars 直接跳过不符合条件的元数据行组(Row Groups),仅解压符合条件的少量行。 - 投影下推(Projection Pushdown): 优化器分析后续计算链条中所有被引用的字段,自动丢弃文件中未被使用的列。原本拥有 100 列的大表,如果后续只计算 2 列,Polars 在磁盘扫描阶段就只会加载这 2 列,从源头省去 90% 以上的 I/O 带宽。
- 公共子表达式消除: 如果一个复杂计算在后续多次被使用,优化器会统一计算一次并共享结果,避免重复计算。
代码对比:大规模文件筛选聚合
# 传统 pandas 做法:全量载入内存,中间产生多个临时深拷贝对象
df_raw = pd.read_parquet("sales_data.parquet")  # 全量 8GB 读取
df_filtered = df_raw[df_raw["region"] == "North"]  # 中间临时表
df_res_pd = df_filtered[["order_id", "amount"]].groupby("order_id").sum()

# Polars 1.39 推荐的 LazyFrame 做法:
# 仅构建计算计划,通过优化器下推谓词与投影
q = (
    pl.scan_parquet("sales_data.parquet")
    .filter(pl.col("region") == "North")       # 谓词下推至 Parquet 扫描器
    .select(["order_id", "amount"])            # 投影下推:只读取这两列
    .group_by("order_id")
    .agg(pl.col("amount").sum())
)
# 真正执行计算:此时只解码需要的行与列,极速完成
df_res_pl = q.collect()scan_*() 代替 read_*() 的习惯。只有在数据本身已在内存中,或进行即时单步探索时才使用 read_*()。
三、计算调度差异:基于 Rayon 的原生多线程并行 vs 单核 GIL 受限
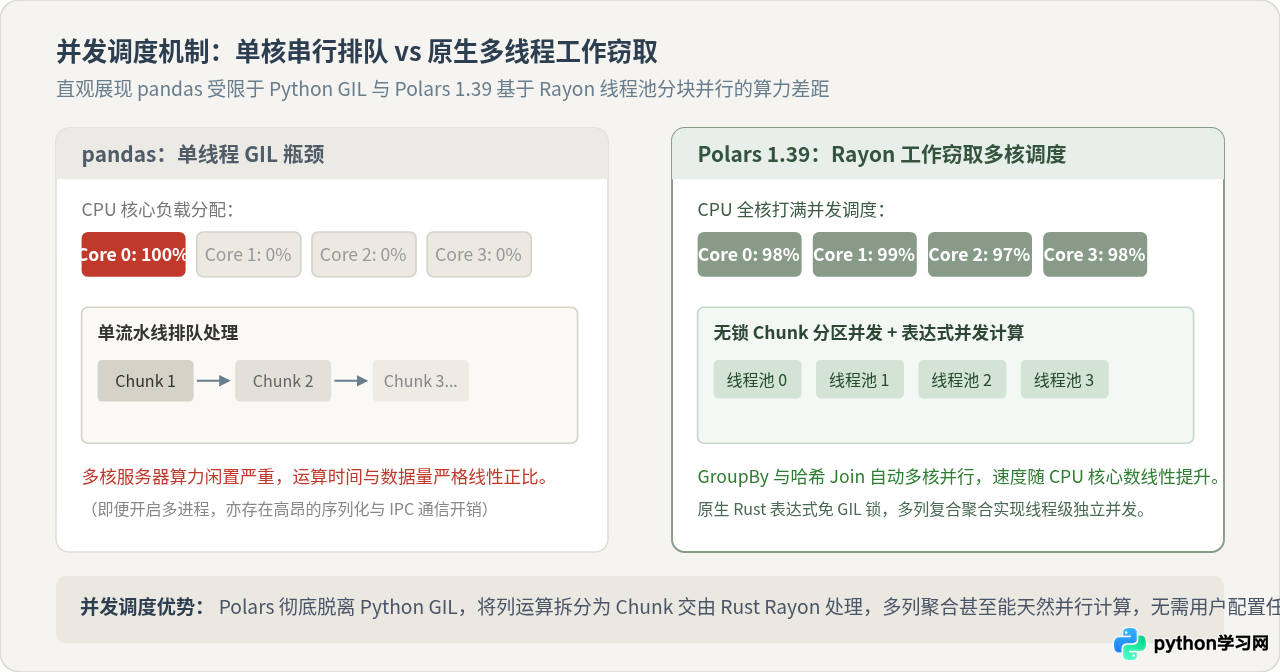
另一个导致执行时间悬殊的核心差异在于 CPU 算力的释放程度。pandas 的 Python 代码运行在 CPython 虚拟机之上,受到全局解释器锁(GIL)的制约。更关键的是,pandas 绝大多数核心算法(包括哈希分组 GroupBy、排序、透视表)在设计时便是单线程实现的。
这意味着,即便读者在配备 16 核或 64 核处理器的专业工作站上运行 df.groupby("id").sum(),操作系统的系统监视器中也通常只有一个 CPU 核心满载到 100%,其余所有核心均处于闲置状态。用户若想在 pandas 中利用多核,必须借助 multiprocessing 库或 Dask、Ray 等外围框架,而这会引入跨进程数据序列化(Pickle)的高昂通信损耗。
Polars 1.39 底层使用 Rust 编写,彻底摆脱了 Python GIL 的束缚。它采用 Rust 生态中成熟的 Rayon 工作窃取(Work-Stealing)并行调度器:
- 自动数据分块(Chunking): Polars 会将大规模列数组自动切分为多个 Chunk,并分发到不同的线程池中并发执行。
- 哈希分组与连接的天然并行: 在执行 GroupBy 聚合或 Hash Join 时,Polars 会将数据散列到不同的哈希桶中,每个工作线程独立负责一个桶的聚合,全程无锁或极少锁争用,计算吞吐随 CPU 核心数近乎线性增长。
- 表达式级并发调度(Expression Concurrency): 在 Polars 的单个
select()或with_columns()语句中,如果传入了多个相互独立的聚合表达式,Polars 会将不同列的计算任务分发到不同核心同时执行。
代码对比:多列独立表达式的并发计算
# Polars 1.39 表达式并发特性:
# 以下三个表达式在执行引擎中会被自动分配到多个 CPU 核心并行计算
result = df_pl.select([
    pl.col("sales").sum().alias("total_sales"),
    pl.col("cost").mean().alias("avg_cost"),
    (pl.col("sales") - pl.col("cost")).median().alias("median_profit")
])
# 在 pandas 中,用户通常需要串行写三行计算或调用单核聚合字典
四、算法与流转:无索引架构、不可变语义与流式计算(Streaming)
除了内存、优化器和多核并行,Polars 1.39 在 API 架构与数据流转设计上也做出了许多关键裁决,去除了传统工具链中的历史负担:
1. 彻底移除显式 Index(索引)
pandas 最具标志性的设计之一是行索引(Index,甚至 MultiIndex)。但在实际工程中,Index 往往是性能陷阱的源头:每次进行过滤、合并或连接后,pandas 都需要维护、重新计算或对齐 Index 的哈希映射,耗费了不可小觑的 CPU 周期;同时 loc、iloc 的复杂切片规则也增加了心智负担。
Polars 从第一天起就彻底放弃了显式行 Index。在 Polars 中,所有列都是平等的普通列。如果需要行号,可以使用 with_row_index() 显式生成。没有了索引对齐的开销,所有连接与变换操作都得以保持最高纯度的纯矢量计算。
2. 不可变数据流与严格规避防御性复制
熟悉 pandas 的读者一定遇到过令人困惑的 SettingWithCopyWarning。这是因为 pandas 内部难以判断当前切片究竟是原数据的“视图”还是“副本”,为了防止用户在意外修改视图时污染原数据,代码内部充斥着防御性深拷贝。
Polars 遵循函数式不可变数据结构原则:所有转换操作都会返回一个基于不可变 Arrow 数组的新引用或新结构,底层引用计数会自动管理只读内存;修改某一列时仅生成该列的新 Buffer,其余不变的列完全共享内存指针,从语法层面彻底消除了意外复制。
3. 流式计算(Streaming Engine):突破物理 RAM 限制
当数据规模超过单机物理内存时,pandas 唯一的结局就是抛出 MemoryError 或被操作系统内核 OOM 强制杀死。而在 Polars 1.39 中,惰性引擎内置了成熟的流式批处理能力:
# 当数据规模大于本机内存(如在 16GB 内存机器上处理 60GB 数据)
q_large = (
    pl.scan_parquet("huge_dataset/*.parquet")
    .filter(pl.col("amount") > 100.0)
    .group_by("user_category")
    .agg(pl.col("amount").sum())
)

# 开启 streaming=True,Polars 将以数据块(Batch)分流管道式处理,避免内存爆炸
streaming_result = q_large.collect(streaming=True)许多初学者迁移到 Polars 后,习惯性地调用
.map_elements(lambda x: ...)。一旦调用 Python 自定义 lambda,数据就会被迫逐行转换回 Python 对象并重新落入 GIL 锁保护,将 Polars 的多核与 Arrow 向量化优势抵消殆尽。在 Polars 中,99% 的场景都应使用原生表达式(如 pl.when().then().otherwise()、pl.col().str.slice() 等)进行矢量化计算。
五、技术选型与适用场景决策
尽管 Polars 1.39 在性能、吞吐量和内存占用上表现极其优异,但在实际工程与团队技术选型中,依然需要结合具体的项目阶段与上下游生态进行理性决策:
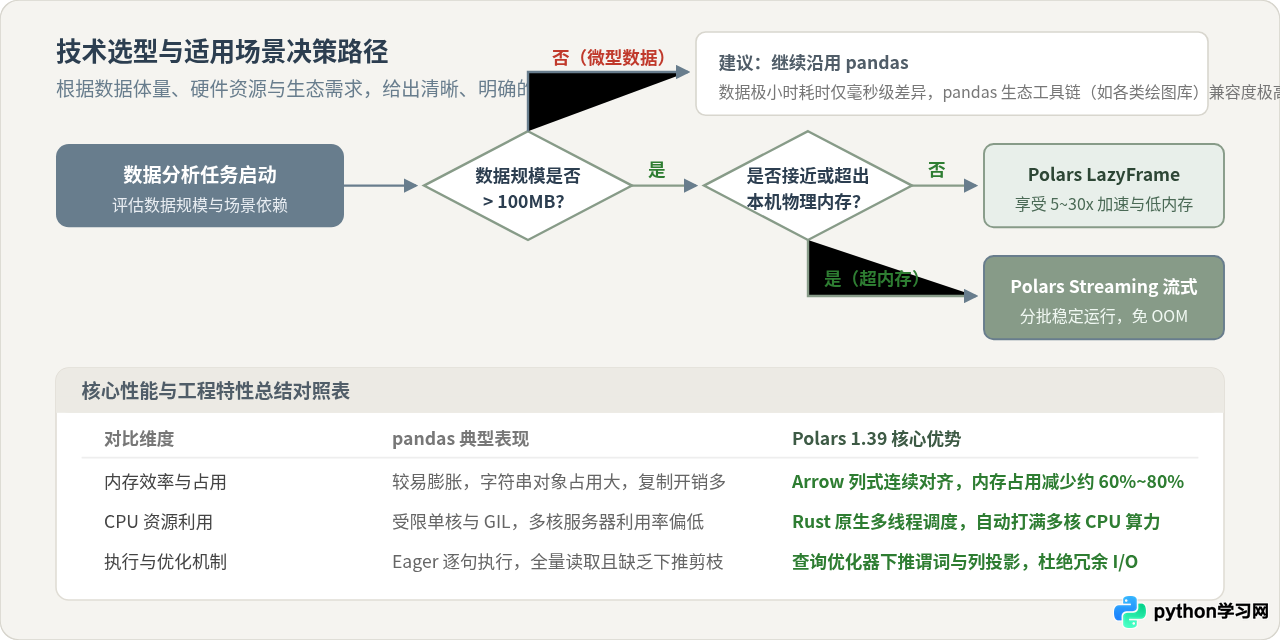
| 决策维度 | 继续沿用 pandas 的场景 | 推荐迁移至 Polars 1.39 的场景 |
|---|---|---|
| 数据规模 | 小于 100MB,单次运行仅几十毫秒,优化收益有限。 | 从数百 MB 到数十 GB,需要频繁聚合、筛选与关联的大表。 |
| 计算硬件 | 单核轻量服务器、边缘无依赖设备。 | 现代多核服务器(4核至128核),需要压榨硬件算力。 |
| 内存预算 | 内存充足(机器 RAM 为数据体积的 5 倍以上)。 | 内存吃紧,甚至数据体积大于物理 RAM,需流式或按需读取。 |
| 生态依赖 | 深度依赖仅支持 pandas 的老旧科学计算库或特定金融工具。 | 数据管道清洗(ETL)、特征工程、以 Parquet 为中心的现代湖仓架构。 |
总结
Polars 1.39 相比 pandas 的性能优势,是一场现代数据工程架构的整体升级:
- 内存层:以 Apache Arrow 为底层规范,用物理连续内存与紧凑布局替代了离散指针与对象封装,释放了 CPU 缓存命中率与 SIMD 矢量计算能力;
- 逻辑层:通过 LazyFrame 建立了查询优化器,在读取文件前完成谓词下推与列剪枝,彻底消除了冗余 I/O 与无用中间对象;
- 调度层:脱离 Python GIL,依托 Rust 的 Rayon 框架实现了工作窃取与多列并发调度,轻松跑满多核 CPU;
- 流转层:剔除显式 Index 对齐包袱,结合不可变语义与流式批处理引擎,大幅削减了内存峰值并支持超内存计算。
在实际生产环境中,将计算瓶颈严重的 pandas 管道重构为 Polars 1.39,不仅可以显著减少分析等待时间,更能将云端计算服务器的资源规格与内存成本压缩至原本的数分之一。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









