

Python3.14和3.13定义函数区别
深入对比 Python 3.14 与 Python 3.13 在定义函数时的核心区别,包括 PEP 649 延迟注解求值模型、前向引用处理、__annotate__ 机制与全新 annotationlib 内省库的实操与排查。
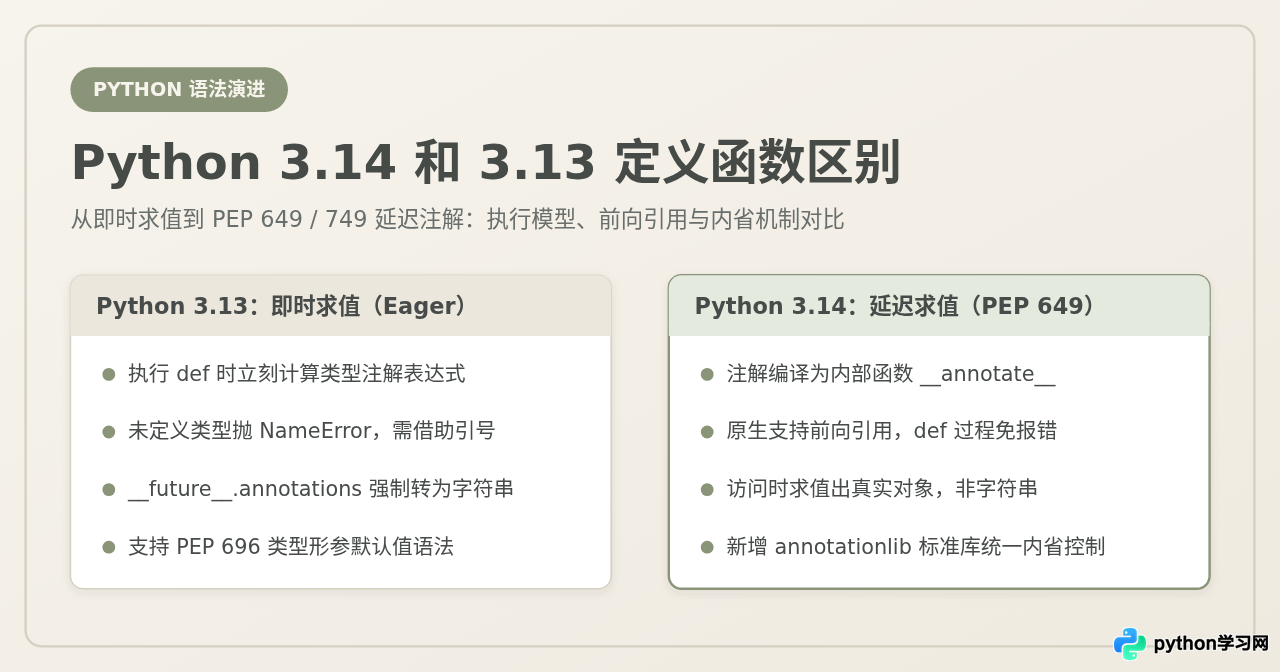
def 关键字定义函数的基础语法(形参声明、默认参数、*args、**kwargs 以及 3.13 引入的泛型类型参数默认值)完全一致。两者的核心区别在于函数注解的求值时机与底层存储模型:Python 3.13 在执行 def 语句时立即计算注解(或通过 from __future__ import annotations 全部转为静态字符串),而 Python 3.14(遵循 PEP 649 与 PEP 749)默认全面转向延迟求值(Deferred Evaluation),将注解打包为内部 __annotate__ 函数并按需执行。这一演进在无需引号与 future 语句的前提下原生解决了前向引用报错,并新增了标准库 annotationlib 进行精确反射控制。
一、语法层面的延续:def 声明与参数体系
许多开发者在接触 Python 3.14 的更新日志时,常会误以为 def 语句本身发生了破坏性改变。事实恰恰相反,在语言表层的函数声明语法上,Python 3.14 对 Python 3.13 保持了百分之百的向上兼容:
- 常规形参与位置/关键字限定:
def func(pos_only, /, standard, *args, kw_only, **kwargs):的定义方式没有任何语法变动。 - 默认参数求值时机:形参的默认值(如
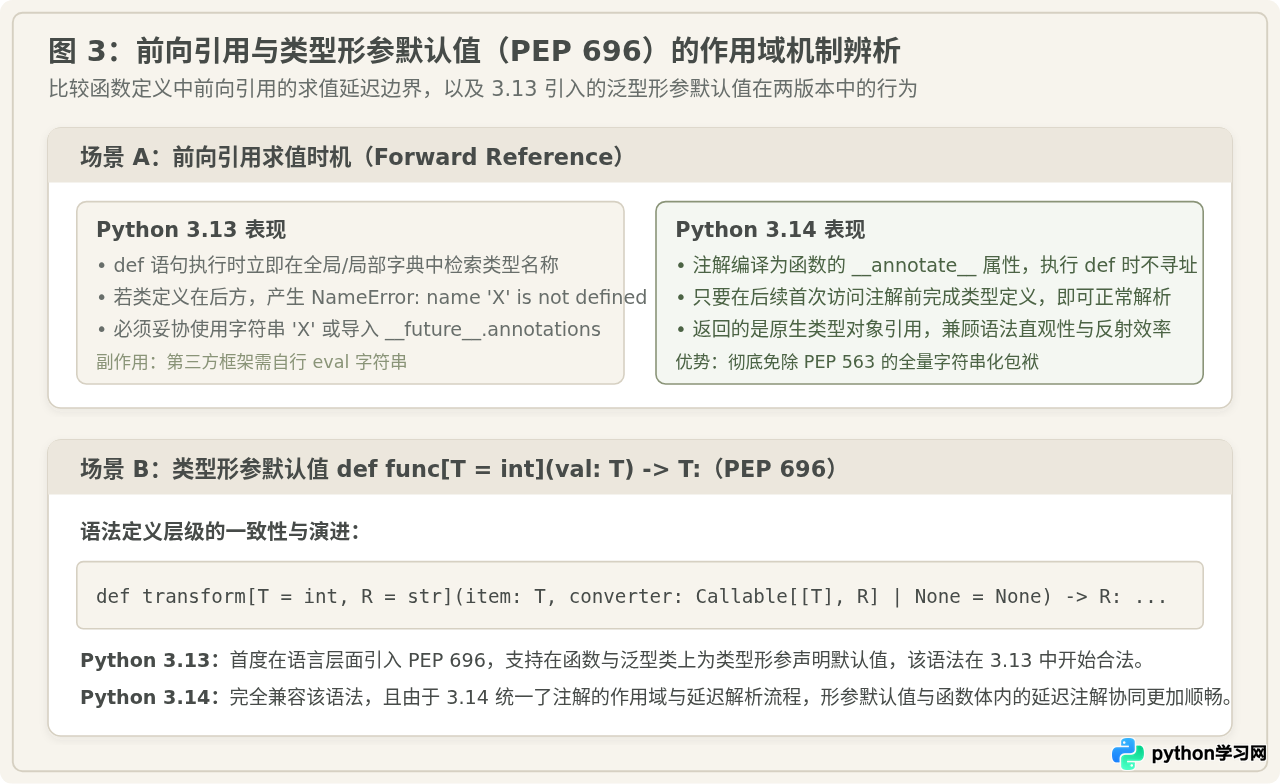
b=1或config=[])仍然在def语句执行时立即求值,这一点在两个版本中保持完全一致。 - PEP 696 类型形参默认值(Type Parameter Defaults):Python 3.13 在 PEP 695 泛型语法的基础上新增了类型形参默认值支持,允许编写类似
def parse[T = str](data: bytes) -> T: ...的定义。Python 3.14 完全沿用了这一语法规范,并在类型作用域的协同上表现得更加平滑。
既然编写 def 的语法外貌没有变,那么当解释器执行到这一行代码时,底层究竟发生了什么截然不同的事情?答案在于注解的“执行生命周期”。
二、核心机制演进:从即时求值到延迟注解(PEP 649 / 749)
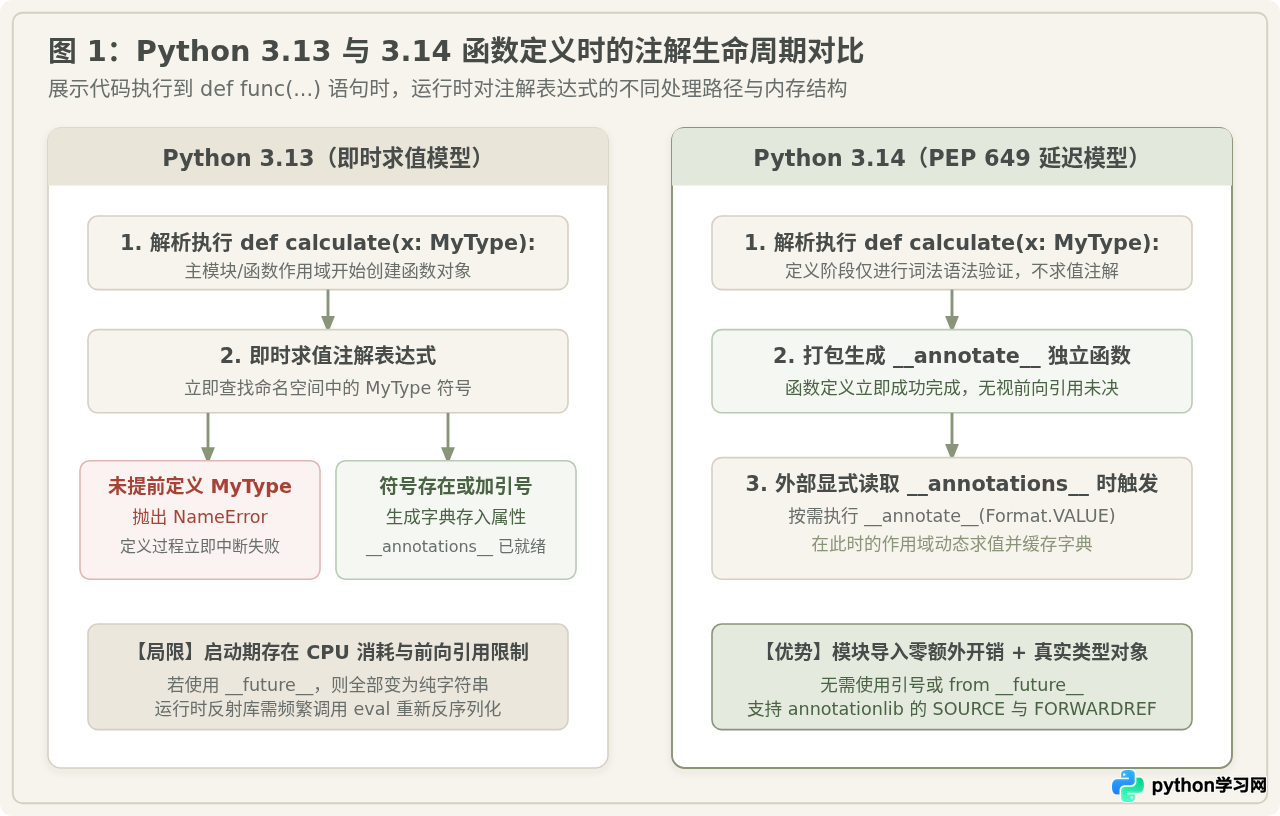
在 Python 3.13 及更早版本中,函数注解遵循的是即时求值(Eager Evaluation)模式。当解释器执行模块并解析到某个带有注解的 def 语句时,不仅会分配函数对象,还会同步执行注解中的所有 Python 表达式,把计算结果组装成一个标准字典并绑定到 func.__annotations__。
这种机制带来两个深层次痛点:
- 导入期性能消耗:在拥有海量数据模型与函数注解的中大型工程中,模块 import 时需要为成百上千个类型表达式(包括复杂的
Union、泛型嵌套等)分配内存并运行解释器指令,拖慢了应用启动速度。 - 前向引用死锁:如果函数参数的类型标注引用了当前文件后方尚未定义的类,或者产生互相依赖的自引用,解释器在执行
def瞬间就会直接因找不到符号而崩溃。
Python 3.14 通过采纳 PEP 649(使用描述符延迟求值注解) 与 PEP 749(Python 3.14 具体实现规范),从根本上重塑了函数定义的执行过程:
当 Python 3.14 执行 def 语句时,编译器不再直接计算注解表达式,而是将它们编译为一个专用的内部代码对象,挂载在函数的 __annotate__ 属性上。函数对象的创建过程轻量且瞬时完成。只有当程序后续明确读取 func.__annotations__ 字典,或通过内省 API 获取注解时,__annotate__ 函数才会被触发运行,计算真实对象并缓存起来供后续复用。
三、代码行为差异:前向引用(Forward Reference)实测
前向引用是 Python 日常开发中最为高频的痛点。我们通过一段具有代表性的树节点添加函数,来直观对比两版解释器在执行完全相同的源码时的行为差异。
1. 场景代码:在类声明前定义关联函数
# demo.py
def link_nodes(parent: TreeNode, child: TreeNode) -> TreeNode:
    parent.children.append(child)
    return parent

class TreeNode:
    def __init__(self, val: int):
        self.val = val
        self.children: list[TreeNode] = []

print("定义加载成功")
2. 在 Python 3.13 环境下的执行表现
在标准的 Python 3.13 解释器中直接运行上述代码,定义 link_nodes 阶段就会直接中断:
为了在 Python 3.13 中修复此问题,开发者必须做出妥协:
- 妥协方案 A(字符串字面量):写成
def link_nodes(parent: 'TreeNode', child: 'TreeNode') -> 'TreeNode':。这导致类型检查虽能工作,但失去了原生符号的高亮与重命名重构便利。 - 妥协方案 B(PEP 563):在文件第一行加入
from __future__ import annotations。该指令会将模块内所有注解统一转换为纯文本字符串。虽然NameError消失了,但 Pydantic、FastAPI、Dependency Injector 等依赖运行时实际类型对象的库,就必须在反射阶段消耗大量 CPU 运行eval()重新解析,并频繁遭遇复杂的局部命名空间缺失问题。
3. 在 Python 3.14 环境下的执行表现
同样的文件,在未添加任何 __future__ 语句且未使用引号包裹的前提下,直接由 Python 3.14 解释器运行:
def link_nodes(...) 顺利通过。因为注解表达式被延迟存入 link_nodes.__annotate__,在文件自上而下执行完第 6 行的 class TreeNode 之后,全局作用域中的 TreeNode 符号已经就绪。此时若去访问注解,就能直接获得真实的 <class '__main__.TreeNode'> 对象,兼具书写直观性与反射高效性。
四、实操步骤:在 Python 3.14 中进行注解内省与排查
伴随着延迟求值机制的落地,Python 3.14 正式新增了标准库 annotationlib。过去常用的 inspect.get_annotations() 在 3.14 中底层已被更新以对接新模型,而新项目推荐直接使用 annotationlib 进行精确控制。
下面是验证与调试定义函数注解的标准操作路径:
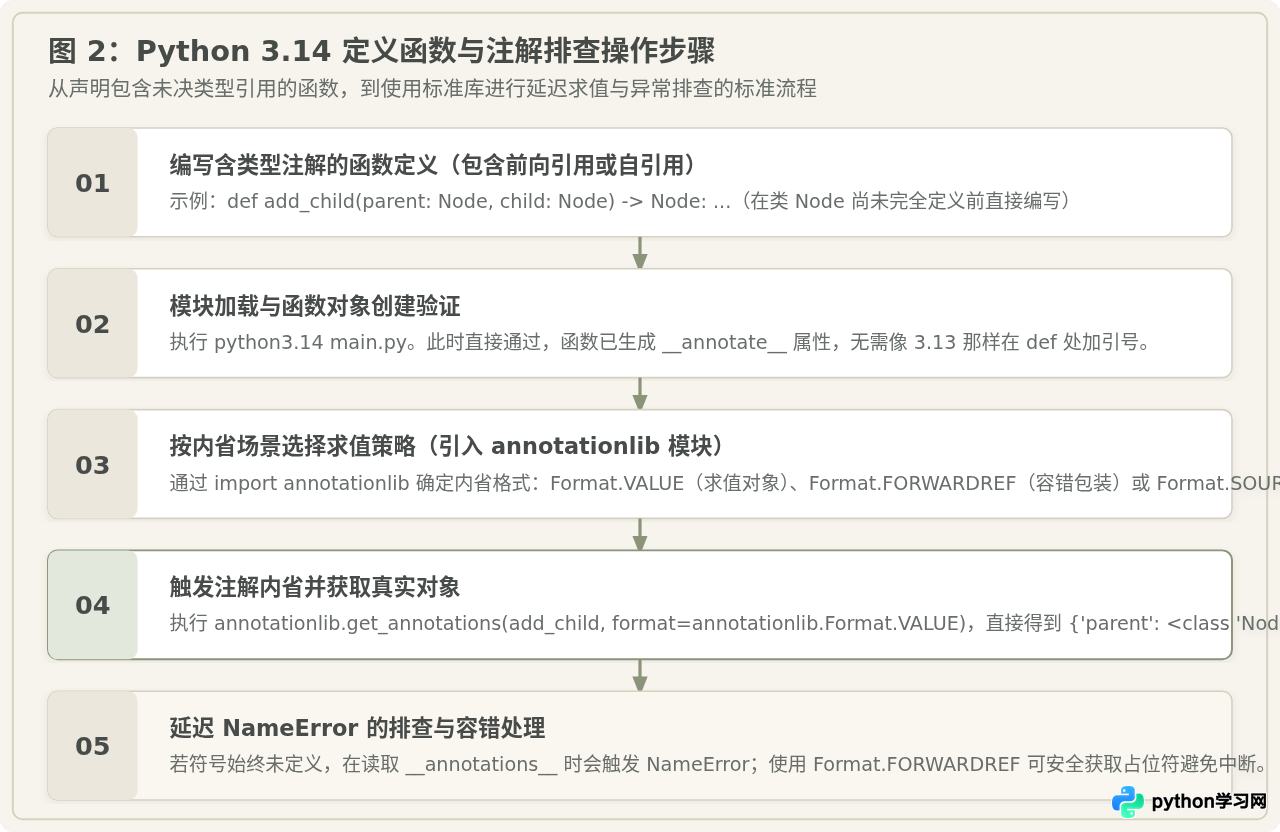
步骤 1:直接定义包含延迟引用的函数
在模块内正常编写函数声明,对于后续定义的业务实体、互相引用的数据模型均无需特殊标注:
# validator.py
def process_record(record: RawPayload, strict: bool = False) -> ProcessedResult:
    return ProcessedResult(record.data, valid=True)

class RawPayload:
    def __init__(self, data: dict):
        self.data = data

class ProcessedResult:
    def __init__(self, data: dict, valid: bool):
        self.data = data
        self.valid = valid
步骤 2:使用 annotationlib.get_annotations 提取真实对象
当框架或调试脚本需要内省该函数的参数类型时,导入 annotationlib 并使用 Format.VALUE:
import annotationlib

# Format.VALUE 为默认求值模式,返回实际 Python 类型对象
hints = annotationlib.get_annotations(process_record, format=annotationlib.Format.VALUE)
print("真实对象内省结果:", hints)步骤 3:面对永久缺失符号时的安全回退(Format.FORWARDREF)
如果某处注解引用的符号在运行时确实不存在(例如由可选插件引入的模块被遗漏),直接读取 __annotations__ 会在访问时刻抛出延迟的 NameError。此时可以使用 Format.FORWARDREF 格式进行安全内省:
def export_job(handler: OptionalExternalEngine) -> None:
    pass

# 不会抛出 NameError,而是将未解符号包裹为 ForwardRef 对象
safe_hints = annotationlib.get_annotations(export_job, format=annotationlib.Format.FORWARDREF)
print("安全模式解析:", safe_hints)

# 获取源码字符串形式(替代过去字符串模式的需求)
source_hints = annotationlib.get_annotations(export_job, format=annotationlib.Format.SOURCE)
print("源码文本解析:", source_hints)五、常见易混淆说法辨析
在版本过渡期间,社区中容易产生一些概念混淆。了解这些说法的合理性与适用边界,有助于更准确地掌握技术细节。
为什么看似合理:在 3.14 中故意写一个完全不存在的名字(如 def f(x: NoSuchClass): pass),执行该定义语句时解释器确实静默通过,不会中断程序启动。
修正与边界:该说法并不准确。这只是求值时机推迟,而非语法检查被取消。语法错误(例如写了非法语法符号 def f(x: [1,,2]):)在编译阶段依然会立即拦截;同时,一旦业务代码或框架(如 FastAPI 启动构建路由依赖)去读取 f.__annotations__,且此时 NoSuchClass 仍未定义,解释器便会在该访问语句处精准抛出 NameError。
为什么看似合理:PEP 563 原定计划将 __future__.annotations 变为语言默认行为,而 Python 3.14 采用了 PEP 649 作为替代路径,解决了 PEP 563 的全量字符串化缺陷。因此有人推断 __future__.annotations 已被废弃删除。
修正与边界:该指令并未被删除。在 Python 3.14 中保留该导入语句是为了向下兼容旧有代码库。在声明了该语句的文件中,解释器会遵循适配规则进行平滑过渡,但官方与社区均推荐在新项目中停止添加该 future 导入,直接享受原生的延迟求值特性。
为什么看似合理:既然注解不是一次性预先算好的,有人担心每次调用该函数时都会触发重新计算。
修正与边界:普通的函数执行(如 result = add(1, 2))在字节码层面根本不会访问函数的 __annotations__ 或 __annotate__。延迟计算只在外部显式访问元数据属性时发生,且首次计算完成后结果会被自动缓存,不会对高频函数执行带来任何额外性能惩罚。
六、全维度对比总结与迁移建议
为方便快速查阅,下表汇总了 Python 3.13 与 Python 3.14 在定义函数时的全部关键技术指标:
| 对比维度 | Python 3.13 | Python 3.14 |
|---|---|---|
| def 声明基础语法 | 完全保留标准语法;支持 PEP 695 泛型参数及 PEP 696 参数默认值。 | 语法保持完全一致,无新增关键字或破坏性变动。 |
| 注解求值时机 | 即时求值(Eager):执行 def 语句时立即计算表达式并生成字典。 |
延迟求值(Lazy):打包至 __annotate__ 独立函数,按需惰性计算。 |
| 前向引用处理 | 必须使用字符串字面量('Type')或 from __future__ import annotations。 |
原生支持:未加引号的类型只要在首次读取注解前就绪即可顺利解析。 |
| 注解内省结果类型 | 常规为真实对象;若启用 future 模式则全量降级为纯文本 str。 |
始终为真实 Python 类型对象(可按需通过 API 切换为 ForwardRef 或源码)。 |
| 内省标准库 API | 主要依赖 inspect.get_annotations() 与 typing.get_type_hints()。 |
新增专用的 annotationlib 标准库,支持 VALUE、FORWARDREF、SOURCE 三种格式。 |
| 模块启动性能与内存 | import 时计算所有注解,大型复杂项目中存在可观的 CPU 周期与内存占用。 | 仅生成轻量代码对象;在不使用运行时内省的代码路径中开销趋近于 0。 |
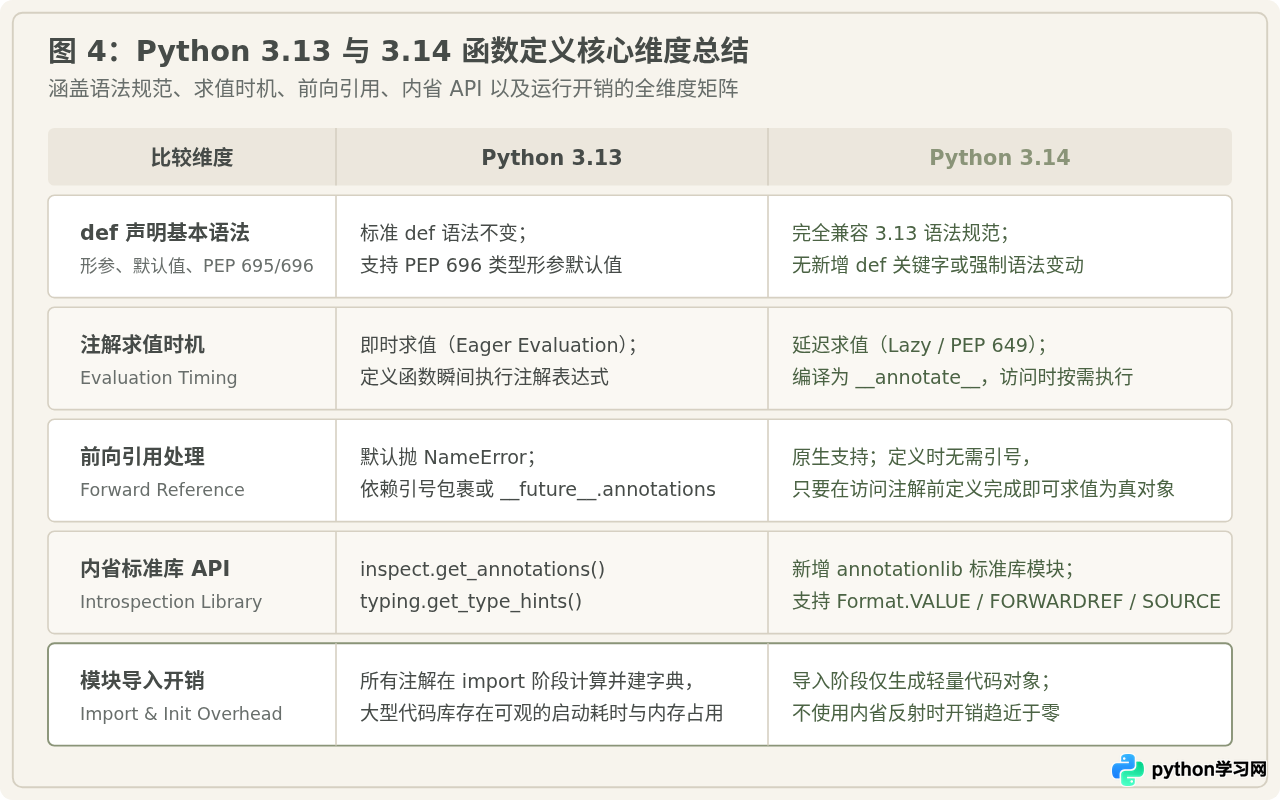
版本迁移与编写建议:
- 业务与应用开发:在 Python 3.14 环境下,编写带有自引用、复杂树形结构或循环依赖的数据函数时,无需再在文件开头机械性地粘贴
from __future__ import annotations,也不用再为前向引用添加难看的字符串引号。 - 框架与库作者(如 ORM、序列化器、CLI 框架):应当适配
annotationlib模块,使用annotationlib.get_annotations(func, format=...)替代手写的eval()解析逻辑,从而在 3.14 环境中获得显著的元数据解析性能提升与更高的健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









