

Python 3是什么:现代编程语言的核心特性与设计哲学
深入解析Python 3的语言定位、运行模型、现代核心特性与设计哲学,通过结构图示与代码示例全面阐释现代Python的技术演进与工程实践边界。
一、定义与本质:Python 3 的核心定位与运行机制
理解 Python 3,首先需要厘清它的三个基础技术属性:解释型执行模型、动态类型判定与强类型约束。
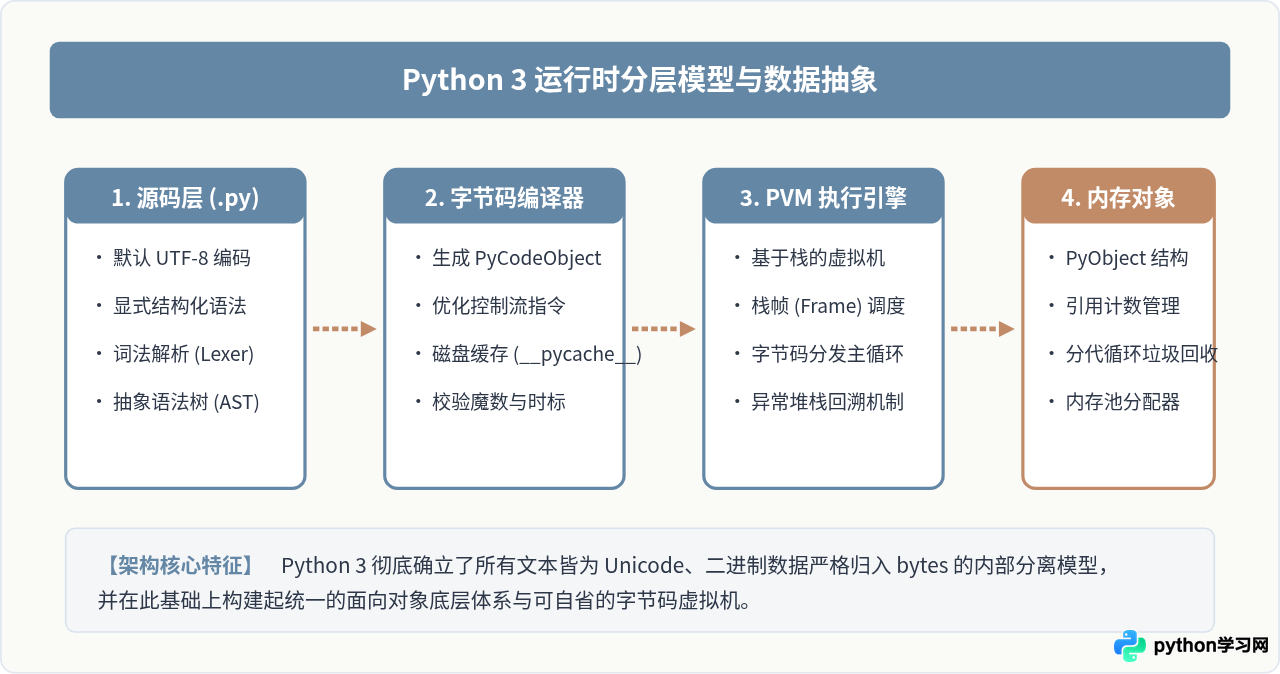
在执行机制上,Python 通常由 C 语言编写的官方参考实现(CPython)进行解析。当开发者执行一个 .py 脚本时,CPython 并不直接将代码翻译为机器指令,而是先将其编译为紧凑的字节码(Bytecode),并缓存在 __pycache__ 目录中的 .pyc 文件内;随后,Python 虚拟机(PVM, Python Virtual Machine)逐条读取并执行这些字节码。这种两阶段设计赋予了 Python 跨平台的通用性与灵活的运行时自省能力。
在类型系统上,初学者常将“动态类型”与“弱类型”混淆。Python 3 是典型的动态强类型语言。“动态”意味着变量在声明时无需标注具体类型,变量名仅仅是绑定到内存中对象的引用指针;而“强类型”则指运行时绝不允许隐式的非兼容类型转换。例如在 Python 3 中,表达式 "2" + 1 会直接触发 TypeError,绝不会像弱类型语言那样隐式将数值转换为字符串拼接。
二、设计哲学:驱动语言决策的核心准则
任何编程语言的语法细节,都是其背后设计哲学的具象化体现。在 Python 交互式环境中输入 import this,即可看到著名的“Python 之禅”(The Zen of Python,PEP 20)。在 Python 3 的演进过程中,有四项准则起到了决定性作用:
-
显式优于隐式(Explicit is better than implicit):
这是 Python 3 砍掉 Python 2 诸多妥协特性的首要法则。例如类实例方法定义中必须显式声明
self,避免隐式魔法上下文的引入;字典键名比较必须类型兼容,杜绝不可预期的自动隐式类型互转。 -
可读性至上(Readability counts):
Python 坚持使用严格的代码缩进强制划分代码块,取代了传统语言常见的花括号
{}或begin...end。这一设计强制统一了整个生态的排版范式,使不同程序员编写的代码具有极高的一致性与可读性。 - 用一种且最好只有一种显而易见的方式去解决问题(There should be one-- and preferably only one --obvious way to do it): 这一条法则直接划清了 Python 与 Perl 等“条条大路通罗马”语言的界限。Python 3 宁可减少冗余的重叠语法糖,也要保留最清晰、最容易排查和推理的标准路径。
- 简单优于复杂,复杂优于混乱(Simple is better than complex, Complex is better than complicated): 在面对工业级软件的复杂性时,Python 倾向于通过分层的简单模块去化解问题,而不是将单一工具复杂化。
三、核心技术特性与现代演进
当代广泛使用的 Python 3(尤其是 Python 3.8 至 3.12+ 系列)已经完成了从传统脚本语言向大型工程化工业语言的蜕变。以下四大核心特性构成了现代 Python 3 的技术支柱:
1. 严格的文本与二进制类型边界
在 Python 2 时代,处理编码常会遭遇臭名昭著的 UnicodeDecodeError,核心原因在于 str 默认代表原生字节串,与 unicode 之间存在隐式的自动解码逻辑。
Python 3 对此进行了彻底修正:
str:纯粹的字符文本,底层默认使用 Unicode 进行抽象表达。bytes:纯粹的二进制序列,代表不可分割的 8 位字节块。
二者之间没有隐式转换通道,网络传输或磁盘读取的原始字节必须显式调用 .decode() 才能转化为文本,文本写入外设前必须显式调用 .encode()。这一改变在源头上杜绝了绝大多数由于平台环境字符集差异导致的数据污染。
# 现代 Python 3 中的显式转换规范
raw_data: bytes = b"\xe4\xbd\xa0\xe5\xa5\xbd"
text: str = raw_data.decode("utf-8")  # 明确指定编码进行解码
print(f"解析结果: {text}")

encoded_bytes: bytes = text.encode("utf-8")  # 显式编码回字节流
assert encoded_bytes == raw_data
2. 渐进式类型提示系统(Type Hints)
大型软件项目的维护困难往往源于动态语言无法在编译期获知函数签名契约。Python 3.5 引入了 PEP 484,确立了渐进式类型系统。
需要明确的是,Python 3 的类型注解在运行时完全不参与强制校验,依然保持极高的动态敏捷性;但它允许现代 IDE(如 PyCharm、VS Code)和静态分析工具(如 mypy、pyright)在编写阶段提供毫秒级的错误诊断与自动补全。
from typing import Optional, List
from dataclasses import dataclass

@dataclass
class ServiceNode:
    name: str
    ip: str
    port: int
    is_active: bool = True

def find_available_port(nodes: List[ServiceNode], target_name: str) -> Optional[int]:
    for node in nodes:
        if node.name == target_name and node.is_active:
            return node.port
    return None
3. 原生异步 I/O 与协程生态(async/await)
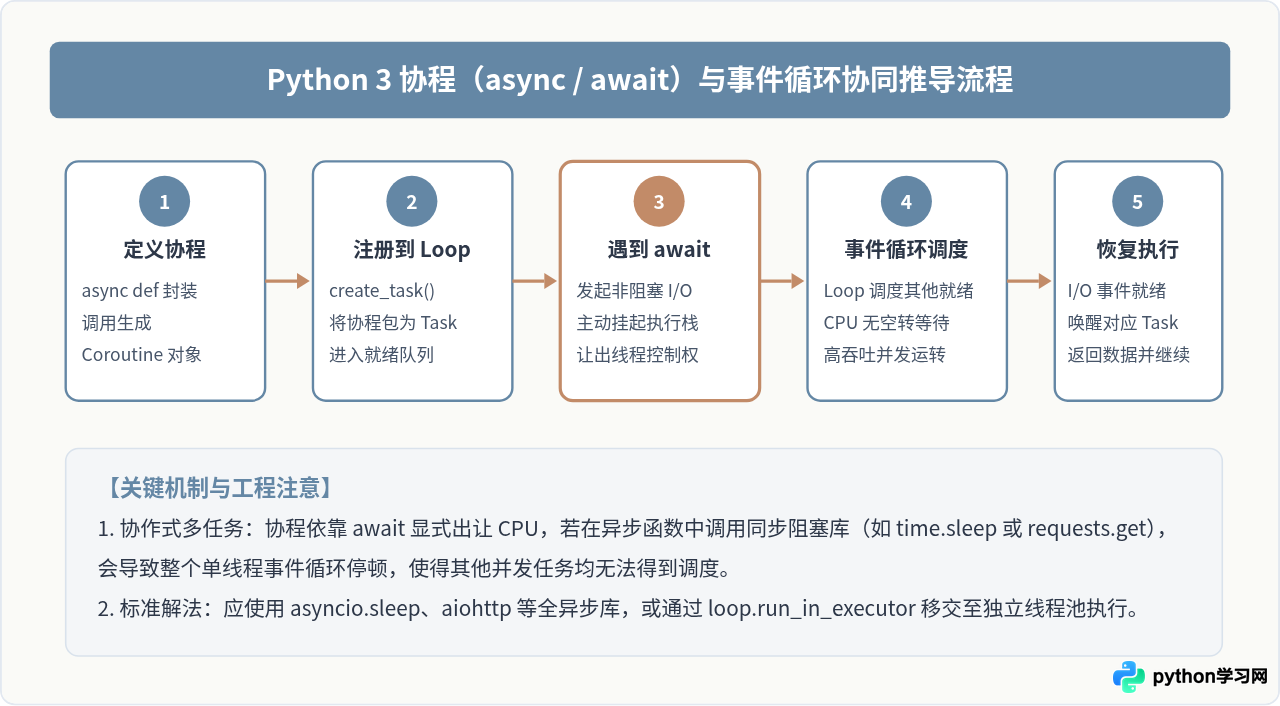
在处理高并发网络连接或分布式 I/O 密集型任务时,传统多线程受制于操作系统的线程切换开销与 CPython 的全局解释器锁(GIL)。Python 3 确立了以 asyncio 为基础的原生协程体系。
开发者通过 async def 声明协程函数,通过 await 关键字在发生网络或磁盘 I/O 等待时显式出让 CPU 控制权。事件循环(Event Loop)可以在单线程内高效轮询调度数以万计的并发任务,极大地推动了以 FastAPI、aiohttp 等为代表的新一代现代高性能服务端框架的发展。
4. 表达力革新:模式匹配与现代语法机制
Python 3 在保持简洁语法的核心前提下,逐步引入了多个极具表现力的新特性:
-
结构化模式匹配(Structural Pattern Matching,Python 3.10+):
match ... case远不止是其他语言中的switch-case,它具备深度解构映射、匹配对象属性和条件过滤的能力。 -
海象赋值表达式(Walrus Operator
:=,Python 3.8+): 允许在表达式内部完成变量赋值,大幅精简诸如正则表达式匹配、文件分块读取中的样板代码。 -
内置数据类的标准化(dataclasses,Python 3.7+):
通过装饰器声明式定义数据承载模型,自动合成
__init__、__repr__和比较方法。
# Python 3.10+ 结构化模式匹配示例
def handle_command(event: dict) -> str:
    match event:
        case {"type": "ping"}:
            return "pong"
        case {"type": "auth", "token": str(token)} if len(token) >= 32:
            return f"用户授权成功, 凭证指纹: {token[:8]}..."
        case {"type": "auth", "token": _}:
            return "鉴权失败: 凭证格式或长度非法"
        case {"type": "execute", "actions": [head, *tail]}:
            return f"优先执行核心指令: {head}, 剩余排队任务: {len(tail)} 个"
        case _:
            return "未知的协议指令"
四、历史鸿沟的弥合:Python 2 到 Python 3 的体系演进
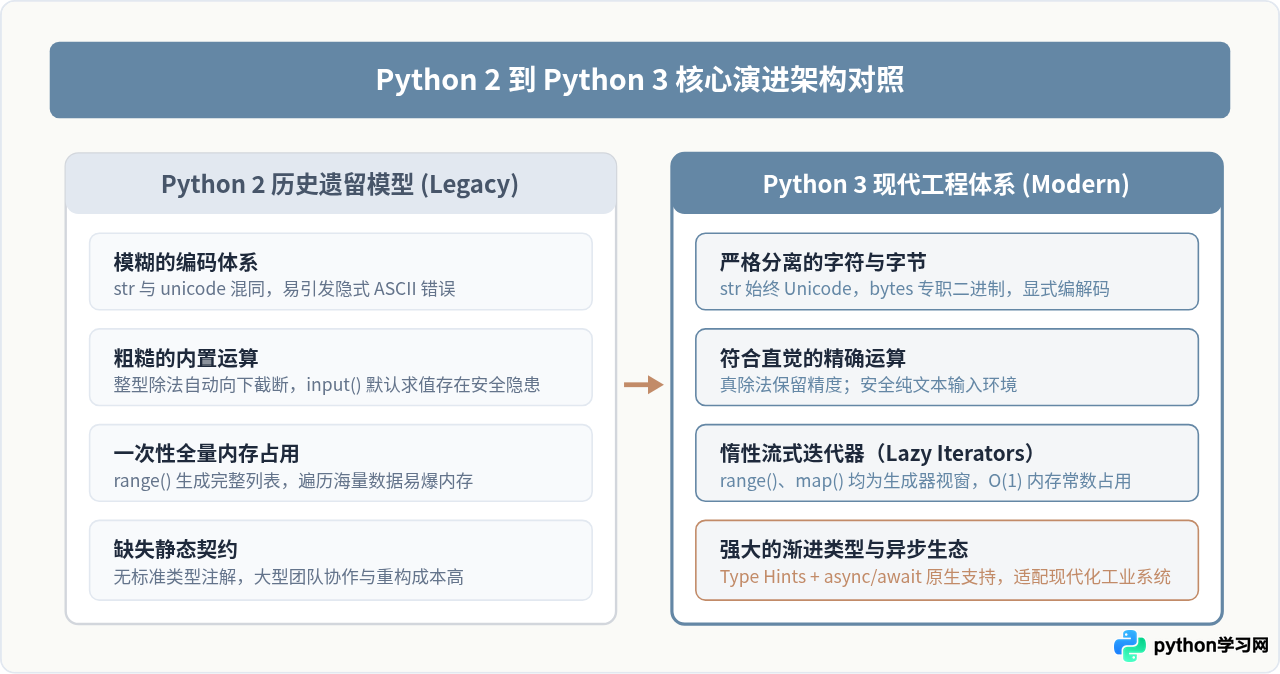
在 Python 的发展史上,从 2.x 到 3.x 曾经历过长达数年的“阵痛期”。Python 社区之所以宁可打破向后兼容性(Backward Incompatibility),也要彻底推行 Python 3,是因为 2.x 版本存在多项无法自洽修补的底层设计缺陷。下表清晰总结了这两代版本之间的关键分水岭:
| 特性维度 | Python 2(历史旧方案) | Python 3(现代标准) | 设计决策背后的技术价值 |
|---|---|---|---|
| 文本与字节 | str 为字节串,unicode 为文本;存在隐式混合转换 |
str 严格为 Unicode 字符,bytes 为纯字节 |
从语法根源阻断字符编码隐式错位,彻底解决乱码与系统崩溃 |
| 除法运算 | 3 / 2 == 1(整数除法截断为整型) |
3 / 2 == 1.5(真除法),整除使用 // |
符合人类直觉与通用数学规律,避免隐蔽的数值截断误差 |
| 集合运算效率 | range()、map() 直接返回完整 list |
返回惰性求值迭代器(Iterator / View) | 极大削减大规模数据处理时的内存峰值开销 |
| 输入函数 | input() 会对内容求值(eval),raw_input() 读字符串 |
废除 raw_input,input() 统一返回安全纯字符串 |
杜绝了交互读取输入时潜在的代码注入执行安全漏洞 |
| 工程类型体系 | 无官方语法级类型注解,依赖第三方 Docstring 约定 | 原生集成渐进式 Type Hints 与 typing 模块 |
使数百万行规模的大型协作项目具备工业级静态排错能力 |
五、适用场景与工程边界:理性认识优势与局限
作为一门成熟的通用语言,Python 3 在工业界拥有极高的占有率,但并不存在适合所有任务的“万能语言”。明确其技术边界,是工程选型的前提。
1. Python 3 的核心优势场景
- 人工智能与数据科学事实上的通用“胶水层”: Python 3 简洁的外层语法与底层由 C/C++/Rust/Fortran 编写的高性能计算库(NumPy、PyTorch、TensorFlow、Polars)形成完美互补。开发者可以用简单清晰的高层逻辑调用底层向量化指令,兼顾研发速度与硬件执行效率。
- 微服务与现代 Web API 开发: 依托异步事件循环与渐进式类型体系,FastAPI 等现代框架能够在提供出色吞吐表现的同时,自动生成符合 OpenAPI 规范的交互式文档。
- 自动化运维、测试流水线与云原生编排: 标准库开箱即用(Batteries Included),对操作系统、网络协议、文件系统的操作极其顺畅,是编写系统调度工具的首选。
2. 工程局限与权衡条件
-
全局解释器锁(GIL,Global Interpreter Lock)的存在:
CPython 为了保证多线程下引用计数与内存管理的线程安全,通过 GIL 确保任何时刻只有一个线程在 PVM 中执行字节码。这意味着多线程无法直接利用多核 CPU 加速计算密集型任务。在 Python 3 中,解决 CPU 密集型任务的标准手段是使用
multiprocessing多进程架构,或者依赖 NumPy/C-Extensions 释放 GIL。技术演进速递:自 Python 3.12 引入子解释器独立 GIL、Python 3.13 推出自由线程(Free-threaded / no-GIL)实验模式以来,官方正稳步解决这一长期历史局限。 - 原生纯 Python 代码执行速度: 由于动态类型检查与堆对象间接寻址,在纯循环与高频数值计算中,纯 Python 速度明显慢于 C/C++、Go 或 Rust。对于极度追求微秒级延迟或高吞吐数据流转的核心计算模块,通常需要将其下沉至 Rust/C 扩展中实现。
六、总结:掌握 Python 3 的完整知识全景
归根结底,Python 3 是以“高开发效率与极致代码可读性”为核心目标打造的现代多范式编程语言。它通过彻底理顺底层数据抽象、引入渐进式类型与异步原语,成功在动态脚本语言的敏捷与现代软件工程的严谨之间找到了平衡点。
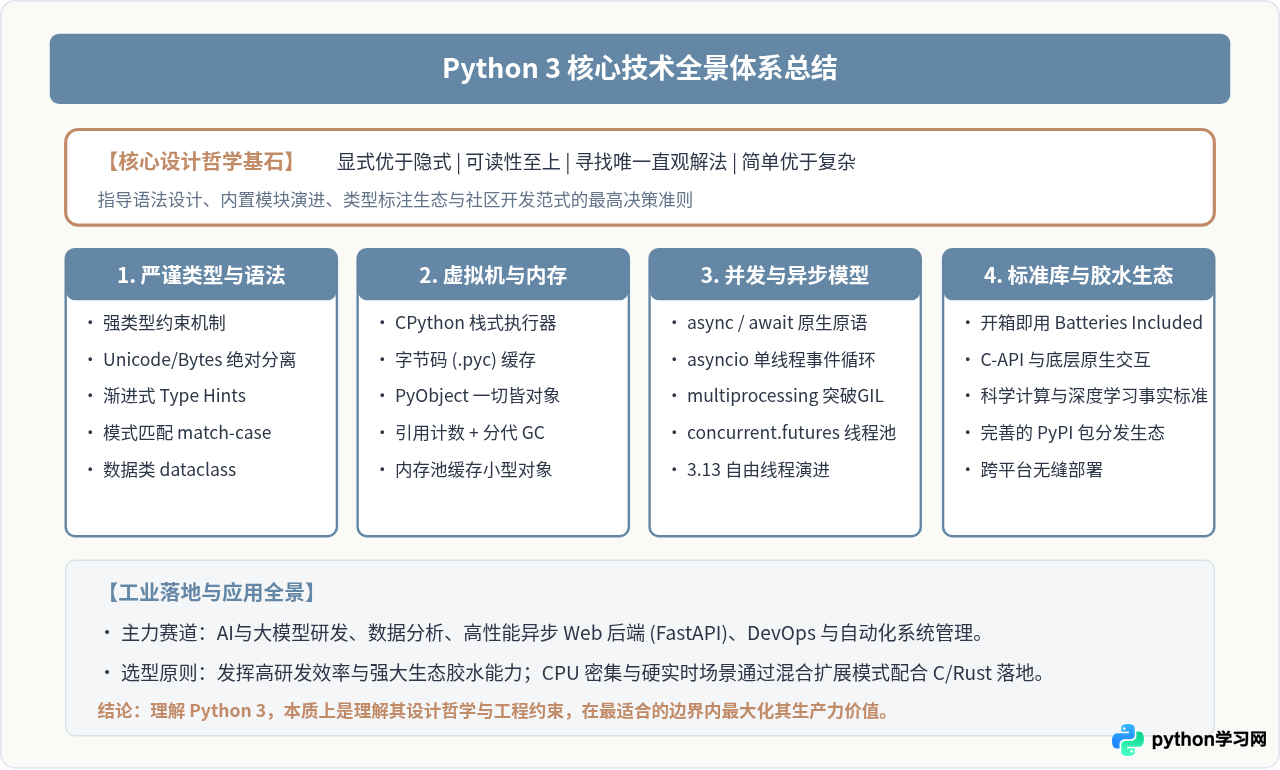
掌握 Python 3 不仅仅是记住其语法糖,更重要的是理解其“显式表达、安全边界与高效工程化”的内生逻辑。当开发者能够熟练运用类型注解构建稳固模块、使用异步协程调度高并发 I/O、并通过生态库桥接底层硬件性能时,Python 3 将成为构建现代化软件体系最可靠的高效利器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









