

利用Python序列解包简化代码:交换变量与处理函数多返回值
深入讲解Python中序列解包的核心机制,通过变量交换、函数多返回值接收、星号扩展解包等实用场景,展示如何写出简洁、安全且符合Python风格的代码。
在Python开发中,序列解包(Sequence Unpacking)是一种将可迭代对象中的元素直接映射到对应变量的高效语法。通过一行赋值语句,开发者即可完成变量值交换或函数多个返回值的接收,从而摆脱繁琐的临时中间变量与索引访问。本文将通过底层执行机制、核心典型应用场景及边界规避原则,全面讲解如何规范使用序列解包简化日常编码。
一、序列解包的底层机制与变量交换
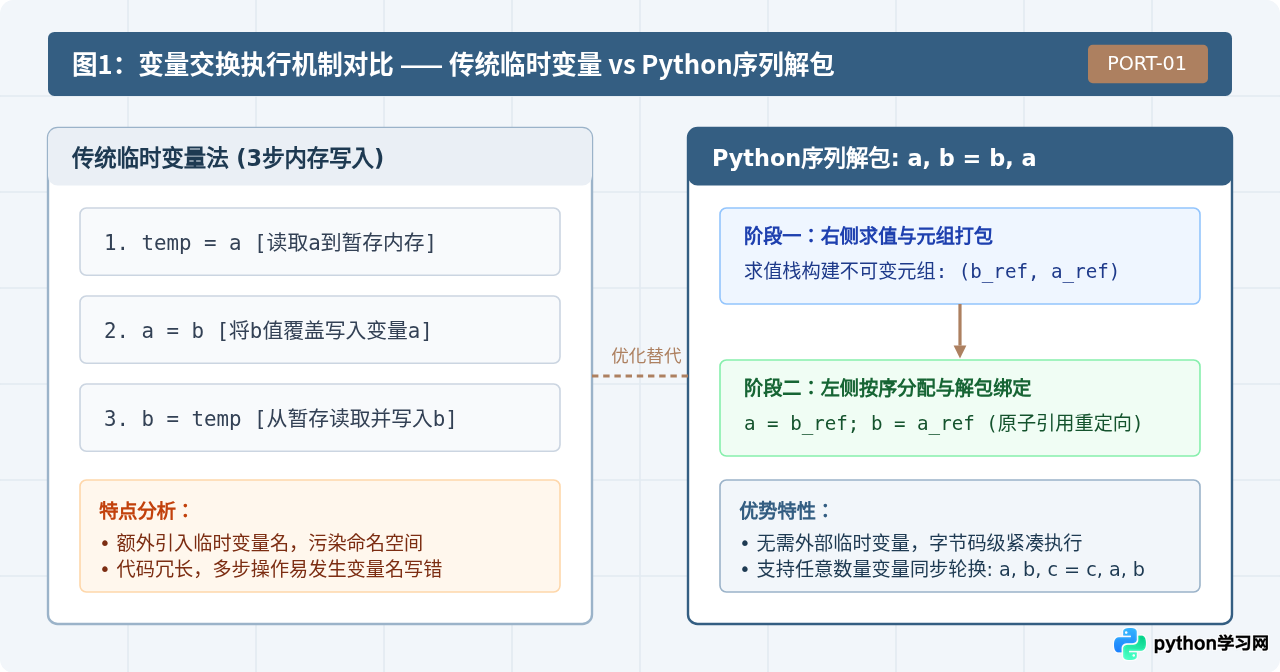
在C或Java等传统语言中,交换两个变量的值通常需要借助一个中间变量来临时保存数据:
# 传统方式:需要第三方临时变量
temp = a
a = b
b = temp而在Python中,这一操作被精简为纯粹的一行语句:a, b = b, a。很多初学者误以为Python在底层自动创建了同名替换,但实际上其底层依赖的是元组打包(Tuple Packing)与序列解包(Sequence Unpacking)两阶段求值机制。
在执行赋值语句时,Python解释器遵循严格的“先右后左”求值顺序:
- 右侧求值与元组打包:解释器首先计算等号右侧的所有表达式。在
b, a中,解释器隐式创建了一个临时元组(b, a),并将两个变量当前指向的对象引用推入求值栈中。 - 左侧对应赋值与解包:右侧元组构建完毕后,解释器按照从左到右的位置顺序,把元组中的各个引用依次绑定到左侧对应的变量名
a与b上。
因为右侧的值在任何左侧变量被重新赋值之前就已经固化在求值栈的元组中,所以变量交换过程不会发生覆盖冲突,完全不需要显式定义临时变量。
二、优雅接收函数的多返回值
在设计数据处理、接口请求或算法计算等函数时,经常需要同时向调用方反馈多个结果(例如:状态码、结果载荷、响应耗时)。许多初学者在遇到此类需求时,倾向于返回字典或列表,并随后通过索引或键名提取:
# 不推荐写法:基于索引提取,语义模糊且难以维护
result = query_database(user_id)
status = result[0]
data = result[1]
elapsed_time = result[2]
在Python中,当 return 语句后跟着多个以逗号隔开的变量时,解释器会自动将其封装为一个标准的 tuple。利用序列解包,调用方可以直接用多个变量名优雅地进行一对一接收:
def query_database(user_id):
    # 模拟查询逻辑
    is_success = True
    user_info = {"id": user_id, "name": "Alice"}
    latency = 0.045
    # 语法层面隐式打包为元组 (is_success, user_info, latency)
    return is_success, user_info, latency

# 优雅解包接收:一行代码完成变量拆分与赋值
success, info, cost = query_database(1001)

print(f"执行状态: {success}, 用户: {info['name']}, 耗时: {cost}s")
部分接收与占位符规范
如果调用者只关心多返回值中的某一项或某几项,不需要将所有变量都声明具体的业务名称。Python工程实践中通常使用下划线 _ 作为废弃变量的占位符:
# 只关注用户信息,丢弃成功标志与耗时
_, info, _ = query_database(1001)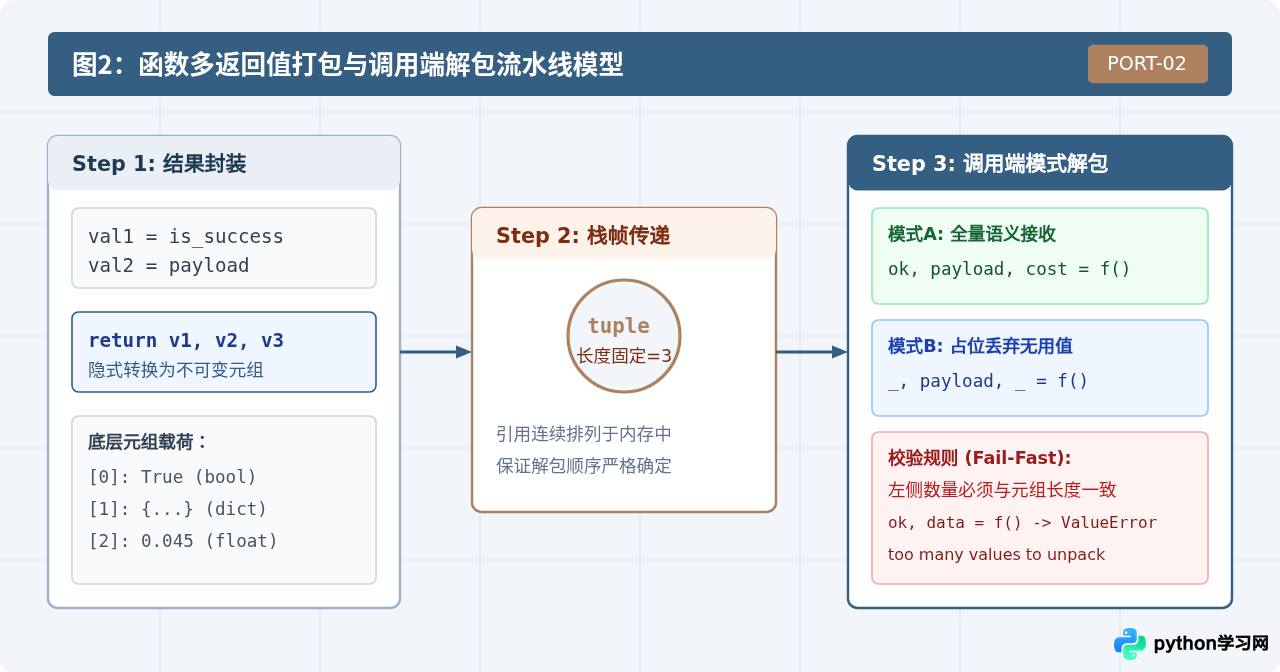
三、星号扩展解包:处理未知或不定长序列
常规序列解包要求等号左侧的变量数量与右侧序列中的元素数量必须严格相等。如果右侧元素数量超过左侧变量,解释器会立即抛出 ValueError: too many values to unpack;如果不足,则抛出 ValueError: not enough values to unpack。
针对不定长序列或仅需提取特定边界元素的情况,Python 3引入了带星号的扩展可迭代解包(Extended Iterable Unpacking)。通过在某个变量名前添加星号 *,该变量将自动接收剩余的所有多余元素,并以列表(list)的形式存储。
典型使用场景示例
# 场景1:截取首尾元素,打包中间记录
log_records = ["2026-10-16", "INFO", "AuthService", "User login success", "192.168.1.108"]
date, *middle_details, ip = log_records

print("日期:", date)            # 输出: 2026-10-16
print("中间内容:", middle_details) # 输出: ['INFO', 'AuthService', 'User login success']
print("来源IP:", ip)             # 输出: 192.168.1.108

# 场景2:提取第一个元素并保留剩余队列
head, *tail = [10, 20, 30, 40]
print(head) # 10
print(tail) # [20, 30, 40]

# 场景3:当剩余元素为空时,星号变量被赋予空列表,不会报错
x, *y = [100]
print(x) # 100
print(y) # []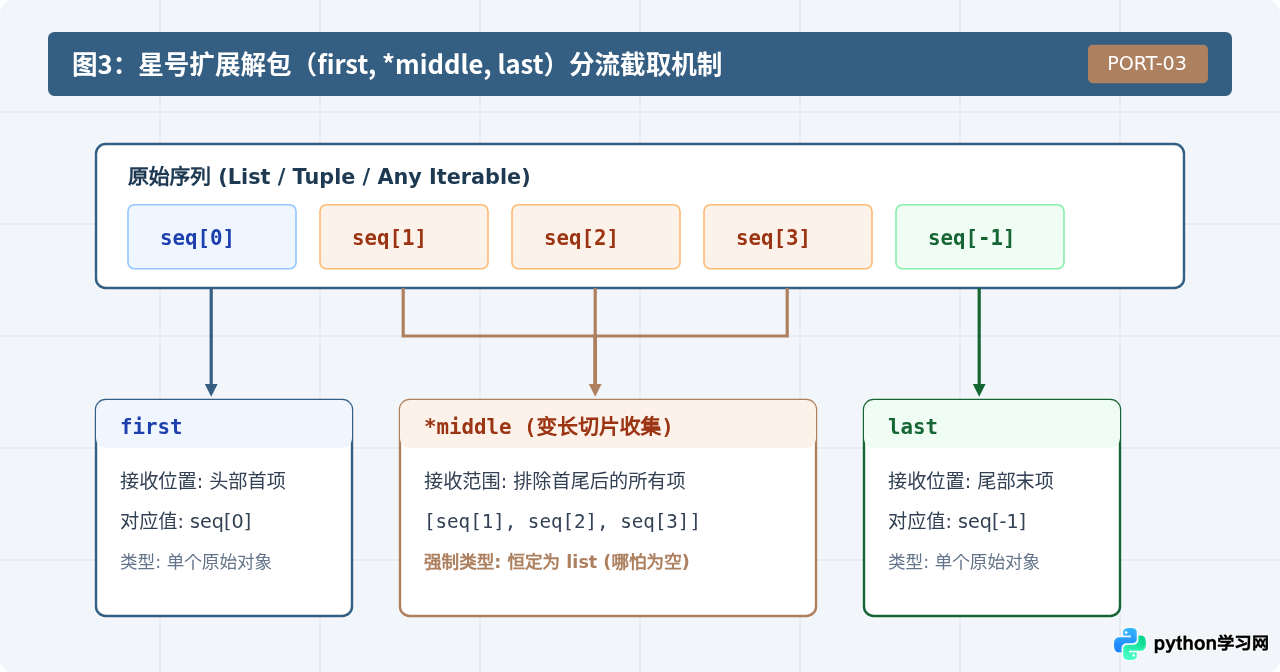
*a, *b = [1, 2, 3]),Python无法确定各个列表的长度边界,会在编译期直接报错:SyntaxError: two starred expressions in assignment。
四、序列解包的最佳实践与决策边界
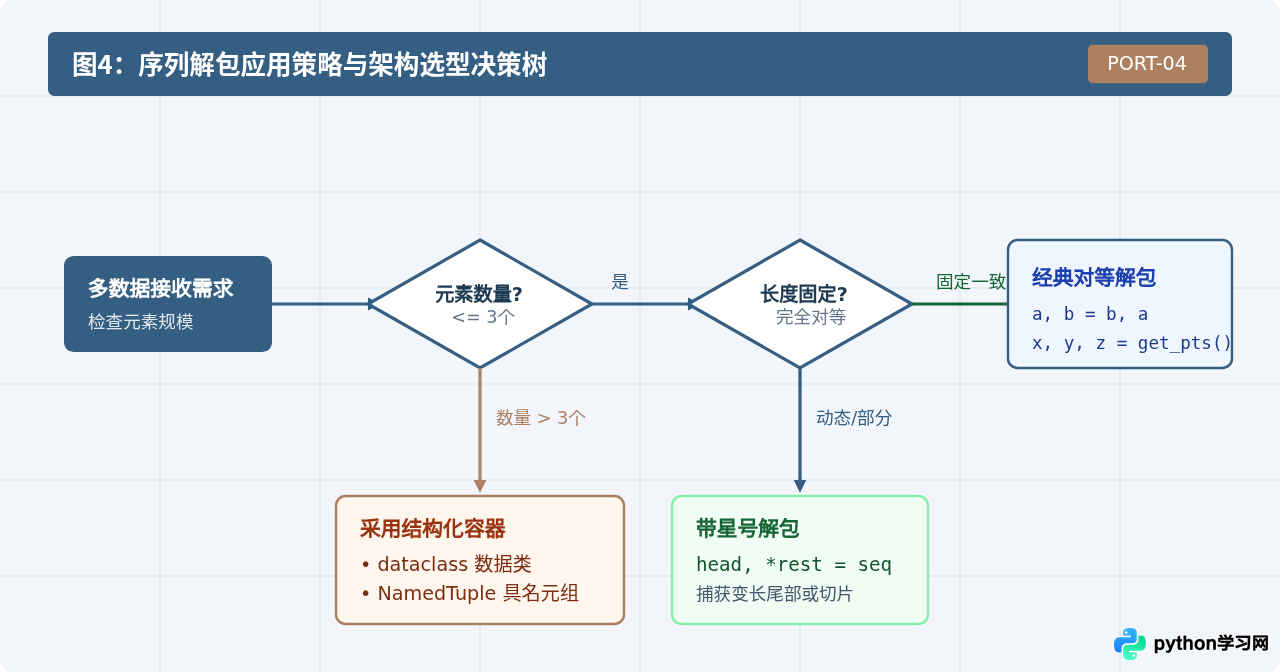
序列解包虽能大幅简化代码,但在实际工程中如果不加节制地使用,也可能降低代码的可读性或引入隐蔽Bug。以下是在工程设计中应当遵循的决策规范:
| 维度 | 推荐使用场景 | 不推荐 / 应替换为其他设计 |
|---|---|---|
| 返回值数量 | 2 ~ 3 个核心返回值(如状态 + 载荷) | 超过 4 个返回值(极易出现位置传参对错) |
| 数据含义 | 元素角色各异且顺序固定(如坐标 x, y) |
包含多个相同类型字段(易发生静默赋值错位) |
| 架构扩展性 | 内部封闭函数,参数签名长期稳定 | 对外公共API(新增字段会导致外部调用方全量崩溃) |
当函数返回值较多,或者接口有高频演进扩展的需求时,应优先采用 typing.NamedTuple 或 dataclasses.dataclass 封装返回实体,借助属性名提供编译期代码补全和更强的自解释性。
总结
Python的序列解包是一项兼具优雅与实用价值的语言特性。在处理变量交换时,它利用求值栈中的元组打包与按序解包,实现了不依赖临时变量的原子赋值;在函数交互中,它将元组多返回值直观分发给各个目标变量,使业务逻辑表达更加平铺自然。结合带星号的扩展解包与下划线占位符,开发者可以灵活应对各种序列拆分场景。而在涉及大规模字段或对外扩展接口时,配合 dataclass 等强类型容器,便可在代码简洁性与工程健壮性之间取得最佳平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









