

GitHub上适合新手的免费Python开源入门项目
精选GitHub上适合新手的免费Python开源入门项目,涵盖语法题解、自动化小脚本、简易Web与算法可视化,提供从本地克隆、环境搭建到源码阅读的实操指南与选型路径。
在掌握了变量、循环与简单函数后,初学者往往会面临一个共同的瓶颈:找不到体量合适、可以直接在本地跑通且代码逻辑直观的项目来进行练手。GitHub 上有数百万个 Python 仓库,直接搜索容易撞上大型商业框架或缺乏维护的废弃代码。本文筛选出四个不同定位、完全免费且对新手友好的典型开源项目,解析它们的代码特征与学习价值,并给出从本地克隆、虚拟环境隔离到验证运行的完整操作步骤与选择路径。
初学者挑选开源项目的四个技术标准
新手挑选开源项目时,容易误选 star 数量极高但内部架构极其复杂的大型工程(如 Django、Scrapy 核心库)。这类项目包含大量元类、动态分发和底层网络异步封装,并不适合在打基础阶段阅读。适合新手入门的项目通常具备以下特征:
- 单文件或浅层目录结构: 核心逻辑集中在少数几个
.py文件中,调用链不超过三层,无需在复杂的抽象类中反复跳转。 - 外部依赖项极少或仅依赖标准库: 尽量减少繁复的 C 编译依赖或环境绑定,只要安装好基础 Python 环境即可一键执行。
- 包含清晰的断言或控制台输出: 代码执行后能立即给出肉眼可见的反馈,方便通过修改参数直接观察输出变化。
- 带有成套的注释或配套文档: 仓库中对关键语句的功能、入参以及预期返回类型有简明中文或英文注释。
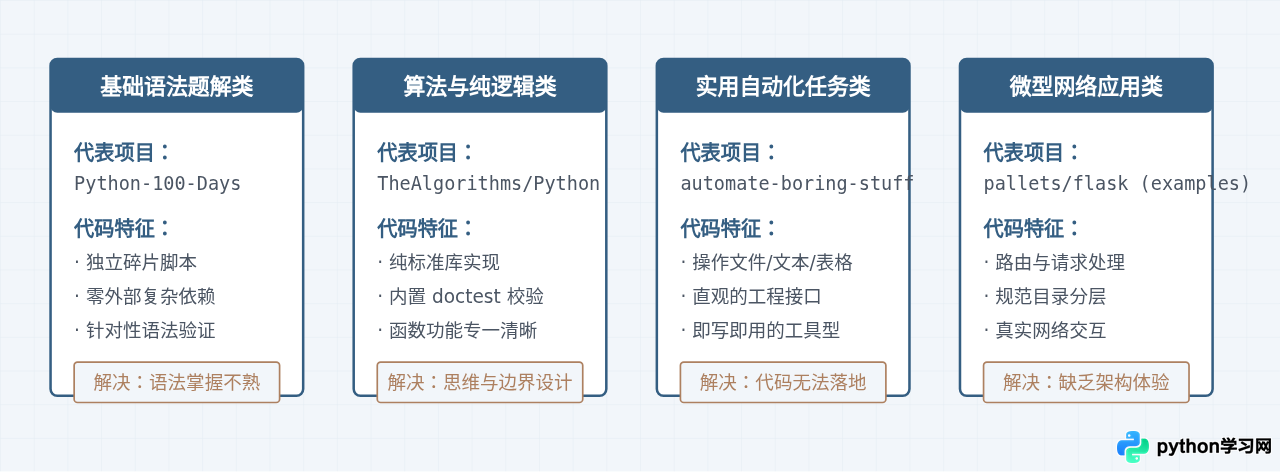
四个适合新手的典型开源项目推荐
1. TheAlgorithms/Python(纯算法与数据结构实现)
GitHub 地址: TheAlgorithms/Python
适合阶段: 刚学完循环、列表、字典与函数,缺乏逻辑组织能力的初学者。
核心价值: 该仓库是 GitHub 上规模最大的纯 Python 算法集合,涵盖排序、搜索、字符串处理、数学运算等常见算法。它的最大特点是几乎不引用第三方库,全部采用 Python 原生语法编写,代码风格极其统一。
每个 .py 文件就是一个独立功能,且代码尾部都直接集成了 doctest 测试用例。你可以打开任意一个文件(例如快速排序 sorts/quick_sort.py),不仅能直接看到算法实现,还能看到直接写在注释里的输入输出示范,非常适合作为单文件精读样本。
2. jackfrued/Python-100-Days(结构化语法与案例实战)
GitHub 地址: jackfrued/Python-100-Days
适合阶段: 希望系统理清基础知识、按天推进学习进度的新手。
核心价值: 这个仓库全中文编写,按照 100 天的学习周期组织代码与文档。前 15 天的代码极其精简,涵盖变量、分支、循环、函数以及基础数据结构的操作示范;随后的章节逐步展开文件操作、正则表达式以及面向对象编程。项目仓库中包含了大量几十行到一百行的小型代码示例(如掷双骰子游戏、井字棋小游戏、跑马灯文本等),无需配置复杂环境,下载后即可在控制台直接运行并查看逻辑效果。
3. asweigart/automate-boring-stuff-code(办公实用自动化脚本)
GitHub 地址: asweigart/automate-boring-stuff-code
适合阶段: 语法基本掌握,希望用 Python 解决实际电脑操作问题(如整理文件、处理 Excel 表格、抓取网页)。
核心价值: 这是经典畅销书《Automate the Boring Stuff with Python》的开源配套代码仓。相比枯燥的控制台输出,这个仓库的内容直接解决现实问题:如何用 os 和 shutil 模块批量重命名文件夹中匹配特定格式的文件、如何利用 openpyxl 批量更新电子表格、如何用简单的 requests 自动下载网络资源。阅读此仓库能让新手快速建立“写脚本来帮我工作”的正向反馈。
4. pallets/flask 官方示例项目(Flaskr 迷你博客)
GitHub 地址: pallets/flask(对应目录:examples/tutorial)
适合阶段: 想要理解后端开发、数据库读写与请求生命周期的学习者。
核心价值: 初学者不要直接阅读 Flask 自身的内核源码,而应该直接看其官方教程中的 flaskr 示例。整个项目代码总量仅数百行,但具备了一个标准 Web 系统的全部骨架:应用工厂函数、SQLite 数据库连接初始化、蓝图路由(注册/登录/发布文章)、以及 Jinja 模板渲染。通过这个微型项目,新手可以完整理解一个现实软件工程的文件组织规范,不再局限于单一的 .py 脚本。
从克隆到本地执行的标准化流程
许多初学者在 GitHub 找到项目后,常常直接点击“Download ZIP”解压,并直接使用系统全局 Python 运行,随后便遭遇依赖冲突或路径报错。标准的开源项目本地调试应当遵循“克隆代码 → 隔离环境 → 安装依赖 → 验证运行”的规范路径。
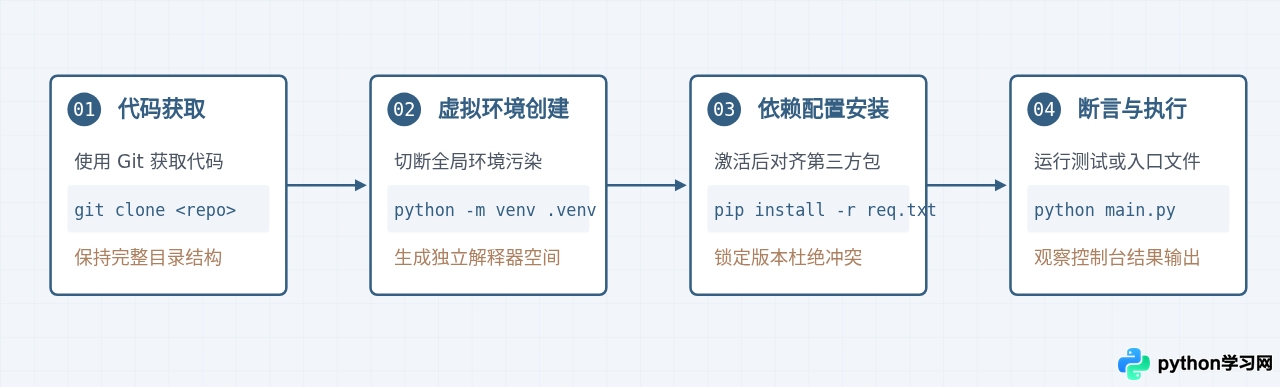
下面以克隆一个典型的开源小项目为例,展示终端操作全流程:
步骤一:通过 Git 克隆目标项目
打开终端(Windows 使用 PowerShell 或 Git Bash,macOS/Linux 使用 Terminal),进入你的工作目录,执行克隆命令:
# 进入你平时存放代码的文件夹
cd ~/projects

# 克隆项目仓库(以自动化代码仓库为例)
git clone https://github.com/asweigart/automate-boring-stuff-code.git

# 进入项目根目录
cd automate-boring-stuff-code
步骤二:创建并激活虚拟环境
为了避免该项目安装的第三方库与全局 Python 环境发生冲突,必须在项目内部创建独立的虚拟环境:
# 创建名为 .venv 的虚拟环境
python3 -m venv .venv

# 激活虚拟环境 (macOS / Linux)
source .venv/bin/activate

# 激活虚拟环境 (Windows PowerShell)
# .venv\Scripts\Activate.ps1
激活成功后,终端提示符最前端会出现 (.venv) 标识,表示当前所有的 Python 与 pip 操作均局限在此文件夹中。
步骤三:安装项目依赖
若项目根目录下存在 requirements.txt,通过 pip 进行统一安装:
pip install -r requirements.txt注意:如果下载速度较慢,可以临时指定国内镜像源,例如:pip install -i https://pypi.tuna.tsinghua.edu.cn/simple -r requirements.txt。若项目中没有该文件,说明项目完全依赖标准库,可直接跳过此步。
步骤四:运行与结果验证
选择仓库中的一个具体小脚本进行运行验证。例如运行一个处理剪贴板的脚本:
python mcb.pyw save test_key验证输出预期:如果脚本没有报出 ModuleNotFoundError 或语法错误,且在当前目录下生成了对应的缓存数据文件,则说明整个运行环境已经完全搭建成功。
以精读为核心的源码学习方法
很多新手把项目拉到本地跑通之后,就直接停下了脚步。跑通只是第一步,真正提升编程能力的是接下来的“逆向拆解”过程。
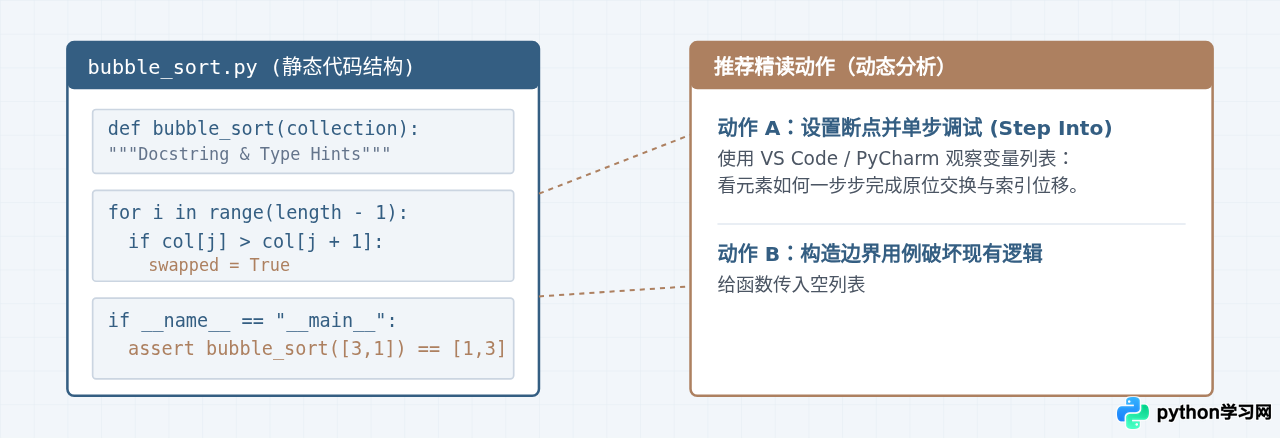
一个标准的单文件代码精读步骤如下:
- 先读
if __name__ == "__main__":底部的调用代码: 弄清楚这个脚本是接收控制台参数,还是写死了测试变量。这一步决定了程序的输入与预期输出。 - 精读类型标注与入参检查: 高质量的开源代码通常包含类似
def search(arr: list[int], target: int) -> int:的类型提示。先通过类型标注推测其数据流,再看函数第一屏是否做了防空指针或越界验证。 - 使用
print()或断点观察中间过程: 在循环体内部打印核心变量。例如阅读排序算法时,在每次swap操作后打印当前列表状态,直观观察列表元素逐步就位的全过程。 - 编写自己的 Assert 测试用例: 在文件末尾添加两行代码,故意传入极端数据(如倒序数组、空字符串),验证程序是否如预期一样稳健。
如何根据你目前的掌握程度做选择
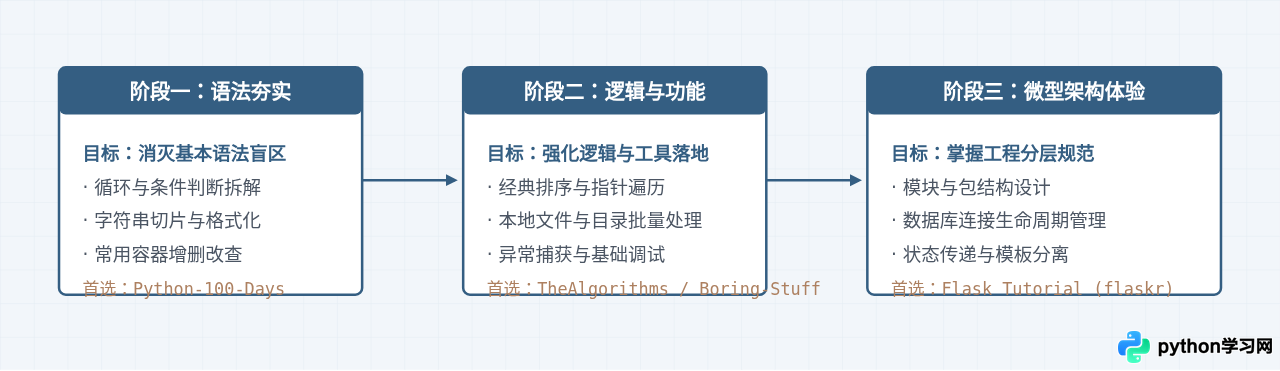
不同基础阶段的学习者对代码复杂度的承受能力截然不同。如果选得太简单,只是重复做控制台加减法;选得太难,则会因无法理清调用关系而放弃。下表给出了明确的选择对照:
| 当前掌握情况 | 建议首选开源项目 | 核心练习模块 | 检验通过的标准 |
|---|---|---|---|
| 刚学完基础语法,列表字典操作容易混淆 | jackfrued/Python-100-Days |
Day01 - Day15 基础语言元素与容器练习 | 能不看源码,独立默写出扑克牌发牌逻辑或猜数字游戏 |
| 熟悉基本语法,但在写算法题时逻辑不连贯 | TheAlgorithms/Python |
sorts/、searches/ 基础算法目录 |
能理清递归与双指针的终止条件,并补全边界测试 |
| 想写工具但不知道日常任务如何用代码表达 | automate-boring-stuff-code |
文件操作、CSV/Excel 读写及简易正则处理 | 能写出一个自动扫描指定目录并清理冗余日志的工具 |
| 想要做网站或提供接口,但毫无工程结构概念 | pallets/flask(tutorial 目录) |
flaskr 博客完整示例 |
能理解蓝图组织方式,并在现有页面上成功增加一个新字段 |
初学者常踩的三个误区与应对策略
- 误区一:只把代码下载下来运行看结果,不动一行代码。
应对: 任何开源代码拉到本地后,必须完成一次“破坏性改动”。比如把排序算法的判断符号由>改为<,或者在文件保存函数前故意抛出一个异常,观察终端的报错回溯栈(Traceback),通过报错信息加深对代码执行路径的理解。 - 误区二:盲目追求使用最复杂的包管理器。
应对: 在初学阶段,直接使用 Python 内置的venv与官方的pip即可,无需在尚未熟悉项目结构时引入复杂的虚拟环境配置工具,避免在环境配置阶段耗费过多精力。 - 误区三:项目一旦跑不通就换下一个。
应对: 初学者在本地执行开源项目遇到报错,90% 以上是由于“Python 版本不一致”或“执行脚本时的当前工作目录(CWD)不匹配”导致的。如果报错提示找不到模块或文件不存在,先在终端执行pwd(Windows 为cd)确认当前终端所在的文件夹层级,确保相对路径基准正确,再查看报错定位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









