

Python脚本运行时怎么传递命令行参数
详细讲解在Python脚本运行时如何传递和接收命令行参数,深入解析sys.argv内置列表与argparse标准库模块的使用方法、参数解析逻辑、类型转换技巧及常见易错点。
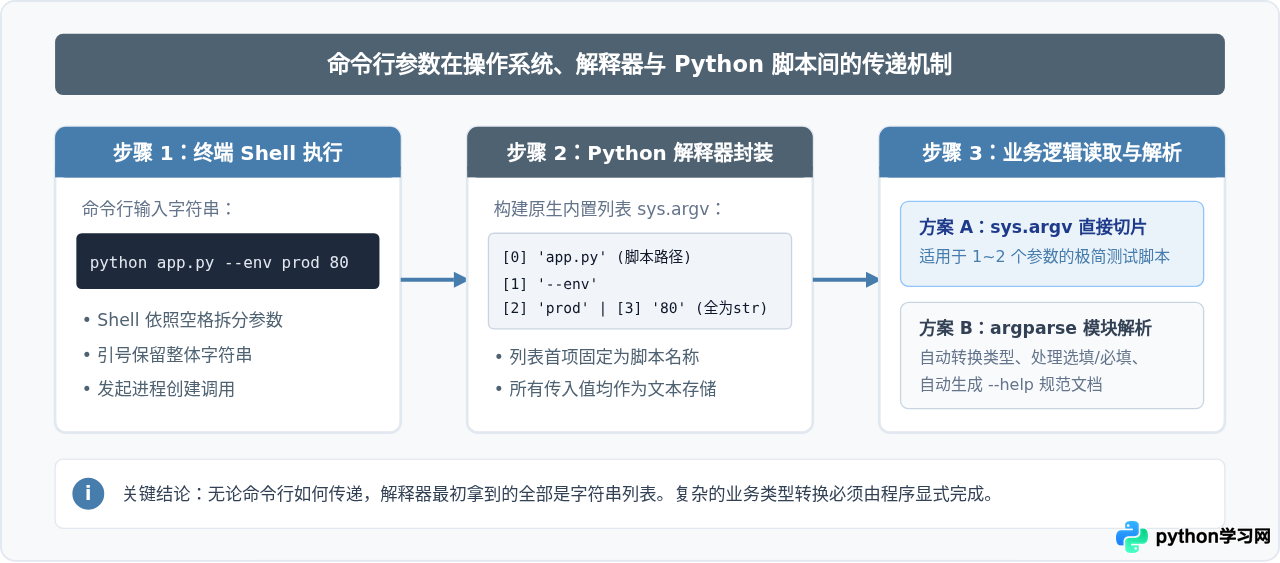
在终端运行 Python 脚本时,向程序传入动态参数是最基础也是最频繁的交互方式。用户在命令行键入 python main.py arg1 arg2 时,操作系统与终端外壳(Shell)会先按空格将输入切分为独立的文本片段,随后打包交给 Python 解释器。Python 内部主要提供了两套核心工具来处理这组数据:一是极简直观的内置列表 sys.argv,二是功能完备、支持类型校验与自动生成帮助文档的标准库模块 argparse。
一、使用内置 sys.argv:轻量级直接传参
在所有方案中,sys.argv 是 Python 原生自带的解决方案,不需要安装任何外部依赖,也不需要复杂的类实例化。只要导入标准模块 sys,就能立刻获取包含所有命令行参数的列表。
1. sys.argv 的结构规则
sys.argv 是一个常规的 Python 列表(List),具有以下三个不可更改的核心规则:
- 索引 0 始终是脚本文件名:例如执行
python demo.py时,sys.argv[0]就是'demo.py'(在某些调用路径下包含完整绝对路径或相对路径)。 - 有效参数从索引 1 开始:用户在脚本名后面追加的内容,依次保存在
sys.argv[1]、sys.argv[2]等位置。可以用sys.argv[1:]切片提取所有实际传参。 - 所有元素均为字符串:即使在终端输入纯数字
100或布尔字面量True,获取到的仍然是字符串'100'与'True'。
2. 完整代码示例
下面是一个使用 sys.argv 接收用户名与重复打印次数的简单脚本。为了防止用户未提供参数而抛出 IndexError,代码加入了长度判断:
import sys

def main():
    # 检查参数个数是否满足预期(脚本名本身占 1 位,两个参数共需 3 位)
    if len(sys.argv) < 3:
        print("错误:缺少必要的命令行参数!")
        print(f"用法:python {sys.argv[0]} <用户名> <重复次数>")
        sys.exit(1)

    username = sys.argv[1]

    # 终端传入的值始终是字符串,数字必须显式转换
    try:
        repeat_count = int(sys.argv[2])
    except ValueError:
        print("错误:重复次数必须是整数!")
        sys.exit(1)

    print(f"正在为用户【{username}】执行任务,共重复 {repeat_count} 次:")
    for i in range(1, repeat_count + 1):
        print(f"  [第 {i} 次执行] 你好,{username}!")

if __name__ == "__main__":
    main()
3. 运行与输出验证
在终端中分别执行正常传参、参数不足和类型异常的情况:
# 1. 正常执行传参
$ python sys_demo.py Alice 3
正在为用户【Alice】执行任务,共重复 3 次:
  [第 1 次执行] 你好,Alice!
  [第 2 次执行] 你好,Alice!
  [第 3 次执行] 你好,Alice!

# 2. 缺少参数时的提示
$ python sys_demo.py Alice
错误:缺少必要的命令行参数!
用法:python sys_demo.py <用户名> <重复次数>

# 3. 传入非整数类型时的拦截
$ python sys_demo.py Alice abc
错误:重复次数必须是整数!适用场景:sys.argv 适合只需接收 1 到 2 个明确参数的内部运维脚本、临时测试或自动化流水线调用。当需要支持 -v/--verbose 可选开关、指定参数顺序无关的命名参数时,自行用 sys.argv 解析会变得极其繁琐脆弱。
二、使用标准库 argparse:规范专业的命令行解析器
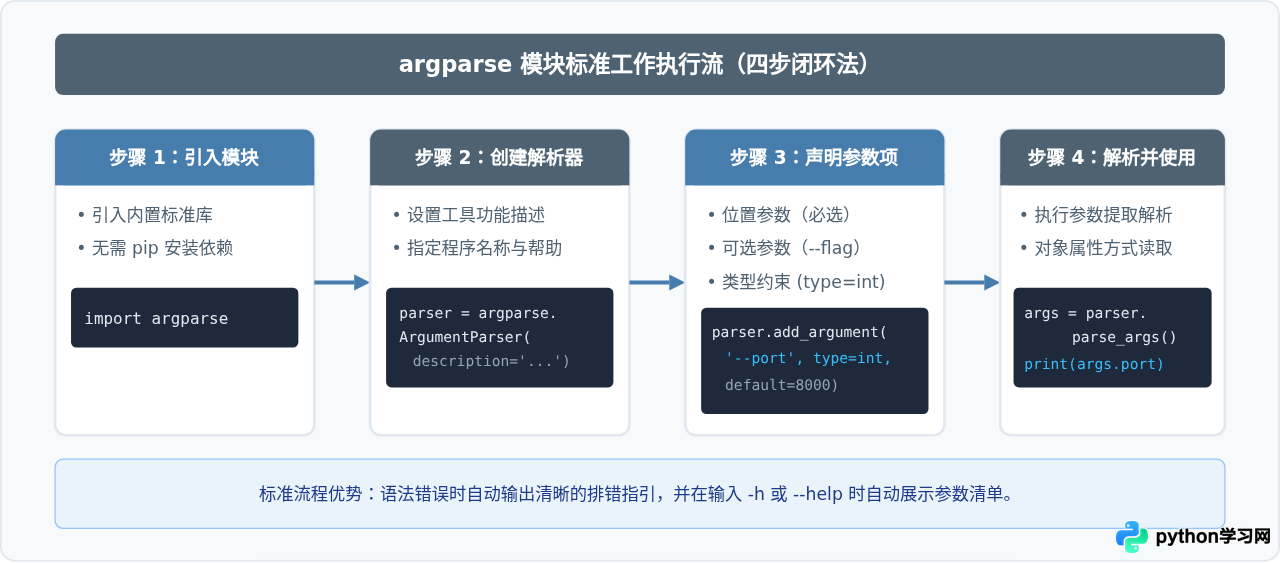
针对需要灵活配置、支持长短选项(如 -p 8080 或 --port 8080)、自动数据类型校验以及自动生成 --help 帮助文档的场景,Python 官方标准库内置了 argparse 模块。
1. 掌握位置参数与可选参数
在 argparse 中,参数根据声明形式划分为两类:
- 位置参数(Positional Arguments):名字前不带横杠,例如
'target_dir'。这类参数是必填项,按照命令行出现的先后顺序被对应变量接收。 - 可选参数(Optional Arguments):名字前带有短横杠
-或双横杠--,例如-p或--port。这类参数位置自由,通常可以设置default默认值。
2. 典型项目级代码示例
以下示例构建了一个模拟数据导出工具,包含位置参数、带类型的可选参数、限制取值范围的参数(choices)以及布尔开关(action='store_true'):
import argparse

def parse_arguments():
    # 1. 实例化解析器,设置程序描述
    parser = argparse.ArgumentParser(
        prog="DataExporter",
        description="用于导出数据库或日志指定格式数据的实用工具。"
    )

    # 2. 添加位置参数(必填项):源文件路径
    parser.add_argument(
        "source",
        type=str,
        help="待处理的源数据文件路径(例如: data.csv)"
    )

    # 3. 添加可选命名参数:输出格式,限定范围
    parser.add_argument(
        "-f", "--format",
        type=str,
        choices=["json", "csv", "xml"],
        default="json",
        help="导出的目标格式(默认: json,可选: json, csv, xml)"
    )

    # 4. 添加数值型可选参数:读取行数
    parser.add_argument(
        "-n", "--lines",
        type=int,
        default=100,
        help="最大读取行数限制(默认: 100)"
    )

    # 5. 添加布尔开关 Flag:是否开启详细调试模式
    parser.add_argument(
        "-v", "--verbose",
        action="store_true",
        help="启用该选项后打印详细执行日志"
    )

    # 6. 执行解析
    return parser.parse_args()

def main():
    args = parse_arguments()

    if args.verbose:
        print("[DEBUG] 调试模式已开启")
        print(f"[DEBUG] 源文件: {args.source}")
        print(f"[DEBUG] 目标格式: {args.format}")
        print(f"[DEBUG] 读取行数: {args.lines}")

    print(f"正在读取 {args.source},转换为 {args.format.upper()} 格式,处理前 {args.lines} 行数据...")
    print("处理完毕!")

if __name__ == "__main__":
    main()
3. 运行效果与验证
argparse 最大的亮点在于对各类调用情况的自动响应与错误阻断:
# 1. 自动生成完备的帮助文档
$ python cli_tool.py --help
usage: DataExporter [-h] [-f {json,csv,xml}] [-n LINES] [-v] source

用于导出数据库或日志指定格式数据的实用工具。

positional arguments:
  source                待处理的源文件路径(例如: data.csv)

options:
  -h, --help            show this help message and exit
  -f {json,csv,xml}, --format {json,csv,xml}
                        导出的目标格式(默认: json,可选: json, csv, xml)
  -n LINES, --lines LINES
                        最大读取行数限制(默认: 100)
  -v, --verbose         启用该选项后打印详细执行日志

# 2. 正常运行并传递可选参数
$ python cli_tool.py sample.log -f csv -n 500 -v
[DEBUG] 调试模式已开启
[DEBUG] 源文件: sample.log
[DEBUG] 目标格式: csv
[DEBUG] 读取行数: 500
正在读取 sample.log,转换为 CSV 格式,处理前 500 行数据...
处理完毕!

# 3. 错误验证:传入 choices 之外的无效格式
$ python cli_tool.py sample.log -f yaml
usage: DataExporter [-h] [-f {json,csv,xml}] [-n LINES] [-v] source
DataExporter: error: argument -f/--format: invalid choice: 'yaml' (choose from 'json', 'csv', 'xml')

# 4. 错误验证:向 int 类型参数传递非数字
$ python cli_tool.py sample.log -n many
usage: DataExporter [-h] [-f {json,csv,xml}] [-n LINES] [-v] source
DataExporter: error: argument -n/--lines: invalid int value: 'many'
三、方案选型:sys.argv 与 argparse 深度对比
面对不同的开发任务,选择最匹配的工具能避免过度设计或后期返工。下表总结了两者的核心差异:
| 评估维度 | 内置 sys.argv | 标准库 argparse |
|---|---|---|
| 代码量与配置 | 极低,直接导入切片即用(1~2 行) | 中等,需定义解析器和规则(10+ 行) |
| 自动类型转换 | 不支持,提取结果全为 str,需手动 int() 转换 |
原生支持,通过 type=int 等自动校验转换 |
| 选项标识支持 | 需手动循环匹配 -f、--format 等字符串 |
开箱即用,天然支持长短选项混用与顺序无关 |
| 帮助文档与防呆 | 无,越界直接崩掉(IndexError),需手写检验 | 输入 -h/--help 自动打印排版文档,非法输入自动拦截 |
| 典型适用场景 | CI/CD 内部执行、一次性数据清洗脚本 | 供他人调用的运维工具、生产交付 CLI 项目 |
四、高频陷阱与防范技巧
在实际编码中,很多初学者在传递命令行参数时经常遇到类型错误、带空格文本被截断或布尔开关失灵等问题。以下列出最容易出现的四个关键陷阱及其标准解法:
1. 布尔开关不要使用 type=bool
这是 argparse 中最隐蔽的逻辑陷阱。不少人会写出 parser.add_argument('--enable', type=bool),期望在终端传入 --enable False 时将其解析为 False。然而在 Python 中,非空字符串调用 bool("False") 的返回值依然是 True!
避坑法则:对于布尔型开关选项,应当使用 action="store_true" 或 action="store_false",只需在命令行出现该 flag 即可触发,无需输入值。若必须传显式字符串,可自定义转换函数。
# 推荐的标准做法:使用 action='store_true'
parser.add_argument(
    "--dry-run",
    action="store_true",
    help="只模拟执行而不产生实际写操作"
)
# 终端执行:
# python run.py          -> args.dry_run 为 False
# python run.py --dry-run -> args.dry_run 为 True
2. 包含空格的参数必须在终端加引号
由于 Shell 默认以空格作为参数切分的分界符,如果传入的参数自身包含空格(如句子、带空格的文件路径),不加引号会被强制切分为多个独立参数,从而导致参数错位或抛出异常:
# 错误示例:Shell 会将其切分为 3 个参数:'Hello', 'World', '!'
$ python process.py Hello World !

# 正确示例:使用双引号或单引号将整体包裹为一个参数
$ python process.py "Hello World !"
$ python process.py "C:\Program Files\Python\app.py"
3. 使用 sys.argv 时缺少防御性长度校验
直接对 sys.argv[1] 寻址而没有预先检查 len(sys.argv),一旦调用方漏传参数,程序会直接崩溃并抛出 IndexError: list index out of range。在所有使用 sys.argv 的代码中,应养成先检查长度或使用列表解包保护的习惯:
import sys

# 推荐:防御性校验
if len(sys.argv) < 2:
    print("提示:请提供待操作的配置文件路径!")
    sys.exit(1)

config_path = sys.argv[1]
五、总结与实操速查表
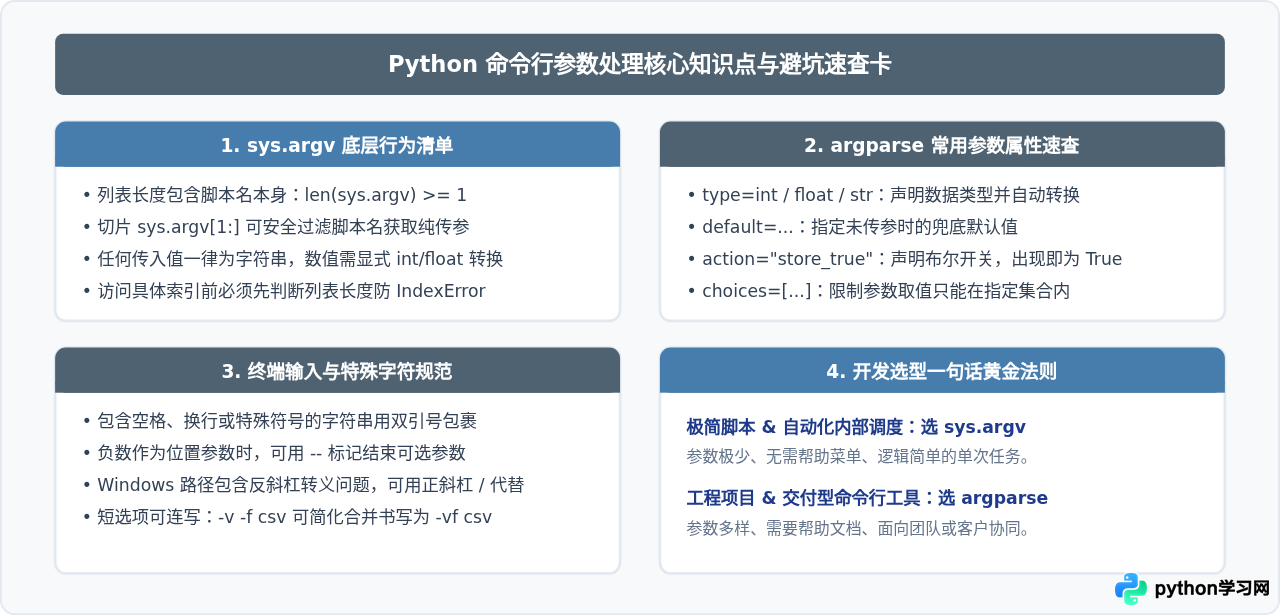
掌握 Python 命令行参数的传递机制,是编写自动化运维脚本、构建专业 CLI 工具以及在容器化环境中运行任务的关键基础。理解底层的传递原理与高层解析器的特点,可以在简洁性与健壮性之间取得完美平衡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









