

Python递归遍历嵌套列表或字典的方法
详细讲解在Python中使用递归函数遍历多层嵌套列表与嵌套字典的具体方法,包含类型判断、路径跟踪、叶子节点处理及循环引用防范策略。
在处理复杂 JSON、配置文件或树状树形数据时,结构内部经常交织着多层字典与列表。遍历这种深层嵌套结构的核心策略是定义一个递归函数:在每次进入函数时判断当前节点类型,如果是字典或列表则继续向下分流调用自身,如果是标量或基本数据类型则作为叶子节点直接读取或处理。本文将系统讲解递归拆解嵌套容器的具体逻辑、完整实现代码以及实际开发中需要防范的细节。
1. 递归遍历的基础逻辑与设计模式
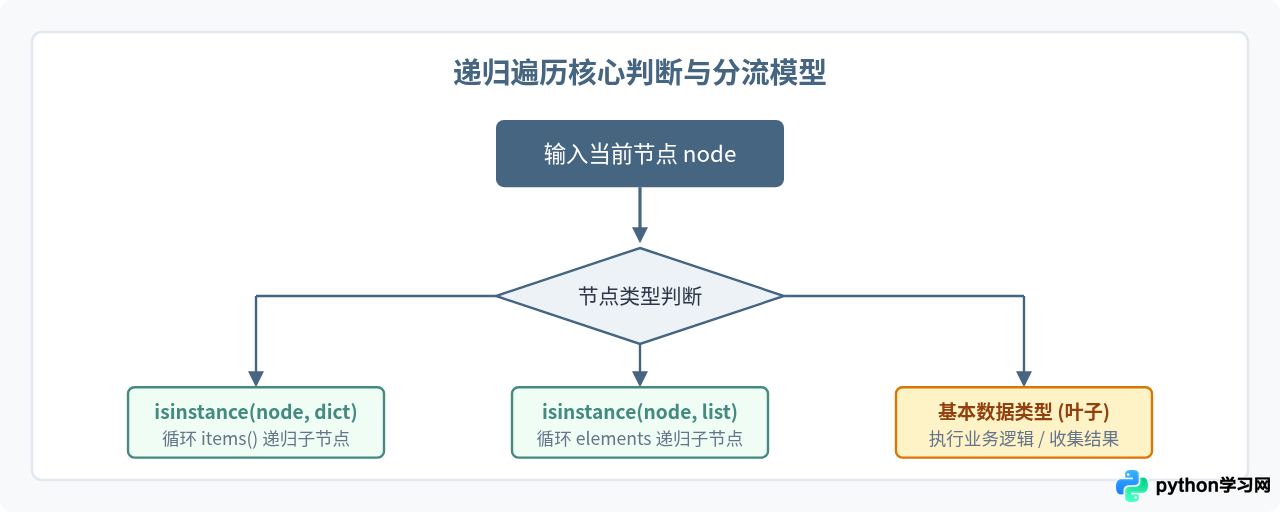
在 Python 中,嵌套结构通常表现为字典中包含列表、列表中又包含字典的树形层级。递归处理这类结构的关键在于两点:
- 递归终止条件(基底情况):当传入的对象不是容器(即非
dict也非list),或者容器为空时,不再发起下级调用,直接返回或处理数值。 - 分流递归驱动:当传入的对象是
dict时,使用items()逐个检查键与值;当传入的对象是list时,按索引或迭代器提取元素,并统一传递给同一递归函数。
2. 递归遍历的具体实现步骤
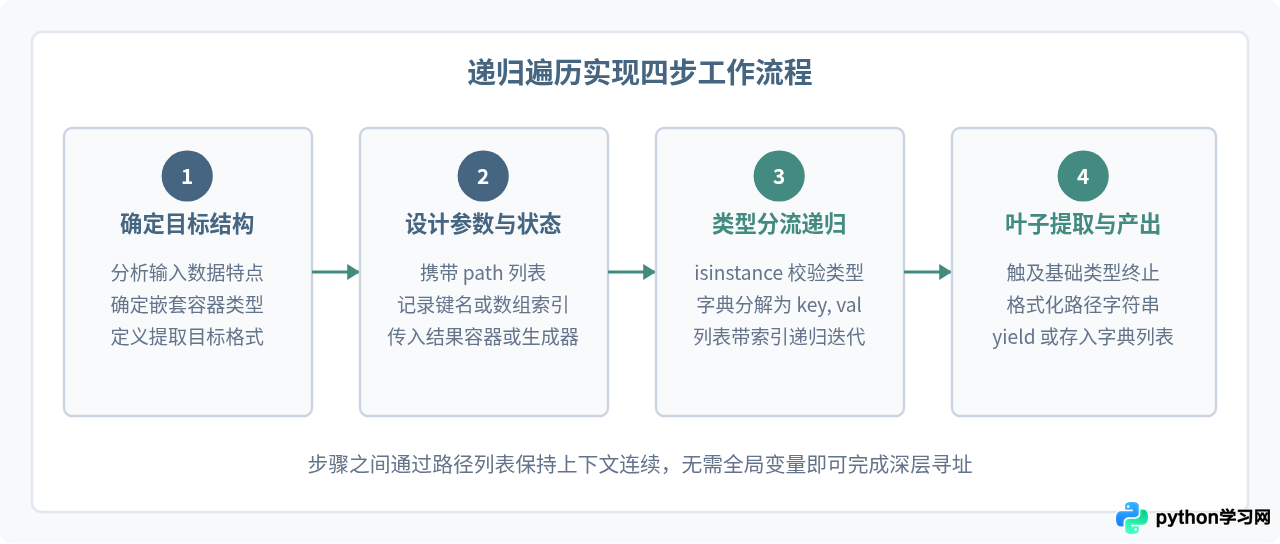
编写一个健壮的递归遍历函数,通常包含准备数据、定义带路径状态的递归函数、判断类型并分流下钻、以及在叶子节点收集输出这四个清晰步骤。
示例代码:支持路径记录的通用递归遍历函数
下面给出一段通用的 Python 递归遍历函数。为了便于查看每个值在原始数据中的具体位置,函数在每次递归调用时追加当前访问的键名或下标,并在触及叶子节点时输出完整的层级路径。
def traverse_nested(data, path=None):
    """
    递归遍历任意嵌套的字典与列表结构。

    参数:
        data: 当前需要遍历的数据节点
        path: 记录从顶层到当前节点的访问路径,默认为 None
    """
    if path is None:
        path = []

    if isinstance(data, dict):
        for key, value in data.items():
            # 字典节点:将当前键追加到路径中继续递归
            traverse_nested(value, path + [str(key)])
    elif isinstance(data, list):
        for index, item in enumerate(data):
            # 列表节点:将当前索引以类似 [0] 的格式追加
            traverse_nested(item, path + [f"[{index}]"])
    else:
        # 叶子节点:已触及基础数据类型,直接输出路径与对应的值
        full_path = " -> ".join(path) if path else "root"
        print(f"路径: {full_path:<30} | 值: {data}")

# 测试数据定义
sample_data = {
    "project": "DataPipeline",
    "version": 1.2,
    "tasks": [
        {"id": 101, "name": "Extract", "tags": ["ETL", "SQL"]},
        {"id": 102, "name": "Transform", "status": "active"}
    ],
    "meta": {
        "maintainer": "admin",
        "retries": 3
    }
}

# 执行遍历
traverse_nested(sample_data)
示例输出
示例输出:
路径: project                        | 值: DataPipeline
路径: version                        | 值: 1.2
路径: tasks -> [0] -> id             | 值: 101
路径: tasks -> [0] -> name           | 值: Extract
路径: tasks -> [0] -> tags -> [0]    | 值: ETL
路径: tasks -> [0] -> tags -> [1]    | 值: SQL
路径: tasks -> [1] -> id             | 值: 102
路径: tasks -> [1] -> name           | 值: Transform
路径: tasks -> [1] -> status         | 值: active
路径: meta -> maintainer             | 值: admin
路径: meta -> retries                | 值: 3
3. 数据展开与路径树对比
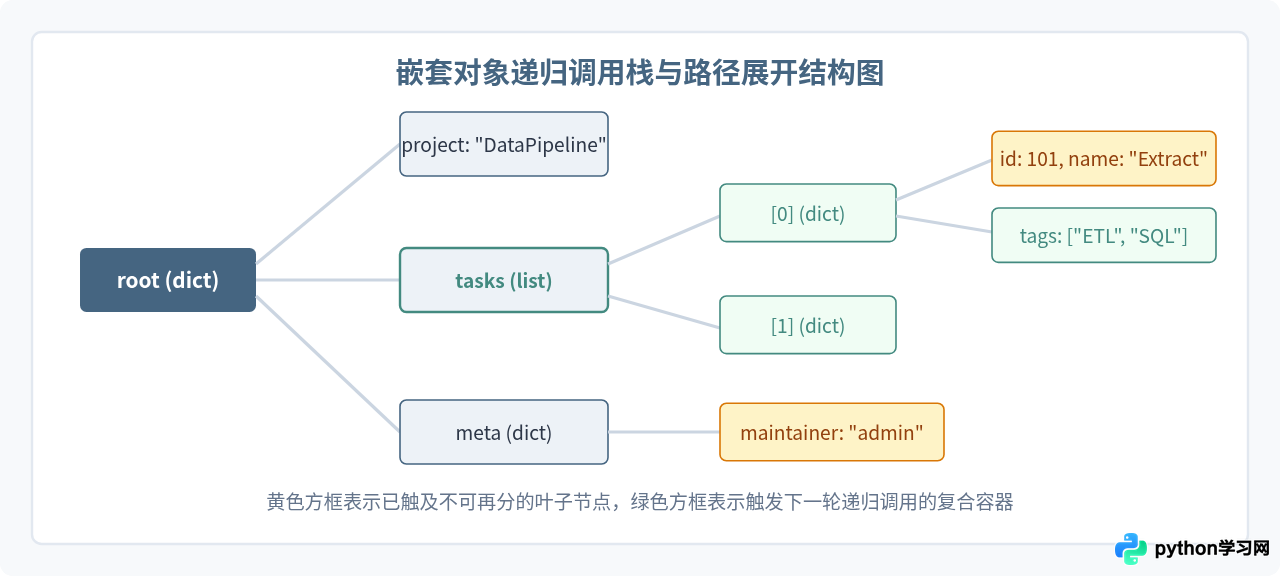
为了直观观察递归函数是如何在不同分支间切换的,我们可以将上述测试数据的层级路径转化为一棵调用树。每个非叶子节点均会派生出多个递归分支,直到遇到标量数值完成当前调用栈的弹栈返回。
4. 进阶场景:使用生成器扁平化提取键值对
在大型数据处理任务中,直接打印并不方便调用方消费数据。我们可以将递归遍历改造为 Python 生成器(Generator),使用 yield from 语法将叶子节点以流式方式产出,节约内存且调用方便:
def flatten_generator(node, current_path=""):
    """
    使用生成器流式产出嵌套对象中的所有 (完整路径, 值)
    """
    if isinstance(node, dict):
        for k, v in node.items():
            new_path = f"{current_path}.{k}" if current_path else str(k)
            yield from flatten_generator(v, new_path)
    elif isinstance(node, list):
        for idx, item in enumerate(node):
            new_path = f"{current_path}[{idx}]"
            yield from flatten_generator(item, new_path)
    else:
        yield (current_path, node)

# 转换为普通字典存储
flattened_dict = dict(flatten_generator(sample_data))
print("展平后的字典条目数:", len(flattened_dict))
print("指定路径的值:", flattened_dict.get("tasks[0].name"))
5. 注意事项与异常防范
在 Python 中,字典或列表是可以包含自身的引用的(例如
a = []; a.append(a))。如果没有防范机制,递归遍历会导致 RecursionError: maximum recursion depth exceeded。解决方案是在递归参数中维护一个已访问容器 id 的集合 seen = set()。
传递路径参数时,切勿直接对同一个列表执行
path.append(...) 后传入子调用,因为列表在 Python 中是可变引用对象,同级的后续循环会被前一个子调用的污染。务必使用 path + [key] 或 path.copy() 创建新切片传递。
6. 关键策略总结
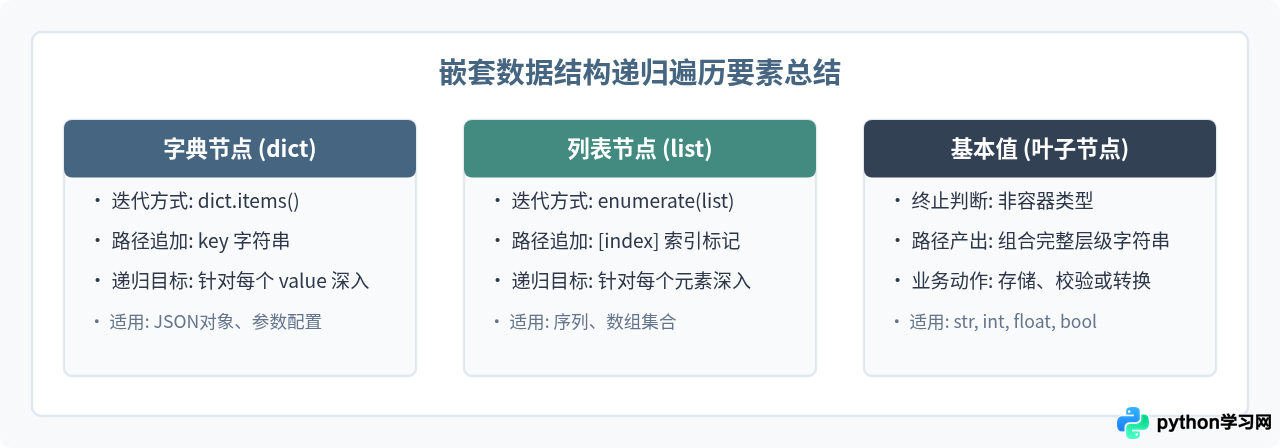
通过合理结合类型分支判断、路径追踪与循环保护,Python 递归函数能够优雅而高效地处理各种复杂的嵌套数据。下表系统归纳了不同类型节点在递归过程中的核心控制策略:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









