

Python高级语法入门:装饰器原理与生成器yield用法
深入浅出讲解Python装饰器的底层闭包原理与语法糖机制,以及生成器yield的状态保存与惰性求值特性,结合直观图解与实用代码示例帮助进阶学习。
一、装饰器的本质与底层原理
很多初学者觉得装饰器神秘,主要原因是 Python 提供的 @ 语法糖隐藏了函数的包装过程。要理解装饰器,必须先明确 Python 中函数的两个基本特征:函数是一等公民,以及闭包的运作方式。
1. 函数是一等公民与闭包机制
在 Python 中,函数与其他数据对象(如整数、字符串、列表)地位完全相同。函数可以被赋值给变量、作为参数传入其他函数,也可以作为其他函数的返回值传出。当一个函数被嵌套定义在另一个函数内部,并且引用了外部函数的局部变量时,就构成了“闭包”(Closure)。闭包会将内部函数及其依赖的环境变量打包保存下来,即使外部函数已经执行完毕,内部函数依然能访问这些外部变量。
2. 装饰器的原型推导
假设我们有一个核心业务函数 query_database(),现在需要统计它的执行耗时,但要求不能修改它的原有代码,也不能在每个调用点手动打点。我们可以编写一个接收函数作为参数的高阶函数:
import time

def measure_time(func):
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs)
        cost = time.time() - start_time
        print(f"[执行统计] {func.__name__} 耗时: {cost:.4f}秒")
        return result
    return wrapper

def query_database(record_id):
    time.sleep(0.1)
    return {"id": record_id, "data": "success"}

# 手动包装原函数
query_database = measure_time(query_database)

# 调用时依然使用原函数名
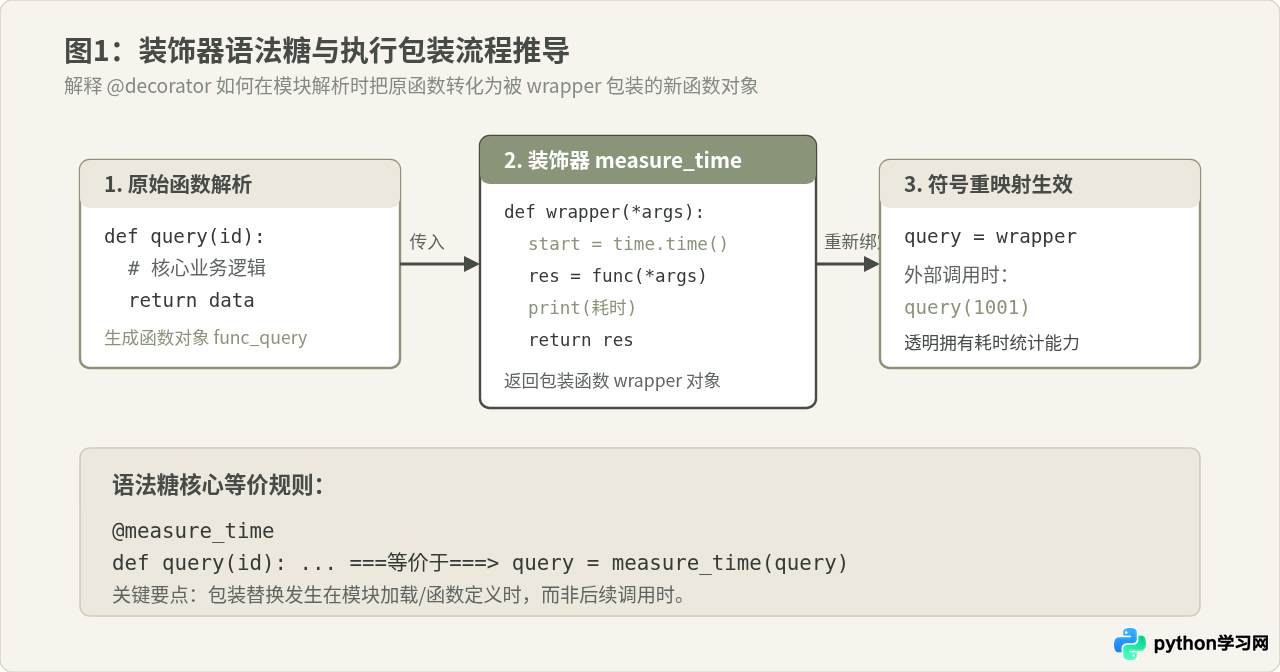
res = query_database(1001)在上面的代码中,measure_time(query_database) 返回了嵌套定义的 wrapper 函数对象,并重新赋值给变量名 query_database。此时再调用 query_database(1001),实际上执行的是具有计时功能的 wrapper 函数。
3. @ 语法糖的等价机制
Python 引入的 @measure_time 写法,纯粹是上述赋值操作的简写。在函数定义语句前加上 @measure_time,Python 解释器在完成函数解析的瞬间,就会自动执行这一层包装替换。
二、装饰器的进阶实战与细节处理
1. 保留函数元信息:functools.wraps
当一个函数被装饰器替换为 wrapper 之后,它的 __name__(函数名)、__doc__(文档注释)等元数据都会变成 wrapper 的信息。这会导致调试、日志记录或自动化文档提取时出现混乱。Python 标准库提供了 functools.wraps 装饰器,专门用于将原函数的元数据拷贝给 wrapper:
from functools import wraps

def audit_log(func):
    @wraps(func)
    def wrapper(*args, **kwargs):
        print(f"[审计] 即将调用函数: {func.__name__}")
        return func(*args, **kwargs)
    return wrapper

@audit_log
def transfer_money(from_account, to_account, amount):
    """执行银行转账核心逻辑"""
    return True

print(transfer_money.__name__)  # 输出: transfer_money (若未加 wraps 则输出 wrapper)
print(transfer_money.__doc__)   # 输出: 执行银行转账核心逻辑
2. 带参数的装饰器:三层函数嵌套
如果装饰器本身需要接收控制参数(例如设置重试次数、指定日志级别),必须在最外层再包装一个函数,用于接收装饰器参数。其本质是:外层函数返回一个普通的装饰器函数。
from functools import wraps

def retry(max_attempts=3, delay_seconds=1):
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            attempts = 0
            while attempts < max_attempts:
                try:
                    return func(*args, **kwargs)
                except Exception as err:
                    attempts += 1
                    print(f"调用 {func.__name__} 失败: {err},正在进行第 {attempts} 次重试...")
                    if attempts >= max_attempts:
                        raise err
        return wrapper
    return decorator

@retry(max_attempts=2, delay_seconds=0.5)
def fetch_api(endpoint):
    # 网络请求模拟
pass在这里,@retry(max_attempts=2) 首先执行 retry(...) 调用,返回了真正的装饰器 decorator;接着执行 fetch_api = decorator(fetch_api) 完成最终绑定。
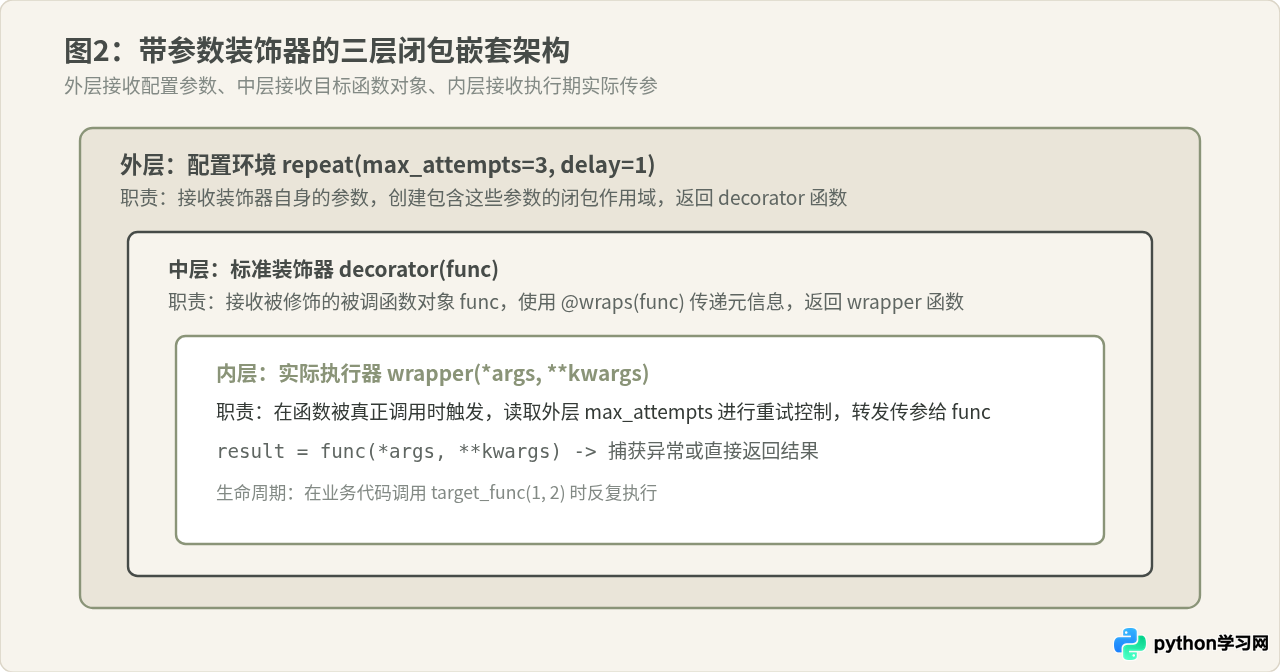
很多开发者误以为“装饰器是在函数被调用时才执行”。这种说法只说对了一半:装饰器外层与中层的包装逻辑是在 Python 导入模块或定义函数时立即执行的;而内层的 wrapper 函数代码才是在每次业务调用目标函数时动态执行的。如果装饰器最外层包含了耗时计算或外部连接,它在脚本启动导入阶段就会阻塞程序。
三、生成器与 yield 的核心机制
在处理海量数据或无限序列时,传统的列表(List)往往会带来灾难性的内存开销。生成器(Generator)是 Python 提供的极具杀伤力的特性,它用极其简洁的语法实现了内存友好的“按需计算”。
1. 从传统函数 return 到 yield 暂停
普通函数在遇到 return 语句后,会向调用者返回一个具体值,并且当前函数的整个栈帧(调用上下文、局部变量)被立即销毁并回收。下一次重新调用该函数时,一切从头开始。
而在函数体内部只要包含 yield 关键字,Python 就会在编译时将其标记为“生成器函数”(Generator Function)。调用生成器函数不会立即执行函数体内的代码,而是立即返回一个生成器对象(Generator Object)。只有当外部通过 next() 或 for 循环索要数据时,函数体才开始执行;当遇到 yield 时,函数会输出当前结果,并且冻结当前的执行位置与所有局部变量状态,让出 CPU 控制权。下次再次调用 next() 时,程序会从上次暂停的 yield 语句处无缝恢复继续往下走。
def simple_counter(limit):
    print("生成器启动...")
    current = 1
    while current <= limit:
        print(f"即将产出: {current}")
        yield current
        print(f"从 yield 恢复,准备计算下一项")
        current += 1
    print("计数器完成,正常退出")

# 1. 此时函数体完全没有运行,仅返回一个生成器对象
gen = simple_counter(2)
print("已获得生成器对象:", gen)

# 2. 第一次索要元素
print("第一次获取:", next(gen))

# 3. 第二次索要元素
print("第二次获取:", next(gen))

# 4. 第三次索要元素,生成器耗尽,抛出 StopIteration
try:
    next(gen)
except StopIteration:
    print("生成器已无更多数据,抛出 StopIteration 异常")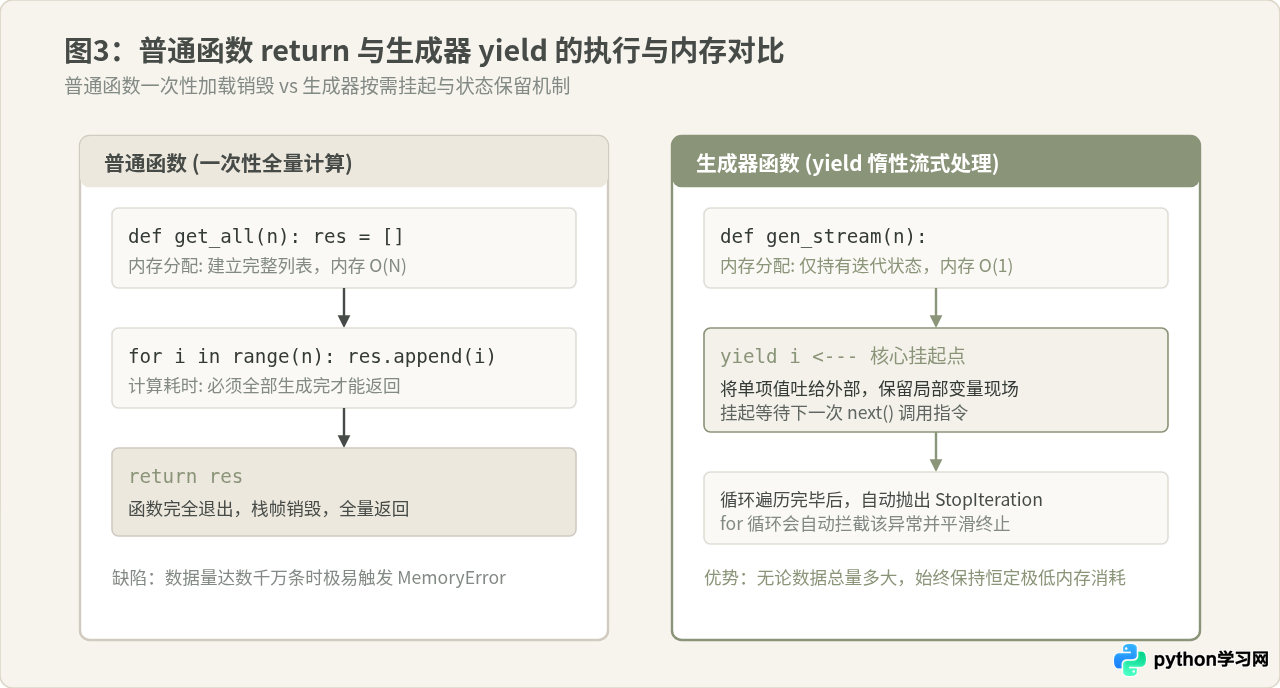
2. 实战场景:逐行处理超大文件
处理几十甚至上百吉字节(GB)的服务器访问日志时,若使用 f.readlines(),程序会尝试一次性将所有文本读入内存,直接引发内存溢出。通过生成器可以构建优雅的管道流式处理:
def stream_large_file(filepath):
    """惰性读取文件,每次仅读取并清洗一行"""
    with open(filepath, "r", encoding="utf-8") as file:
        for line in file:
            cleaned = line.strip()
            if cleaned and not cleaned.startswith("#"):
                yield cleaned

def filter_error_logs(log_stream):
    """过滤出包含 ERROR 标记的日志行"""
    for entry in log_stream:
        if "ERROR" in entry:
            yield entry

# 构建数据处理管道:链式组合,不发生全局内存加载
raw_stream = stream_large_file("server_access.log")
error_stream = filter_error_logs(raw_stream)

# 仅在最终消费时按需驱动计算
for error_item in error_stream:
    # 逐条写入报警数据库或输出
    pass
四、生成器的认知误区与常见细节
并非如此。 生成器是通过时间换取空间。每次从 yield 挂起再恢复都有微小的上下文切换开销。对于已知长度较小的数据集(例如几千项以内的数据),直接使用列表推导式在内存中一次性分配连续内存块,由于 CPU 缓存局部性好,遍历速度往往比生成器更快。生成器的核心优势在于“内存受限”、“数据集规模极大或无限”以及“下游消费可能提前终止”(例如只需要查找满足条件的第一个元素,不需要计算后续内容)。
绝对不能。 生成器是一次性消费品(Single-pass Iterator)。一旦内部迭代指针走到了尽头抛出了 StopIteration,该生成器对象就被“耗尽”(Exhausted)。若需要再次遍历,必须重新调用生成器函数创建全新的生成器实例,无法像列表那样重复使用已有的生成器对象。
3. 生成器中的 return 语句有何含义?
在 Python 2 中,生成器函数内部不允许使用带返回值的 return。但在 Python 3.3+ 引入协程机制后,生成器函数内部允许编写 return value。当执行到 return value 时,生成器会立即终止,并将该返回值作为 StopIteration(value) 异常的附加数据携带出去:
def task_runner():
    yield "第一阶段完成"
    yield "第二阶段完成"
    return "全部任务统计摘要"

gen = task_runner()
print(next(gen))  # 输出: 第一阶段完成
print(next(gen))  # 输出: 第二阶段完成

try:
    next(gen)
except StopIteration as e:
    print("生成器退出返回值为:", e.value)  # 输出: 全部任务统计摘要
五、装饰器与生成器的核心要点速查总结
装饰器和生成器分别代表了 Python 两种核心的高级编程思想:装饰器偏重于结构维度的横切扩展与复用,在代码架构层面解决日志、权限、缓存、性能监控等切面逻辑;生成器偏重于时间与空间维度的流动控制,在数据计算层面解决资源消耗、流式处理与状态维护问题。
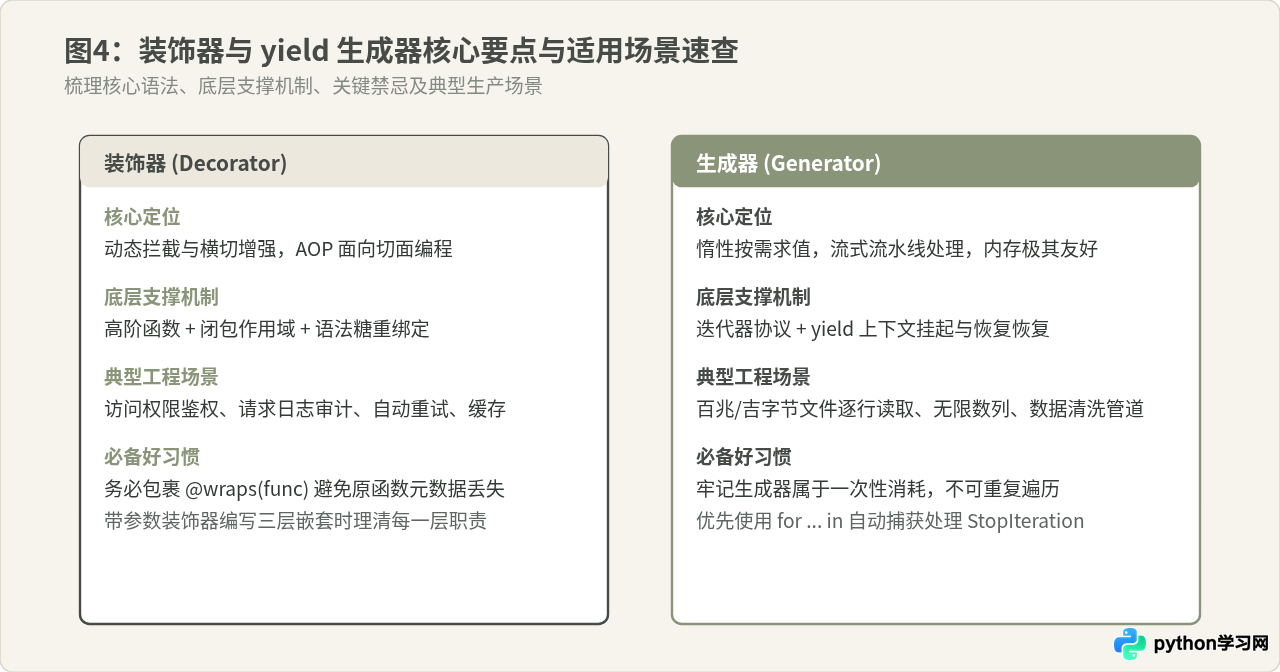
| 比较维度 | 装饰器 (Decorator) | 生成器 yield (Generator) |
|---|---|---|
| 核心解决问题 | 不破坏原代码的同时扩展函数横切功能 | 海量数据或耗时计算下的内存与状态管理 |
| 实现载体 | 高阶函数 + 内部包装函数 (wrapper) | 包含 yield 关键字的函数或生成器表达式 |
| 调用返回结果 | 返回包装后的新函数对象 | 返回实现了迭代器协议的生成器对象 |
| 内存特征 | 取决于闭包保存的外部变量多少 | O(1) 常数级内存占用,每次仅驻留单个元素 |
| 典型应用 | 权限认证、计时器、日志审计、单例模式 | 文件流读取、流式数据清洗、斐波那契无限序列 |
掌握装饰器的关键,在于彻底看清 @ 语法糖背后“输入函数、返回新函数”的闭包映射关系;而掌握生成器的关键,在于领会 yield 带来的“按需索取、挂起等待、保留现场”的惰性流动方式。在日常工程开发中,合理搭配这两项高级语法,既能保持核心业务代码的纯粹与整洁,又能显著降低程序对系统资源的开销。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









