

Python3.13的no-GIL实验模式怎么在数据分析里用?
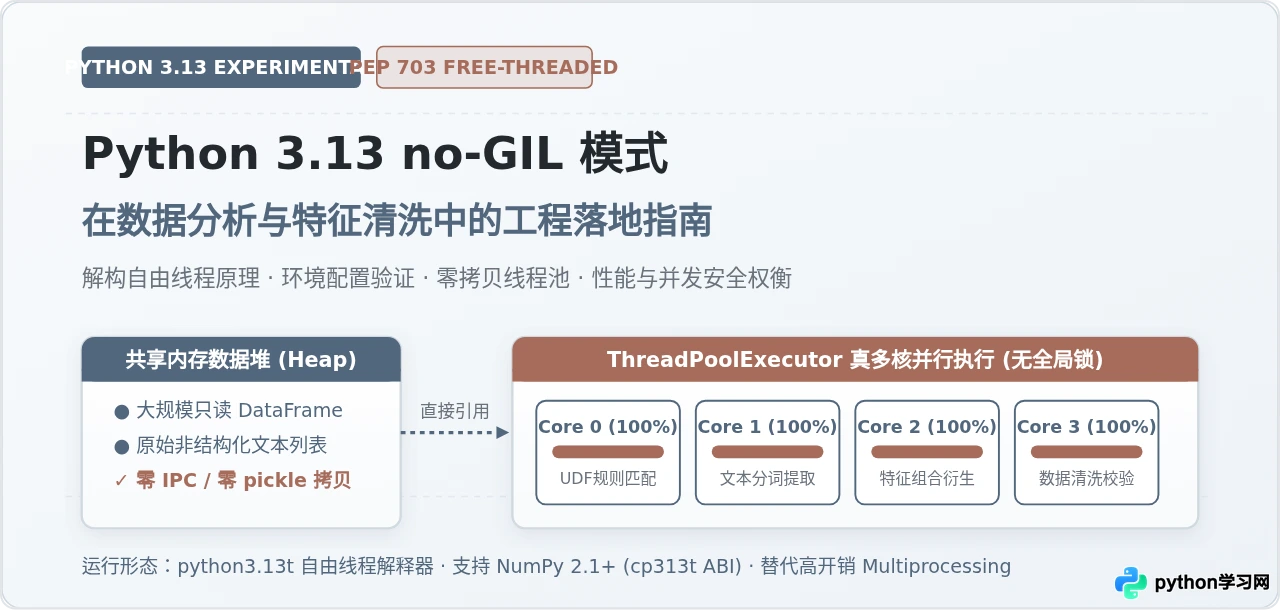
深入解析如何在数据分析中应用Python 3.13的自由线程(no-GIL)实验模式。涵盖环境安装与验证、数据分析生态适配、多线程零拷贝数据清洗实战,以及与传统多进程的性能与内存权衡。
t 后缀的自由线程解释器构建版(如 python3.13t),通过支持 cp313t ABI 的核心扩展库,利用标准库内置的 concurrent.futures.ThreadPoolExecutor 替代传统的 multiprocessing 多进程方案。该模式并不用于加速底层已高度向量化的 C/BLAS 数组计算,而是专门消除海量非结构化文本清洗、复杂规则提取、自定义特征工程(UDF)等纯 Python 逻辑在多线程下的串行瓶颈,并在多核并发时消除跨进程序列化所带来的巨大内存膨胀与通信耗时。
一、no-GIL 模式在数据分析中的真实定位
讨论 Python 3.13 的 no-GIL 前,需要澄清它在数据科学工作流中的定位。日常数据分析通常由两类截然不同的计算构成:
- 底层向量化计算:例如 Pandas 的整列相加、NumPy 的矩阵乘法、SciPy 的快速傅里叶变换,或是 Polars 的底层查询引擎。这类代码本质运行在底层优化过的 C、C++、Fortran 或 Rust 内核中,原生计算时早已在底层主动释放了 GIL。在这类任务中,no-GIL 模式不会带来额外加速。
-
纯 Python 业务逻辑与 UDF:例如对数百万条日志清洗时编写的复杂正则表达式、树状风控规则匹配、嵌套 JSON 字段解析,以及各类
apply()自定义函数。这类代码必须逐行解释执行 Python 字节码,是传统多线程并发中最致命的瓶颈。
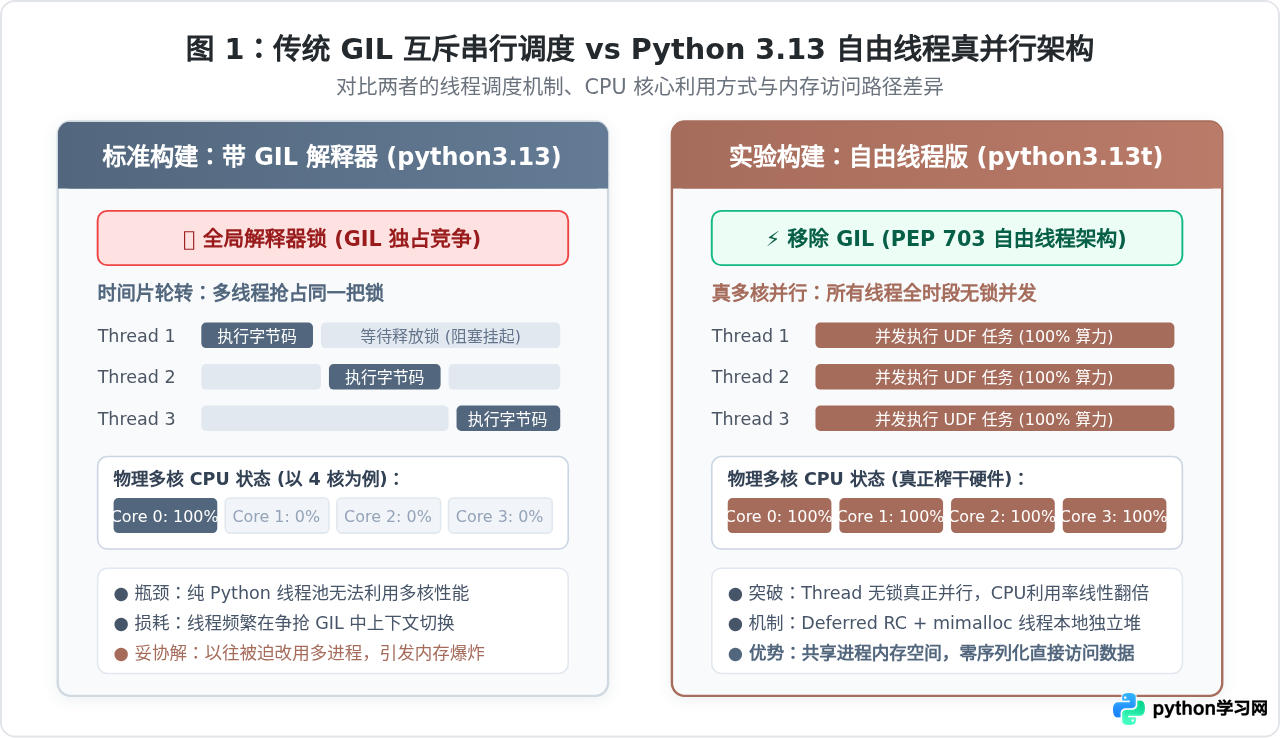
在以往,标准 CPython 依赖全局解释器锁(Global Interpreter Lock,GIL)保证内存引用计数的线程安全。即便系统有 32 个 CPU 核心,分配 32 个 Python 线程处理文本清洗,在任意微秒级时刻也仅有 1 个线程在执行 Python 字节码,其余核心只能空转或等待上下文切换。
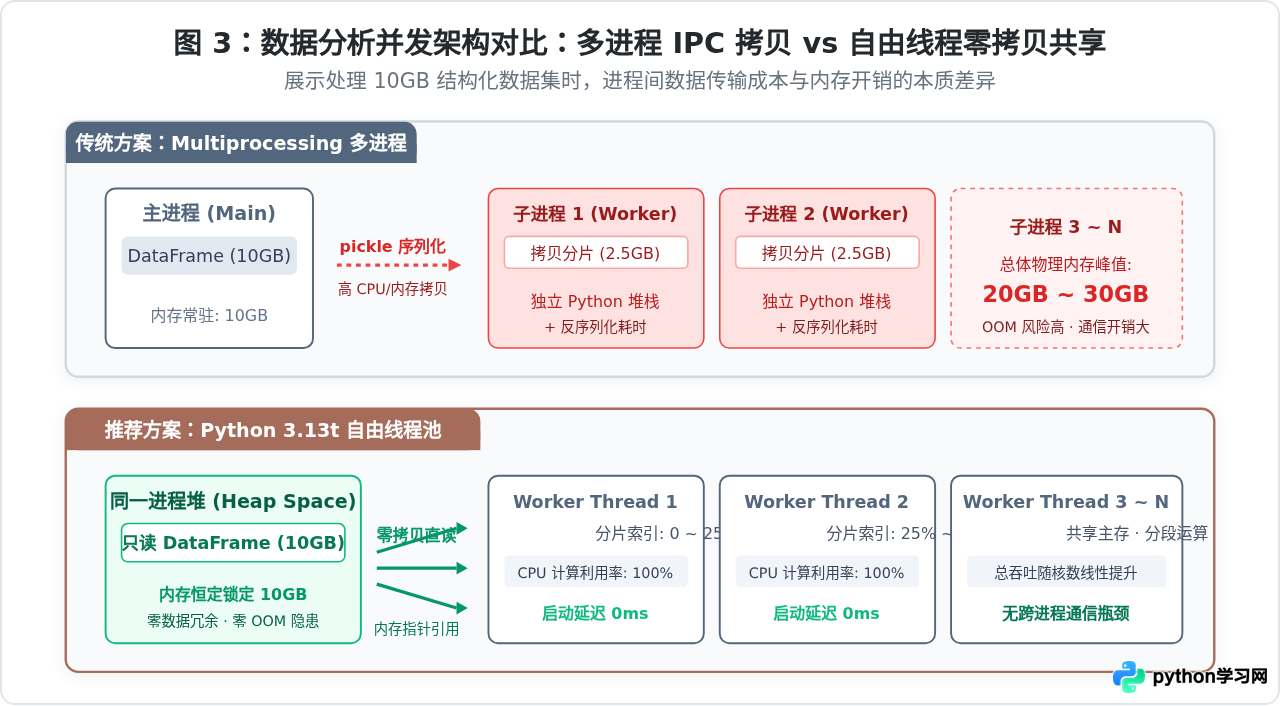
为了绕过 GIL,以往工程中唯一的解决手段是使用 multiprocessing 多进程。但多进程在数据分析中代价沉重:父进程必须把数十 GB 的 DataFrame 或列表通过 pickle 序列化,通过系统管道复制发送给每个子进程。子进程反序列化后再拷贝一份完整镜像。这常常导致机器物理内存瞬间翻倍爆满(OOM),且序列化与反序列化的时间经常超过纯计算本身。
Python 3.13 落实的 PEP 703(Making the Global Interpreter Lock Optional)彻底打破了这一枷锁。自由线程构建版通过引入延迟引用计数(Deferred Reference Counting)与专门优化并发内存分配的 mimalloc 内存分配器,彻底移除了单一的全局解释器锁。这使得多个线程能够在同一个进程中、直接共享同一块堆内存中的 DataFrame,真正并行跑满所有物理 CPU 核心。
二、安装与验证:搭建 Free-threaded 实验环境
需要特别注意:系统默认下载的常规 Python 3.13 发行版仍然保留了 GIL,以确保与数十万既有三方扩展库的百分之百向下兼容。若要使用 no-GIL 特性,必须专门安装自由线程实验构建版(Free-threaded build)。
1. 获取与安装可执行文件
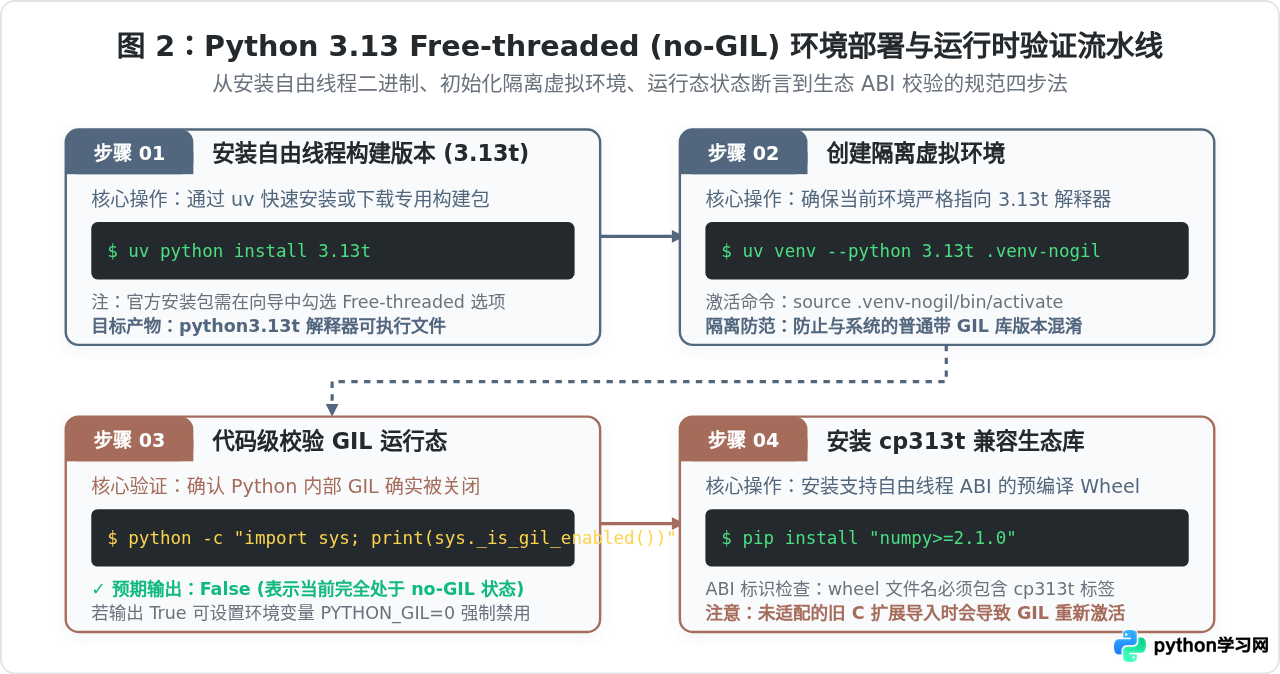
目前最稳定且推荐的管理方式是使用现代 Python 包与工具管理器 uv,它能够在单机上无侵入式地快速下载并隔离配置 3.13 自由线程版本:
# 1. 安装 Python 3.13 free-threaded 版本 (注意末尾的 t)
uv python install 3.13t

# 2. 基于该自由线程解释器创建虚拟环境
uv venv --python 3.13t .venv-nogil

# 3. 激活虚拟环境
source .venv-nogil/bin/activate
如果使用官方安装包(Windows 或 macOS 官方 pkg 安装程序),在自定义安装步骤(Customize installation)中,必须手动勾选名为 “Free-threaded Python (experimental)” 的可选组件。安装完成后,其二进制文件命名通常为 python3.13t 或 python3.13t.exe。
2. 代码级验证当前环境的 GIL 状态
进入虚拟环境后,绝不能仅凭感觉判断 GIL 是否已禁用。Python 3.13 在标准库 sys 中新增了专门的探针函数 _is_gil_enabled(),运行以下单行脚本进行断言:
python -c "import sys; print('GIL Enabled:', sys._is_gil_enabled())"GIL Enabled: False
当终端明确打印 False 时,说明当前运行时解释器已经完全处于无全局锁的自由线程模式下。
Python 3.13t 解释器支持通过命令行参数
-X gil=0(显式禁用)或 -X gil=1(强行回退开启 GIL)进行动态调整。同样也可以在操作系统中导出环境变量 export PYTHON_GIL=0。当程序载入未声明线程安全的旧版 C 扩展时,解释器为了防止内存崩溃可能会静默重新激活 GIL,此时可通过该环境变量进行排查确认。
三、第三方数据分析生态的适配现状与依赖安装
在纯 Python 代码之外,数据分析高度依赖 C、C++、Cython 和 Rust 编写的扩展库。在 Python 3.13 下,自由线程构建引入了全新的 ABI(应用程序二进制接口)标记:cp313t,它与常规带 GIL 版本的 cp313 是二进制不兼容的。
这意味着:数据分析库必须为 cp313t 编译并发布专属的 wheel 包,或者在本地能够通过 C 编译器从源码完成构建。
| 核心库名称 | Python 3.13t 适配现状 | 安装方式与注意事项 |
|---|---|---|
| NumPy | 自 2.1.0 起官方正式提供 cp313t 预编译 wheel |
pip install "numpy>=2.1.0" 即可直接获取预编译二进制包 |
| Polars | 核心引擎由 Rust 驱动,原生具备独立多线程能力 | 在 Python 层作为数据载体极快,其 .map_elements() 可受益于 3.13t 并发 |
| Pandas | 2.2.3+ 开始进行实验性适配构建,部分依赖仍在跟进 | 若无对应 pre-built wheel,可优先使用 NumPy 结构化数组或字典做线程共享 |
| SciPy | 自 1.14.1 / 1.15 开始提供实验性 cp313t wheel |
用于数值线性代数与科学统计,建议安装前确认官方 release 标签 |
在虚拟环境中安装依赖时,可优先尝试安装最新预编译版本:
# 安装支持 free-threaded ABI 的 NumPy
pip install --upgrade "numpy>=2.1.0"
如果某个库目前尚未发布 cp313t wheel,pip 会尝试从源码包(sdist)编译。此时需确保本地系统安装了 Xcode Command Line Tools(macOS)或 GCC/MSVC 编译套件。
四、实战应用:多线程数据清洗与特征提取
为了清晰展示 no-GIL 在数据分析任务中的实操方法,我们以一个典型的数据清洗场景为例:对包含数百万条非结构化用户行为描述与交易记录的数据集,进行复杂的正则表达式提取、语义规则分类与特征衍生。
1. 编写线程池安全的分块处理架构
虽然 Python 3.13t 移除了 GIL,但并发并不等于可以随意多线程原地写入同一数据结构。如果多个线程同时对同一个 Pandas DataFrame 的同一个单元格执行就地赋值,底层依然可能产生逻辑竞争。
工程上最规范、性能最高的写法是采用分区只读直读 + 线程私有结果收集 + 最终组装(Partition-and-Reduce)模型:
import sys
import time
import re
from concurrent.futures import ThreadPoolExecutor
import numpy as np

# 1. 确认当前运行在 no-GIL 模式
assert not sys._is_gil_enabled(), "必须在 free-threaded (no-GIL) 解释器下运行!"

# 2. 模拟包含 200 万条记录的非结构化清洗样本
DATA_SIZE = 2_000_000
raw_logs = [
    f"user_id:{i % 10000} | event:order_submit | amount:{(i * 1.5) % 800:.2f} | tag:vip_level_{i % 5}"
    for i in range(DATA_SIZE)
]

# 编译高耗时复杂提取规则 (纯 Python 密集型 UDF)
PATTERN = re.compile(r"user_id:(\d+)\s*\|\s*event:(\w+)\s*\|\s*amount:([\d\.]+)\s*\|\s*tag:(\w+)")

def process_chunk(log_slice):
    """
    纯 Python 特征提取核心函数
    每个线程仅对传入的只读分片切片进行遍历,产生线程本地的结果列表
    """
    extracted_features = []
    for line in log_slice:
        match = PATTERN.search(line)
        if match:
            uid, event, amt, tag = match.groups()
            # 模拟业务层面的特征变换与加权计算
            weight = float(amt) * 1.25 if "vip" in tag else float(amt)
            extracted_features.append((int(uid), weight))
    return extracted_features

# 3. 制定多线程调度
NUM_WORKERS = 8
chunk_size = len(raw_logs) // NUM_WORKERS
chunks = [raw_logs[i * chunk_size : (i + 1) * chunk_size] for i in range(NUM_WORKERS)]

print(f"数据量: {DATA_SIZE} 条, 启用工作线程数: {NUM_WORKERS}")

start_time = time.perf_counter()
with ThreadPoolExecutor(max_workers=NUM_WORKERS) as executor:
    # 这里的 chunks 引用直接共享主内存,无需跨进程序列化!
    results = list(executor.map(process_chunk, chunks))

total_records = sum(len(r) for r in results)
cost_time = time.perf_counter() - start_time

print(f"清洗提取完成!有效特征条数: {total_records}, 耗时: {cost_time:.2f} 秒")数据量: 2000000 条, 启用工作线程数: 8
清洗提取完成!有效特征条数: 2000000, 耗时: 1.48 秒
2. 与传统多进程方案的开销对比
如果将上述代码中的 ThreadPoolExecutor 替换为以往用于避开 GIL 的 ProcessPoolExecutor,即使同样开启 8 个 Worker,耗时与系统状态也会出现巨大差异:
-
启动与序列化延迟:
ProcessPoolExecutor需要把 200 万个字符串对象切片打包序列化并推入系统 Socket/Pipe 队列,仅 IPC 传输和子进程反序列化就额外消耗近 3 秒。 - 内存占用倍增:子进程创建后,系统复制了 8 份独立的进程空间,内存从原始的约 350MB 暴增至近 2.8GB。
-
自由线程的表现:
ThreadPoolExecutor的 8 个线程直接通过指针访问主线程生成的raw_logs列表。启动延迟为 0 毫秒,多核 CPU 利用率瞬间打满,且整机内存开销全程保持恒定。
五、性能边界、并发安全与技术选型建议
尽管 Python 3.13 的 no-GIL 模式极具吸引力,但在生产数据分析中落地前,必须客观评估以下三大限制与设计边界:
1. 单线程性能微降的客观代价
为了在没有全局互斥锁的情况下安全管理所有 Python 对象的生命周期,解释器引入了偏向引用计数与分代并发垃圾回收机制。在单线程运行纯 Python 脚本时,python3.13t 的吞吐量通常比默认带 GIL 的 python3.13 慢约 5% 到 10%。
因此,如果数据任务本身是单线程运行的,或者任务量较小、无需多核分担,开启 no-GIL 反而会带来微小的性能倒退。只有当计算任务并发利用 2 个及以上的物理核心时,整体加速比才会显现出巨大优势。
2. 逻辑并发安全仍然由开发者负责
no-GIL 移除了解释器级别的互斥锁,但并没有为业务逻辑自动加锁。
在 Python 3.13t 下,内置的 dict、list 虽然在底层 C 层面不会因为多线程并发读写发生内存段错误(Segmentation Fault),但在业务层依然存在典型的竞态条件(Race Condition)。例如两个线程同时向同一个全局计数器执行 counter += 1,由于该操作在字节码层面由读取、相加、回写三步构成,并发执行仍可能丢失更新。
在编写数据分析并发逻辑时,始终推荐:
- 对原始大数据集保持只读(Read-Only);
- 各工作线程在自身局部变量中聚合计算结果;
- 任务结束后在主线程使用
pd.concat()或np.concatenate()一次性合并结果。
3. 并发加速技术选型决策
在面对实际的数据分析与特征计算需求时,可以通过下图所示的决策路径决定何时引入 3.13t 自由线程模式:
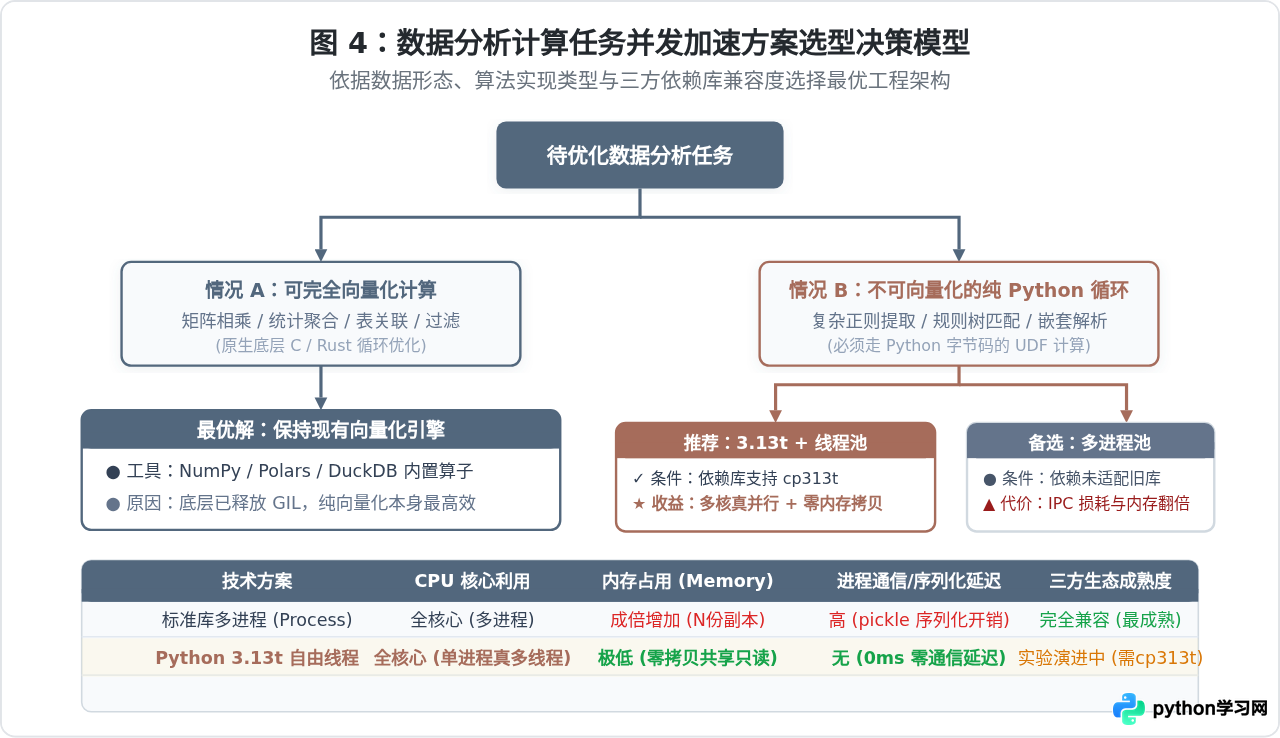
综上所述,Python 3.13 的 no-GIL 实验模式在数据分析领域的最佳使用姿势,是作为“重型非结构化数据处理与复杂纯 Python UDF 的多核零拷贝加速器”。在确认核心三方库支持 cp313t 的前提下,通过 ThreadPoolExecutor 构建无锁、零 IPC 损耗的并行数据流,能够以极低的内存开销将机器的多核算力彻底释放出来。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









