

python必背源代码多进程multiprocessing代码
系统梳理Python多进程multiprocessing必背源代码与工业级标准范式,涵盖Process单进程创建、if __name__ == '__main__'入口守护、Pool进程池批量分发、Queue跨进程管道通信、Lock互斥资源锁以及避免死锁与内存泄漏的核心避坑指南。
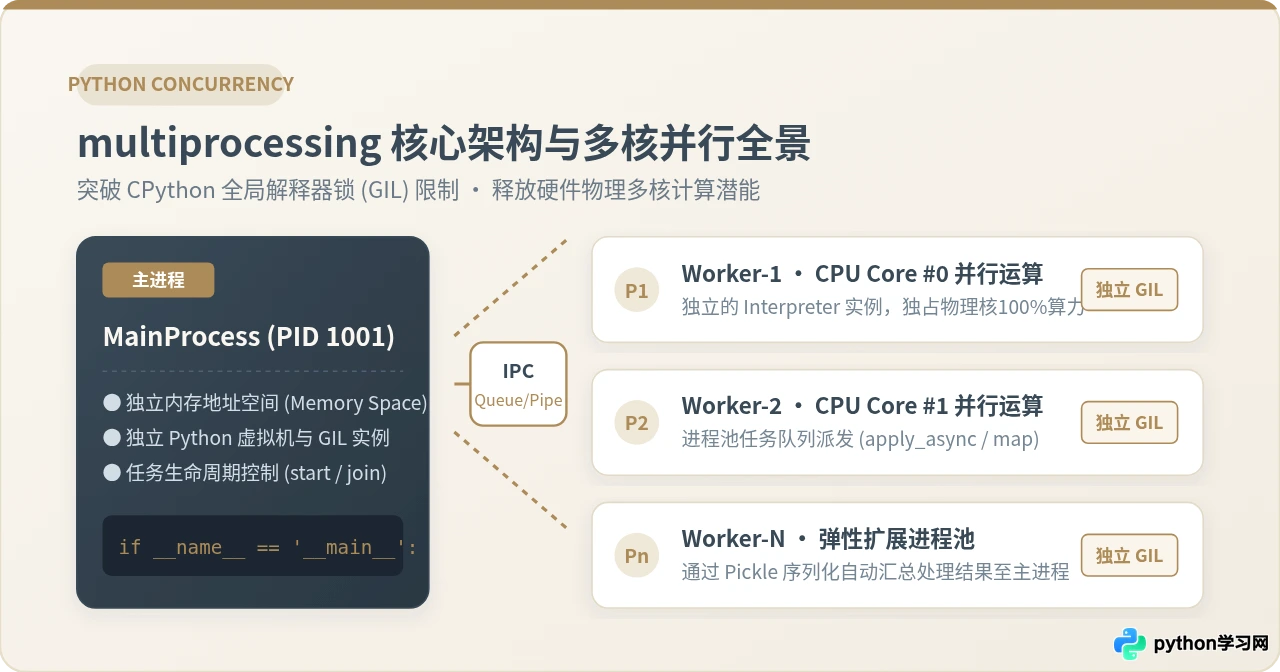
multiprocessing 模块通过派生独立的子进程并为每个子进程分配独立的 Python 解释器与独立内存空间,彻底绕开了 CPython 全局解释器锁(GIL)的束缚,是 Python 在单机多核服务器上处理 CPU 密集型任务(如海量数据解析、数学建模、音视频编解码与科学计算)的核心武器。本文紧扣实战必须掌握的关键源码模板,直接提供单进程创建、入口守护、进程池批量分发、管道队列通信和互斥锁同步等经典骨架代码,并深入剖析其执行机制与避坑准则。
一、为什么必须掌握 multiprocessing:与多线程的核心区别
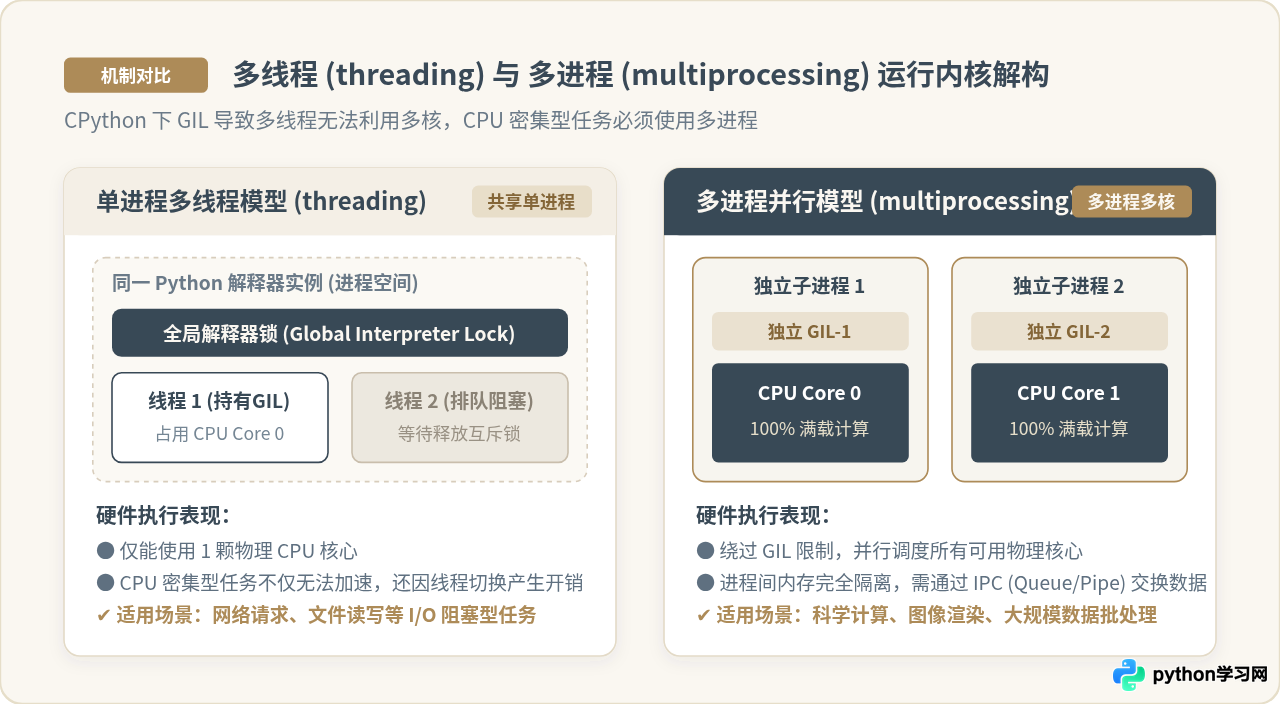
在编写并发程序前,必须首先分清任务类型与并发工具的匹配关系。CPython 解释器内置了全局解释器锁(Global Interpreter Lock,简称 GIL)。在单进程环境下,即使启动了多个 threading.Thread 线程,同一时刻也仅有 1 个线程能够在 CPU 物理核上执行字节码。对于计算量密集的数值任务,多线程不仅无法缩短耗时,还会因为频繁的上下文切换引发额外的性能损耗。
multiprocessing 的解决方式是“以空间换算力”:每次启动一个子进程,操作系统都会创建一个全新的进程实体,拥有专属的虚拟内存空间与独立的 Python 虚拟机。各个子进程分别持有各自独立的 GIL,由操作系统内核分配到不同的 CPU 物理核心上并行运算,从而实现线性的算力倍增。
二、必背代码 1:基础进程创建与 if __name__ == '__main__' 守卫
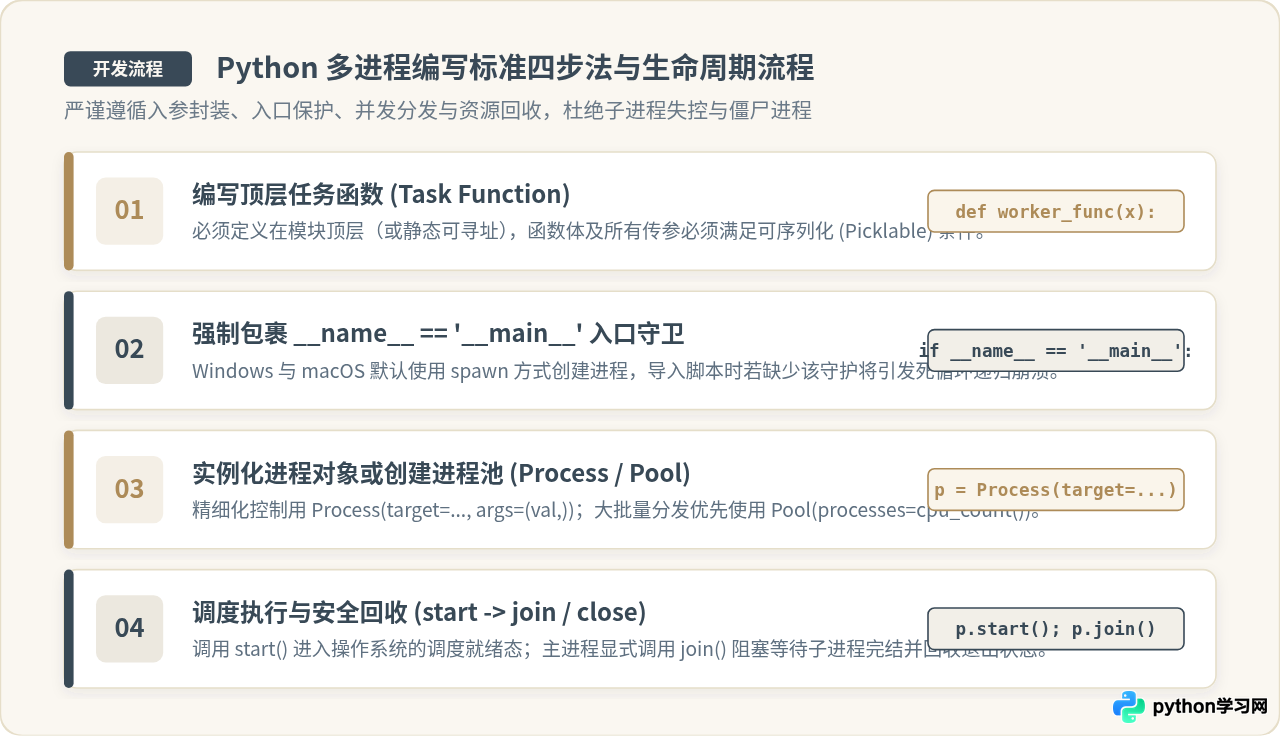
使用 Process 类创建进程是多进程编程的最基础单元。编写多进程代码时,第一项必须刻在肌肉记忆中的铁律就是:所有启动子进程的代码必须置于 if __name__ == '__main__': 之后。
在 Windows 与 macOS(Python 3.8+ 默认)系统中,新进程的创建方式为 spawn。其底层机制是新启动一个 Python 进程,然后重新 import 运行的主脚本。如果主代码没有 __name__ == '__main__' 保护,新子进程在加载脚本时又会执行创建子进程的代码,进而引发无限递归派生子进程的雪崩崩溃(引发 RuntimeError 异常)。
标准单进程与多进程创建源码模板
import multiprocessing
import os
import time

def worker_task(task_name, duration):
    """子进程执行的任务函数(必须位于模块顶层)"""
    print(f"[子进程启动] 名称: {task_name}, PID: {os.getpid()}, 父进程PPID: {os.getppid()}")
    time.sleep(duration)
    print(f"[子进程完结] 名称: {task_name}, PID: {os.getpid()}")

if __name__ == '__main__':
    print(f"[主进程开始] PID: {os.getpid()}")

    # 实例化 Process 对象
    # 注意:args 必须传递元组,单个参数时末尾必须加英文逗号 (val,)
    process_list = []
    for i in range(3):
        p = multiprocessing.Process(
            target=worker_task,
            args=(f"任务_{i + 1}", 1),
            name=f"WorkerProcess-{i + 1}"
        )
        process_list.append(p)
        p.start()  # 通知操作系统就绪,启动子进程

    # 主进程阻塞等待所有子进程执行完毕,安全回收进程资源
    for p in process_list:
        p.join()
        print(f"进程 {p.name} (退出码: {p.exitcode}) 已被成功回收")

print("[主进程结束] 所有并发任务处理完毕")[主进程开始] PID: 45100
[子进程启动] 名称: 任务_1, PID: 45101, 父进程PPID: 45100
[子进程启动] 名称: 任务_2, PID: 45102, 父进程PPID: 45100
[子进程启动] 名称: 任务_3, PID: 45103, 父进程PPID: 45100
[子进程完结] 名称: 任务_1, PID: 45101
[子进程完结] 名称: 任务_2, PID: 45102
[子进程完结] 名称: 任务_3, PID: 45103
进程 WorkerProcess-1 (退出码: 0) 已被成功回收
进程 WorkerProcess-2 (退出码: 0) 已被成功回收
进程 WorkerProcess-3 (退出码: 0) 已被成功回收
[主进程结束] 所有并发任务处理完毕
p.start():仅仅是将进程放入操作系统的就绪调度队列,不会产生阻塞;不要错误地调用p.run(),直接调用run()只会在当前主进程中单线程顺序执行。p.join():调用方(主进程)在此挂起等待,直到目标子进程退出。如果不调用join(),子进程结束后其退出状态无法被内核清理,可能在系统进程表中留下僵尸进程(Zombie Process)。args=(val,):参数元组中如果只有 1 个元素,必须保留尾随逗号;否则(val)会被 Python 识别为普通括号运算,从而报出参数拆包类型错误。
三、必背代码 2:工业级高频首选 multiprocessing.Pool 进程池
在实际生产环境中,若待处理的数据有数万项,若为每条数据都调用 Process() 实例化一个进程,操作系统会在创建、切换与销毁数万个进程的开销中彻底卡死,耗尽系统句柄与内存。工业级的通用解决方案是进程池(Process Pool):预先初始化固定数量的工作进程(Worker),自动复用工作进程并轮询分发任务。
标准进程池源码模板 (Pool.map 与 Pool.apply_async)
import multiprocessing
import os
import time

def square_calculate(x):
    """纯计算密集型任务"""
    # 模拟耗时运算
    result = x * x
    return f"数值 {x} 的平方结果是 {result} (计算者 PID: {os.getpid()})"

if __name__ == '__main__':
    # 获取机器可用的最大物理核数,生产环境建议预留 1 个核给操作系统调度
    cpu_cores = max(1, multiprocessing.cpu_count() - 1)
    print(f"当前机器逻辑核数: {multiprocessing.cpu_count()},启动进程池容量: {cpu_cores}")

    dataset = [1, 2, 3, 4, 5, 6, 7, 8]

    # 方式一:使用上下文管理器或显式 close/join (推荐 maxtasksperchild 规避内存泄露)
    with multiprocessing.Pool(processes=cpu_cores, maxtasksperchild=1000) as pool:
        # pool.map:阻塞式并行分发,严格保持入参与返回结果顺序一致
        results = pool.map(square_calculate, dataset)

        print("
--- pool.map 执行结果 ---")
        for item in results:
            print(item)

        # 方式二:pool.apply_async 异步非阻塞分发(适用于带回调或不同耗时任务)
        print("
--- pool.apply_async 异步分发 ---")
        async_results = []
        for x in dataset[:3]:
            # apply_async 接收 args 元组,返回 AsyncResult 对象
            res = pool.apply_async(square_calculate, args=(x,))
            async_results.append(res)

        # 提取异步返回结果
        for res in async_results:
print("[异步获取]:", res.get(timeout=5))当前机器逻辑核数: 8,启动进程池容量: 7
--- pool.map 执行结果 ---
数值 1 的平方结果是 1 (计算者 PID: 45210)
数值 2 的平方结果是 4 (计算者 PID: 45211)
数值 3 的平方结果是 9 (计算者 PID: 45212)
...
--- pool.apply_async 异步分发 ---
[异步获取]: 数值 1 的平方结果是 1 (计算者 PID: 45210)
[异步获取]: 数值 2 的平方结果是 4 (计算者 PID: 45211)
[异步获取]: 数值 3 的平方结果是 9 (计算者 PID: 45212)
maxtasksperchild=1000 是防止内存泄露的必杀技。在 Python 中,如果任务函数内部调用了 C 扩展模块、大型科学计算库(如 NumPy/Pandas)或存在轻微内存未及时回收的对象,长期运行的工作进程内存占用会逐渐膨胀。配置该参数后,子进程每执行完指定数量的任务就会自动退出并重建新进程,彻底释放泄漏的内存。
四、必背代码 3:跨进程通信 IPC:multiprocessing.Queue 管道
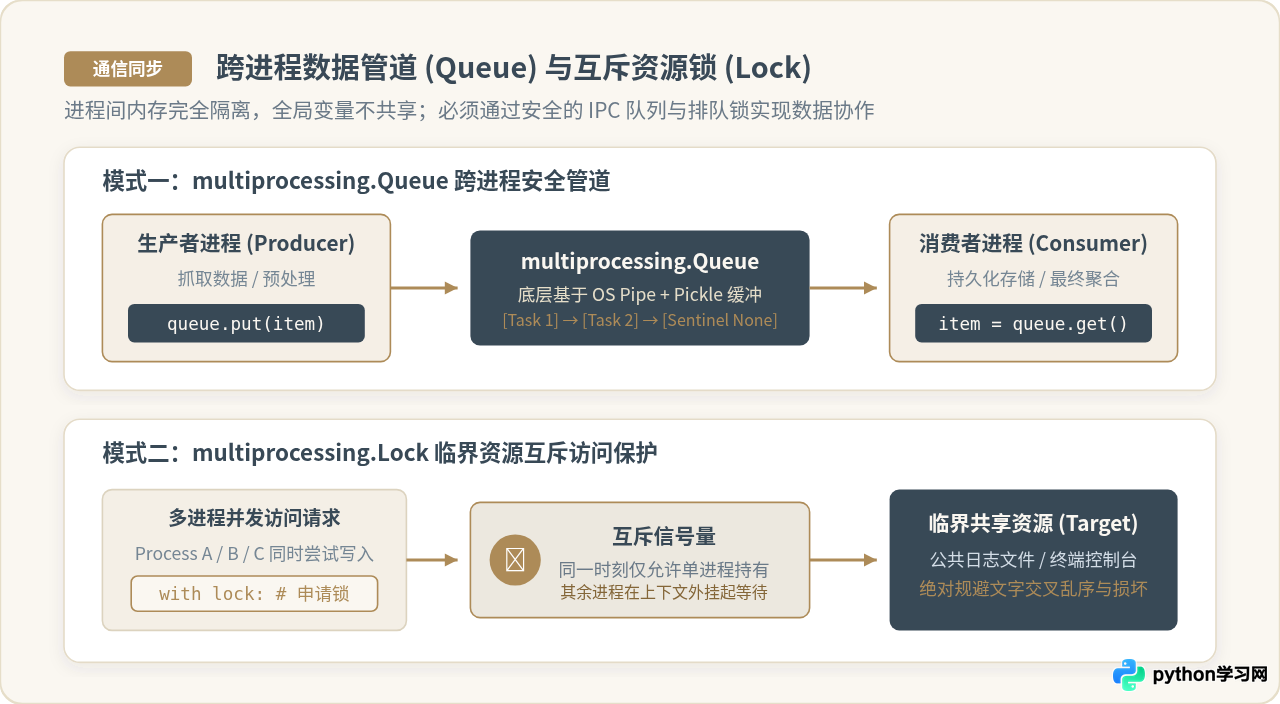
初学者最容易犯的错误是:试图通过修改全局变量或列表来收集多进程的计算结果。因为进程间内存空间完全独立,子进程修改的仅仅是其自身内存镜像中的副本,主进程中的全局变量绝对不会发生任何改变。要跨进程传输数据,必须通过进程安全的数据管道(IPC Queue)。
生产者-消费者跨进程通信源码模板
import multiprocessing
import time
import os

def producer_task(data_queue, total_items):
    """生产者进程:生成数据并放入跨进程队列"""
    print(f"[生产者启动] PID: {os.getpid()}")
    for i in range(1, total_items + 1):
        item = f"DataPacket-{i}"
        data_queue.put(item)  # 若队列满则阻塞,保证内存安全
        print(f"生产者产生: {item} (队列当前近似大小: {data_queue.qsize()})")
        time.sleep(0.1)

    # 发送终止哨兵标记 (Sentinel)
    data_queue.put(None)
    print("[生产者结束] 已发送终止信号")

def consumer_task(data_queue):
    """消费者进程:从队列监听并消费数据"""
    print(f"[消费者启动] PID: {os.getpid()}")
    while True:
        item = data_queue.get()  # 阻塞等待数据
        if item is None:  # 收到终止哨兵,优雅退出
            print("[消费者检测到终止哨兵] 安全退出消费循环")
            break
        print(f"消费者成功处理: {item}")
        time.sleep(0.15)

if __name__ == '__main__':
    # 注意:必须使用 multiprocessing.Queue(),不可混用 queue.Queue()
    # 显式限制 maxsize 可防止生产者过快导致内存爆仓(背压机制)
    shared_queue = multiprocessing.Queue(maxsize=5)

    p_producer = multiprocessing.Process(target=producer_task, args=(shared_queue, 5))
    p_consumer = multiprocessing.Process(target=consumer_task, args=(shared_queue,))

    p_consumer.start()
    p_producer.start()

    p_producer.join()
    p_consumer.join()

print("[主进程] 生产者与消费者均已正常停止")[消费者启动] PID: 45302
[生产者启动] PID: 45301
生产者产生: DataPacket-1 (队列当前近似大小: 1)
消费者成功处理: DataPacket-1
生产者产生: DataPacket-2 (队列当前近似大小: 1)
消费者成功处理: DataPacket-2
...
生产者产生: DataPacket-5 (队列当前近似大小: 1)
[生产者结束] 已发送终止信号
消费者成功处理: DataPacket-5
[消费者检测到终止哨兵] 安全退出消费循环
[主进程] 生产者与消费者均已正常停止
五、必背代码 4:资源同步互斥:multiprocessing.Lock 互斥锁
当多个子进程需要同时向同一个本地文件写入日志,或者向终端标准输出打印内容时,由于操作系统按时间片调度,输出流会被交织截断,导致日志内容字符错乱崩溃。使用 multiprocessing.Lock 能够确保同一时刻只有一个进程能进入临界区执行写操作。
标准进程锁源码模板
import multiprocessing
import time
import os

def safe_writer(lock, filename, worker_id):
    """通过互斥锁排队写入共享文件与终端"""
    # 使用 with 语法自动完成 lock.acquire() 与 lock.release()
    with lock:
        print(f"[进程 {worker_id}] 已获取排他锁,开始写入临界区 (PID: {os.getpid()})")
        with open(filename, "a", encoding="utf-8") as f:
            f.write(f"日志条目来自 Worker-{worker_id}, 记录时间戳: {time.time()}\n")
        time.sleep(0.2)  # 模拟 IO 操作
        print(f"[进程 {worker_id}] 写入完成,自动释放锁")

if __name__ == '__main__':
    target_file = "process_safe_log.txt"
    # 初始化文件内容
    with open(target_file, "w", encoding="utf-8") as f:
        f.write("=== 多进程安全写入测试开始 ===\n")

    # 创建跨进程锁
    file_lock = multiprocessing.Lock()

    workers = []
    for i in range(4):
        p = multiprocessing.Process(target=safe_writer, args=(file_lock, target_file, i + 1))
        workers.append(p)
        p.start()

    for p in workers:
        p.join()

    print("[主进程] 所有进程已严格按序写完文件,内容完整未乱序")
六、核心避坑清单与架构选型总结
掌握了核心源码后,在实际工程交付中还需时刻谨记以下四条红线原则:
- 对象序列化限制(Pickleable):子进程的
target函数及其所有入参对象都会在底层被pickle.dumps()序列化后通过管道传输给子进程。因此,lambda匿名函数、生成器、嵌套函数、数据库连接句柄或打开的 socket 对象绝不能作为入参传递,否则会抛出PicklingError。 - 避免把
multiprocessing.Queue传给Pool:标准进程池由多个工作进程共用一个内部管道,直接把multiprocessing.Queue()作为参数传给Pool.map会引发崩溃;如果进程池内部需要通信,必须使用multiprocessing.Manager().Queue()。 - 子进程异常捕获:子进程内部未捕获的异常会导致该进程退出。在
Pool.apply_async模式下,如果不调用res.get(),子进程中发生的异常会被默默吃掉,主进程察觉不到错误。 - 合理控制进程池数量:进程数量不是越多越好。CPU 密集型任务的进程数量一般推荐设置为
CPU核心数至CPU核心数 + 1。盲目创建超过物理核数几倍的进程只会导致操作系统把大量算力浪费在虚拟内存分页与内核上下文切换中。
multiprocessing 关键组件对比速查表
| 组件 / API | 适用场景 | 核心优势 | 关键注意事项 |
|---|---|---|---|
multiprocessing.Process |
少量长生命周期的独立后台守护任务 | 直接控制进程生命周期、PID 及属性 | 必须显式调用 join() 防止孤儿与僵尸进程 |
multiprocessing.Pool |
大规模批量数据的并行映射计算 | 自动复用工作进程,内置多任务调度负载均衡 | 建议设置 maxtasksperchild;记得 close 与 join |
multiprocessing.Queue |
生产者-消费者解耦模型、流式管道传递 | 跨进程安全缓冲,底层管道自处理序列化 | 建议设 maxsize 限流;不可直接传给 Pool |
multiprocessing.Lock |
共享文件写入、控制台排队打印 | 保障临界资源原子性,防止内容交织乱序 | 优先配合 with 语句使用,防死锁 |
multiprocessing.Value / Array |
极少量的轻量共享状态与基础数值标记 | 基于共享内存,读写效率高于管道通信 | 需配合 Lock 进行并发读写保护 |
总结而言,Python 编写多进程的核心思想在于尊重内存隔离并善用进程池。把任务抽象为无内部副作用的纯函数,借助入口守护和队列管道,就能在任何多核环境中写出安全、高效、稳定的多进程高性能程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









