

Python怎么按多个条件对列表进行多级排序
详细讲解Python中如何按多个条件对列表进行多级排序。涵盖元组比较机制、key参数配合lambda表达式、operator模块提速、数值正负反转实现升降混排,以及基于Timsort稳定性的多轮次排序方案与实际踩坑指南。
list.sort() 或内置函数 sorted() 传入 key 参数,让 key 返回一个包含所有排序条件的元组(Tuple)。当不同条件需要混合“升序”与“降序”时,可通过对数值字段取负值,或利用 Python 内部 Timsort 算法的“排序稳定性”由次要条件向主要条件进行多轮连续排序来实现。
一、核心机制:元组比较与 key 参数
很多开发者初学多级排序时,容易误以为需要手写嵌套的判断逻辑或自定义冒泡循环。实际上,Python 的内置排序机制本身就具备极佳的多条件支持能力,其底座正是“元组(Tuple)字典序比较规则”。
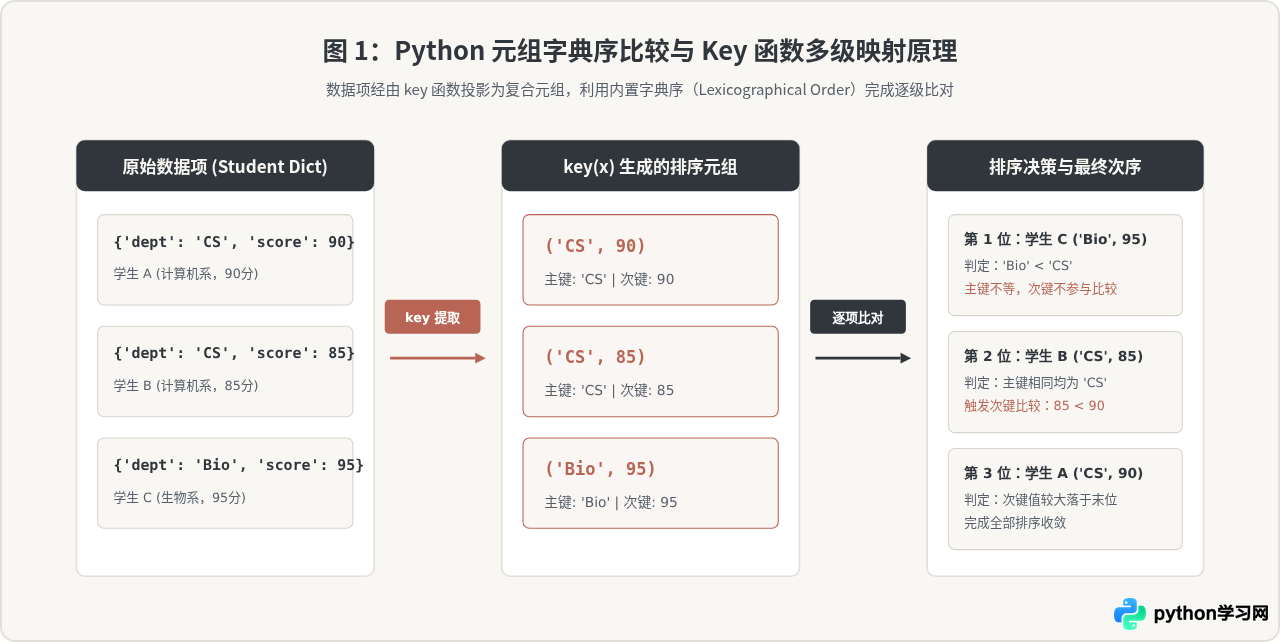
在 Python 中,当两个元组比较大小时,解释器会从第 0 个索引项开始对比;如果第一项已分出大小,比较即告结束;只有当第一项相等时,才会继续比对第二项,依次类推:
# Python 元组比较规则演示
print((1, 5) < (2, 1))    # 输出 True,因为 1 < 2,无需看第二项
print((2, 3) < (2, 8))    # 输出 True,第一项相同,比对第二项 3 < 8
print((2, 5) == (2, 5))   # 输出 True,所有对应项完全相等
无论是 list.sort()(就地修改原列表)还是 sorted()(返回全新列表),都接受一个名为 key 的关键字参数。key 接收一个单参数函数,每次从列表中取出一个元素计算出排序比对的基准值。只要我们让 key 函数返回一个元组,Python 就会自动运用上述元组比较逻辑,实现无缝的多级优先排序。
二、标准实战场景:全升序与全降序
当所有排序条件的方向一致时(全部要求升序,或者全部要求降序),编写代码最为简洁直接。
1. 字典列表的多级排序
假设有一批员工信息列表,要求首先按部门(department)升序排列;如果部门相同,再按年龄(age)升序排列:
employees = [
    {"name": "张伟", "department": "研发", "age": 29},
    {"name": "李强", "department": "运营", "age": 25},
    {"name": "王芳", "department": "研发", "age": 24},
    {"name": "赵敏", "department": "运营", "age": 31},
    {"name": "刘洋", "department": "人事", "age": 28}
]

# 按部门升序,再按年龄升序
sorted_employees = sorted(
    employees,
    key=lambda emp: (emp["department"], emp["age"])
)

# 打印示例
for item in sorted_employees:
    print(f"{item['department']} - {item['age']} 岁 - {item['name']}")
执行输出示例:
人事 - 28 岁 - 刘洋
研发 - 24 岁 - 王芳
研发 - 29 岁 - 张伟
运营 - 25 岁 - 李强
运营 - 31 岁 - 赵敏
2. 对象列表与 operator 模块性能加速
如果列表内装的是自定义对象或者命名元组,可以使用 operator.attrgetter;如果是字典,可以使用 operator.itemgetter。标准库模块 operator 内部由 C 语言底层实现,相比 Python 层面的 lambda 表达式,在处理数万条以上的大数据量列表时具有 15%~30% 的性能提升,同时可读性也更好。
from operator import itemgetter

# 使用 itemgetter 一次提取多个字典字段
sorted_by_getter = sorted(employees, key=itemgetter("department", "age"))

# 若元素是自定义对象,例如 class Student
from operator import attrgetter
# sorted_students = sorted(student_list, key=attrgetter("grade", "score"))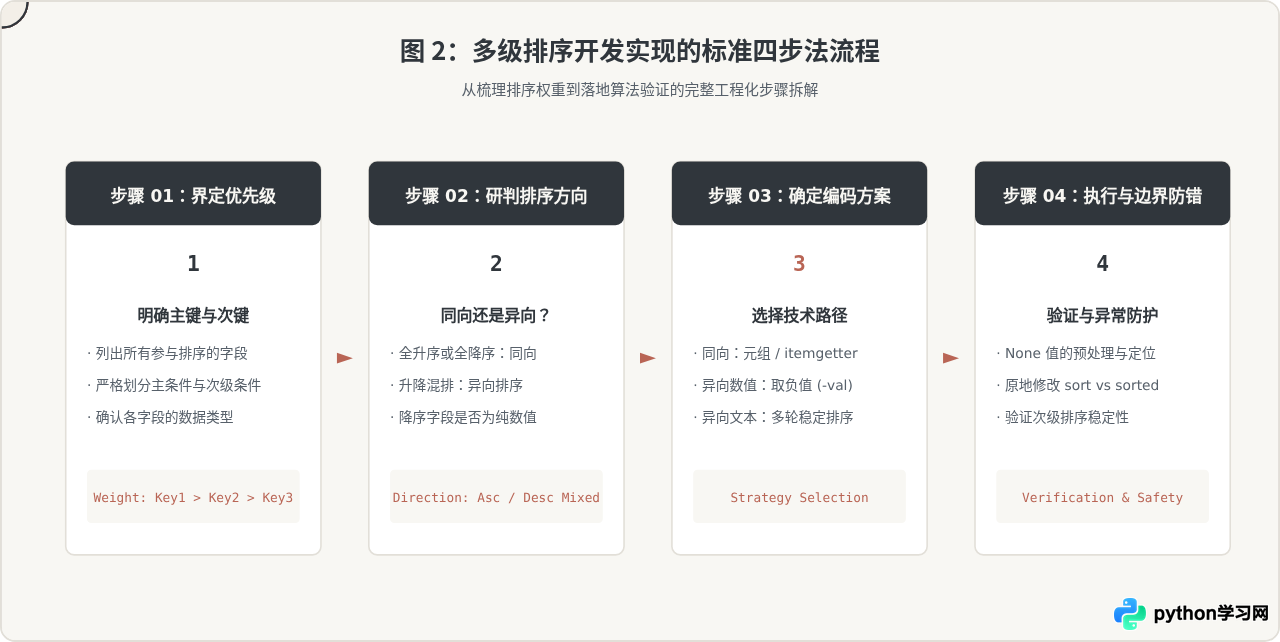
三、核心难点:升序与降序混合排序(异向排序)
现实开发中最普遍的难点是:不同字段要求不同方向。比如“部门升序,分数降序”;或者“优先级降序,创建时间升序”。
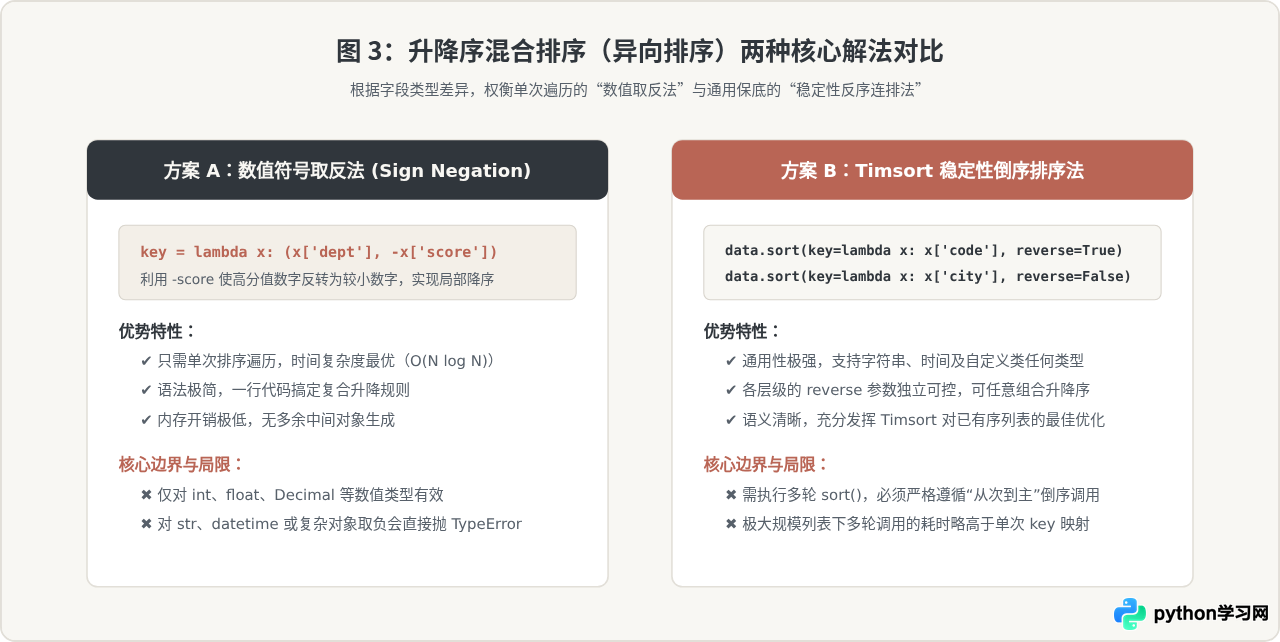
sorted() 和 list.sort() 只有一个全局的 reverse 参数。如果设置 reverse=True,所有字段都会同时反转为降序,无法直接控制“单个字段升序、另一个字段降序”。解决这一问题主要有两种核心方案:
解法一:数值取负法(适用字段为数字类型)
如果需要降序的字段是整数(int)或浮点数(float),最灵巧的数学技巧是对其取负值(-val)。在升序序列中,数值越大的数在取负后反而越小,因而会排在前面,从而完美实现了该字段的“局部降序”:
students = [
    {"name": "小明", "grade": 3, "score": 88},
    {"name": "小红", "grade": 2, "score": 95},
    {"name": "小华", "grade": 3, "score": 96},
    {"name": "小强", "grade": 2, "score": 88},
    {"name": "小丽", "grade": 3, "score": 96}
]

# 业务需求:年级 (grade) 升序,年级相同时成绩 (score) 降序
# 做法:grade 正常放,score 取相反数 -x['score']
sorted_students = sorted(
    students,
    key=lambda x: (x["grade"], -x["score"])
)

for s in sorted_students:
    print(f"年级: {s['grade']} | 成绩: {s['score']} | 姓名: {s['name']}")
执行输出示例:
年级: 2 | 成绩: 95 | 姓名: 小红
年级: 2 | 成绩: 88 | 姓名: 小强
年级: 3 | 成绩: 96 | 姓名: 小华
年级: 3 | 成绩: 96 | 姓名: 小丽
年级: 3 | 成绩: 88 | 姓名: 小明注意:小华和小丽同为 3 年级、96 分,他们在原列表中的先后顺序被完整保留了。这是 Python 排序非常重要的“稳定性”特性。
解法二:利用 Timsort 稳定性的多轮次反向排序法(通用解法)
如果需要降序的字段是字符串(例如按分类升序,再按编码降序),或者是一个无法直接取负的自定义复杂对象,取负法就会报错:TypeError: bad operand type for unary -: 'str'。
此时最正统、最稳妥的解决方案是利用 Python 内置排序算法 Timsort 的稳定性(Stable Sort):
- 什么是稳定排序? 如果两个元素的排序键相等,排序后它们原有的相对顺序保持 100% 不变。
- 操作口诀: 先按次要条件排,再按主要条件排(从最次级优先一直倒推到第一优先级)。
data = [
    {"city": "北京", "code": "B02"},
    {"city": "上海", "code": "A01"},
    {"city": "北京", "code": "B09"},
    {"city": "上海", "code": "A08"},
    {"city": "北京", "code": "B01"}
]

# 需求:城市 (city) 升序;城市相同时,代码 (code) 降序(code 为字符串无法取负)

# 步骤 1:先对次要条件进行排序(code 降序)
data.sort(key=lambda x: x["code"], reverse=True)

# 步骤 2:再对主要条件进行排序(city 升序)
data.sort(key=lambda x: x["city"], reverse=False)

for item in data:
    print(f"{item['city']} - {item['code']}")
执行输出示例:
上海 - A08
上海 - A01
北京 - B09
北京 - B02
北京 - B01
在步骤 2 中,由于 Timsort 算法是绝对稳定的,当面对同样是“北京”的三个元素时,算法绝不会改变它们在步骤 1 中已经排好的“B09 > B02 > B01”的相对次序。因此,两轮单条件排序后,完全达成了多条件异向排序的目标。
四、高级进阶:复杂规则与 functools.cmp_to_key
在极少数情况下,排序需求极其复杂,无法单纯拆解为简单的属性提取。例如:两个元素之间的大小关系取决于相互拼接后的字典序,或者某些特定值必须强制置顶,其余项按常规排序。
在 Python 2 时代,sort() 函数原生支持 cmp 比对函数;Python 3 移除了 cmp,但在 functools 模块中提供了 cmp_to_key 转换工具。它可以把一个旧式的“双元素比较函数”包装成标准的 key 对象:
from functools import cmp_to_key

# 定义传统比较函数:a < b 返回负数;a == b 返回 0;a > b 返回正数
def custom_compare(a, b):
    # 规则 1:状态为 'active' 的必须永远排在 'inactive' 前面
    if a["status"] != b["status"]:
        return -1 if a["status"] == "active" else 1

    # 规则 2:状态相同时,按得分降序
    if a["score"] != b["score"]:
        return -1 if a["score"] > b["score"] else 1

    # 规则 3:得分相同时,按姓名拼音升序
    if a["name"] < b["name"]:
        return -1
    elif a["name"] > b["name"]:
        return 1
    return 0

records = [
    {"name": "Alice", "status": "inactive", "score": 90},
    {"name": "Bob", "status": "active", "score": 80},
    {"name": "Charlie", "status": "active", "score": 90}
]

# 通过 cmp_to_key 接入
records.sort(key=cmp_to_key(custom_compare))工程建议:cmp_to_key 会显著增加函数调用栈开销,性能比原生 key 慢 3 到 5 倍。只要能够将逻辑构造成元组(例如让 active 状态映射为 0,inactive 映射为 1),就应当优先使用元组 key。
五、常见陷阱与避坑注意事项
-
None 值的比较陷阱: 在 Python 3 中,
None与整数或字符串直接比对会直接抛出TypeError: '<' not supported between instances of 'NoneType' and 'int'。如果排序字段可能存在None,必须在 lambda 中使用占位或条件表达式显式赋默认值(如float('inf')或float('-inf'))来指定None排在开头还是末尾。# 将 None 强制排在数字最后面 sorted(lst, key=lambda x: (x['score'] is None, x['score'])) -
混淆
list.sort()与sorted():list.sort()是列表专有方法,直接修改原列表并返回None;新手常写出res = my_list.sort()导致变量变成None。而sorted()返回全新的排好序列表,原数据保持不变。 - 不要在 key 函数内编写高耗时计算: 排序算法内部对 key 的计算虽然有缓存机制(每个元素在排序前只计算一次 key),但如果列表有数万条记录,key 内包含正则匹配、文件读写或复杂对象序列化依然会导致严重的性能瓶颈。
总结
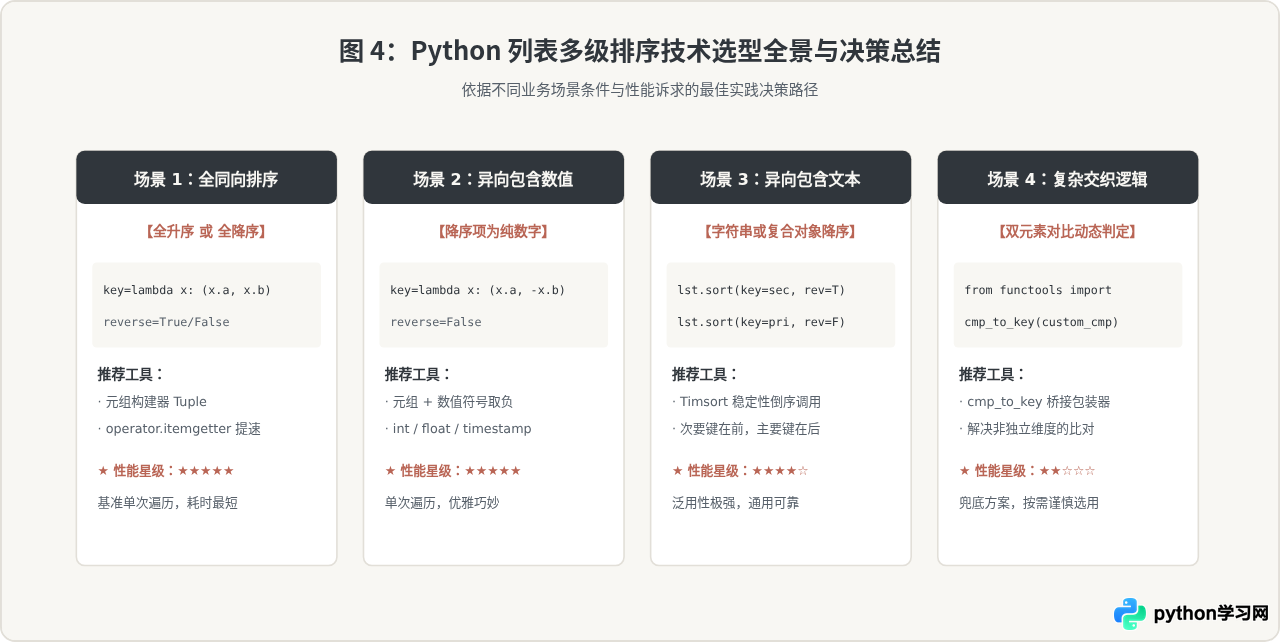
掌握 Python 多级排序的核心在于理解“元组比对”与“排序稳定性”:
- 遇到同向排序,直接通过
key=lambda x: (条件1, 条件2, ...)即可完成。 - 遇到异向排序且降序字段为数值,直接在对应字段前添加负号
-。 - 遇到异向排序且包含不可取负的文本或对象,依照“从次级条件到主条件”的倒序规则多次调用
sort()。 - 遇到极端自定义场景,再考虑
functools.cmp_to_key。
根据具体业务的数据类型和规模选择匹配的实现方案,既能保证代码的清晰易读,也能获得最优的运行效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









