

Python主要应用领域解析:Web开发、数据分析与人工智能场景概览
发布时间:2026-11-17| 3人浏览过
深入解析Python的三大核心应用领域:Web后端开发、数据分析与人工智能。系统梳理各领域主流技术栈、典型架构流程、实战代码示例及选型决策标准。
Python语言经过数十年的生态积累,其成熟工程落地场景集中在三大核心领域:Web后端服务开发、数据分析与自动化处理、以及人工智能与机器学习建模。本文直接剖析这三大领域的技术栈构成、工程架构分工、实战执行流程与典型代码示例,帮助读者建立清晰的选型判断标准与技术全景认知。
一、Web后端开发:分层架构与三大框架选型
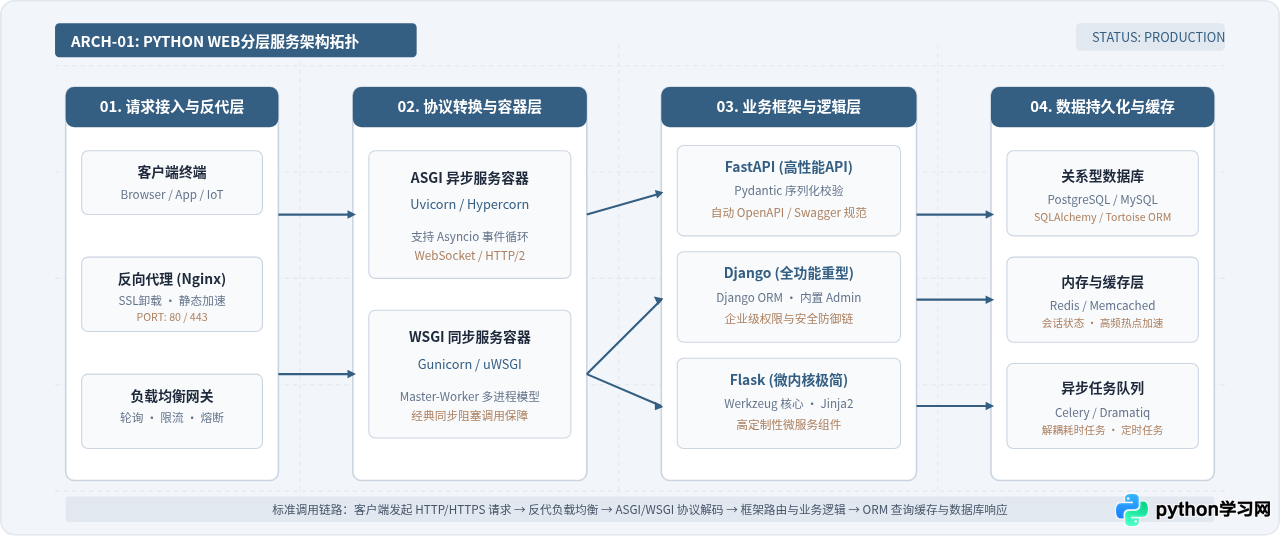
在Web开发体系中,Python主要扮演服务端业务调度、API接口构建与数据持久化管理的角色。得益于丰富的网络协议支持和高度成熟的ORM(对象关系映射)库,开发者能够以较低的编码开销完成高可靠的后端业务系统。
1. 主流Web框架的定位与选择依据
- Django(全功能型架构):遵循“开箱即用”设计哲学,自带完备的身份认证系统、ORM、内容管理后台(Admin)与安全防护机制(CSRF、XSS、SQL注入防护)。适用于业务流程复杂、数据表结构规范、交付周期紧凑的企业中后台系统与内容发布平台。
- FastAPI(现代异步微服务):基于标准Python类型提示(Type Hints)与ASGI异步网关构建,原生集成Pydantic数据校验与OpenAPI自动文档生成。其单节点并发吞吐量与开发体验均表现出众,是微服务接口、前后端分离API以及机器学习模型在线推理服务的优选。
- Flask(微内核轻量型):仅保留路由映射与请求/响应封装核心,其余组件(如数据库迁移、表单验证)均通过插件机制按需引入。适合小型工具、原型验证或对架构具有特定定制诉求的轻量服务。
2. FastAPI 异步微服务典型代码示例
以下为一个可直接执行的 FastAPI 接口示例。演示了定义强类型数据请求模型、参数合法性约束、以及异步处理端点:
# 环境准备:pip install fastapi uvicorn pydantic
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="DeviceManagementAPI", version="1.0.0")

# 定义请求数据结构与字段校验规则
class DeviceCreateRequest(BaseModel):
    device_name: str = Field(..., min_length=2, max_length=50, description="设备唯一识别标识")
    ip_address: str = Field(..., pattern=r"^(?:[0-9]{1,3}\.){3}[0-9]{1,3}$", description="合法IPv4地址")
    port: int = Field(default=8080, ge=1, le=65535, description="通信端口")
    is_active: bool = Field(default=True, description="启用状态")

# 模拟内存数据存储
DEVICE_DATABASE = {}

@app.post("/api/v1/devices", status_code=status.HTTP_201_CREATED)
async def register_device(device: DeviceCreateRequest):
    if device.device_name in DEVICE_DATABASE:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail=f"设备 '{device.device_name}' 已存在,不可重复注册"
        )

    # 异步处理入库与结果组装
    record = device.model_dump()
    DEVICE_DATABASE[device.device_name] = record
    return {"code": 0, "message": "注册成功", "data": record}

@app.get("/api/v1/devices/{device_name}")
async def get_device(device_name: str):
    record = DEVICE_DATABASE.get(device_name)
    if not record:
        raise HTTPException(status_code=status.HTTP_404_NOT_FOUND, detail="目标设备未找到")
    return {"code": 0, "data": record}
二、数据分析与自动化处理:标准流水线与工序
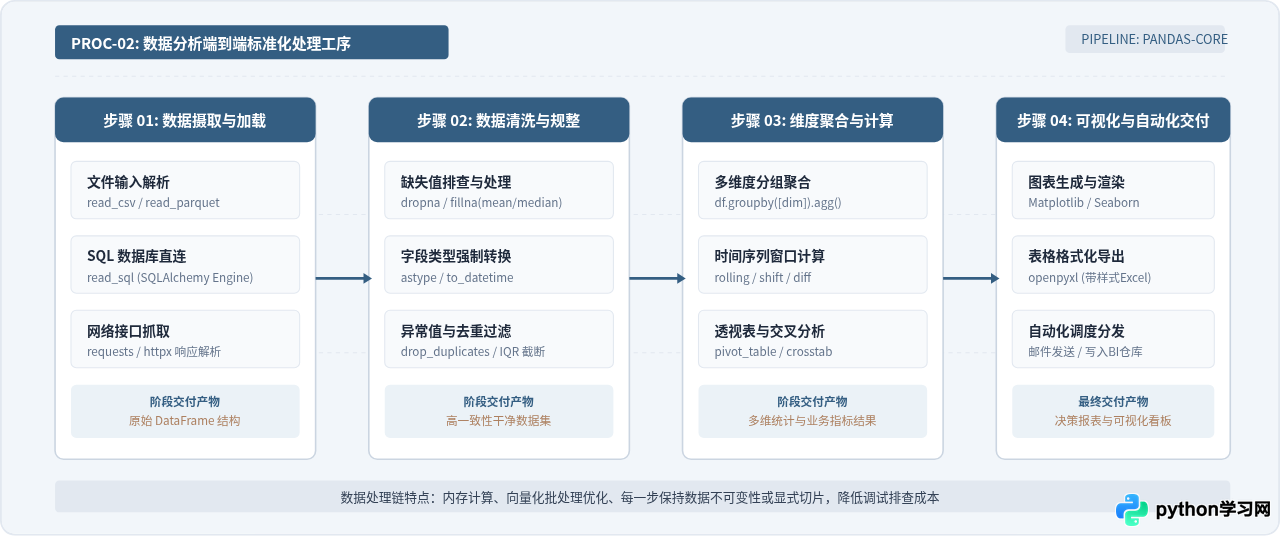
数据分析是 Python 占据统治地位的另一大核心应用。其核心优势在于提供了一整套从底层连续内存数组计算(NumPy)到高阶表格结构操作(Pandas),再到可视化图表呈现(Matplotlib/Seaborn)的闭环工具链。
1. 核心分析工序的分解与定位
- 数据加载与输入规范化:读取多种数据源(CSV、Parquet、SQL数据库、REST API),统一映射为二维表格结构 DataFrame。
- 数据清洗与规整:排查缺失值(NaN)、修正异常值、对离散类型统一编码,确保后续运算不会因脏数据产生异常。
- 特征工程与统计聚合:基于业务维度进行
groupby、透视表pivot_table计算,推导环比、占比与累加等指标。 - 结果输出与自动化集成:将清洗并汇总后的指标导出为业务报表、静态报告或直接推送到下游数据库。
2. Pandas 数据清洗与聚合计算实战代码
以下示例展示如何利用 Pandas 处理一份含有缺失值与字符串格式日期的业务数据,完成清洗、指标聚合与衍生率计算:
# 环境准备:pip install pandas numpy
import pandas as pd
import numpy as np

# 1. 模拟原始数据输入(包含缺失值与类型异常)
raw_data = {
    "order_id": ["A001", "A002", "A003", "A004", "A005"],
    "region": ["华东", "华北", "华东", "华南", "华北"],
    "amount": ["1250.5", np.nan, "890.0", "2100.0", "1450.0"],
    "discount": [0.1, 0.05, 0.2, np.nan, 0.15],
    "order_date": ["2026-03-01", "2026-03-02", "2026-03-02", "2026-03-03", "2026-03-04"]
}

df = pd.DataFrame(raw_data)

# 2. 数据清洗:类型转换与缺失值修复
df["amount"] = pd.to_numeric(df["amount"], errors="coerce")
df["discount"] = df["discount"].fillna(0.0) # 折扣缺失按0处理
df["amount"] = df["amount"].fillna(df["amount"].median()) # 金额缺失按中位数插补
df["order_date"] = pd.to_datetime(df["order_date"])

# 3. 衍生特征计算:实际成交金额
df["final_amount"] = df["amount"] * (1.0 - df["discount"])

# 4. 多维统计与聚合汇总
summary = df.groupby("region").agg(
    order_count=("order_id", "count"),
    total_sales=("final_amount", "sum"),
    avg_sales=("final_amount", "mean")
).reset_index()

# 5. 输出格式化结果(示例输出)
print(summary)
# 输出结果示例:
#   region  order_count  total_sales  avg_sales
# 0   华东            2      1837.45     918.72
# 1   华北            2      2610.00    1305.00
# 2   华南            1      2100.00    2100.00
三、人工智能与机器学习:算法工程与模型闭环
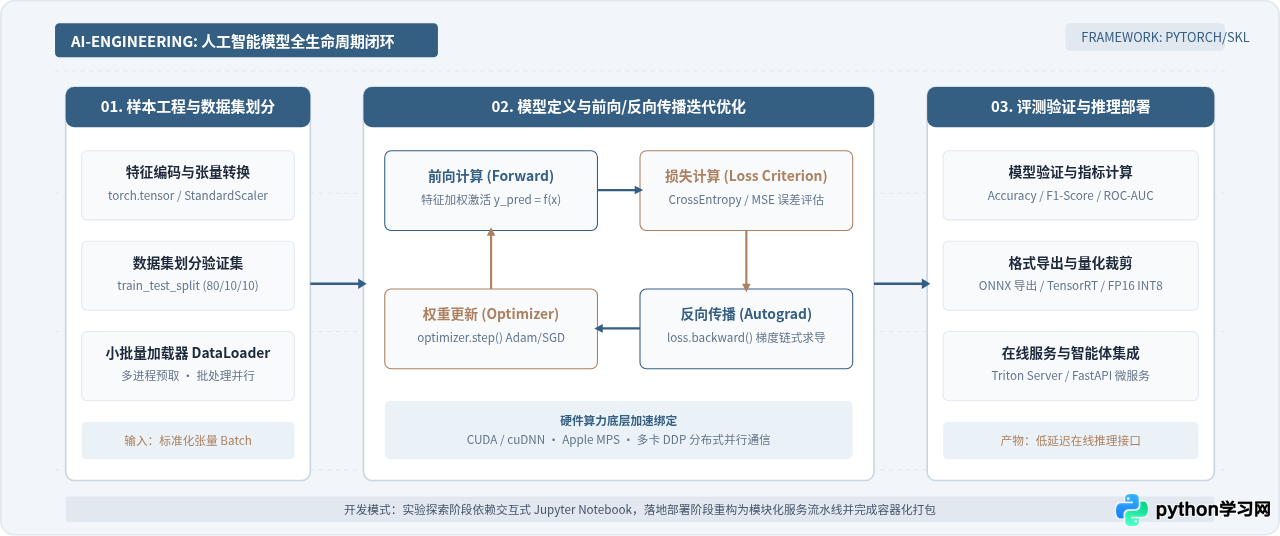
Python 在人工智能领域建立起绝对的先发优势与生态壁垒。其底层核心库普遍采用 C/C++ 与 CUDA 进行算子加速,而暴露在 Python 层的则是高度声明化、面向对象的编程接口。这种“上层表达高效、底层算力极致”的双层架构,使 Python 成为算法研究与工业化落地的通用语言。
1. 典型应用场景分层
- 经典统计学习(Scikit-learn):专注于表格特征预测、客户流失预测、信用评分与异常检测,算法涵盖随机森林(Random Forest)、梯度提升树(GBDT/XGBoost)及支持向量机(SVM)。
- 深度学习与多模态(PyTorch / TensorFlow):以张量(Tensor)为核心计算单元,支持自动微分机制(Autograd)。覆盖计算机视觉(目标检测、图像分割)、自然语言处理与语音合成。
- 大语言模型与应用集成(Transformers / LangChain):通过标准模型权重加载、向量数据库检索增强(RAG)与智能体(Agent)工作流编排,实现私有知识库问答与业务流程自动化。
2. Scikit-learn 预测模型流水线实战代码
以下示例构建了一个结构完备的机器学习分类流水线,包含特征标准化、随机森林模型装配、超参数评估与模型预测:
# 环境准备:pip install scikit-learn numpy
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.ensemble import RandomForestClassifier
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report, accuracy_score

# 1. 构建演示业务特征数据集(1000个样本,10个特征维度)
X, y = make_classification(
    n_samples=1000,
    n_features=10,
    n_informative=6,
    n_classes=2,
    random_state=42
)

# 2. 划分训练集与测试集(严格防范数据泄露)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3. 组装标准化与模型管道(Pipeline 保证预处理一致性)
model_pipeline = Pipeline([
    ("scaler", StandardScaler()),
    ("classifier", RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42))
])

# 4. 训练模型并执行预测
model_pipeline.fit(X_train, y_train)
y_pred = model_pipeline.predict(X_test)

# 5. 校验指标输出
acc = accuracy_score(y_test, y_pred)
print(f"测试集准确率 (Accuracy): {acc:.4f}")
print("\n详细评测分类报告:")
print(classification_report(y_test, y_pred, target_names=["类0", "类1"]))
# 示例输出:
# 测试集准确率 (Accuracy): 0.8850
四、三大领域综合对比与技术选型总结
在技术架构设计与项目研发初期,明确业务所属领域的性能特征、生态成熟度以及潜在限制,是规避后期架构重构的关键。以下对三大领域的核心维度进行对比归纳:
| 应用领域 | 主流开发框架与库 | 核心解决问题 | 工程优势 | 主要性能与架构限制 |
|---|---|---|---|---|
| Web后端开发 | FastAPI, Django, Flask, SQLAlchemy, Celery | 业务逻辑流转、RESTful/GraphQL API、企业后台、微服务集成 | 开发迭代速度极快,ORM与安全防御机制成熟,开箱即用组件丰富 | CPython 全局解释器锁(GIL)限制多线程CPU计算,极端高并发需依赖多进程或异步网关 |
| 数据分析与处理 | Pandas, NumPy, SciPy, Matplotlib, Polars | 离线/准实时数据清洗、探索性分析(EDA)、财务报表自动化、指标统计 | 交互式环境(Jupyter)友好,表格结构操作直观,生态兼容性极强 | 单机内存限制(Pandas通常需要原始数据3-5倍内存),TB级海量数据需桥接Spark或DuckDB |
| 人工智能与算法 | PyTorch, TensorFlow, Scikit-learn, HuggingFace | 传统特征建模、图像分类目标检测、自然语言理解、大模型智能体与RAG | 学术界与工业界事实标准,底层C/CUDA算子执行,顶层Python表达极简 | 模型推理部署对显存和算力要求高,超低延迟端侧部署需转换为C++运行时(TensorRT/ONNX) |
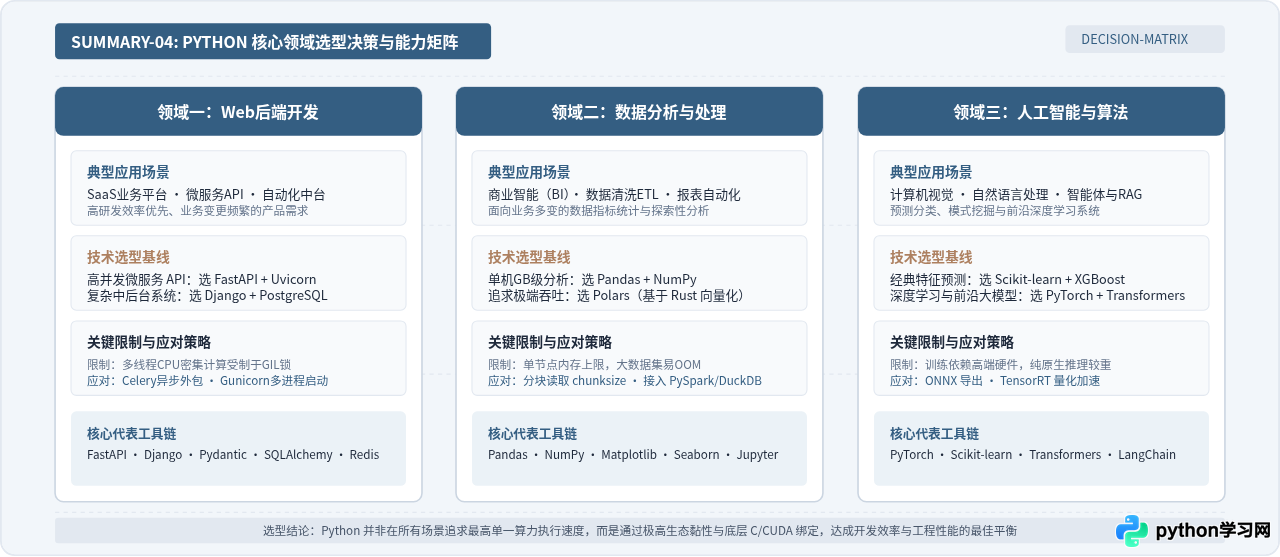
架构边界与注意事项:
当系统面临微秒级超低延迟通信(如高频量化交易撮合引擎)、移动端原生App核心逻辑嵌入、或者操作系统内核级驱动开发时,C++、Rust 或 Go 会是更为合适的主力语言。在这些极端场景下,业界成熟实践通常采用“底层以 C++/Rust 编写高性能内核模块,上层使用 Python 暴露调用接口与进行策略编排”的混合架构。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









