

Python for循环、while循环与列表推导式该怎么选
深入解析Python中for循环、while循环与列表推导式的核心差异、底层运行机制与实际选型边界,提供清晰直接的场景决策树、反模式排查及选型对比速查指南。
一、核心选型决策路径
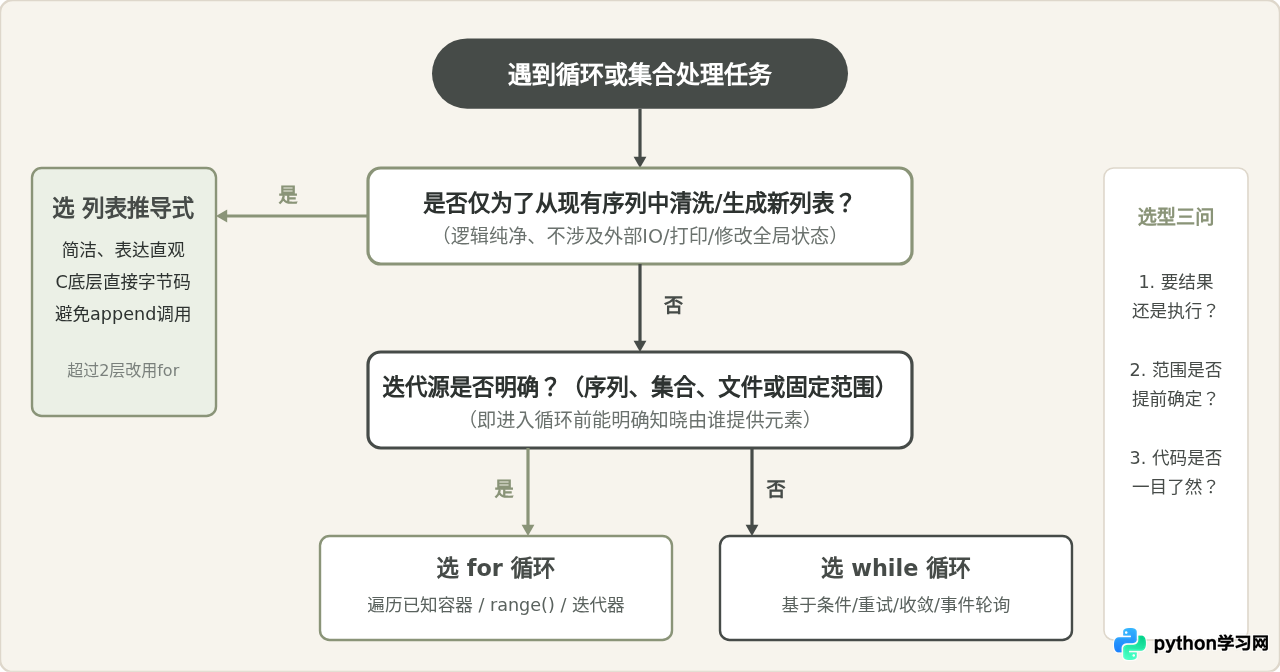
很多初学者在写代码时,容易陷入“哪个熟练就一律用哪个”的习惯。然而,在Python的语法设计中,这三者并非单纯的等价替代品,而是各自对应着不同的数据控制范式。列表推导式偏向声明式数据映射,for循环偏向安全可控的确定性迭代,while循环则是状态驱动的过程控制。
面对具体需求时,你可以按照下面的判断顺序快速得出最佳选择:
二、for 循环:已知边界与序列遍历的标准选择
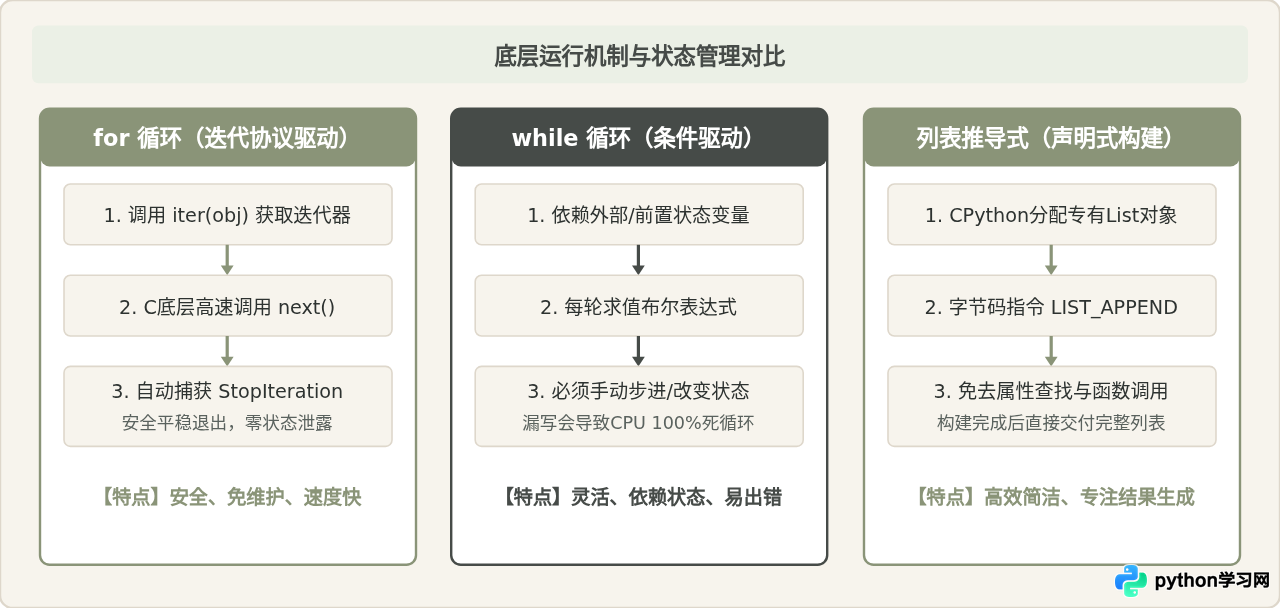
在C语言等传统语言中,循环往往需要手动声明计数器变量(例如 int i = 0),通过索引去访问数组元素。而在Python中,for 循环的本质是迭代器协议(Iterator Protocol)。只要一个对象是可迭代的(实现了 __iter__ 或 __getitem__),for 循环就能直接取出每个元素,无需开发者手动管理索引。
1. 典型适用场景
- 遍历序列或容器:列表、元组、字符串、字典、集合等。
- 执行已知次数的操作:利用
range(n)确定性重复执行。 - 逐行处理文件流:利用生成器按需迭代,避免一次性读入全部内存。
- 带有索引需求的迭代:使用内置的
enumerate(),而不是手动递增变量。
2. 代码示例
# 场景:批量处理用户数据,并带有多步业务操作与记录
users = [{"id": 101, "name": "Alice", "active": True},
         {"id": 102, "name": "Bob", "active": False}]

for index, user in enumerate(users, start=1):
    if not user["active"]:
        print(f"[{index}] 跳过未激活用户: {user['name']}")
        continue
    # 执行多步具体业务
    print(f"[{index}] 正在同步用户数据: {user['name']}")
在遍历列表的同时调用 remove() 或 append() 会导致迭代器内部索引偏移,从而漏掉元素或引发意外死循环。如果需要过滤元素,应使用列表推导式生成新列表,或者在原有列表的浅拷贝(如 for item in list_data[:]:)上进行遍历。
三、while 循环:状态驱动与未知轮次的控制利器
与 for 的“从源头取元素直到耗尽”不同,while 循环是条件驱动型控制结构。只要布尔表达式求值为 True,循环体就会持续运行。因此,凡是循环次数在开始前无法预知、取决于程序内部状态改变或外部系统响应的场景,都是 while 循环的主场。
1. 典型适用场景
- 网络请求或外部操作重试:遇到失败时按次数重试并结合指数退避。
- 算法双指针与收敛计算:如二分查找、快速排序分区、牛顿法数值逼近。
- 事件轮询与消费者队列:持续监听任务队列,直到收到特定终止标记。
- 交互式控制流:要求用户输入合法数据,直到满足条件才放行。
2. 代码示例:指数退避网络重试
import time

max_attempts = 3
attempt = 0
success = False

# 循环轮次由动态业务状态决定,而非已有数据列表
while attempt < max_attempts and not success:
    attempt += 1
    print(f"正在进行第 {attempt} 次连接尝试...")
    try:
        # 模拟外部操作
        if attempt < 3:
            raise ConnectionError("网络波动")
        success = True
        print("连接成功!")
    except ConnectionError:
        if attempt < max_attempts:
            sleep_time = 2 ** attempt
            print(f"连接失败,等待 {sleep_time} 秒后重试...")
            time.sleep(sleep_time)
        else:
            print("已达最大重试次数,终止任务。")
3. 常见说法辨析:while 可以完全替代 for,为什么不统一用 while?
为什么这种说法看似合理:从图灵完备性和底层逻辑看,while 确实更加通用。任何 for item in seq 都可以改写为手动维护索引 i = 0,然后在循环体末尾 i += 1 的 while i < len(seq) 形式。
为什么在Python中需要坚决纠正:
- 心智负担与缺陷风险:使用
while处理序列时,必须手动初始化、判断边界并步进变量。一旦中途遇到continue或分支遗漏更新步进值,就会导致程序陷入死循环或发生IndexError。 - 非序列容器无法按索引访问:集合(set)、字典(dict)以及生成器(generator)没有数字下标。用
while遍历它们必须手动捕获StopIteration,极其繁琐。 - 执行效率更低:
for循环在CPython内部是由底层的迭代器协议驱动的,避免了Python字节码层面的多次变量读写与条件求值,运行速度明显快于手动计数器的while。
四、列表推导式:专注数据转换的声明式利器
列表推导式(List Comprehension)是Python最受推崇的特性之一。它的本质公式是:[目标表达式 for 变量 in 可迭代对象 if 过滤条件]。它将“初始化空列表”、“遍历”、“过滤条件”与“追加数据”四个步骤浓缩为一行清晰的声明。
1. 代码对比:常规for追加 vs 列表推导式
# 任务:提取一批原始数值中大于0的数,并计算它们的平方

raw_scores = [12, -5, 0, 8, -2, 15]

# 方式A:使用标准for循环(命令式步骤)
positive_squares = []
for score in raw_scores:
    if score > 0:
        positive_squares.append(score ** 2)

# 方式B:使用列表推导式(声明式直述)
positive_squares = [score ** 2 for score in raw_scores if score > 0]
方式B不仅省略了4行模板代码,更重要的是它表达了“我要什么”,而不是一步一步指导计算机“先怎么做、再怎么放”。
2. 为什么推导式通常更快?
在性能测试中,对于相同规模的数据生成任务,列表推导式通常比普通 for + append() 快20%至35%。原因在于:普通循环在每次调用 .append() 时,Python解释器都需要执行一次属性查找(Attribute Lookup),并压栈调用内置函数;而列表推导式在编译期会被转译为专门优化的字节码指令 LIST_APPEND,由C语言底层直接向列表追加元素,免去了Python运行时的函数调用开销。
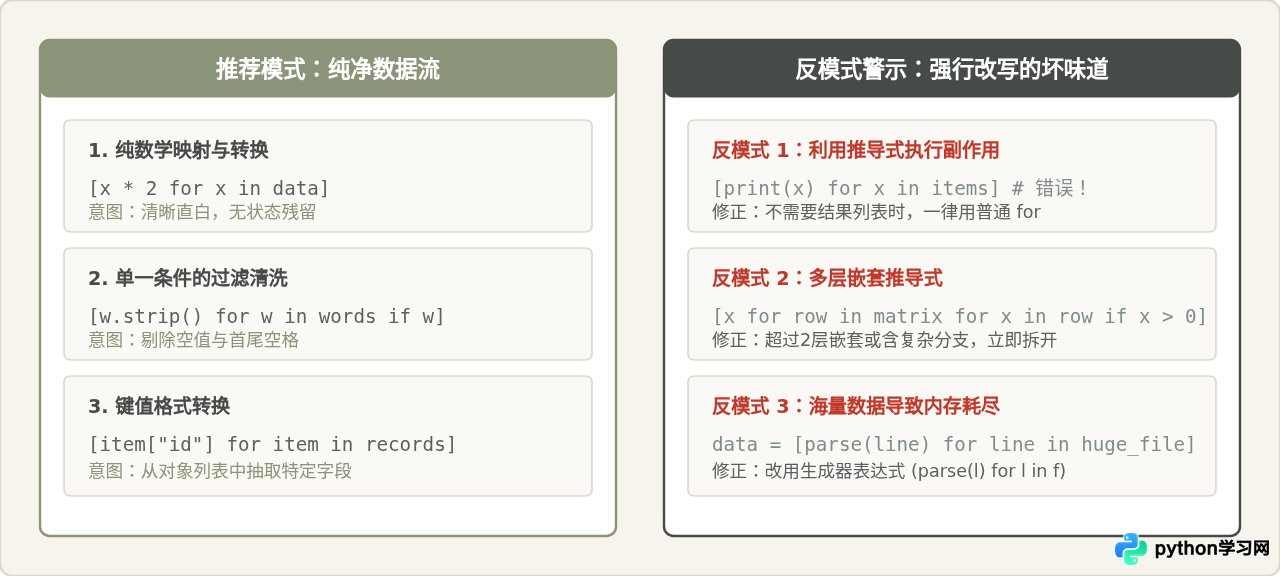
3. 常见误区与反模式辨析
虽然列表推导式速度快且紧凑,但滥用它会严重破坏代码可读性与健壮性。以下三种典型写法应当坚决避免:
五、全维度选型对比与实战对照
为了在实际编码时快速决策,下表总结了三者在语言特性、状态控制及维护成本上的核心指标:
| 选型维度 | for 循环 | while 循环 | 列表推导式 |
|---|---|---|---|
| 核心目标 | 遍历已有集合或序列并执行过程性操作 | 在维持特定布尔状态前持续执行 | 声明式过滤并映射生成新列表 |
| 终止机制 | 迭代器消耗完毕自然停止(安全) | 条件表达式求值变为 False 或遇到 break | 输入序列遍历完毕时自动返回 |
| 状态变量 | 由迭代器管理,无需手动维护 | 需在外部显式声明并手动更新步进 | 仅在内部单次生效,不污染全局 |
| 内存开销 | 可配合生成器实现 O(1) 逐项流动 | 根据内部实现决定,无额外语法级开销 | 在内存中一次性完整分配整个新列表 |
| 可读性边界 | 擅长包含多步分支、异常捕获的长逻辑 | 适合状态转换复杂、退出路径多的场景 | 仅适合单行、无分支或简单过滤的纯函数变换 |
| 经典口诀 | 知道走几步,选 for | 满足条件才走,选 while | 只为得到新列表,选推导式 |
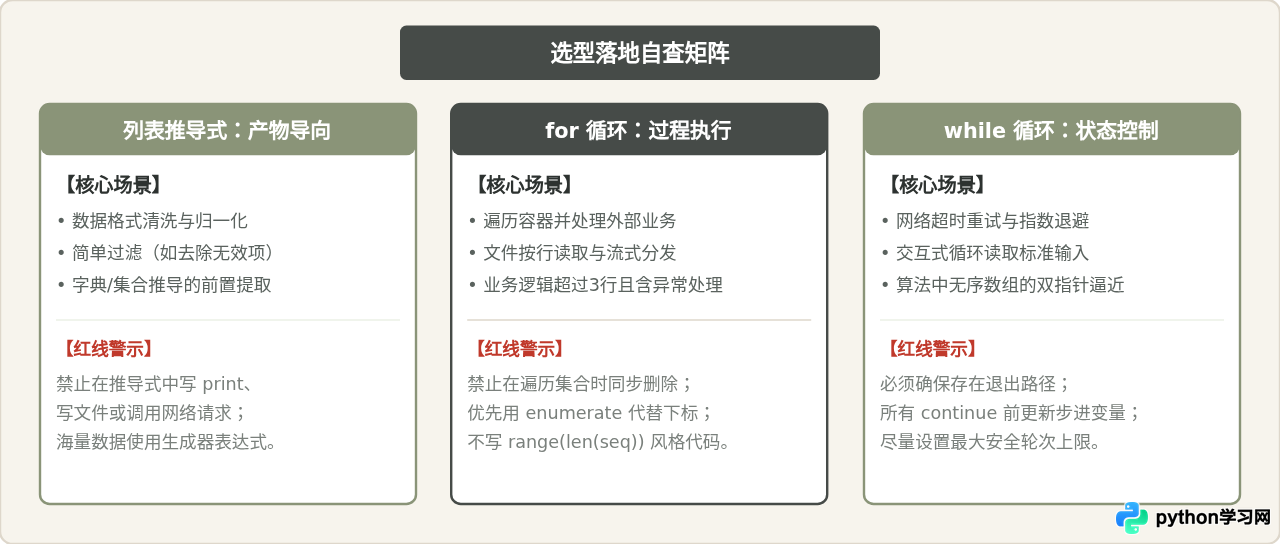
六、日常编码自查清单
在日常编写Python代码时,若在循环结构上产生犹豫,可以对照以下三个问题快速自检:
- 这段代码执行后,我是需要一个新的列表,还是需要发生某些动作?
——如果只是为了拿到过滤转换后的新列表,且逻辑在一两行内能看懂,直接写列表推导式;如果需要打印日志、写入数据库或更新对象,用for。 - 循环次数在开始前,能不能通过某个已有对象确定?
——能确定(如数据行、范围、集合项),必须用for;不能确定(如等待任务就绪、外部状态变更为已完成),用while。 - 推导式写完后,别人读代码能不能在2秒内看懂意图?
——如果推导式包含了双重嵌套、复杂的if-else三元判断,或者长度超过了一屏,请毫不犹豫地拆解为多行for循环。在Python哲学中,可读性永远优先于微小的单行技巧。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









