

只靠菜鸟教程能学会Python吗?内容深度评估与进阶资源补充建议
客观评估仅依靠菜鸟教程学习Python的内容深度与能力边界,剖析初学者常见认知偏差,并提供从语法入门到实际工程落地的系统化进阶资源与补充建议。
一、菜鸟教程的内容深度客观评估:擅长什么与欠缺什么
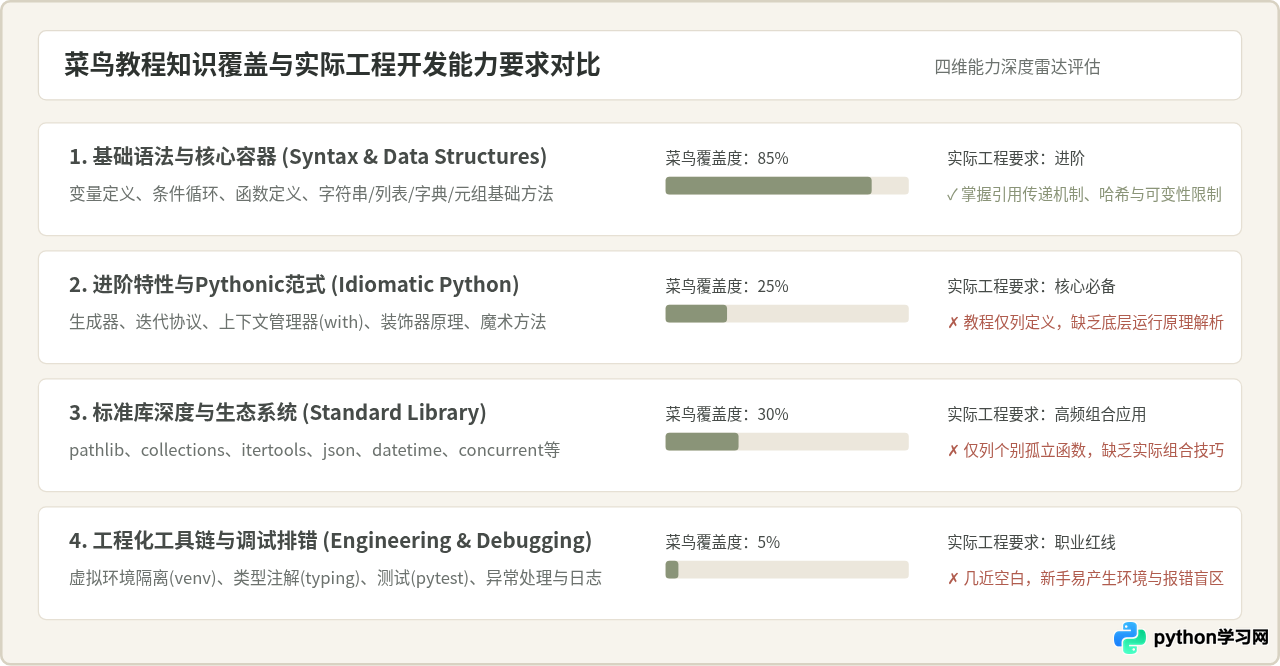
评估一个教程是否足够,首先需要界定“学会”的标准。如果“学会”是指理解 if/else 条件分支、掌握 for/while 循环、调用列表的 append() 方法,或是照着网页示例运行几行计算代码,那么菜鸟教程完全能够胜任。然而,在实际工作、自动化脚本构建或软件开发场景中,开发者面对的是复杂的业务逻辑、不规范的外部输入、依赖冲突与性能瓶颈。在这些维度上,菜鸟教程的内容深度存在明显的边界。
1. 菜鸟教程的突出优势
菜鸟教程之所以被广泛传播,在于其精准契合了零基础用户的“低阻力破冰”需求:
- 入门阻力极小:每个章节篇幅短小,剔除了晦涩的理论推导,直接给出最小可用代码。
- 在线运行直观:提供了即时运行的沙箱组件,初学者无需先配置复杂的本地解释器与环境变量,就能看到运行输出。
- 速查字典属性明确:结构完全依循语法词条组织,在忘记某种字符串切片语法或字典遍历方法时,能以极高效率提供参考。
2. 限制进阶的四大内容断层
然而,如果把这种“知识清单”当成全盘技能树,就会遭遇严重的认知断层:
- 缺乏对象模型与内存语义:教程展示了
a = [1, 2]和b = a,但没有解释变量名本质上是指针标签,初学者在修改b导致a意外改变时常常不知所措。 - 缺乏 Pythonic 编程思想:Python 的核心魅力在于列表推导式、生成器表达式、解包机制与上下文管理。菜鸟教程的代码风格往往保留浓厚的类 C 语言痕迹(例如依赖下标
range(len(items))遍历,而非直接迭代或使用enumerate)。 - 工程化与工具链完全脱节:在真实环境里,代码运行在隔离的虚拟环境(venv)中,受
pip依赖版本制约,需要通过 PEP 8 规范格式化,需要依靠类型注解(Type Hints)提高可读性。这些现代规范在菜鸟教程中极少提及。 - 排错与异常体系虚弱:教程中的异常处理通常仅有一段简短的
try...except Exception: print("error"),这是在工程实践中极其忌讳的“静默吞掉报错”。
二、典型认知偏差辨析:为什么有人误以为“学完菜鸟教程就够了”?
在自学者社群中,常能听到“看完了菜鸟教程 Python 篇,感觉自己全懂了”的声音。这种判断在某种特定边界下是合理的,但在扩展到真实场景时则会迅速失效。
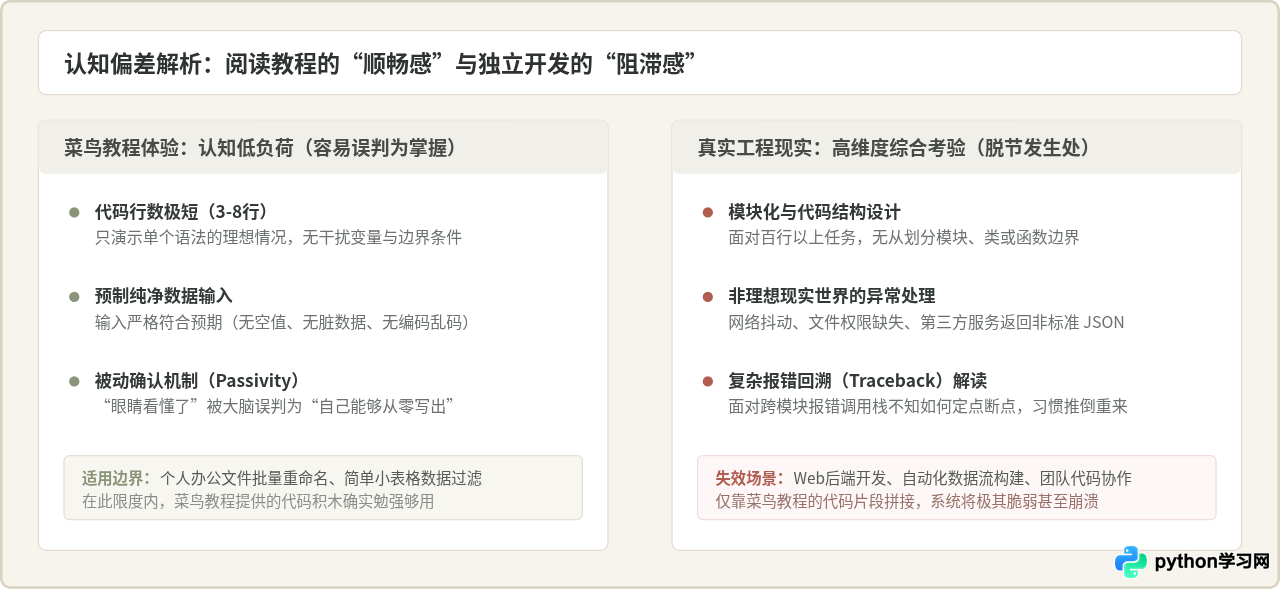
之所以产生“学完即可”的错觉,是因为读者把识别语法的能力(Recognition)当成了构建程序的能力(Construction)。阅读一段已经写好的 for x in my_list: print(x) 并看懂其含义,所调用的认知负荷极低;但当面对“需要从三个分布在不同子目录的文本中提取关键指标,并按照日期逆序去重汇总”的需求时,开发者需要在脑中组织数据流、处理文件路径、设计结构化对象以及防范空指针异常。这是教程单纯罗列条目无法传授的。
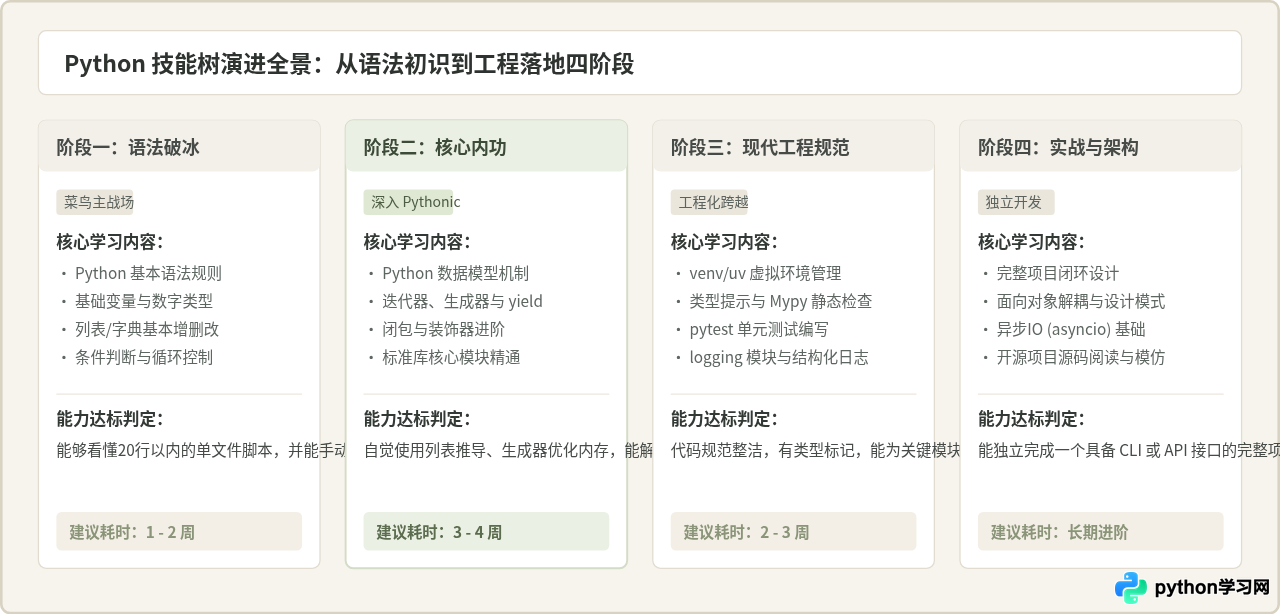
三、从语法入门到实际开发:系统化学习的四个演进阶段
脱离了菜鸟教程的“舒适区”后,应该如何科学建立 Python 能力?合理的成长路径应划分为四个梯度阶段,每个阶段都有明确的交付产物和能力标志。
具体示范:菜鸟风格代码与进阶工程化代码的直观差异
为了具象化理解“深度”究竟差在哪里,我们可以对比同一个业务需求在两种认知阶段下的代码实现。
需求:读取一个包含学生信息的 CSV 文件,筛选出成绩大于等于 80 分的学生,并按成绩降序输出他们的姓名与班级。
初学者在菜鸟教程中学完文件操作与列表后,通常会写出如下代码:
# 菜鸟教程风格初学者代码:脆弱、未解耦、缺乏错误处理
f = open("students.csv", "r")
lines = f.readlines()
f.close()

result = []
for i in range(1, len(lines)):
    parts = lines[i].strip().split(",")
    name = parts[0]
    clazz = parts[1]
    score = int(parts[2])  # 假定格式绝对正确,如果包含空值或非法字符会直接奔溃
    if score >= 80:
        result.append([name, clazz, score])

# 手动冒泡排序或简单排序
for i in range(len(result)):
    for j in range(i + 1, len(result)):
        if result[i][2] < result[j][2]:
            result[i], result[j] = result[j], result[i]

for r in result:
    print(r[0] + " - " + r[1] + ": " + str(r[2]))
而具备现代 Python 基础的进阶代码则是这样的:
# 规范进阶代码:利用标准库、类型提示、上下文管理与生成器机制
import csv
from pathlib import Path
from dataclasses import dataclass
from typing import List, Optional

@dataclass(frozen=True)
class Student:
    name: str
    grade_class: str
    score: float

def parse_score(val: str) -> Optional[float]:
    """安全解析分数,处理异常脏数据"""
    try:
        return float(val.strip())
    except (ValueError, TypeError):
        return None

def load_qualified_students(file_path: Path, min_score: float = 80.0) -> List[Student]:
    """读取指定路径的 CSV 数据,返回合格学生列表"""
    if not file_path.exists():
        raise FileNotFoundError(f"数据文件不存在: {file_path}")

    qualified: List[Student] = []
    with file_path.open(mode="r", encoding="utf-8") as fp:
        reader = csv.DictReader(fp)
        for row in reader:
            score = parse_score(row.get("score", ""))
            if score is not None and score >= min_score:
                qualified.append(
                    Student(
                        name=row.get("name", "").strip(),
                        grade_class=row.get("class", "").strip(),
                        score=score
                    )
                )

    # 利用标准库高阶排序,语义明确且执行高效
    return sorted(qualified, key=lambda s: s.score, reverse=True)

if __name__ == "__main__":
    target = Path("students.csv")
    if target.exists():
        for s in load_qualified_students(target):
print(f"{s.name} ({s.grade_class}): {s.score:.1f}")对比可见,进阶代码并不追求“炫技”,而是引入了资源自动释放(with 上下文)、标准库解析器(csv.DictReader)、结构化数据对象(dataclass)、防御性空值解析(parse_score)以及类型注解(typing)。这正是只靠菜鸟教程无法获得、却在实际工作中不可或缺的工程素质。
四、进阶资源补充建议:构建完整知识矩阵
当在菜鸟教程中完成了基本的关键字语法打卡后,应立即引入经过行业验证的经典资源。不要盲目收集上百 G 的盗版网课,而应构建覆盖“官方标准”、“进阶原理”、“工程实践”的立体矩阵。
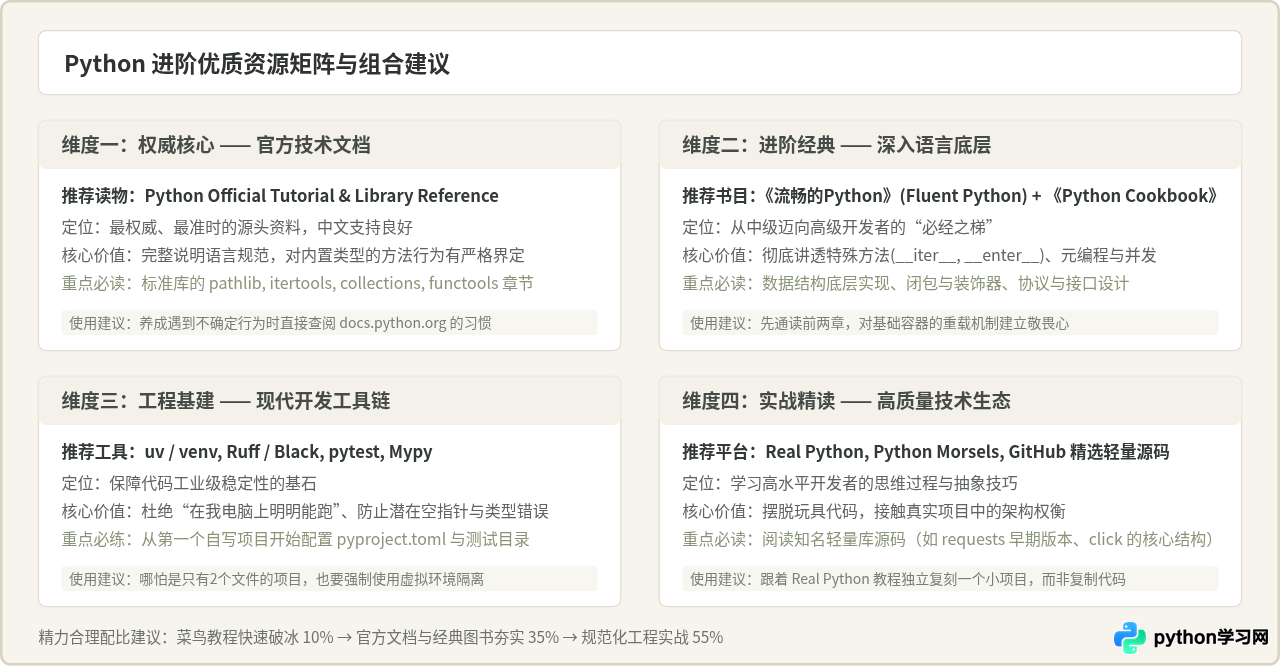
| 学习资源 | 适用学习阶段 | 核心突破重点 | 配合使用建议 |
|---|---|---|---|
| 菜鸟教程 (Runoob) | 第 1 周(语法破冰期) | 快速建立对关键字、缩进、常见数据类型的直观认识 | 当作速查词典使用,看完基础语法后立刻离开,不恋战 |
| Python 官方文档 (docs.python.org) | 全周期必读 | 理解语言设计初衷、标准库详尽规范、官方最佳实践 | 精读内置函数、数据模型章节,常备用于替代搜索引擎粗制回答 |
| 《流畅的Python》(Luciano Ramalho) | 第 3-8 周(进阶提升期) | 彻底掌握特殊方法、闭包、协程、生成器与对象模型 | 每章读完后在本地交互式终端实验代码,理解底层数据流 |
| 《Python Cookbook》(David Beazley) | 第 6 周以上(实战沉淀期) | 学习解决真实编程任务的成熟模式与标准库惯用法 | 按需翻阅具体章节,重点吸收关于文件处理、元编程和算法结构的写法 |
| Real Python (realpython.com) | 持续进阶 | 完整工程案例、现代工具链使用指南、技术专题剖析 | 选读深度长文,重点跟做其中的 CLI 工具、Web 接口、测试等端到端项目 |
五、如何把菜鸟教程变成高效工具而非“认知天花板”?
否定“只靠菜鸟教程能学会”,并不意味着要全盘否定菜鸟教程的实用价值。关键在于明确它的功能定位:把它当成一本“轻量级字典”和“前十天的跳板”,并遵守以下三条落地法则:
在菜鸟教程中浏览完一个知识点后,不要仅点击网页上的“运行”按钮。关闭浏览器标签页,打开本地终端的交互式解释器,从空白文件开始,凭借记忆和理解重新实现该逻辑。如果在无提示状态下能够正确写出,才证明形成了初步记忆。
菜鸟教程给出的示例通常是完全正确、甚至经过高度净化的理想代码。在本地练习时,应刻意进行破坏性测试:传入错误的数据类型、故意造成索引越界、传入无法解析的字符串,仔细观察 Python 输出的报错回溯信息(Traceback)。理解错误是如何抛出的,比记住成功运行的代码重要十倍。
完成阶段一后,停止在网上刷无关痛痒的数学打印题(如九九乘法表、水仙花数)。转向自己身边的真实问题:写一个脚本把下载文件夹中所有的截图按月份归档;编写一个定时向自己发送天气提醒的脚本;解析一份导出的账单数据并统计月度开销。只有当代码必须与真实的文件系统、多变的网络响应和不完美的数据格式交互时,编程能力才会真正扎根。
只靠菜鸟教程学不会 Python,但这并不是教程本身的缺陷,而是速查类轻量文档的天然属性。理清它的边界,借它顺利迈出第一步,随后果断步入更系统、更具深度的工程知识体系,才是掌握这门语言的高效且严谨的路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









