

Python自学避坑指南:初学者常见的5个误区与纠正
详细梳理Python自学过程中初学者最容易踩入的5个典型误区,从学习习惯、语法取舍、异常排查、框架选择到环境隔离,提供针对性的工程级纠偏方法与实操指引。
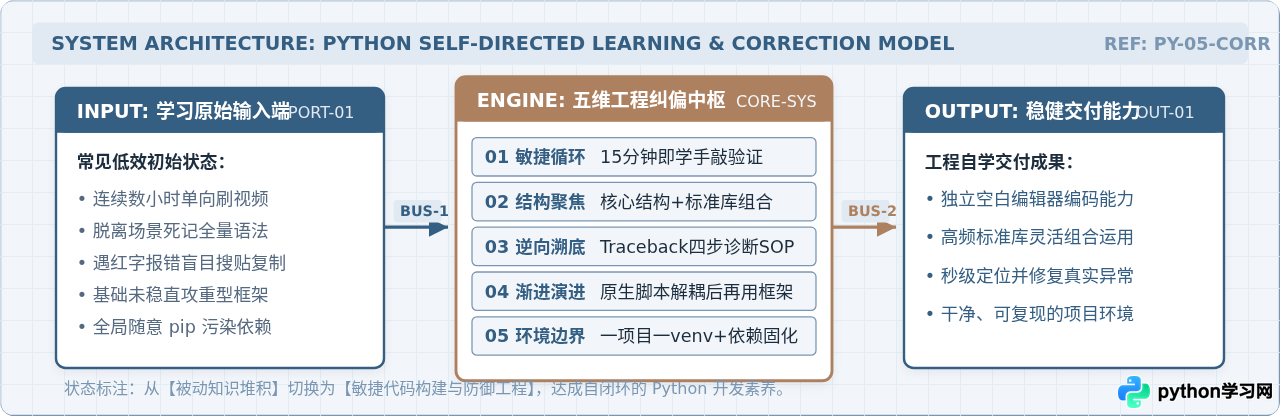
误区一:只看视频动嘴不动手的“教程仓鼠症”
初学者最容易产生的一种错觉是:只要连续看完一套长达数十小时的高清教学视频,脑海中就能自然拥有编程能力。很多人习惯在手机或电脑前连续观看多节讲解,看着讲师流畅地定义变量、编写循环和输出结果,内心觉得逻辑清晰、完全理解。然而,一旦关闭播放器、面对空白的代码编辑器时,往往连最简单的输入接收或列表遍历都无法完整敲出。
这种现象被称为“被动吸收假象”。人脑在看视频时处于相对放松的单向信息接收状态,认知负荷极低;而编写代码属于高认知负荷的逆向逻辑建构。如果中间缺乏双手的物理输入与编译运行反馈,大脑根本无法形成牢固的神经突触连接与语法直觉。
拒绝连续观看视频超过 15 分钟。每接触一个语法点,必须立即暂停视频,切换至终端或代码编辑器中,执行完整的“手敲验证 — 参数篡改 — 边界注入 — 函数封装”闭环。
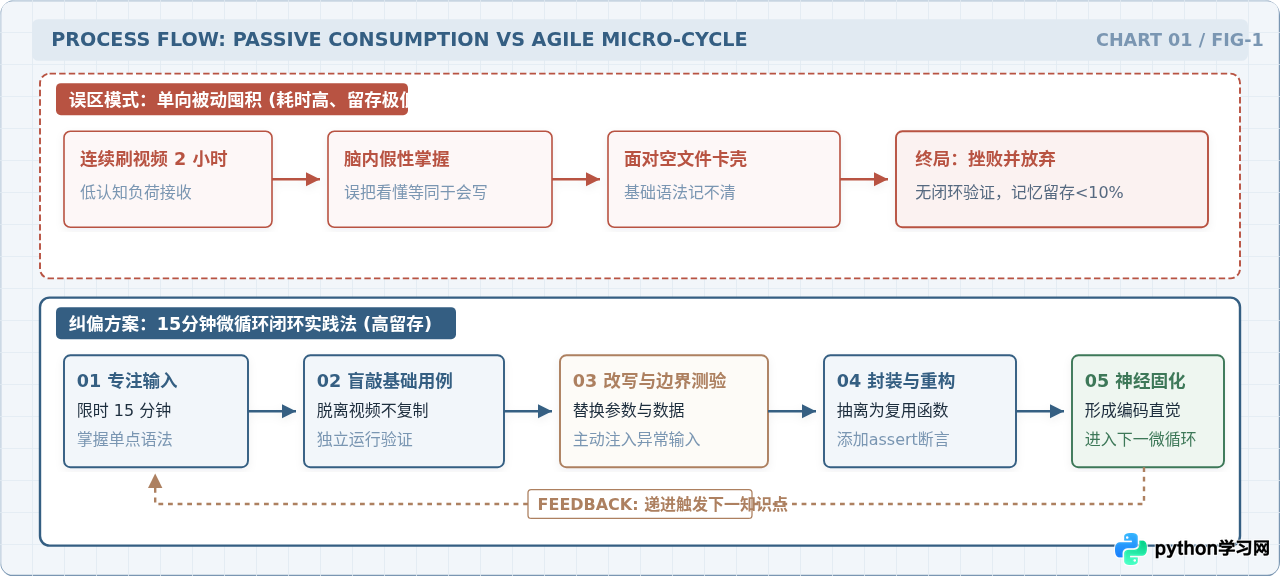
具体操作时,切勿直接从课件或网页中复制代码。即便最基础的代码,也必须由键盘逐字符录入。在基础用例运行成功后,主动对代码进行“破坏性实验”与“业务微调”。
# 示例:从被动抄代码演进为主动封装与边界测试 (micro_loop.py)
def calculate_grade_average(scores: list[float]) -> float:
    """
    计算有效成绩的平均分。
    纠偏练习:不只照抄求和公式,主动加入数据清洗与边界守卫。
    """
    # 边界条件 1:空列表防护
    if not scores:
        return 0.0

    # 边界条件 2:过滤非法数据(例如负数或超出100分的无效项)
    valid_scores = [s for s in scores if 0.0 <= s <= 100.0]
    if not valid_scores:
        return 0.0

    return round(sum(valid_scores) / len(valid_scores), 2)


# 编写断言用例进行自我验证(脱离教程独立验证)
if __name__ == "__main__":
    # 标准场景测试
    assert calculate_grade_average([85.5, 90.0, 78.5]) == 84.67
    # 边界测试:包含非法数据项与空列表
    assert calculate_grade_average([-10, 150, 100, 50]) == 75.00
    assert calculate_grade_average([]) == 0.0
    print("微循环验证通过:基础计算、边界清洗与断言均已就绪。")
当编写完带有断言测试的函数并成功运行后,该语法点才算真正内化为你认知系统的一部分。遵循这种节奏,每次学习的绝对时长虽然变短,但编写代码的实际肌肉记忆和问题解决能力会呈倍数提升。
误区二:脱离实际场景死磕全量语法与生僻特性
许多自学者在制定学习规划时,习惯以“啃完一本 800 页的语法参考大全”为目标。从元类(Metaclass)、自定义属性描述符(Descriptor)、动态代码编译(exec/eval)一直死记到底层的 CPython 垃圾回收分代算法。结果花费了几个月时间背诵冷门知识,真正面对日常业务时,连如何从嵌套字典中提取有效数据、或是如何安全读取 CSV 文件依然一头雾水。
现代编程语言的应用遵循严格的 80/20 法则:在实际开发中,80% 的生产需求仅依赖 20% 的核心基础结构与标准库;而剩余的生僻高级特性往往服务于特定底层架构或大型框架的内部封装。脱离具体应用场景去死记语法规则,既容易让人产生倦怠感,又因缺乏使用场景而迅速遗忘。
将主要学习精力集中在 list、dict、set、tuple 以及字符串的常用切片与推导式上。对于辅助工具,优先掌握 Python 现代化内置标准库,例如用于路径操作的 pathlib、用于数据交换的 json 以及用于统计计数的 collections。
# 示例:利用现代标准库与核心数据结构高效完成业务 (data_pipeline.py)
import json
from pathlib import Path
from collections import Counter

# 1. 现代化路径处理:抛弃繁琐易错的 os.path.join 字符串拼接
data_dir = Path("./workspace_data")
data_dir.mkdir(exist_ok=True)
sample_file = data_dir / "user_logs.json"

# 构造模拟业务数据
records = [
    {"user": "alice", "action": "login", "status": "success"},
    {"user": "bob", "action": "checkout", "status": "failed"},
    {"user": "alice", "action": "view", "status": "success"},
    {"user": "charlie", "action": "login", "status": "success"},
    {"user": "alice", "action": "checkout", "status": "success"},
]

# 写入 JSON 数据
sample_file.write_text(json.dumps(records, ensure_ascii=False, indent=2), encoding="utf-8")

# 2. 读取并借助内置 Counter 与字典推导式进行快速聚合
loaded_data = json.loads(sample_file.read_text(encoding="utf-8"))

# 统计每位用户的成功行为频次
user_success_counter = Counter(
    item["user"] for item in loaded_data if item.get("status") == "success"
)

# 转换生成分析摘要
summary = {user: count for user, count in user_success_counter.items() if count >= 1}
print("数据统计汇总结果:", summary)
# 预期输出:数据统计汇总结果: {'alice': 3, 'charlie': 1}
通过围绕核心数据结构建立起解决具体问题的工具箱,你可以在最短时间内写出简洁、符合 Python 惯用风格(Pythonic)的代码。生僻的高级语法应当推迟到参与大型项目或阅读知名开源库底层源码时,再结合具体设计模式进行针对性补齐。
误区三:遭遇报错便恐慌搜索或盲目无序复制
终端里突然弹出一整屏红色的 Traceback (most recent call last) 报错信息,往往是自学者感到受挫最深的时候。很多初学者的第一反应是将这一整屏报错视作“系统瘫痪”,连具体英文字母都不仔细看,立刻把报错文字甚至整个工程代码一股脑贴入搜索引擎或询问 AI。随之而来的操作是在网上搜索各种零散的代码片段,不加理解地强行粘贴进自己的工程,直到整个项目语法错乱、彻底无法运行。
Python 的回溯追踪机制(Traceback)并非旨在警告或惩罚开发者,它是整个运行环境中最精准的排障导航仪。许多人之所以觉得报错难懂,是因为阅读顺序颠倒了:从第一行开始自上而下阅读,往往会被外部类库或标准库冗长的层级调用栈扰乱心智。
排查错误必须遵循标准顺序:从最末行开始逆向溯源,先锁定异常类与原因,再过滤自有代码栈帧,随后在现场输出真实变量状态,最后加入防御逻辑。
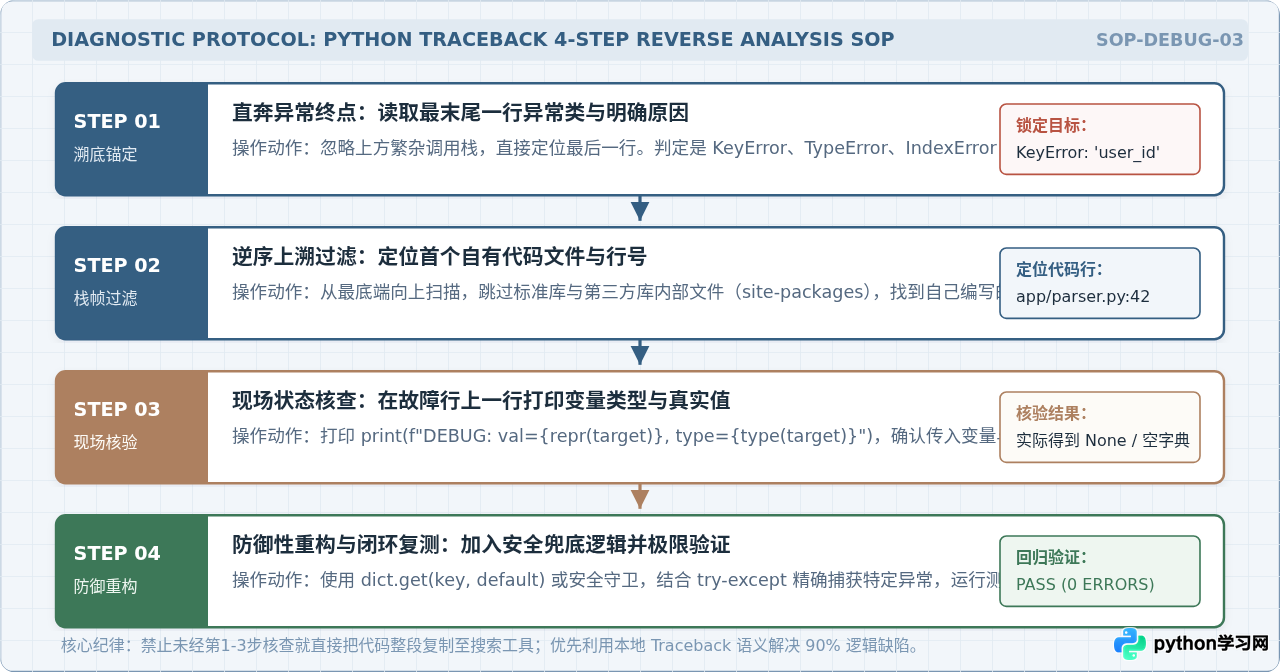
以下通过一个最典型的业务场景展示如何阅读真实报错信息并实施精准修复:
# 模拟报错场景:执行如下代码时触发异常
user_profile = {"username": "dev_walker", "role": "editor"}

def parse_access_level(profile: dict) -> str:
    # 错误发生点:直接通过中括号索引可能不存在的键
    return f"Level-{profile['permissions']['access_code']}"

parse_access_level(user_profile)
终端输出的典型 Traceback 信息如下:
# 终端输出 Traceback (示例)
Traceback (most recent call last):
  File "/workspace/app/main.py", line 8, in <module>
    parse_access_level(user_profile)
  File "/workspace/app/main.py", line 5, in parse_access_level
    return f"Level-{profile['permissions']['access_code']}"
KeyError: 'permissions'
按照排查 SOP 执行分析:
- 步骤一:看末行确定异常种类。 最后一行为
KeyError: 'permissions',明确指出字典中缺少名为permissions的键。 - 步骤二:逆向上溯查找自有文件。 找到
main.py, line 5,锁定错误是在执行profile['permissions']时抛出。 - 步骤三:核实上下文真实值。 在第 5 行之前加入调试打印
print(f"DEBUG: profile keys = {list(profile.keys())}"),发现传入的字典只有username和role。 - 步骤四:使用防御性写法消除隐患。 采用链式
get()安全提取并设置默认回退值。
# 纠正后的稳健实现 (safe_resolver.py)
def parse_access_level_safe(profile: dict) -> str:
    # 采用安全获取策略,提供明确的兜底默认值
    permissions = profile.get("permissions")
    if not isinstance(permissions, dict):
        return "Level-GUEST_DEFAULT"

    code = permissions.get("access_code", "RESTRICTED")
    return f"Level-{code}"

print(parse_access_level_safe(user_profile))
# 正常输出:Level-GUEST_DEFAULT
误区四:跨过编程基础逻辑越级冲刺复杂大型框架
不少初学者刚学完基础的 if-else 分支与 while 循环,就迫不及待地想要“快速做项目”,直接去学习 Django、Scrapy、TensorFlow 等大型框架。面对庞大的自动化脚手架、繁杂的配置文件、ORM 模型映射以及中间件机制,初学者往往被巨大的黑盒复杂度困住。一旦遭遇版本不兼容或依赖缺失,由于缺乏基础排查能力,只能陷入无休止的求助与停滞。
现代工业级框架之所以高效,是因为其底层利用面向对象多态、元编程、装饰器和动态导入对通用工程模式进行了深度封装。如果自学者连基本的模块导入路径(sys.path)、类继承调用逻辑与异常捕获机制都未理顺,直接使用框架就像在流沙之上搭建积木,难以形成真正的技术积淀。
在引入大型框架前,先练习使用 Python 内置库与单一职责的轻量库(例如 requests 或 sqlite3)完整编写 1~2 个 100 行左右的独立脚本。当你亲身体会到“手工维护路由很繁琐”或“手动拼接 SQL 容易出错”时,再去接触框架,才能深刻理解框架的设计动机与运行机理。
# 示例:不用重型框架,仅用标准库编写可落地的轻量持久化工具 (storage_tool.py)
import sqlite3
from pathlib import Path

DB_FILE = Path("app_mini.db")

def init_database():
    """初始化数据库表结构:理解原生连接与游标运作机制"""
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS task_log (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                task_name TEXT NOT NULL,
                execution_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
                status TEXT CHECK(status IN ('SUCCESS', 'FAILED'))
            )
        """)
        conn.commit()

def record_task(name: str, status: str):
    """插入单条记录:参数化查询防止 SQL 注入风险"""
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute(
            "INSERT INTO task_log (task_name, status) VALUES (?, ?)",
            (name, status)
        )
        conn.commit()

def query_recent_tasks(limit: int = 5) -> list[tuple]:
    """查询最新执行记录"""
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute(
            "SELECT id, task_name, execution_time, status FROM task_log ORDER BY id DESC LIMIT ?",
            (limit,)
        )
        return cursor.fetchall()

if __name__ == "__main__":
    init_database()
    record_task("data_sync", "SUCCESS")
    record_task("file_backup", "SUCCESS")
    for row in query_recent_tasks(2):
        print(f"日志条目: ID={row[0]}, 任务={row[1]}, 时间={row[2]}, 状态={row[3]}")
通过亲手编写上述使用原生接口的小程序,你将彻底理解数据库连接池、游标指针、事务提交(commit)与参数化防注入的底层逻辑。以此为基石,日后学习大型 ORM 框架(如 SQLAlchemy 或 Django ORM)时,便能看穿其抽象外壳,从容应对底层产生的各类连接超时与事务死锁问题。
误区五:忽视虚拟环境造成全局依赖污染与版本冲突
这是导致自学者“在自己电脑上能跑、换台机器完全崩溃”或者“今天刚安装新库、昨天写好的程序突然跑不起来”的罪魁祸首。很多新手在终端里学习时,看到教程里写着 pip install xxx,便在任意目录下直接敲下回车。所有的第三方包全部被堆入操作系统的全局 Python site-packages 目录中。
Python 的全局安装机制是单一扁平的。当学习教程 A 时,安装了 pydantic==1.10.8;几天后学习教程 B 时,又全局执行了 pip install pydantic==2.6.4。后安装的高版本会直接强制覆盖低版本文件。由于 Pydantic 1.x 与 2.x 之间存在大量不兼容变更,曾经正常运行的教程 A 代码会立刻因方法缺失而崩溃,而初学者往往很难意识到是全局三方库被暗中替换导致的故障。
建立绝对的工程红线:任何新建项目必须拥有完全独立的虚拟环境目录,所有依赖必须在激活的环境内安装,并通过清单文件进行严格版本锁定。
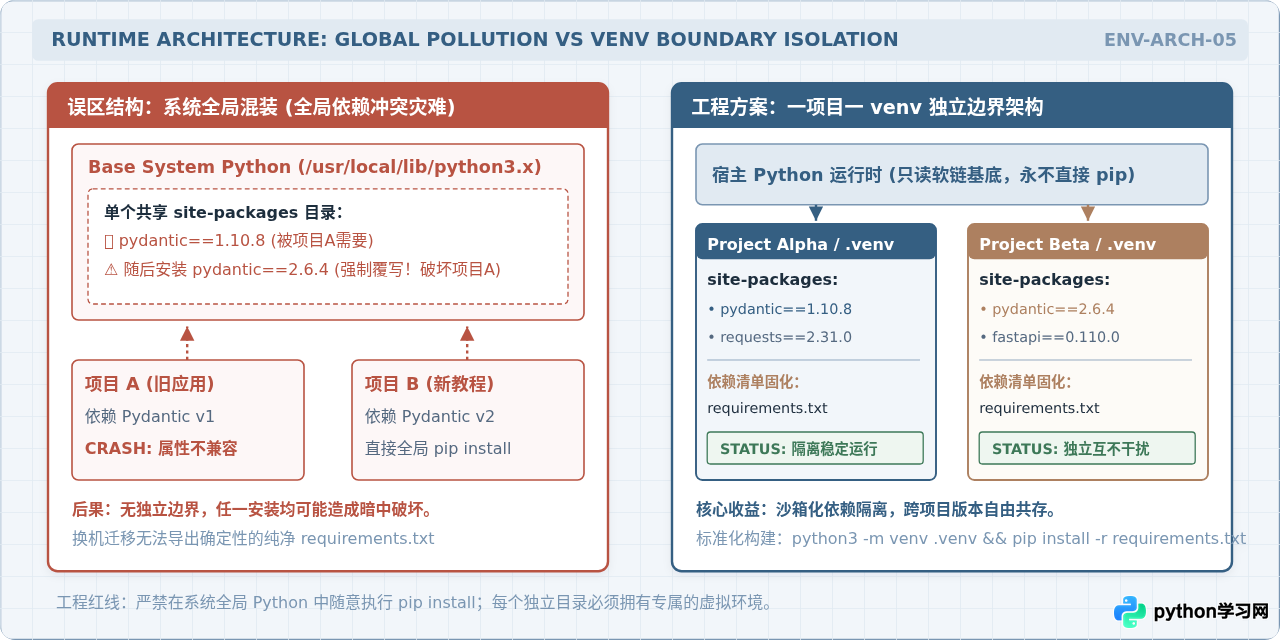
虚拟环境标准操作指引(以 Python 内置 venv 为例)
-
创建专属虚拟环境:
进入你的项目专属根目录,调用 Python 内置的
venv模块创建名为.venv的隔离环境。# 进入工程根目录 cd ~/my_python_project # 创建虚拟环境(在当前目录下生成 .venv 文件夹) python3 -m venv .venv -
激活虚拟环境:
环境创建后必须显式激活,终端提示符前出现
(.venv)标记后,方可进行包管理。# macOS / Linux 激活命令: source .venv/bin/activate # Windows PowerShell 激活命令: # .\.venv\Scripts\Activate.ps1 # 验证当前正在使用的 python 解释器路径(确保指向 .venv 内部) which python -
安装依赖并固化清单:
在激活的环境中安装所需三方库,并将其版本完整导出至
requirements.txt。# 安装项目所需的依赖 pip install requests==2.31.0 # 将当前环境所有包及其确切版本固化输出为清单文件 pip freeze > requirements.txt -
异地重现与交付:
当在另一台电脑或交由他人运行时,只需依据清单文件一键还原,绝无版本差异干扰。
# 对方只需创建环境后执行:
pip install -r requirements.txt
总结:初学者自学避坑对照矩阵与自查清单
自学 Python 的核心在于从“被动知识接收者”转变为“具备工程思维的代码构建者”。学习的快慢并不取决于你收藏了多少本电子书或刷了多少集视频,而取决于每一次键盘敲击是否构成了闭环、每一处报错是否得到了根因分析、每一个项目是否拥有干净规范的运行边界。
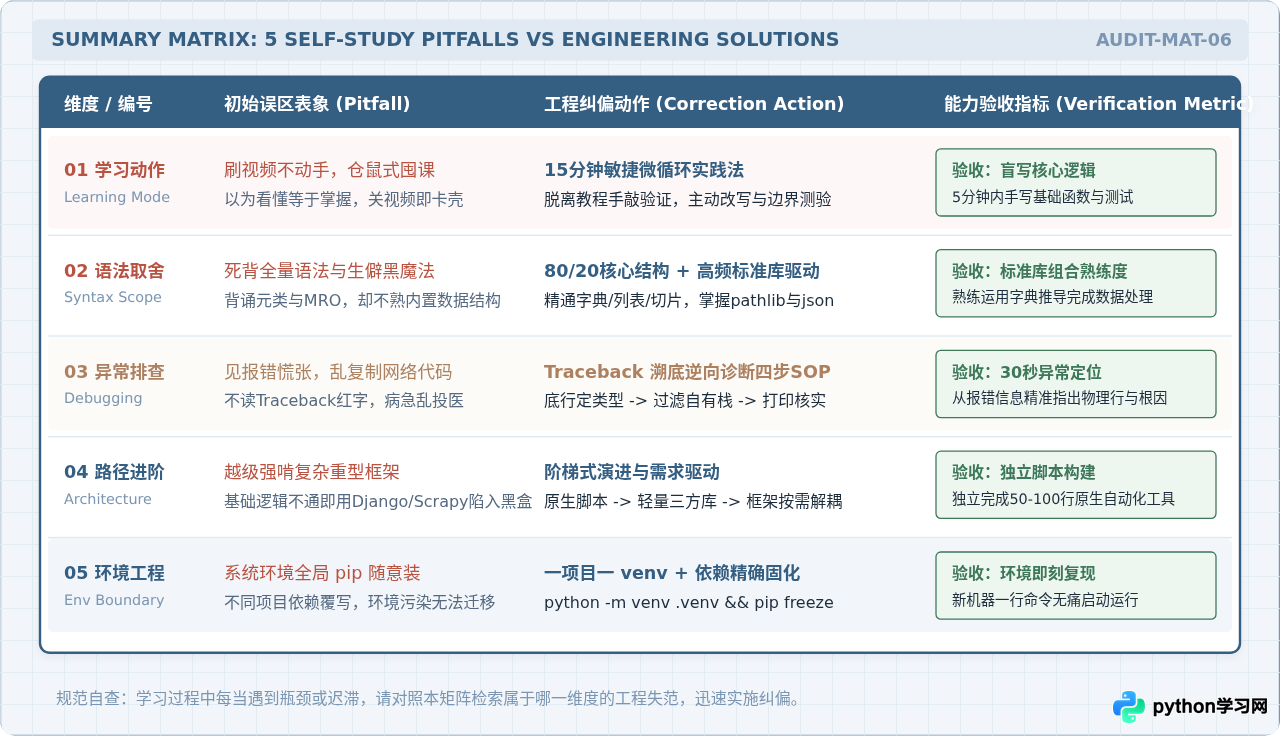
在自学遇到瓶颈或迟滞不前时,建议使用以下自查清单对自己的日常学习动作进行审计:
| 审计维度 | 高危误区表象 | 健康自检标准 | 立即可行纠偏动作 |
|---|---|---|---|
| 学习节奏 | 长时间刷视频、很少打开编辑器 | 视频学习与手敲代码时间比不低于 1:2 | 严格设定 15 分钟闹钟,定时暂停视频手敲验证 |
| 代码实操 | 逐行全选复制代码或直接用课件 | 关掉教程后能独立盲写出基础实现 | 手写代码后,主动改写输入参数与测试边界 |
| 异常认知 | 一见报错红字就整段复制去网络搜索 | 能在 30 秒内指出 Traceback 最底行的根因 | 强制执行逆向四步排查法,先读末行再查自有栈帧 |
| 架构选择 | 语法未通即用复杂全栈框架做大项目 | 能用原生标准库写出 50 行自动化小脚本 | 先用原生库实现核心逻辑,按需逐步引入三方组件 |
| 运行环境 | 所有三方库直接全局 pip install | 每个项目均拥有独立 .venv 与依赖清单 |
新建项目必须先执行 python3 -m venv .venv |
避开这 5 个关键误区后,你的代码积累将直接转化为扎实的工程落地能力。编程从来不是单纯关于“记住多少语法规则”的学问,而是一门关于“如何组织逻辑、调试异常与管理运行状态”的实践技能。沉下心完成每一个小函数的封装与测试,自学的每一步都将坚实可信。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









