

Python原始字符串r''中\n和\t会生效吗
深入解析Python原始字符串r''中\n与\t是否生效的机制、底层原理、代码验证、正则表达式中的二次解析以及常见语法陷阱。
r 或 R 为前缀的字符串字面量)中,\n 和 \t 不会生效为换行符与制表符。在词法解析阶段,反斜杠会被当作普通字符处理,因此 r'\n' 表示反斜杠和字母 n 构成的两个连续字符,而非换行控制符。
假设你正在处理 Windows 本地路径 C:\new_folder\test.txt,或者编写包含转义规则的正则表达式。许多初学者听说在字符串前加上字母 r 可以避免转义带来的各种麻烦,但随之而来的疑问是:如果加上了 r,其中的 \n 和 \t 还会不会触发换行和缩进?它们在内存中到底是如何存在的?本文将通过具体代码演示、内存对比、原理解析以及易错陷阱,彻底解答这一问题。
一、直观测试:普通字符串与原始字符串的输出差异
要弄清楚 \n 与 \t 是否生效,最直接的方法就是对比它们在 print() 打印时和用 len() 测量长度时的表现。
请看以下对比代码:
# 普通字符串
normal_str = "Line1\nLine2\tEnd"

# 原始字符串
raw_str = r"Line1\nLine2\tEnd"

print("--- 打印普通字符串 ---")
print(normal_str)

print("\n--- 打印原始字符串 ---")
print(raw_str)

print("\n--- 长度与内部结构对比 ---")
print("普通字符串长度:", len(normal_str))
print("原始字符串长度:", len(raw_str))Line1
Line2 End
--- 打印原始字符串 ---
Line1\nLine2\tEnd
--- 长度与内部结构对比 ---
普通字符串长度: 15
原始字符串长度: 17
从输出中可以清晰地观察到两个核心事实:
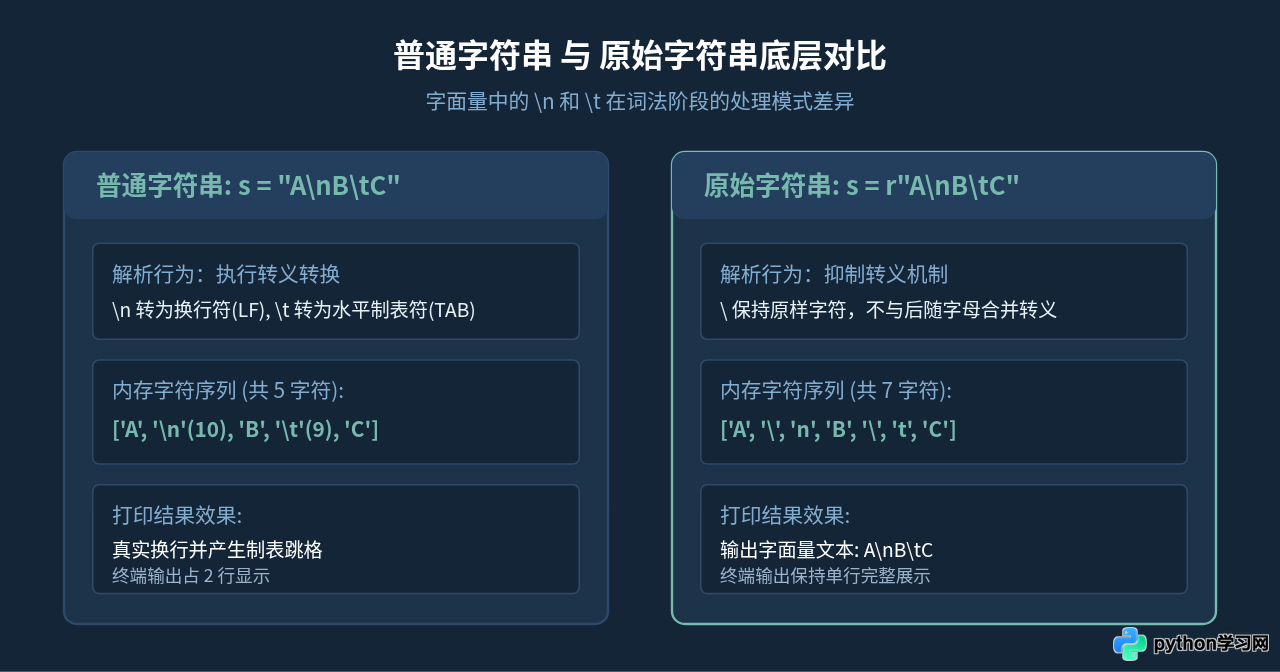
- 显示效果:普通字符串中的
\n触发了实际折行,\t产生了制表符空白;而在原始字符串中,终端直接打印出了字符\和n,以及\和t,没有发生任何换行或跳格。 - 字符串长度:普通字符串中的
\n和\t分别只占用 1 个字符位(ASCII 码点 10 和 9)。而原始字符串的长度多了 2,因为每个反斜杠都被独立计为了 1 个字符。
二、底层原理解析:解释器是如何处理 r'' 前缀的
要深刻理解原始字符串的行为,我们需要了解 Python 解释器在读取源代码文本时的处理流程。
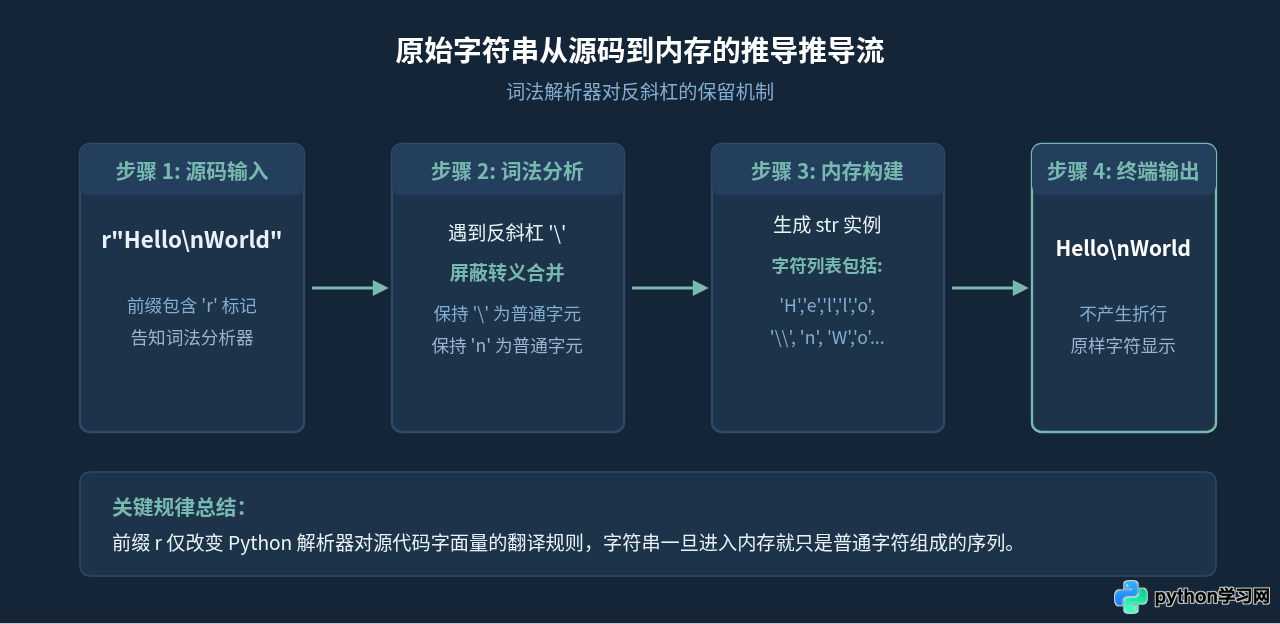
在 Python 中,字符串的类型只有一种,即 str。不论你书写的是 "hello" 还是 r"hello",生成后的对象在底层都是标准的 Unicode 字符串对象,并没有名为“raw string”的独立数据类型。前缀 r 或 R 的作用范围仅仅存在于词法分析阶段。
当解释器的词法分析器(Lexer)扫描到普通字符串字面量时,遇到反斜杠 \ 会将其视作转义引导符,尝试与后一个字符组合:
- 遇到
\+n:识别为换行转义符,在内存中填入单一字符\u000a(ASCII 码 10)。 - 遇到
\+t:识别为制表转义符,在内存中填入单一字符\u0009(ASCII 码 9)。
而当词法分析器看到以 r 开头的字符串时,它会改变内部状态,关闭绝大多数转义字符的转换逻辑。此时反斜杠不再充当“将字母 n 转变为控制字符”的桥梁,而是直接作为反斜杠字符 \u0005c(ASCII 码 92)写入内存,后随的 n 也直接作为字母 \u0006e(ASCII 码 110)写入内存。
我们可以用 Python 内置的 list() 和 ord() 函数进一步验证每个字符的 Unicode 码点:
s = r"\n\t"

# 拆解每个字符及其码点
for idx, char in enumerate(s):
print(f"位置 {idx}: 字符={repr(char)}, ASCII码点={ord(char)}")位置 1: 字符='n', ASCII码点=110
位置 2: 字符='\\', ASCII码点=92
位置 3: 字符='t', ASCII码点=116
这个验证彻底证明了:r'\n\t' 在内存中包含 4 个完全独立的字符,根本不存在 ASCII 10(换行)或 ASCII 9(制表)的踪迹。
三、常见混淆点:为什么在正则表达式中 r'\n' 看起来生效了?
许多开发者在初学正则表达式时会产生深深的困惑:“既然 r'\n' 不会生效,为什么我写 re.search(r'\n', text) 却能精准匹配到文本中的换行符?”
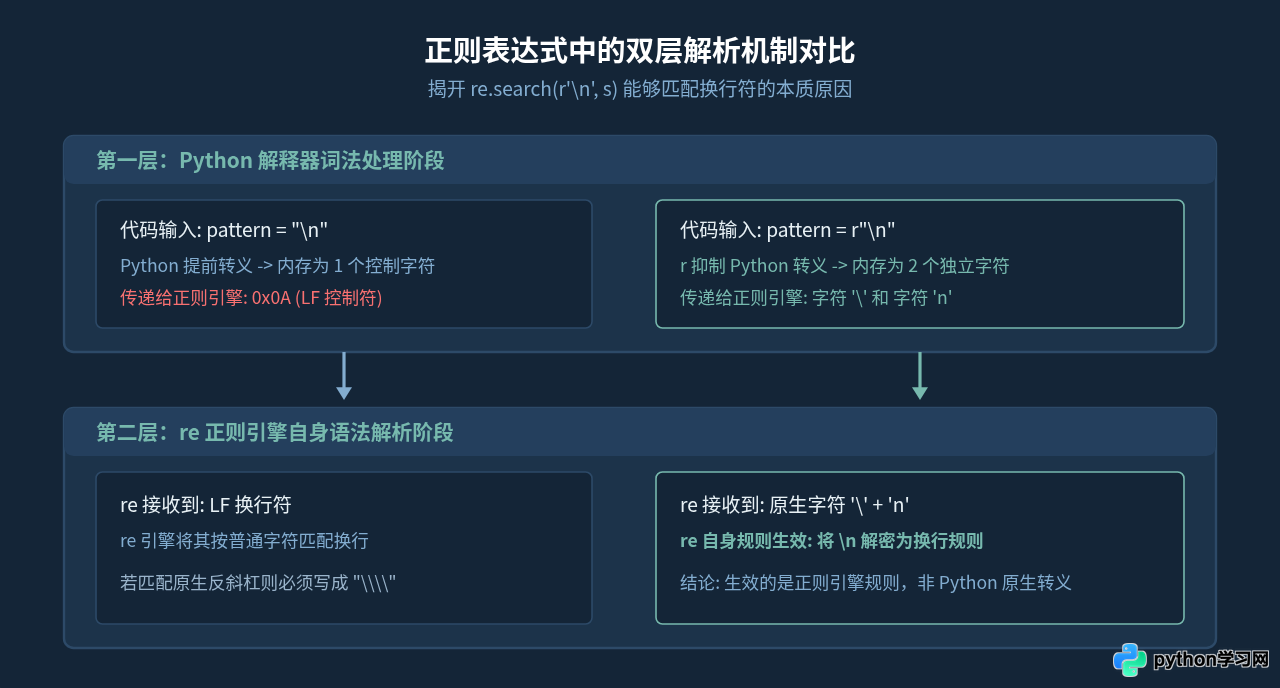
这涉及到一个至关重要的概念:双层解析机制(Two-stage Parsing)。
在 Python 正则表达式操作中,实际存在两个完全独立的解析器:
- 第一层(Python 解释器):负责将代码里的字面量转为内存中的
str对象。 - 第二层(re 模块正则表达式引擎):负责读取该
str对象,并将其按照正则表达式语法规范进行匹配。
当你写 r"\n" 时:
- 在第一层,Python 解释器因为
r的存在,将\和n原样放入内存传递给re.search()。 - 在第二层,
re引擎接收到由两个字符组成的字符串\和n。而 re 引擎自身的语法规范中,规定了“反斜杠后跟字母 n 代表匹配换行符”。于是re引擎将其匹配为换行符。
换句话说:并不是 Python 的 r'' 让 \n 生效了,恰恰相反,正是因为 r'' 阻止了 Python 提前把 \n 转换掉,才把原始的反斜杠完好无损地送到了 re 引擎手里,由 re 引擎完成了解析!
四、避坑指南:原始字符串的两个致命陷阱
虽然原始字符串在书写路径和正则表达式时非常方便,但它并非万能,有两个最容易让人摔跟头的陷阱必须注意。
1. 陷阱一:原始字符串不能以奇数个反斜杠结尾
很多开发者在书写 Windows 目录时习惯这么写:
# 错误示例:试图定义一个末尾带反斜杠的路径
path = r"C:\project\data\"
执行这段代码并不会得到预期的路径,而是会直接抛出语法错误:
\" 时,反斜杠将后面的双引号转义了,导致字符串字面量认为引号还没有闭合,从而引发语法错误。
解决方案:如果路径末尾必须保留反斜杠,可以通过字符串拼接或 os.path.join / pathlib 来规避:
# 正确解法 1:最后追加一个单独的反斜杠
path1 = r"C:\project\data" + "\\"

# 正确解法 2:使用 pathlib(现代 Python 推荐方案)
from pathlib import Path
dir_path = Path(r"C:\project\data")
2. 陷阱二:需要在字符串中同时包含原始符号与真实换行
由于 r'' 会让所有的 \n 都失效为字面量,如果你确实需要在一个长文本中既包含不转义的反斜杠,又需要换行,直接写 \n 是行不通的。此时可以使用三引号多行字符串:
# 在多行原始字符串中,直接回车换行会保留为实际换行
# 但文本中的 \t 仍然是字面量字符
multiline_raw = r"""Line 1: Item\tValue
Line 2: Another\tValue"""

print(multiline_raw)Line 2: Another\tValue
五、实战选型与决策速查
在日常开发中,究竟什么时候应该用普通字符串,什么时候应该加 r 前缀?下表给出了直观的对照指引:
| 应用场景 | 推荐写法 | 原因说明 |
|---|---|---|
| 需要生成真实换行或制表符格式化输出 | "Line 1\nLine 2\tEnd" |
必须依靠普通字符串转义,才能将 \n 和 \t 转换为控制符。 |
| 书写正则表达式(re 模块) | r"^(\d+)\t[a-z]+$" |
避免 Python 和正则引擎的双重转义地狱,让正则元字符清晰可见。 |
| 处理包含特殊字符的 Windows 本地路径 | r"C:\test\new_app" 或 Path(...) |
防止路径中的 \t 和 \n 被误当成制表符和换行符破坏文件名。 |
| 末尾包含反斜杠的路径定义 | r"C:\data" + "\\" 或 Path("C:/data") |
原始字符串不能以奇数个 \ 结尾,需使用路径库或拼接规避。 |
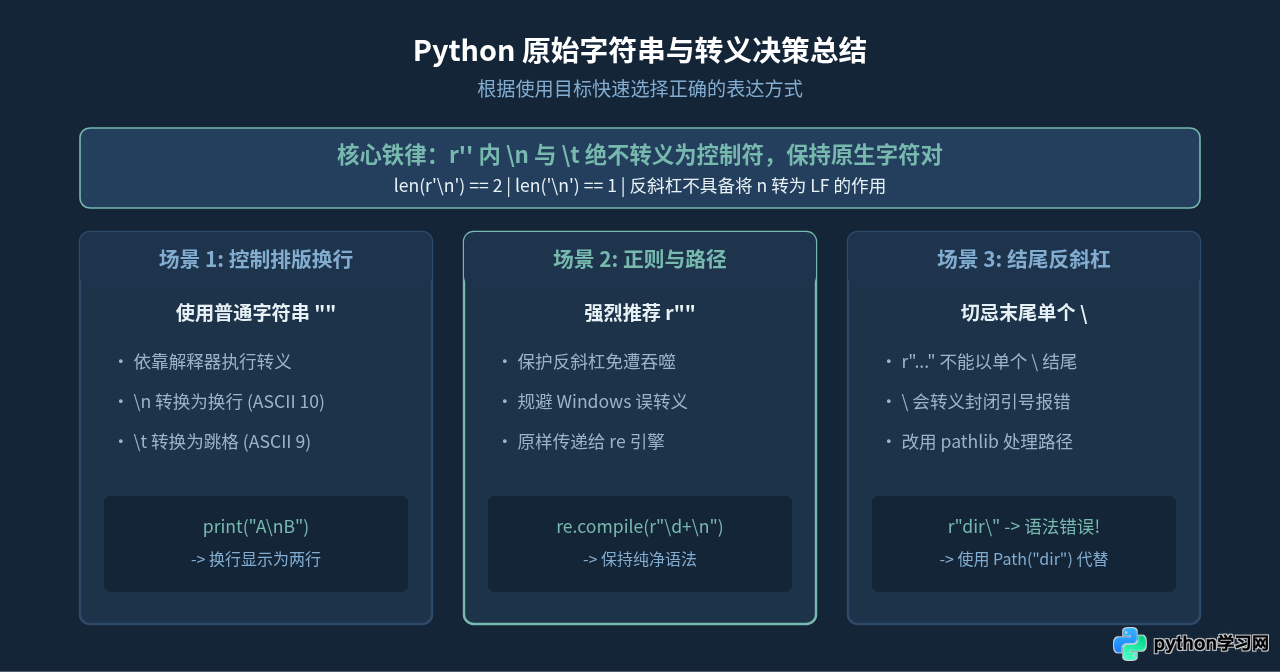
六、全文总结
回到文章开头提出的问题:Python 原始字符串 r'' 中 \n 和 \t 会生效吗?
答案是非常明确的:不会生效。在 Python 的词法规则下,r 前缀会阻止反斜杠参与转义转换。r'\n' 在内存中就是包含一个反斜杠和一个字符 n 的双字符序列,r'\t' 也是包含一个反斜杠和一个字符 t 的双字符序列。它们在打印时不会换行或产生制表间距,其长度也始终为 2。只有当你需要直接保留反斜杠字面值(例如文件路径或传递给外部引擎的正则表达式)时才应使用 r'';如果需要真正的控制排版符,请使用常规字符串。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









