

Python中原始字符串r''对\n和\t处理的影响
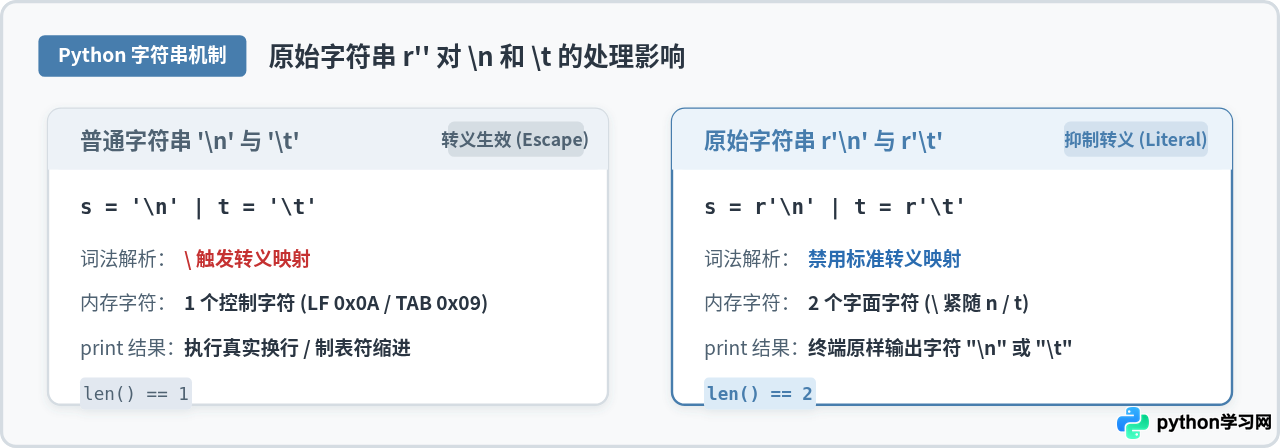
深入解析Python中原始字符串r''对\n与\t处理的底层影响,对比词法分析、内存结构、终端输出、字符长度及常见语法陷阱。
\)默认作为转义前导符:
会被词法分析器折叠为单一的换行控制字符(ASCII 10,LF), 会被折叠为水平制表符(ASCII 9,TAB)。而在字符串前增加 r 或 R 声明的原始字符串(Raw String,如 r'
' 与 r' ')中,Python 会抑制该转义映射,反斜杠与后续字符作为独立文本字符被原样保留,字符串长度直接翻倍。这一机制根本性地改变了字符在内存中的码点组成、终端输出的视觉渲染,并在文件路径处理与正则表达式构建中发挥着决定性作用。
一、核心机制:解析阶段与内存字符的根本差异
很多初学者误以为 r'' 是某种“运行时反转义函数”,或者认为它只是在打印时临时取消了换行。实际上,原始字符串的影响发生在 Python 源代码的词法分析与语法解析阶段(Parsing & Tokenization),在生成字节码并创建内存对象的那一刻,两者的结构就已经彻底分道扬镳。
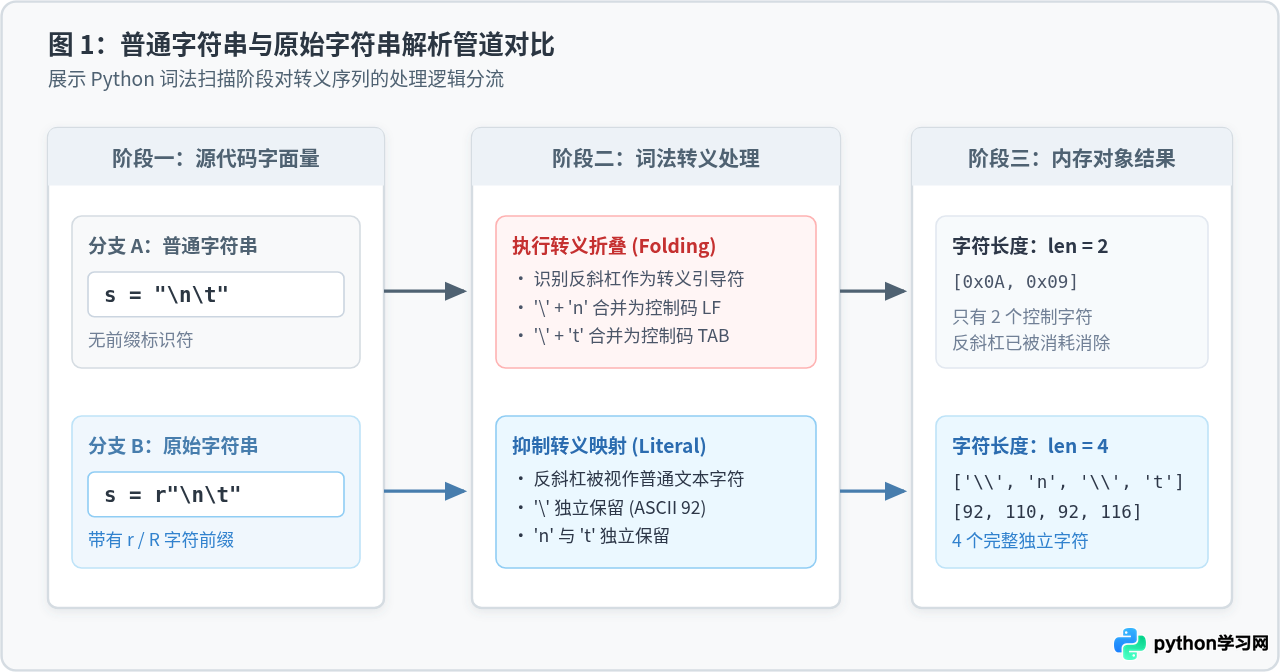
1. 词法扫描阶段的处理分流
当 Python 解释器扫描源码中的字符串字面量时:
- 普通字符串字面量(
' '/' '):词法扫描器检测到反斜杠\后,会与后续紧随的字符组合进行查表匹配,将双字符源代码序列合并编码为单个 ASCII/Unicode 码点。反斜杠自身被消耗,不会作为独立字符存在于最终字符串中。 - 原始字符串字面量(
r' '/r' '):前缀r通知词法扫描器禁用标准转义折叠规则。反斜杠\不再扮演转义引发者的角色,而是直接作为反斜杠字符(Unicode U+005C)写入,随后的n或t同样按字面字符写入。
2. 代码验证:字符长度与底层码点
通过 Python 内置的 len() 和 ord() 函数,可以清晰检验内存中的真实字符构成:
# 示例代码:验证字符长度与内存码点列表
s_normal = "
"
s_raw = r"
"
print("s_normal 长度:", len(s_normal))
print("s_normal 码点:", [ord(c) for c in s_normal])
print("s_raw 长度:", len(s_raw))
print("s_raw 码点:", [ord(c) for c in s_raw])输出结果明确证实:
- 普通字符串
" "的长度仅为 2,包含的字符是 ASCII 10(换行符 - 原始字符串
r" "的长度为 4,由 4 个独立的 ASCII 字符组成:92(\)、110(n)、92(\)、116(t)。反斜杠没有被任何转义逻辑消除。
二、终端输出表现:print()、repr() 与光标控制
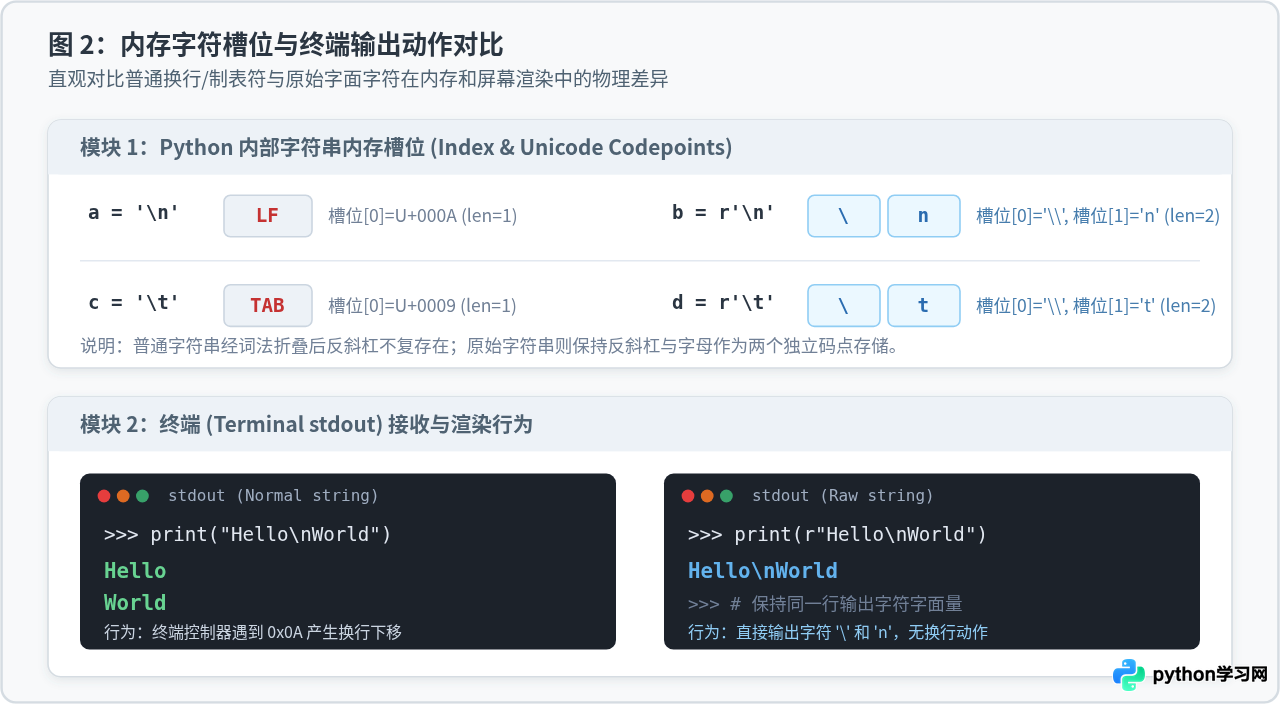
理解了内存码点的差异后,终端输出的现象便顺理成章。终端本质上是一个字符显示控制器,它依据接收到的字符流决定执行光标移动还是字形渲染。
1. print() 调用的渲染差异
当调用 print() 输出内容时,Python 会将字符串内的码点原样发往标准输出流 sys.stdout:
- 对于
print("Alpha Beta"):终端控制器收到码点0x0A,触发换行并回到行首操作,Alpha与Beta呈现为两行; - 对于
print(r"Alpha Beta"):终端控制器依次收到A-l-p-h-a、\、n、B-e-t-a。因为全是常规可见字符,终端不会执行光标移动,而是完整在一行打印出字符Alpha Beta; - 制表符同理:
print("Col1 Col2")会产生光标向后跳跃对齐的缩进空格,而print(r"Col1 Col2")则直接输出包含
# 示例代码:print() 打印对比
print("--- 普通字符串打印 ---")
print("Line1
Line2 ColB")
print("
--- 原始字符串打印 ---")
print(r"Line1
Line2 ColB")2. 交互式解释器与 repr() 的显示陷阱
初学者在 Python 交互式 REPL(如 IPython 或终端 Python)中调试时,经常会看到令人困惑的输出:
# 示例代码:交互式环境下的返回值与 print 对比
>>> s = r"
"
>>> s
'\n'
>>> print(s)
原因解释:交互式命令行直接回车显示的是对象的 repr() 结果,而非 print()。repr() 的设计初衷是生成可供 Python 代码重新解析的字符串表示。由于字符串 s 内部确实存储了一个字符 \,为了在常规 Python 语法中表示这个反斜杠,repr() 必须在外层为其额外转义,输出 '\n'。这绝不意味着 s 内部存了两个反斜杠,实际长度依然是 2。
三、典型应用场景:为什么必须使用 r'' 规避转义
在日常开发中,无意中忽略
和 的转义行为是造成诡异 Bug 的高发区。以下两个场景展现了原始字符串的必要性。
场景一:Windows 文件路径中的“隐式破坏”
Windows 系统的目录层级习惯使用反斜杠分隔。若在路径中出现以 n、t、u 开头的目录名,普通字符串会直接产生灾难性错误:
# 常见错误写法:未加 r 的 Windows 路径
path_bug = "C: ools
ew_project able.csv"
# 实际内存中:
# 被解析为制表符
#
被解析为换行符
print("错误解析后的路径:")
print(repr(path_bug))如果将上述 path_bug 传给 open(path_bug),操作系统会收到包含换行符与制表符的乱码文件名,随即抛出 FileNotFoundError: [Errno 2] No such file or directory。正确的做法是强制使用原始字符串:
# 正确写法:使用原始字符串
path_safe = r"C: ools
ew_project able.csv"
print("安全路径:", path_safe)场景二:正则表达式中的反斜杠风暴
在 re 模块中,正则表达式引擎本身也有自己的一套转义语法。例如正则中 \d 匹配数字, 匹配单词边界, 匹配制表符。
若不使用原始字符串,字符串字面量在传给 re.compile() 之前就会先被 Python 词法扫描器转义一次。为了把一个反斜杠传给正则引擎,程序员不得不写成 "\\",极易引发难以维护的“反斜杠泥潭”。使用 r'' 可以使 Python 完整透传反斜杠给正则引擎:
import re
text = "Item1 ValueA
Item2 ValueB"
# 需求:在文本中通过正则匹配制表符后续的文本
# 使用原始字符串,模式更直观易读
matches = re.findall(r" [A-Za-z]+", text)
print("匹配结果:", matches)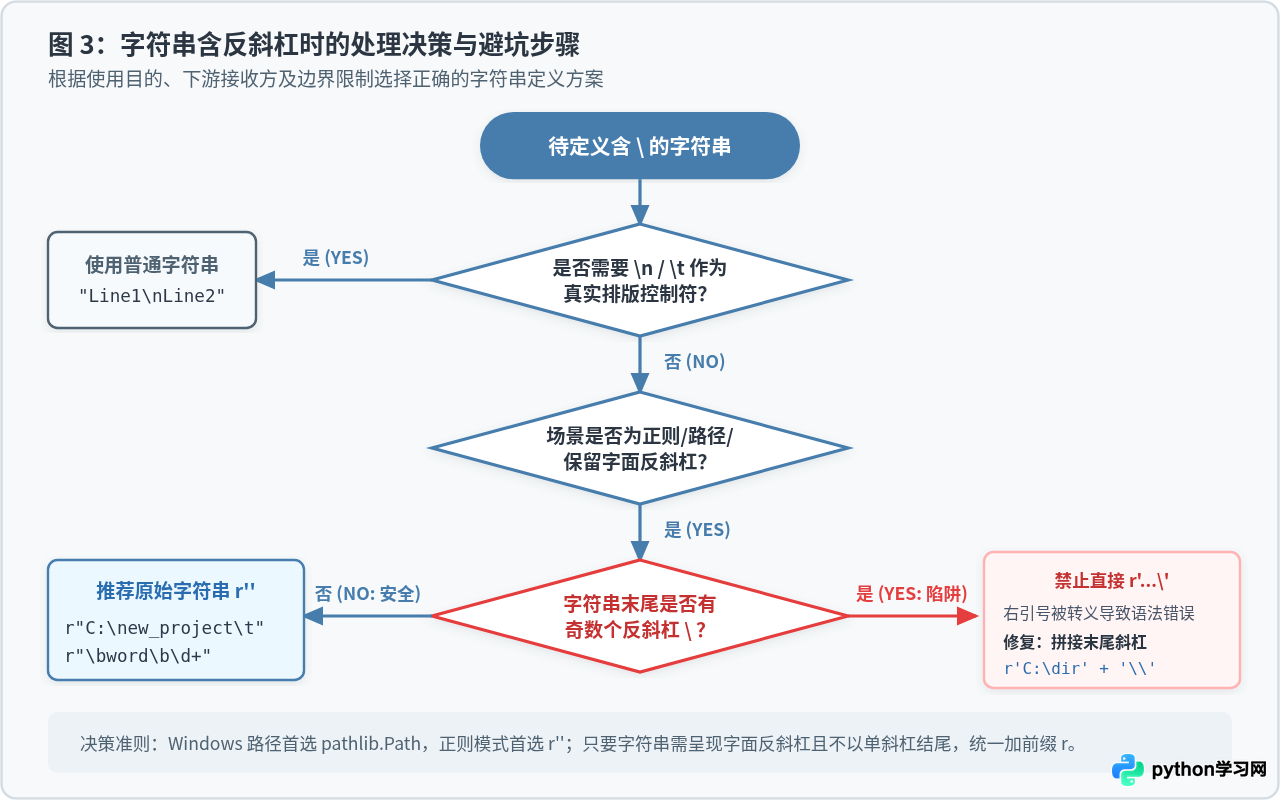
四、关键限制与避坑:原始字符串不是“绝对原始”
许多初学者容易产生一种过度概括的认知,以为 r'' 会让 Python 完全停止对反斜杠的一切处理。这种理解是错误的。Python 的原始字符串并非完全未经处理的无格式字符流,它仍然保留了针对引号的逃逸机制。
1. 语法硬限制:末尾不能以奇数个反斜杠结束
这是 Python 原始字符串最著名的“反直觉语法限制”。以下代码会在编译期直接报错:
# 语法错误示例:尝试以单反斜杠结尾
# bad_str = r"C: estolder"Python 词法分析器在扫描原始字符串时,依然保留了“反斜杠允许转义包围它的引号”这一规则。目的是让开发者能够写出
r""" 或 r''' 这样包含同类引号的字符串。然而这一机制的副作用是:字符串末尾的反斜杠会将随后的闭合引号(")转义成字面引号,导致字符串失去闭合引号,词法扫描器因而判定为“字符串未闭合”(unterminated string literal)。
解决方案:当目录路径必须以反斜杠结尾时,可通过常规转义拼接或使用 pathlib 库解决:
# 解决方案 A:拼接转义反斜杠
dir_path = r"C: estolder" + "\"
# 解决方案 B:切片写法
dir_path_b = r"C: estolder""[:-1]
# 解决方案 C(工程推荐):使用 pathlib 面向对象路径
from pathlib import Path
dir_path_c = Path(r"C: estolder")2. 引号转义保留反斜杠自身
在普通字符串中,""" 的长度是 1(反斜杠被消耗,只留下双引号)。但在原始字符串中,转义引号的同时,反斜杠自身会被保留:
# 验证原始字符串转义引号的行为
raw_quote = r"""
print("raw_quote 内容:", raw_quote)
print("raw_quote 长度:", len(raw_quote))3. 格式化原始字符串组合:rf"" / fr""
从 Python 3.6 开始,原始字符串前缀可以与 f-string 格式化前缀组合使用(rf"..." 或 fr"...")。在此模式下:
- 花括号表达式
{var}依然正常插值求值; - 反斜杠
user = "alice"
# rf 组合:既能变量插值,又抑制 与
msg = rf"User: {user} DefaultPath: C:
ew_data able"
print(msg)五、总结与对照速查
为了在实际编码中快速做出正确选择,下表系统梳理了不同定义方式在各环节的行为对照:
| 表达式写法 | 内存字符组成 | len() | print() 输出效果 | 典型适用场景 |
|---|---|---|---|---|
'
' |
[0x0A] (LF) | 1 | 换行折行(光标移至下一行) | 文本排版、构造多行数据 |
r'
' |
[0x5C, 0x6E] ('', 'n') | 2 | 直接显示文本
|
正则表达式字面匹配、说明文档 |
' ' |
[0x09] (TAB) | 1 | 水平跳格(缩进空格对齐) | 表格对齐、TSV 数据生成 |
r' ' |
[0x5C, 0x74] ('', 't') | 2 | 直接显示文本 |
Windows 路径、正则字段匹配 |
'\n' |
[0x5C, 0x6E] ('', 'n') | 2 | 直接显示文本
|
无 r 前缀时手动转义输出斜杠 |
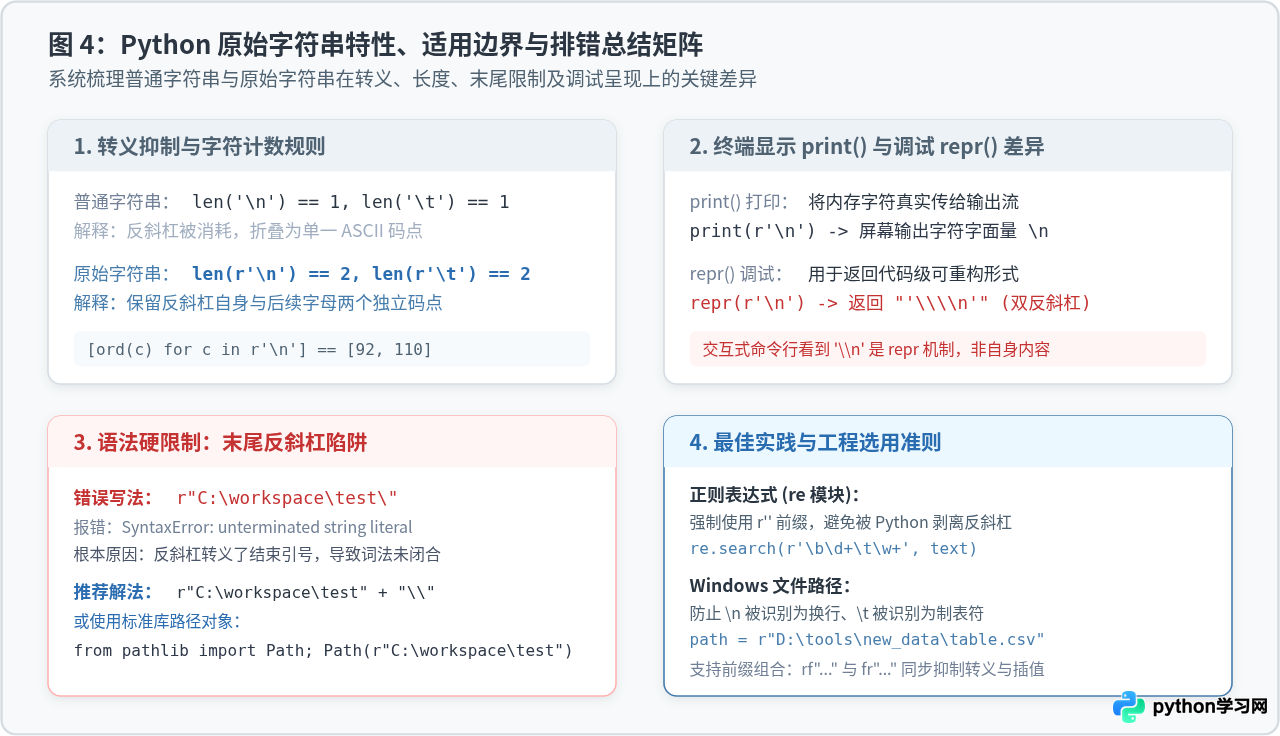
r'' 的核心价值在于将反斜杠的转义解释权从 Python 词法分析器剥离,完整移交给下游接收方(如正则表达式引擎、文件系统 API 或网络协议解析器)。处理
与 时,只要你希望反斜杠是字面内容而非排版指令,就应果断加上 r 前缀;同时切记避免以单反斜杠作为结尾。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









