

MiniMax-H3-Image用DiffSynth-Studio推理时,24GB显存方案怎样区分
MiniMax-H3-Image的DiffSynth-Studio文档为24GB显存给出了两种不同推理配方:一种搭配32GB主机RAM并使用卸载,另一种搭配8GB RAM并采用混合量化。它们属于官方README新增推荐入口所指的具体方案,不意味着模型新权重或DiffSynth-Studio新版本发布。
先分清常规加载和面向不同硬件的配方
DiffSynth-Studio文档的Quick Start将各组件保留在加速器上,合计约需135GB显存,其中包括文本编码器、Transformer和图像VAE。文档另有低显存示例,通过磁盘流式加载和主机内存量化存储减少显存占用。“低显存”是在指定方案下的相对描述,不等于所有示例都适合24GB GPU。
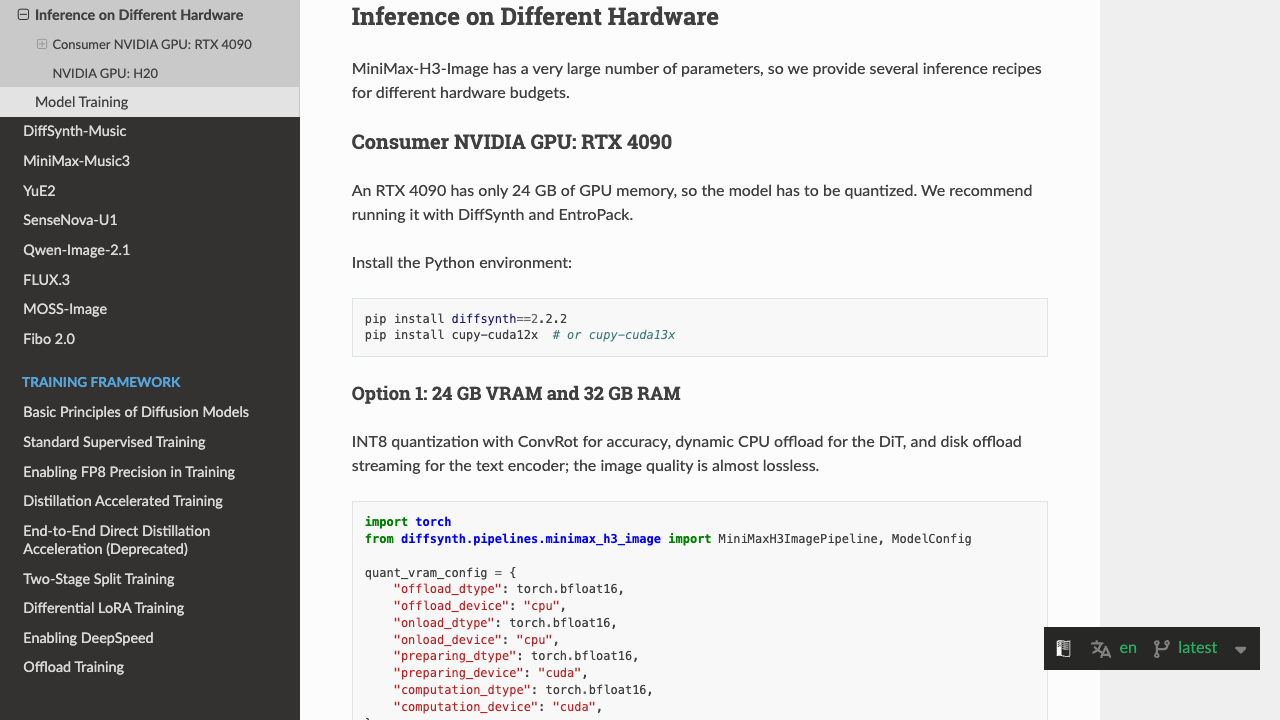
面向RTX 4090的章节进一步区分了两类配方。24GB显存加32GB RAM方案使用INT8量化与ConvRot,并结合DiT的动态CPU卸载和文本编码器的磁盘流式加载;24GB显存加8GB RAM方案使用平均每参数约3bit的混合量化,并且不使用卸载。两者的数据存放方式与量化配置不同,不是只改一个显存上限参数就可互换。
准备24GB推理示例所用的依赖
以下安装命令来自文档的消费级NVIDIA GPU配方,适用于已有兼容CUDA和PyTorch的Python环境。示例固定使用diffsynth 2.2.2,并为CUDA 12选择cupy-cuda12x;文档同时列出CUDA 13对应的cupy-cuda13x选择,实际包应与环境匹配,不应把两个包同时作为必需项安装。
pip install diffsynth==2.2.2
pip install cupy-cuda12x  # or cupy-cuda13x
这里的2.2.2是该篇文档给出的安装配方版本,不是MiniMax-H3-Image此次README更新宣布的新框架版本。依赖安装完成也不等于模型文件已经齐全,更不证明特定GPU上的生成结果已经通过验证。
24GB显存加8GB RAM示例如何指定模型文件
下面是文档Option 2的完整推理代码,前提是按该配方准备兼容环境、足够的模型存储空间和下载访问条件。它显式选用EntroPack的混合量化Transformer、量化文本编码器和VAE,并指定处理器及输出头;首次加载可能获取相关模型文件,因此应在计划运行前确认存储与网络条件。
import torch
from diffsynth.pipelines.minimax_h3_image import MiniMaxH3ImagePipeline, ModelConfig

pipe = MiniMaxH3ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",
    model_configs=[
        ModelConfig(
            model_id="DiffSynth-Studio/MiniMax-H3-Image-EntroPack",
            origin_file_pattern="models/dit_extreme_3bpp.safetensors",
            origin_config_file="models/dit_extreme_3bpp.json",
        ),
        ModelConfig(
            model_id="DiffSynth-Studio/EntroPackPreQuants",
            origin_file_pattern="models/MiniMax-H3/text_encoder_3bpp.safetensors",
            origin_config_file="models/MiniMax-H3/text_encoder_3bpp.json",
        ),
        ModelConfig(
            model_id="MiniMax/MiniMax-H3-Image",
            origin_file_pattern="pdd_fused_heads.safetensors",
        ),
        ModelConfig(
            model_id="DiffSynth-Studio/MiniMax-H3-Image-EntroPack",
            origin_file_pattern="models/vae_int8.safetensors",
        ),
    ],
    processor_config=ModelConfig(model_id="MiniMax/MiniMax-H3-Image", origin_file_pattern="processor/"),
)
prompt = "A cat is sitting on the table. A book is on the table."
image = pipe(prompt=prompt, height=4096, width=4096, seed=42)
image.save("MiniMax-H3-Image-Pruned-EntroPack.jpg")
代码的预期操作是用给定英文提示词生成4096×4096图片,保存为MiniMax-H3-Image-Pruned-EntroPack.jpg。它不是文本到图像之外的完整训练脚本,也没有承诺与未量化权重在所有内容上完全一致。输出文件名和尺寸来自该示例配置,不是每种硬件、每个任务都必须采用的统一设置。
训练为什么要单独理解两阶段流程
模型训练章节同时提供全量微调与LoRA微调。文档说明33.1B Transformer在bfloat16下约占66.3GB,文本编码器另需约66.7GB,因此训练采用两阶段:第一阶段执行数据预处理,缓存提示词嵌入与VAE latents,同时将Transformer卸载到磁盘;第二阶段使用缓存数据训练,将文本编码器和VAE卸载到磁盘。
这种安排避免训练过程中所有大组件同时驻留于同一加速器,但不构成24GB GPU加8GB RAM能完成任意训练任务的保证。推理表格中的显存和RAM组合只对应各自推理配方;训练的分辨率、可训练参数、缓存数据、梯度检查点和卸载配置仍需按训练脚本分别考虑。
文档中的LoRA示例使用rank 32,并通过空的lora_target_modules让框架选择目标模块。这个训练配置与前面的推理模型文件选择是不同层次,不能把推理脚本改一个输出目录就当成LoRA训练,也不能把文档入口里的“training”概括成所有小显存设备都能无条件训练。
这次README变化应怎样界定
MiniMax-H3-Image的不可变README变更8ced60068623def5b74b4d10558117cb61d6482d新增了DiffSynth-Studio推荐及相应推理、训练文档入口。它为选择接入路径提供了新的官方导航,没有在这项变更中发布新模型权重,也没有给推荐条目标注一个DiffSynth-Studio发行版本。
实际使用价值在于按硬件预算找到对应配方,并分清常规加载、量化推理和训练工作流。配置选择应沿着具体示例的前提进行,不能仅凭“低显存”三个字推导所有任务都能运行,或把文档中的硬件结果当成任意本机环境的实测保证。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









