

原生驱动还是SQLAlchemy?Python数据库连接方式对比与选择
深入对比Python原生数据库驱动与SQLAlchemy在架构分层、开发效率、执行性能、连接池管理及可维护性上的差异,提供清晰的技术选型决策树与实践建议。
一、架构分层与工作机制对比
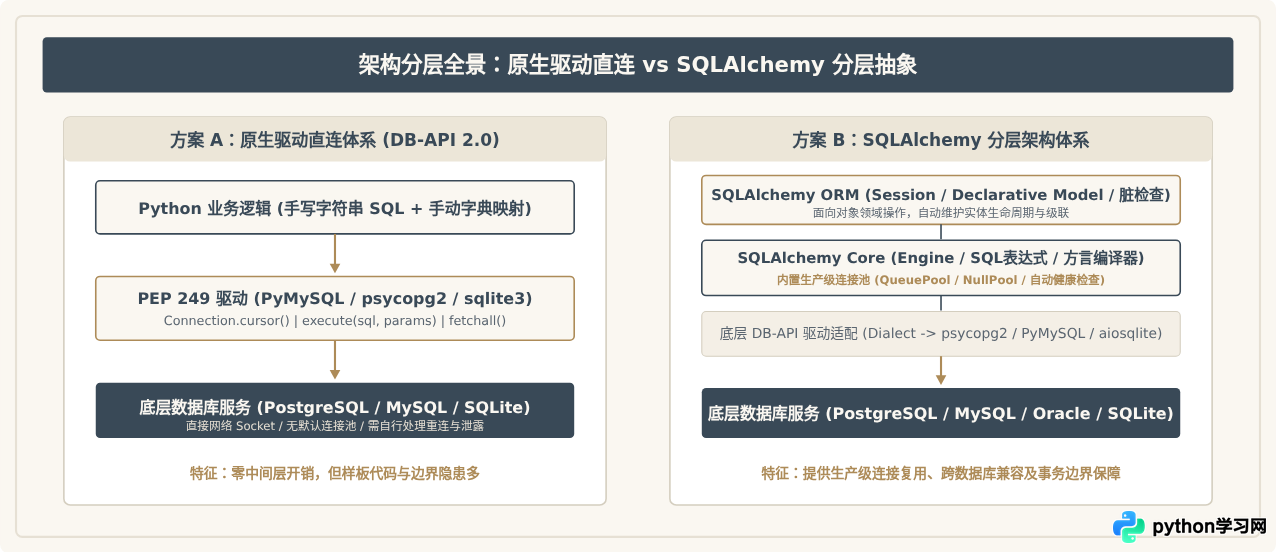
Python生态中的数据库交互标准是PEP 249(Python Database API Specification v2.0,简称DB-API 2.0)。原生驱动(例如针对PostgreSQL的psycopg2、针对MySQL的PyMySQL或内置的sqlite3)直接实现了这一规范,通过TCP套接字或本地进程与数据库引擎通信。
SQLAlchemy并不是底层驱动的替代者,而是构建在DB-API驱动之上的高级抽象工具集。它分为清晰的两个层次:SQLAlchemy Core(提供连接池、方言翻译和SQL表达式构建)以及SQLAlchemy ORM(提供对象关系映射、工作单元Unit of Work及状态机跟踪)。理解这一分层是正确评估两者差异的前提。
二、核心操作工作流与代码实现对比
为了具体展现两者在日常开发中的体验差异,我们以常见的“用户表更新余额并记录流水”业务为例。这一过程涉及数据查询、模型修改、参数化绑定以及事务管理。
1. 原生驱动模式:完全显式的手动管理
使用原生驱动时,开发者必须全权负责连接获取、游标创建、手写SQL字符串拼接(必须防注入)、字典结果转换以及显式的commit()与rollback()异常捕获:
import sqlite3

def transfer_funds_raw(sender_id: int, receiver_id: int, amount: float):
    # 1. 建立物理连接(无默认连接池)
    conn = sqlite3.connect("app.db")
    conn.row_factory = sqlite3.Row  # 开启行字段映射
    cursor = conn.cursor()
    try:
        # 2. 查询出账账户并显式参数化传参
        cursor.execute("SELECT balance FROM accounts WHERE id = ?", (sender_id,))
        row = cursor.fetchone()
        if not row or row["balance"] < amount:
            raise ValueError("账户余额不足或账户不存在")

        # 3. 执行扣减与增加(手写SQL语句)
        cursor.execute("UPDATE accounts SET balance = balance - ? WHERE id = ?", (amount, sender_id))
        cursor.execute("UPDATE accounts SET balance = balance + ? WHERE id = ?", (amount, receiver_id))
        cursor.execute("INSERT INTO audit_logs (sender, receiver, amount) VALUES (?, ?, ?)",
                       (sender_id, receiver_id, amount))

        # 4. 手动提交事务
        conn.commit()
    except Exception as exc:
        conn.rollback()  # 发生错误必须手动回滚
        raise exc
    finally:
        cursor.close()
        conn.close()     # 必须显式关闭以防连接泄露
2. SQLAlchemy 2.0 现代风格:类型安全与自动化事务上下文
在SQLAlchemy 2.0+标准中,借助mapped_column声明式实体与上下文管理器,连接池管理、参数绑定及事务提交均已实现标准化封装:
from sqlalchemy import create_engine, select, String, Numeric
    from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, Session

    # 1. 初始化引擎(自动绑定连接池)
    engine = create_engine("sqlite:///app.db", echo=False, pool_size=5)

    class Base(DeclarativeBase):
        pass

    class Account(Base):
        __tablename__ = "accounts"
        id: Mapped[int] = mapped_column(primary_key=True)
        balance: Mapped[float] = mapped_column(Numeric(10, 2))

    def transfer_funds_orm(sender_id: int, receiver_id: int, amount: float):
        # 2. Session 上下文管理器自动掌管连接归还与事务生命周期
        with Session(engine) as session:
            with session.begin(): # 开启原子事务,退出块时自动 commit,抛异常自动 rollback
                sender = session.scalar(select(Account).where(Account.id == sender_id))
                receiver = session.scalar(select(Account).where(Account.id == receiver_id))

                if not sender or sender.balance < amount:
                    raise ValueError("账户余额不足或账户不存在")

                # 3. 面向对象属性修改,ORM脏检查自动生成精确 UPDATE
                sender.balance -= amount
                receiver.balance += amount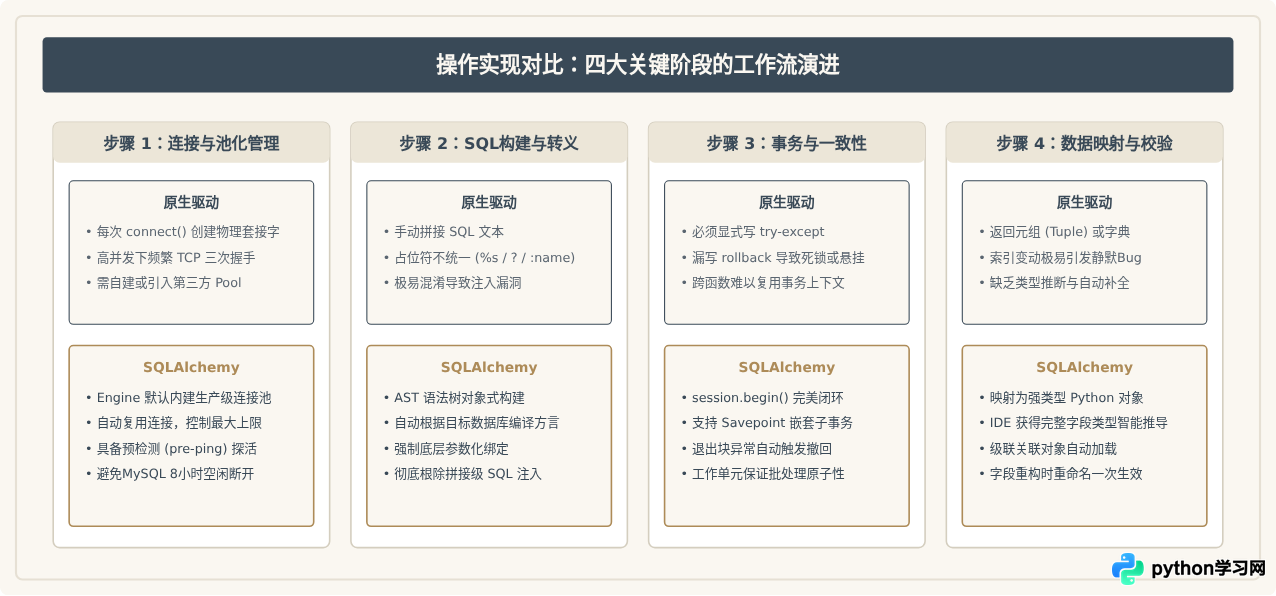
三、全方位技术维度深入对比
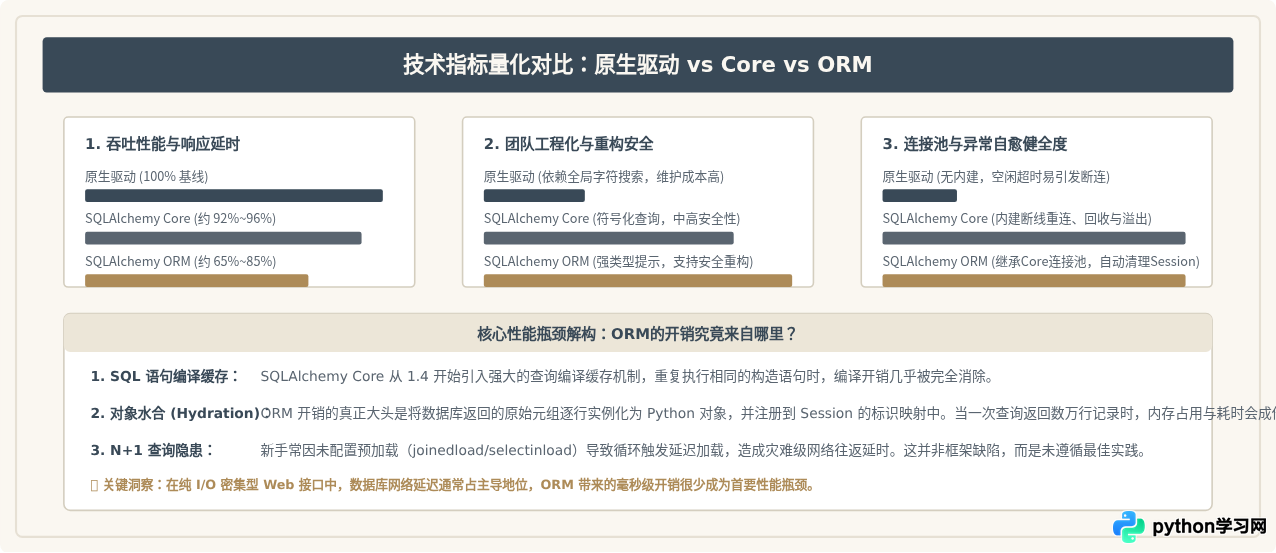
为了避免片面化评价,我们需要从执行性能开销、开发维护成本、复杂查询灵活性、多数据库迁移以及团队工程化规范五个维度进行客观度量。
| 评估维度 | 原生驱动(DB-API 2.0) | SQLAlchemy Core | SQLAlchemy ORM |
|---|---|---|---|
| 性能损耗与内存 | 极低(直接C扩展/纯Python序列化) | 轻微(仅编译SQL与结果包装,约3%~8%损耗) | 中等(需维护Identity Map与对象生命周期,约15%~35%损耗) |
| 连接池机制 | 无内置(每次全新连接或需外挂连接池) | 内建QueuePool/NullPool,自动探活 | 继承Core的连接池支持 |
| SQL防注入保障 | 依赖开发者自律(占位符绑定) | 框架强制参数化编译,杜绝拼接漏洞 | 框架强制参数化编译,杜绝拼接漏洞 |
| 复杂报表与多表关联 | 极高(只要SQL引擎支持即可编写) | 极高(函数化组装动态复杂SQL,极易复用) | 中等(过于复杂的聚合多表需退化为Core或Text) |
| 团队协同与重构成本 | 高(表字段重命名需全局查找字符串替换) | 低(引用Python符号,重构工具可静态感知) | 极低(定义于单一实体类,重命名全局安全) |
| Schema版本迁移 | 缺乏官方集成,多需手写脚本 | 完美支持 Alembic 自动化生成DDL | 完美支持 Alembic 根据模型Diff自动推导迁移 |
四、选型决策指南与落地实践路径
技术选型从来不是非黑即白的单选题。在实际工业界项目中,往往不是“只能二选一”,而是建立以清晰边界为准则的落地规范。根据项目的生命周期、数据规模与业务场景,我们梳理出以下决策路径:
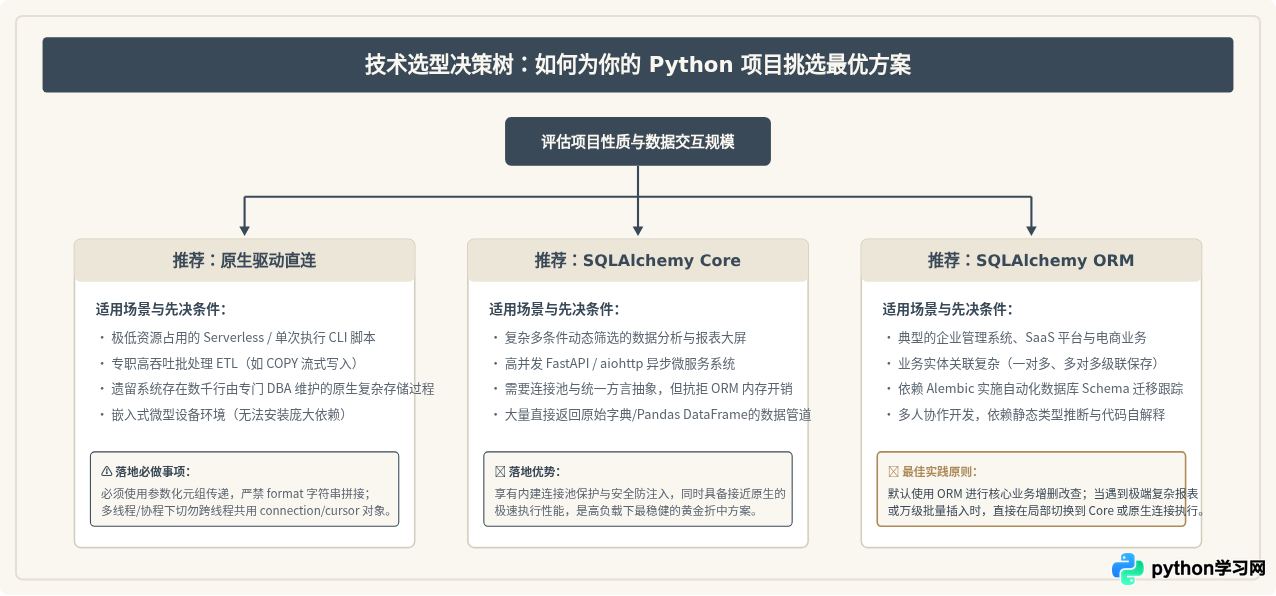
五、工程化落地中的核心避坑指南
在生产部署中,数据库中间件或防火墙通常会在连接闲置超过一定时间(如8小时或300秒)时单方面关闭套接字。原生驱动无法感知这一状态,在下次查询时会直接抛出连接已断开异常。
如果使用SQLAlchemy,强烈建议在create_engine中开启探活配置:
engine = create_engine(
    "mysql+pymysql://user:password@host/db",
    pool_size=10,
    max_overflow=20,
    pool_recycle=3600,   # 每1小时主动替换连接,避免被服务器掐断
    pool_pre_ping=True   # 每次从连接池借出连接时,先执行轻量级 ping 验证连通性
)
当面对数万行数据的插入或同步任务时,如果依然使用ORM的session.add(Model(...)),因每个实例都需要注册对象状态与检查自增主键,耗时通常比原生驱动慢5~10倍。此时切勿推翻整个ORM架构,只需使用SQLAlchemy提供的批量操作API或直接调用底层连接:
# 方案:通过 Core 的 insert() 结合 values 列表进行单次批量插入
with engine.begin() as conn:
    conn.execute(
        Account.__table__.insert(),
        [{"id": i, "balance": 100.0} for i in range(10000)]
    )
这种混合编写方式既保留了全局统一的连接池与表结构定义,又完全获得了与原生驱动相同的批处理性能。
六、总结
在Python数据库连接的技术演进中,原生驱动与SQLAlchemy并不是相互替代的对立关系,而是“基础零件”与“完整工业底盘”的分工:
- 原生驱动是掌握数据库底层的利器,轻巧、直接且透明,适合用于执行简单任务、编写极致低延迟数据通道或开发专用中间件;
- SQLAlchemy Core是平衡安全性、可编程性与运行性能的高效工具,非常契合需要连接池治理和动态SQL组装的数据密集型微服务;
- SQLAlchemy ORM则是应对复杂业务领域模型、保障多人团队开发规范以及配合自动化迁移工具(Alembic)的最佳长效选择。
理清实际工程所处的生命周期与性能瓶颈所在,让ORM掌管业务流转,让Core与原生驱动攻克局部高负载与复杂报表,才是构建高鲁棒性Python数据底座的成熟路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









