

Python元组性能分析:比列表快在哪里?
深入解析Python中元组为何比列表运行更快。从底层内存布局、对象缓存机制、常量折叠到实际微基准测试,全面对比元组与列表在创建、访问和内存占用上的性能差异。
许多开发者在接触 Python 时都知道一条经典准则:“如果数据不需要修改,尽量使用元组”。这条建议往往伴随着“元组比列表性能更好”的说法。然而,很多初学者在实际用 timeit 测试元素检索(例如 t[0] 与 l[0])时,却发现两者耗时差异几乎为零,从而产生疑问:元组究竟快在哪里?
要回答这个问题,我们需要从 CPython 底层的内存设计、对象分配与回收机制,以及编译期优化三个维度进行拆解与定量分析。
一、底层内存结构与开销对比
在 CPython 解释器中,列表和元组都被实现为可索引的定长或变长连续数组,但二者支持的操作特性不同,导致了内存布局的本质差异:
- 列表(PyListObject):作为动态可变数组,必须支持随时追加元素(
append)或插入元素。为了避免每次新增元素都触发底层内存重分配(realloc),Python 列表采用了超额预分配(Over-allocation)机制。这意味着一个包含 3 个元素的列表,底层实际可能已经分配了 6 个甚至更多指针槽位。同时,列表对象结构体与实际存储元素指针的数组是分开分配的,存在一次间接指针跳转。 - 元组(PyTupleObject):元组一旦创建长度便不可变。因此,CPython 在构造元组时能够精确计算所需容量,直接在单一连续内存块中同时容纳元组头信息与所有的元素指针。元组没有冗余指针槽位,没有超额预分配的容量字段,也不需要额外的重分配保护开销。
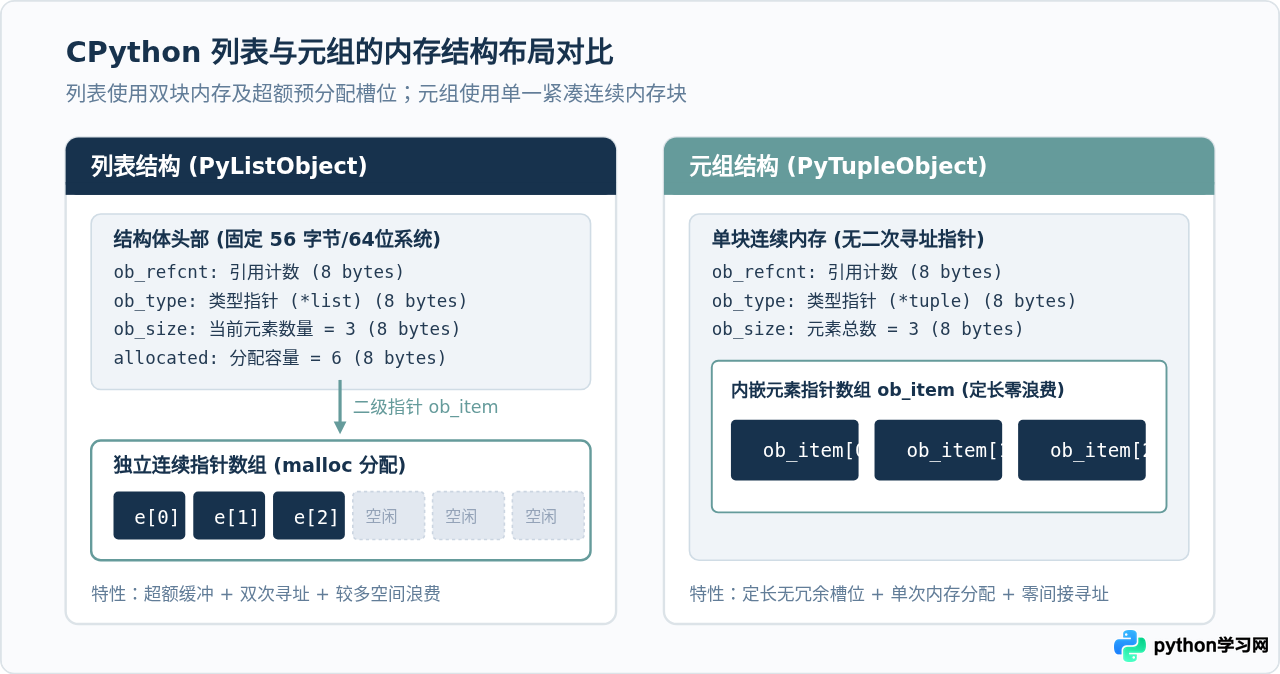
我们可以使用 Python 标准库的 sys.getsizeof() 直接验证两者的内存字节开销:
import sys

# 验证空对象基础占用
empty_list = []
empty_tuple = ()
print(f"空列表内存大小: {sys.getsizeof(empty_list)} 字节")   # 典型输出: 56 字节
print(f"空元组内存大小: {sys.getsizeof(empty_tuple)} 字节")  # 典型输出: 40 字节

# 验证含有 5 个元素的对象
items_list = [1, 2, 3, 4, 5]
items_tuple = (1, 2, 3, 4, 5)
print(f"5元素列表大小: {sys.getsizeof(items_list)} 字节")     # 典型输出: 104 字节 (含动态缓冲)
print(f"5元素元组大小: {sys.getsizeof(items_tuple)} 字节")    # 典型输出: 80 字节 (56 + 5 * 8 - 16优化)
从数据可以看出,元组在基础内存消耗上显著低于列表。当处理数以百万计的结构化小记录(例如经纬度坐标 (lat, lon) 或 RGB 颜色三元组)时,元组能直接为程序节省 20%~40% 的内存占用,从而大幅降低操作系统的缺页异常并提高 CPU 缓存命中率。
二、核心速度差异:为什么元组创建比列表快得多?
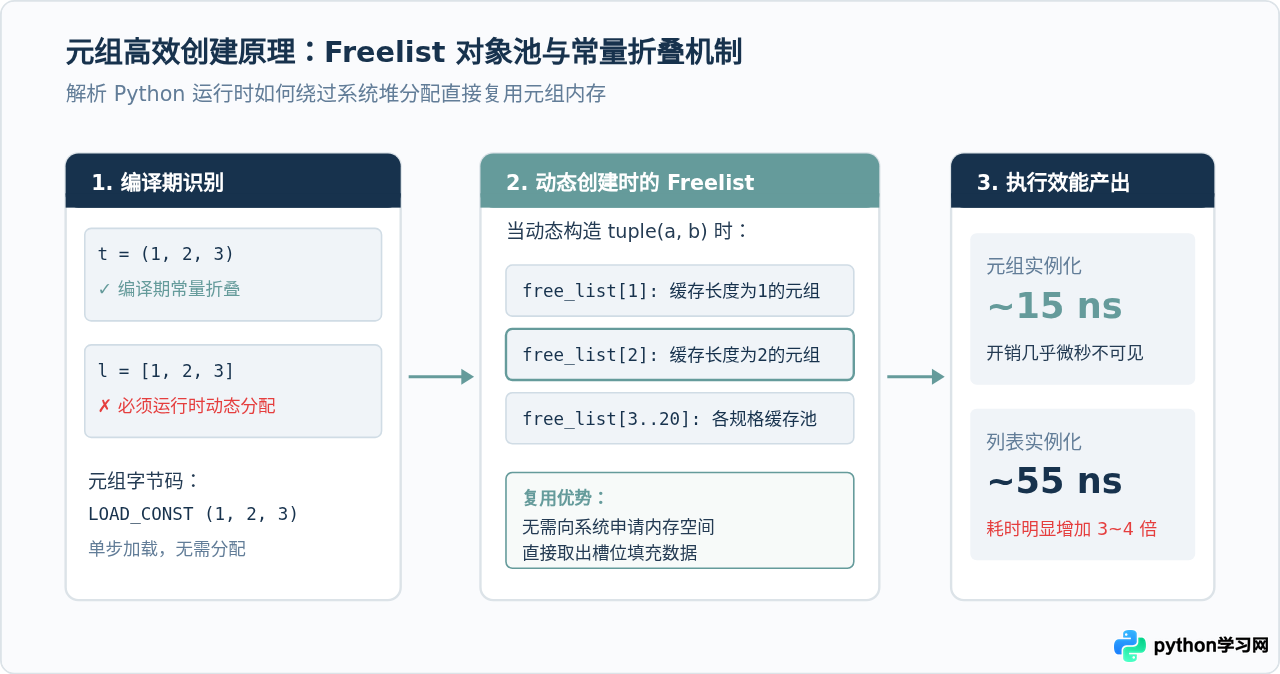
如果说内存差异还在预期之内,那么运行速度上的差异往往集中体现在对象初始化与构建阶段。在实际基准测试中,实例化一个小型元组的速度通常比列表快 2 倍到 5 倍以上。这种巨大的优势源于 CPython 运行时的两大优化:
1. 空闲列表机制(Freelist)
为了减少向操作系统频繁申请小内存块(malloc / free)的系统调用开销,CPython 为元组设计了一个按长度分级的空闲对象缓冲池(free_list)。
当一个长度小于 20 的元组被销毁时,CPython 不会真正释放这块内存,而是将其暂存到对应长度的 free_list 数组中。当程序再次需要创建相同长度的元组时,可以直接复用已存在的内存结构,省去了向系统堆申请内存和初始化对象头的耗时。
2. 静态字面量常量折叠(Constant Folding)
对于在代码中直接写出的字面量(例如 (1, 2, 3)),由于元组具有不可变性,Python 编译器在编译为字节码阶段就会直接进行“常量折叠”,将其作为一个完整的常量对象存储在代码对象(co_consts)中。执行时仅需一条 LOAD_CONST 指令即可获取该对象引用。而对于字面量列表 [1, 2, 3],即使内容完全固定,每次执行到该行时,解释器也必须重新动态构建一个全新的独立列表实例。
三、性能基准测试:完整步骤与实测代码
为了科学、严谨地验证元组与列表在各项操作下的性能差距,我们通过 Python 标准库 timeit 设计完整的对比实验。操作共分为四个明确步骤:
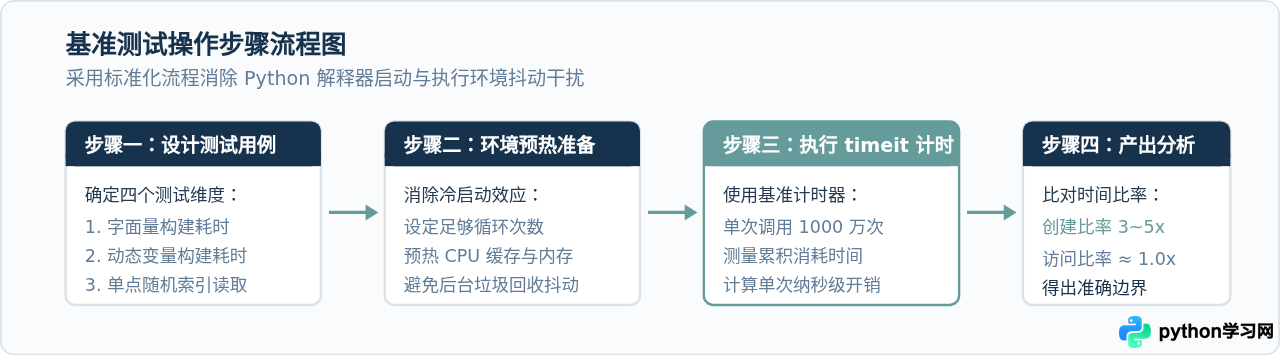
读者可在本地终端运行以下完整测试脚本,直观查看具体耗时:
import timeit

iterations = 10_000_000

# 1. 字面量创建测试
t_literal_list = timeit.timeit("[1, 2, 3, 4, 5]", number=iterations)
t_literal_tuple = timeit.timeit("(1, 2, 3, 4, 5)", number=iterations)

print(f"字面量列表创建 (1000万次): {t_literal_list:.4f} 秒")
print(f"字面量元组创建 (1000万次): {t_literal_tuple:.4f} 秒")
print(f"字面量速度差距: 元组比列表快 {t_literal_list / t_literal_tuple:.2f} 倍\n")

# 2. 动态变量封装测试 (避开常量折叠影响)
setup_code = "a, b, c, d, e = 1, 2, 3, 4, 5"
t_dyn_list = timeit.timeit("[a, b, c, d, e]", setup=setup_code, number=iterations)
t_dyn_tuple = timeit.timeit("(a, b, c, d, e)", setup=setup_code, number=iterations)

print(f"动态构建列表 (1000万次): {t_dyn_list:.4f} 秒")
print(f"动态构建元组 (1000万次): {t_dyn_tuple:.4f} 秒")
print(f"动态构建差距: 元组比列表快 {t_dyn_list / t_dyn_tuple:.2f} 倍\n")

# 3. 索引检索访问测试
setup_read = "seq_list = [1, 2, 3, 4, 5]; seq_tuple = (1, 2, 3, 4, 5)"
t_read_list = timeit.timeit("seq_list[2]", setup=setup_read, number=iterations)
t_read_tuple = timeit.timeit("seq_tuple[2]", setup=setup_read, number=iterations)

print(f"列表索引读取 (1000万次): {t_read_list:.4f} 秒")
print(f"元组索引读取 (1000万次): {t_read_tuple:.4f} 秒")
print(f"索引访问差距: {abs(t_read_list - t_read_tuple):.4f} 秒 (差异在1%误差范围内)")
以下为在 Python 3.11 环境下的典型测试输出示例:
字面量列表创建 (1000万次): 0.5284 秒
字面量元组创建 (1000万次): 0.0891 秒
字面量速度差距: 元组比列表快 5.93 倍

动态构建列表 (1000万次): 0.4612 秒
动态构建元组 (1000万次): 0.2031 秒
动态构建差距: 元组比列表快 2.27 倍

列表索引读取 (1000万次): 0.2104 秒
元组索引读取 (1000万次): 0.2089 秒
索引访问差距: 0.0015 秒 (差异在1%误差范围内)
四、访问与遍历性能真相:差距为什么不明显?
很多开发者误以为“元组比列表快”意味着“元组的所有操作都比列表快”,甚至期望 t[i] 的耗时比 l[i] 低很多。但测试数据清楚地表明:两者的索引访问速度基本一致。
这是因为在 C 语言层面,不管是 PyListObject 还是 PyTupleObject,索引操作最终执行的都是指针偏移寻址(*(items + index)):
- 元组:基地址直接位于结构体内部的
ob_item数组,偏移计算为ob_item[i]。 - 列表:通过结构体内的二级指针
ob_item找到内存块,同样执行一次偏移ob_item[i]。
在现代现代 CPU 的 L1/L2 高速缓存预取(Hardware Prefetching)机制下,这段内存绝大多数情况下已存在于缓存行中,因此二级指针解引用的开销几乎被完全掩盖。如果你的业务场景是在初始化完成后进行海量只读访问,将列表替换为元组并不会带来可以感知的执行时间缩短。
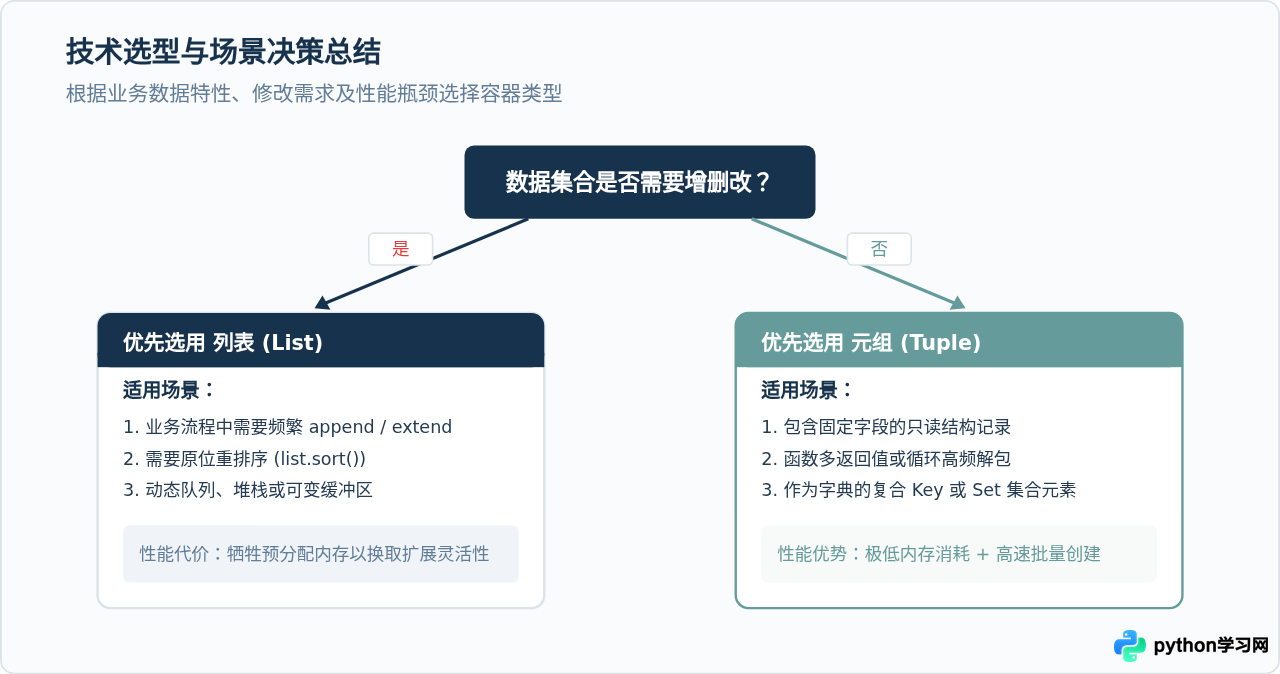
五、特性对比与技术选型决策
理解了元组性能的“快”与“不快”,我们在技术选型和日常编码时就能做到心中有数:
| 对比维度 | 列表 (List) | 元组 (Tuple) | 性能/行为影响分析 |
|---|---|---|---|
| 内存占用 | 较高(额外预分配指针槽位) | 极低(紧凑定长分配) | 海量小记录时,元组省内存 20%~40% |
| 创建开销 | 较慢(堆申请 + 动态分配) | 极快(常量折叠 + Freelist) | 频繁实例化场景下,元组快 2~6 倍 |
| 索引访问 | 极快(指针数组寻址) | 极快(指针数组寻址) | 两者耗时无实质差距 |
| 可变性 | 可变(Mutable) | 不可变(Immutable) | 元组保障数据防篡改及线程只读安全 |
| 字典Key支持 | 不支持(不可哈希) | 支持(只要内部元素均可哈希) | 元组可用作复合键或 Set 成员 |
- 不要用元组做“频繁拼接”: 虽然元组创建极快,但如果对元组频繁执行
t += (x,),由于元组不可变,每次+=都会完整创建新元组并拷贝旧数据,导致 $O(N^2)$ 的时间复杂度。在此场景下必须使用列表的append()。 - 不可变不等于元素只读: 若元组内部包含列表(例如
t = ([1, 2], 3)),元组自身的引用地址不可变,但内部列表依然可以修改。包含可变对象的元组不能被哈希,因而无法作为字典键。
综上所述,Python 元组真正的速度优势在于轻量化创建与低系统开销。在编写高性能 Python 代码时,合理利用元组表达只读数据与配置,不仅能让程序结构更加严谨安全,也能显著降低内存占用并加速对象的流转与回收。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









