

Python字典推导式怎么用:快速构建字典的技巧
详细讲解Python字典推导式的基本语法、条件筛选、键值反转、双列表合并及常见应用技巧,配有清晰的流程图与对比总结,帮助读者快速掌握高效构建字典的方法。
如果你经常需要把一个列表转换为字典、提取复杂字典中的子集,或者将已有的键值关系反转,在传统写法中往往需要先创建一个空字典 {},再通过 for 循环配合 dict[key] = value 逐条填充。Python 提供的字典推导式(Dictionary Comprehension)则允许我们用单行具备表达力的语法声明式地完成这一转换,不仅代码更简洁紧凑,执行速度往往也比常规显式循环更快。本文将具体介绍字典推导式的基本结构、条件筛选、多数据源组合等核心技巧,以及在日常开发中需要注意的边界情况。
字典推导式的核心语法与执行逻辑
字典推导式使用花括号 {} 包裹,其内部核心是一对以冒号隔开的 key_expr: value_expr,紧接着是一个或多个 for 子句。其基本语法结构如下:
{key_expr: value_expr for item in iterable}当 Python 执行这段语句时,会首先遍历可迭代对象 iterable,在每次迭代中将元素绑定到变量 item,然后分别计算 key_expr 和 value_expr,并将计算得到的键值对插入到新创建的字典中返回。下面是一个将数字列表映射为“数值与对应平方”的简单示例:
numbers = [1, 2, 3, 4, 5]

# 使用字典推导式计算平方
square_dict = {n: n ** 2 for n in numbers}

# 示例输出: {1: 1, 2: 4, 3: 9, 4: 16, 5: 25}
print(square_dict)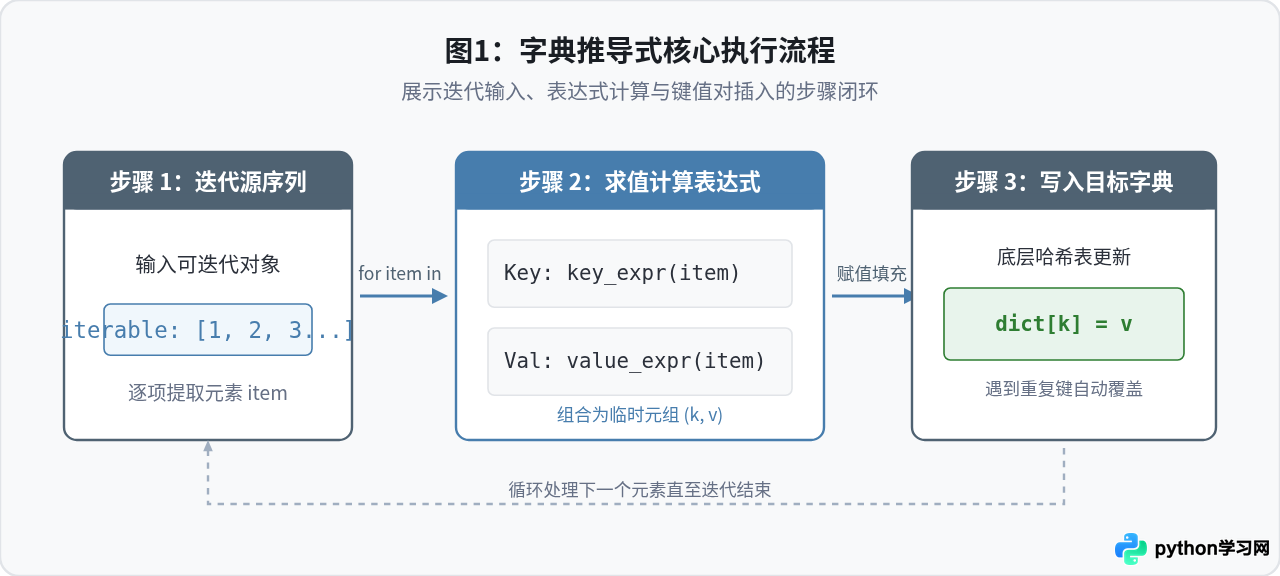
技巧一:结合 if 条件过滤无用数据
在构建字典时,我们常常需要根据特定规则排除不满足条件的数据项。推导式允许在 for 子句后直接追加 if 条件判定。只有当条件表达式为 True 时,对应的键值对才会写入新字典中。
例如,我们有一个记录商品及其库存数量的原始字典,现在需要筛选出库存数量大于 0 的有效商品:
inventory = {
    "apple": 15,
    "banana": 0,
    "orange": 8,
    "peach": 0,
    "grape": 22
}

# 过滤库存为0的商品
available_goods = {name: count for name, count in inventory.items() if count > 0}

# 示例输出: {'apple': 15, 'orange': 8, 'grape': 22}
print(available_goods)注意区分:放在 for 后面的 if 用于过滤数据项(不满足条件则直接丢弃);如果希望在条件不满足时提供默认值或改变赋值,需要使用条件表达式(三元运算符)放在 value_expr 中,形式为 {k: (v if cond else default_val) for k, v in items}。
技巧二:使用 zip() 快速合并双列表为字典
在处理表格导出、数据库查询或 CSV 解析结果时,列名(键)和记录行(值)往往分别存储在两个平行的列表或元组中。通过内置函数 zip() 与字典推导式配合,可以快速完成配对转换:
fields = ["user_id", "username", "role", "is_active"]
values = [1001, "alice", "admin", True]

# 合并两组独立数据为完整字典
user_profile = {field: val for field, val in zip(fields, values)}

# 示例输出: {'user_id': 1001, 'username': 'alice', 'role': 'admin', 'is_active': True}
print(user_profile)
如果在合并过程中还需要针对某些字段进行数据清洗或格式转换(例如去除字段首尾空格、统一小写),在推导式的 key_expr 或 value_expr 中直接添加处理函数即可:
raw_keys = [" NAME ", " AGE ", " EMAIL "]
raw_vals = ["Bob ", " 28", " BOB@EXAMPLE.COM "]

clean_data = {
    k.strip().lower(): v.strip().lower()
    for k, v in zip(raw_keys, raw_vals)
}
# 示例输出: {'name': 'bob', 'age': '28', 'email': 'bob@example.com'}
print(clean_data)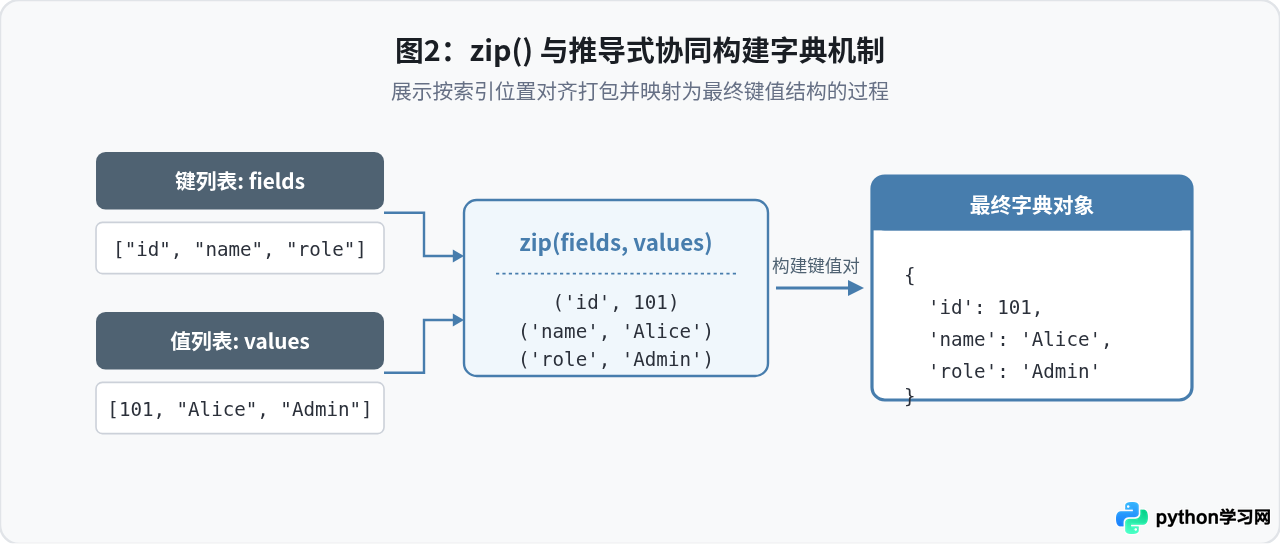
技巧三:反转字典中的键与值
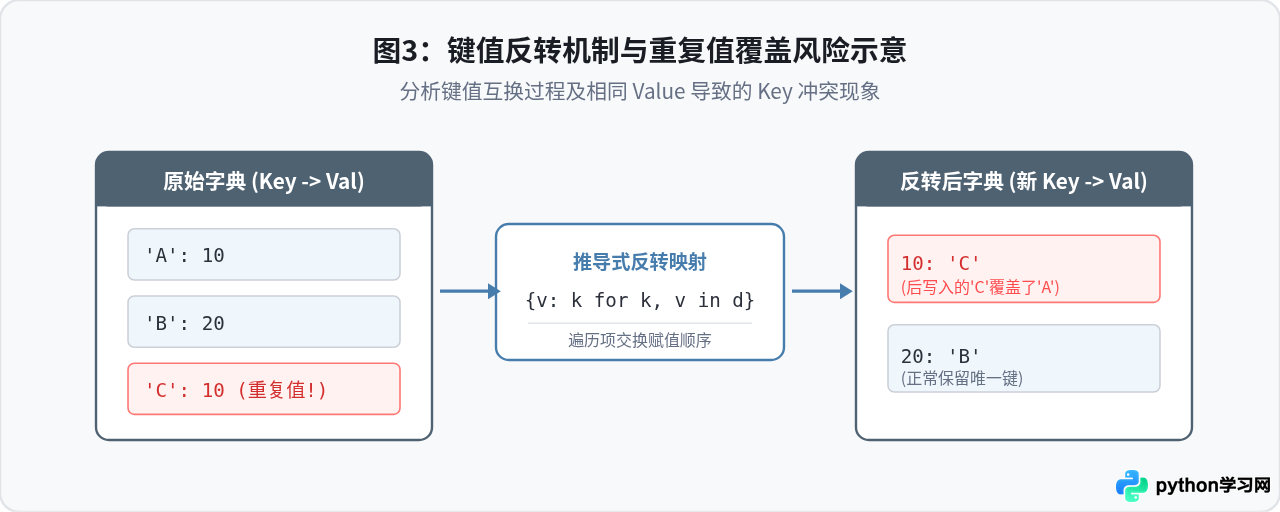
在日常业务中,我们有时需要把“员工编号 -> 姓名”的映射转成“姓名 -> 员工编号”以便根据姓名反查;或者把状态码对应状态名进行调转。通过遍历 dict.items() 并调换推导式中的键值位置,一行代码即可实现反转:
code_to_status = {
    200: "OK",
    404: "Not Found",
    500: "Internal Error"
}

# 调换键与值的位置
status_to_code = {status: code for code, status in code_to_status.items()}

# 示例输出: {'OK': 200, 'Not Found': 404, 'Internal Error': 500}
print(status_to_code)
防坑警示:值必须具备可哈希性且唯一。 字典的键(Key)必须是不可变且可哈希的类型(如整数、字符串、元组)。如果原字典的值是列表、集合或其他字典,直接反转会抛出 TypeError: unhashable type 异常。另外,若原字典存在重复的值,反转后后面的键会直接覆盖前面的键,导致数据丢失。
技巧四:提取复杂嵌套数据或对象列表的字段
在实际工程中,后端接口经常返回包含多个字典的对象列表。如果我们希望按某个唯一标识字段(例如 id 或 uuid)建立快速检索索引,使用推导式是最惯用的方式:
user_list = [
    {"id": 101, "name": "Tom", "dept": "Engineering"},
    {"id": 102, "name": "Jerry", "dept": "Marketing"},
    {"id": 103, "name": "Spike", "dept": "Security"}
]

# 按用户ID构建员工速查索引表
user_index = {user["id"]: user for user in user_list}

# 示例输出:
# {
#   101: {'id': 101, 'name': 'Tom', 'dept': 'Engineering'},
#   102: {'id': 102, 'name': 'Jerry', 'dept': 'Marketing'},
#   103: {'id': 103, 'name': 'Spike', 'dept': 'Security'}
# }
print(user_index)
这种做法将原本需要 $O(n)$ 线性遍历搜索的列表查找,直接优化为利用哈希表实现的 $O(1)$ 常数时间按主键定位,在大批量数据高频查询时效果显著。
字典推导式与传统方式的写法对比与选型建议
为了让不同场景下的选择依据更加清晰,我们将常见的字典构建方式做如下对比:
| 场景需求 | 传统 for 循环写法 | 推导式 / 内置写法 | 选型建议 |
|---|---|---|---|
| 简单列表转换或映射 | 4-5 行代码,显式 append/set | {x: f(x) for x in list} |
优先选用字典推导式,代码最清晰且性能高 |
| 纯双列表合并 | 需要维护索引或手动遍历 | dict(zip(k, v)) |
如果无需对数据做二次加工,直接使用 dict(zip()) 更快 |
| 包含过滤逻辑 | 嵌套 if 语句 |
{k: v for ... if cond} |
推荐字典推导式,紧凑表达“提取与过滤”一体化 |
| 多层嵌套/异常处理 | 可写 try-except,逻辑分明 | 推导式嵌套过多变复杂难以阅读 | 改用普通 for 循环,保证代码可读性与健壮性 |
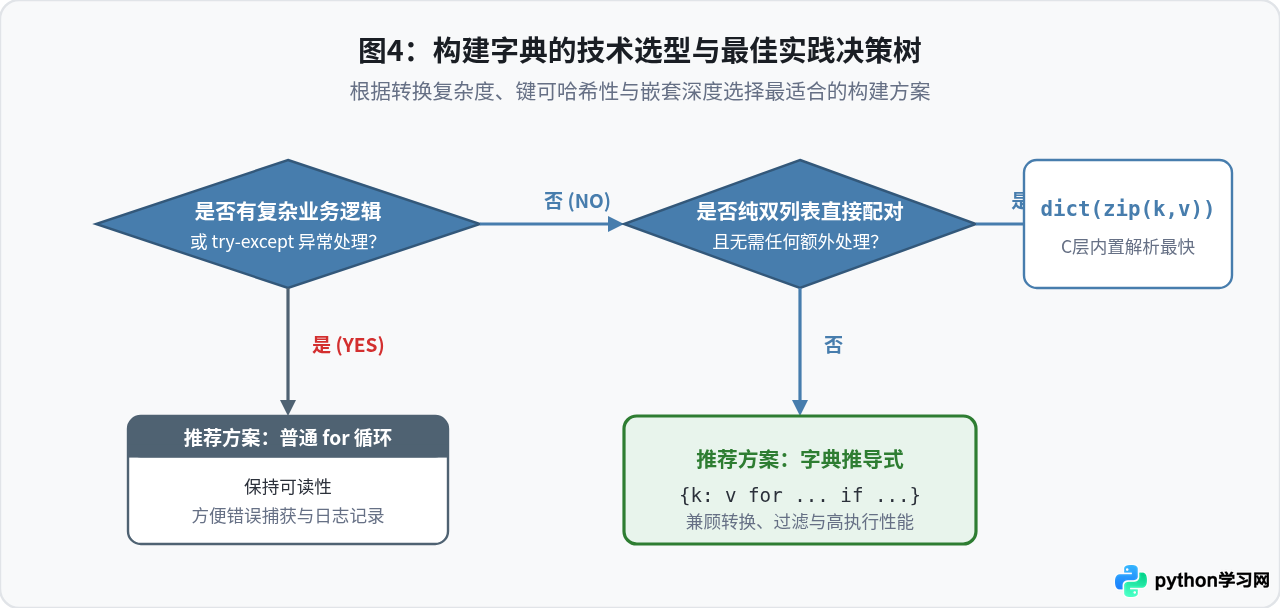
总结与使用准则
字典推导式是 Python 表达力与优雅特性的典型体现。在实际编写代码时,可以牢记以下三条基本准则:
- 单行聚焦:如果推导式在一行或两行换行内能清晰描述映射关系与过滤条件,优先使用推导式。
- 警惕嵌套:尽量避免在同一个字典推导式中嵌套两层以上的
for或复杂的三元运算符。过度紧凑的代码会显著增加团队维护成本。 - 确保键唯一与可哈希:在进行键值对调或由外部动态数据生成键时,时刻防范重复键覆盖及不可哈希类型的运行时错误。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









