

Python numpy.log处理无效值时返回NaN还是报错?
深入解答Python中numpy.log在处理负数和0等无效值时的默认行为:默认返回NaN或-inf并伴随RuntimeWarning警告,而非直接抛出异常;同时介绍如何通过np.seterr配置报错机制及实用的无效值处理方案。
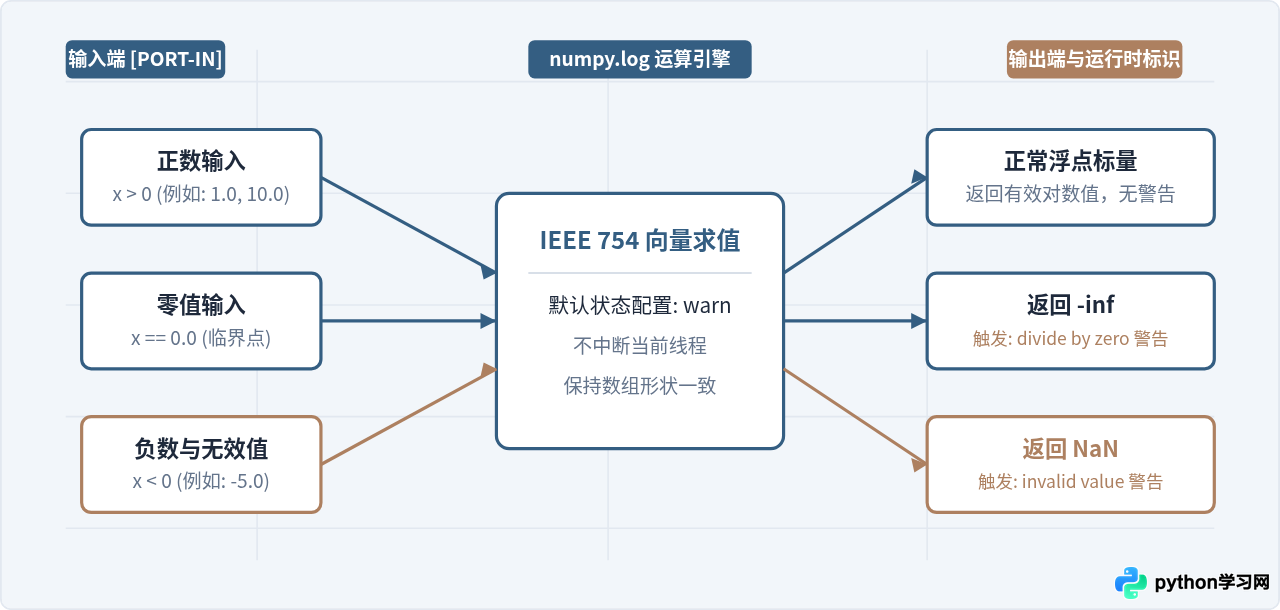
在 Python 中使用 numpy.log 处理无效值(例如负数)时,默认既不会中断程序执行,也不会抛出 Python 异常,而是直接返回 NaN(Not a Number),并在标准错误中打印一条 RuntimeWarning 警告。类似地,对于输入为 0 的数学未定义点,它会返回 -inf(负无穷大)并产生除以零警告。如果你的工程场景必须以异常中断的形式阻止错误数据流入下游,NumPy 提供了专门的错误状态配置接口,可以将这些警告升级为直接抛出报错。
一、默认行为:返回特定数值与触发运行时警告
与 Python 原生标准库中的 math.log(-1) 会直接抛出 ValueError: math domain error 截然不同,NumPy 的设计初衷是支持大规模向量化计算。在大规模矩阵运算中,若因某一个数组元素无效而立即终止整个批次计算,代价通常过高。因此,NumPy 默认遵循 IEEE 754 浮点运算标准,对无效计算采取“填充特殊值并标记警告”的策略:
- 负数输入(如 -1.0):对数函数在实数范围内无定义,NumPy 返回
np.nan,并输出警告RuntimeWarning: invalid value encountered in log。 - 零值输入(0.0):对数函数在趋近于 0 时的极限为负无穷,NumPy 返回
-inf,并输出警告RuntimeWarning: divide by zero encountered in log。 - 原有 NaN 输入:输入本身为
np.nan时,运算直接透传返回np.nan,且通常不会触发新的无效值警告。
二、实操演示:默认代码表现与输出分析
为了直观观察上述机制,我们通过一段典型的测试代码,分别传入包含正数、零和负数的数组:
import numpy as np

# 构建包含常规值、零与负数的混合数组
data = np.array([1.0, np.e, 0.0, -1.0, -5.0])

print("开始执行 np.log 计算...")
result = np.log(data)

print("\n计算结果为:")
print(result)
在默认终端或 Jupyter Notebook 环境中执行此段代码,标准输出与标准错误呈现如下结果(示例输出):
开始执行 np.log 计算...
<stdin>:1: RuntimeWarning: divide by zero encountered in log
<stdin>:1: RuntimeWarning: invalid value encountered in log

计算结果为:
[ 0. 1. -inf nan nan]print(result) 依然能够完整打印出结果数组。数组长度保持为 5,负数位置被精确赋值为 nan,零值位置被赋值为 -inf。
三、如何让 numpy.log 在遇到无效值时主动报错?
在金融计量、生产模型打分或关键参数校验等严谨业务中,静默产生 NaN 可能会导致脏数据扩散到后续的复杂计算链路中。如果你的目标是“一旦出现无效值就立即中断并抛出异常”,可以使用 NumPy 提供的两种配置方式:
1. 全局配置:使用 np.seterr
np.seterr 用于设置整个 Python 进程在遇到浮点运算异常时的行为。支持的错误类型包括 invalid(非数/无效值)、divide(被零除)、over(溢出)和 under(下溢)。
import numpy as np

# 将无效值和除以零的处理策略均设置为 'raise'
old_settings = np.seterr(invalid='raise', divide='raise')

try:
    # 尝试计算含负数的数组
    x = np.array([2.0, -4.0])
    y = np.log(x)
except FloatingPointError as e:
    print(f"成功捕获异常: {e}")
finally:
    # 恢复原有的浮点设置,避免污染其他第三方库或全局行为
    np.seterr(**old_settings)
2. 局部安全配置:使用 np.errstate 上下文管理器
在实际工程代码中,直接调用全局 np.seterr 容易带来副作用(影响同进程内的其他模块)。更推荐使用 np.errstate 上下文管理器,仅在特定代码块内部开启异常拦截,退出代码块后自动还原:
import numpy as np

arr = np.array([10.0, 0.0, -2.0])

# 仅在此代码块内将无效值升级为异常
with np.errstate(invalid='raise', divide='raise'):
    try:
        val = np.log(arr)
    except FloatingPointError as exc:
        print(f"[上下文捕获] 计算由于浮点异常中断: {exc}")

# 退出 with 块后,自动恢复默认的 warn 行为
print("恢复默认行为后的计算:", np.log(np.array([-1.0])))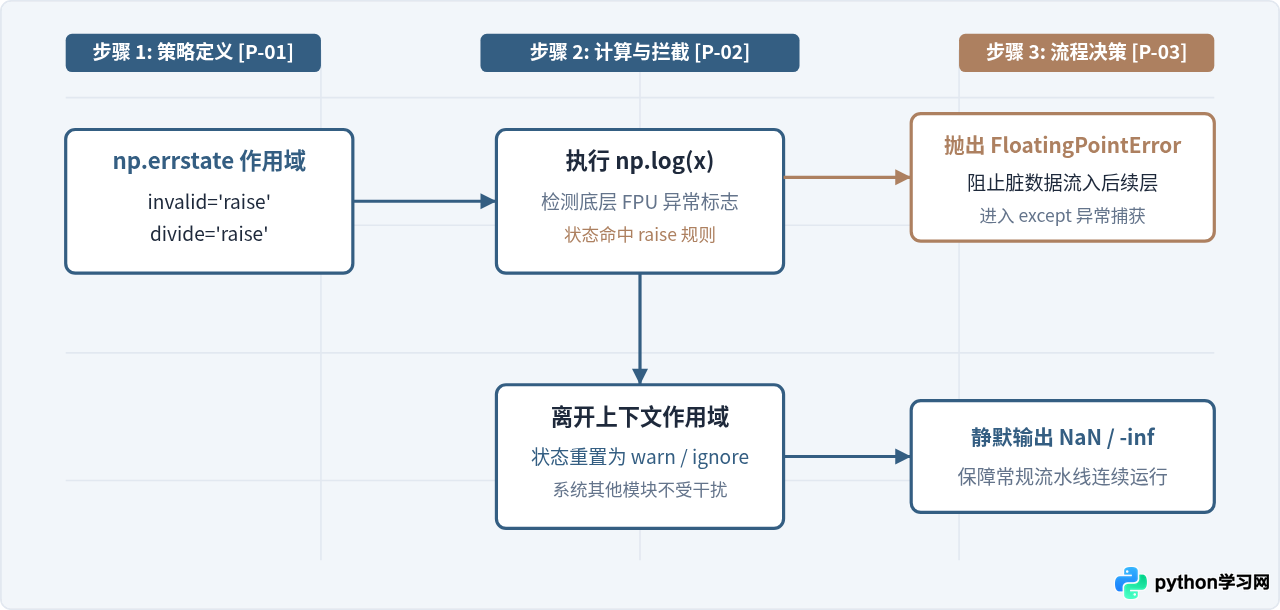
四、工程实战:如何安全预处理与过滤无效值?
在大多数数据处理管道中,既不希望程序无预警崩溃,也不希望最终结果中残留大量难以索引的 NaN。通常的做法是在调用 np.log 之前或之中进行条件屏蔽与数值清洗。
方案 A:使用 np.where 进行条件安全替换
直接在 np.where 中调用 np.log 需要注意一个常见陷阱:如果写成 np.where(x > 0, np.log(x), 0),即使 x <= 0 的位置最终被 0 替代,由于 Python 在传参前会先对 np.log(x) 进行完整求值,控制台依然会冒出 RuntimeWarning。正确的做法是利用 out 参数或者在计算前将无效值替换为安全占位符:
import numpy as np

arr = np.array([10.0, 0.0, -5.0, 100.0])

# 方法 1:使用 where 掩码避免无效值参与底层求值
valid_mask = arr > 0
log_result = np.zeros_like(arr)

# 仅对符合条件的元素执行 log 计算
np.log(arr, out=log_result, where=valid_mask)
# 对不符合条件的位置显式填充默认值(例如 0.0 或业务自定义值)
log_result[~valid_mask] = np.nan

print("安全掩码计算结果:", log_result)
方案 B:布尔掩码直接过滤
如果业务允许丢弃非法行或离群点,直接使用布尔索引获取纯净正数切片是最高效的方法:
import numpy as np

raw_data = np.array([2.5, -1.2, 0.0, 4.8, 9.1])

# 过滤保留正数子集
clean_data = raw_data[raw_data > 0]
log_clean = np.log(clean_data)

print("过滤后的纯净对数数组:", log_clean)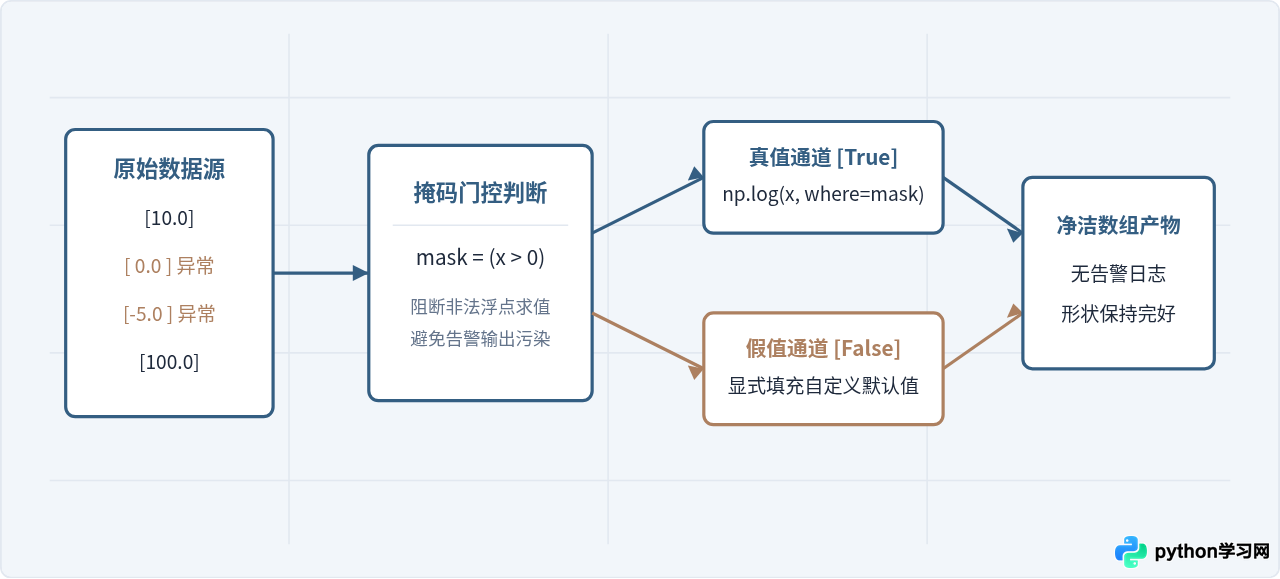
五、各运算库行为对比与决策建议
在 Python 科学计算与工程开发中,不同模块在处理数学定义域之外的值时有着明显不同的策略。了解这些差异有助于避免在混合编程时产生意外:
| 函数与库 | 负数输入处理 (如 x = -1) | 零值输入处理 (x = 0) | 异常类型 / 状态标识 | 典型适用场景 |
|---|---|---|---|---|
| math.log (原生标准库) | 直接报错抛出 | 直接报错抛出 | ValueError: math domain error |
单标量运算、严苛校验控制流 |
| numpy.log (默认配置) | 返回 NaN |
返回 -inf |
RuntimeWarning |
大数据批量矩阵运算、容忍部分缺损 |
| numpy.log (设置 raise) | 直接报错抛出 | 直接报错抛出 | FloatingPointError |
关键金融模型、数据入库严格门控 |
| torch.log (PyTorch) | 返回 NaN (无警告) |
返回 -inf (无警告) |
静默填充特殊浮点值 | GPU 张量训练、反向传播梯度图 |
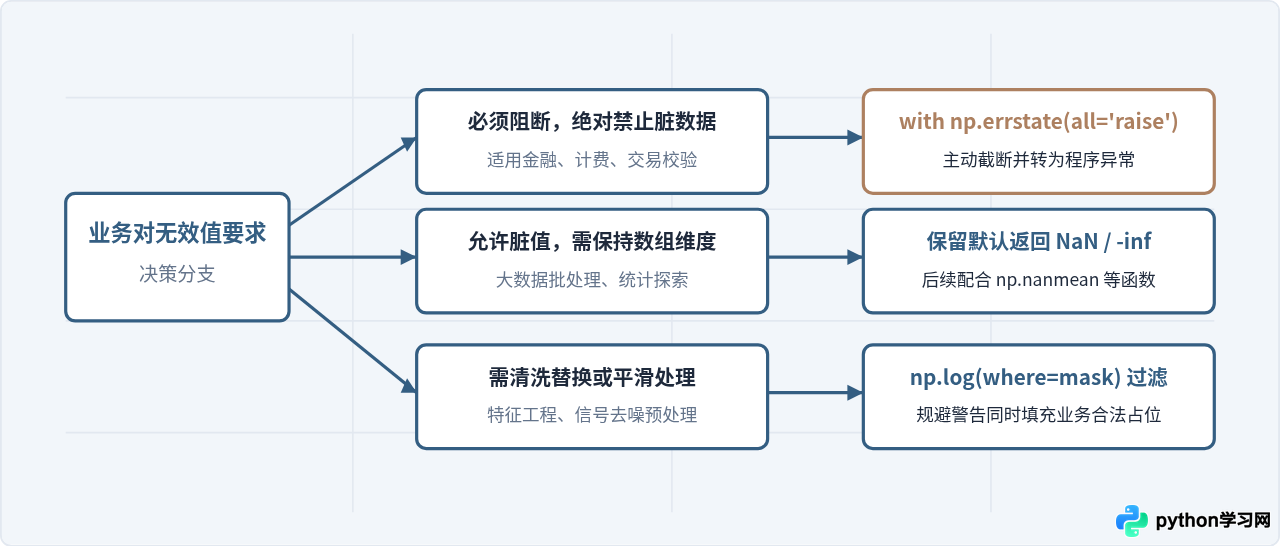
六、总结与关键备忘
- 默认机制是返回 NaN,而非抛出报错:传入负数时返回
np.nan,传入 0 时返回-inf,同时伴随终端RuntimeWarning。 - 不会中断后续执行:警告不会导致 Python 程序退出,数组其余正常正数部分的对数结果仍会计算完成。
- 升级为报错:通过
np.seterr(invalid='raise')或更为安全的上下文管理器with np.errstate(invalid='raise'):可以让无效值在计算瞬间抛出FloatingPointError。 - 生产级防护:在数据清洗阶段,推荐结合布尔掩码
where=mask先行过滤或安全填充,从源头消解无效值对下游计算的影响。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









