

Python源文件的基本结构和PEP 8规范简介
系统介绍Python源文件的标准组织结构与PEP 8代码风格规范,深入解析文件头声明、文档字符串、三段式导入、类与函数组织、命名约定及工程化检查工具。
撰写整洁、规范且结构合理的代码,是每一位 Python 开发者从初学者迈向专业工程实践的必经之路。Python 语言以语法简明、可读性强著称,但这种优势高度依赖于统一的代码布局与风格约定。本文将从一个标准 .py 源文件的物理结构讲起,逐层拆解从头部声明、导入顺序、业务定义到主入口的规范排布,并系统介绍官方代码风格提案 PEP 8 的核心要求,帮助读者写出风格地道、易于维护和协作的 Python 程序。
一、Python 源文件的标准物理结构
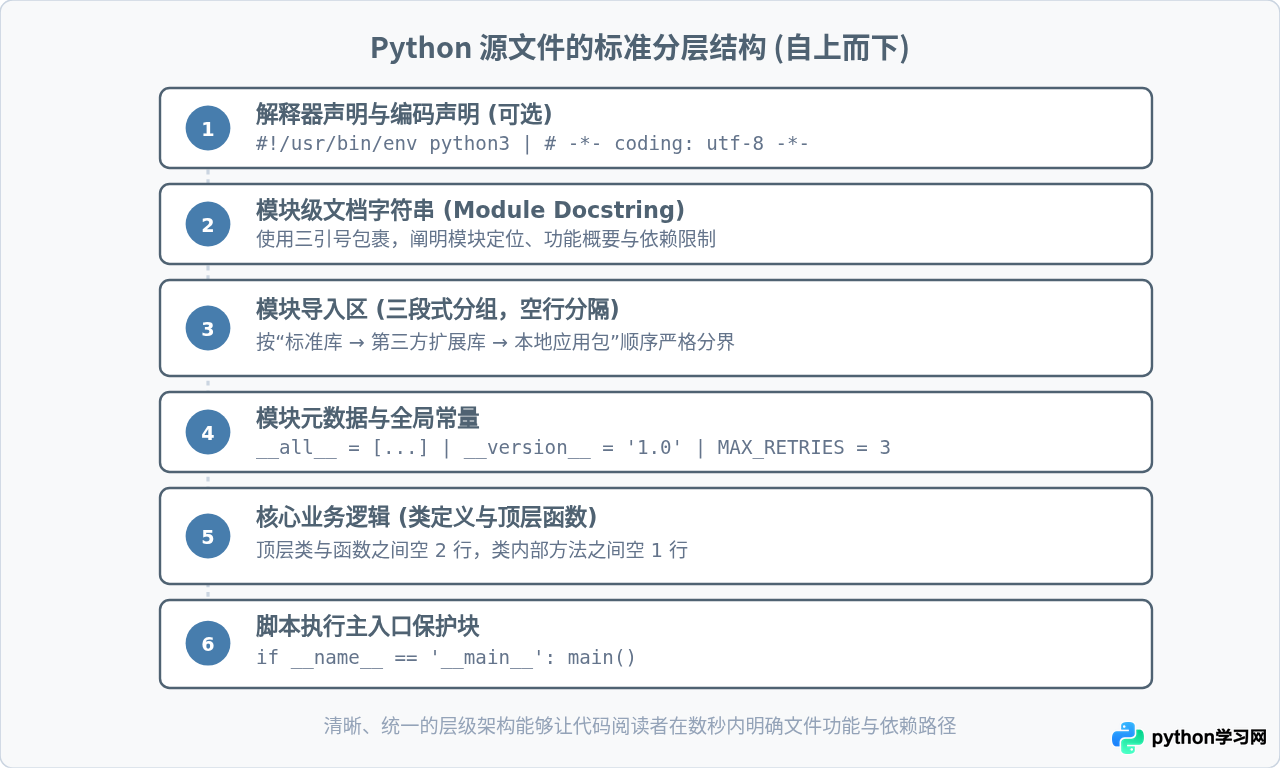
一个组织良好的 Python 源文件通常遵循自上而下的既定层级模式。这种结构使得其他阅读者或静态分析工具能够在第一时间掌握模块的用途、依赖关系与对外暴露的接口。一个典型的 Python 源文件自顶向下一般包含六个主要部分:解释器与编码声明、模块文档字符串、模块导入区、全局元数据与常量、类与核心函数定义,以及作为脚本运行的主程序保护块。
以下是一份符合工业界通用惯例的标准模块骨架示例:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-

"""用户数据处理器模块

本模块提供用户信息的清洗、验证与格式化功能,
支持从外部字典构造标准用户模型并导出规范化报表。
"""

import os
import sys
from datetime import datetime

import requests

from myproject.config import DEFAULT_TIMEOUT
from myproject.utils import format_user_id

__all__ = ['UserManager', 'process_user_data']
__version__ = '1.0.0'

MAX_RETRIES = 3
DEFAULT_ROLE = 'guest'


class UserManager:
    """用户管理器,负责维护用户状态与持久化操作。"""

    def __init__(self, username: str) -> None:
        self.username = username
        self.created_at = datetime.now()

    def get_info(self) -> dict:
        """返回用户的基本信息字典。"""
        return {
            'username': self.username,
            'role': DEFAULT_ROLE,
            'created_at': self.created_at.isoformat(),
        }


def process_user_data(raw_data: dict) -> dict:
    """清洗单条原始用户数据并返回处理后的字典。"""
    user_id = format_user_id(raw_data.get('id', ''))
    name = raw_data.get('name', '').strip()
    return {'id': user_id, 'name': name}


def main() -> None:
    """主入口执行逻辑。"""
    sample_user = {'id': '1001', 'name': '  张三  '}
    cleaned = process_user_data(sample_user)
    print(f"清洗完成的数据: {cleaned}")


if __name__ == '__main__':
    main()
1. 文件头与编码声明
位于文件首行的 #!/usr/bin/env python3 称为 Shebang,主要用于类 Unix 环境(Linux、macOS)。当源文件被赋予执行权限(chmod +x script.py)并作为独立脚本直接执行时,系统内核通过这一行调用对应的 Python 解释器。第二行的编码声明 # -*- coding: utf-8 -*- 在 Python 2 时代是包含中文等非 ASCII 字符文件的必备标记;在 Python 3 中,默认源文件编码已锁定为 UTF-8,因此该行在纯 Python 3 项目中通常可以省略,但在需要显式保证向下兼容或跨工具解析的场景中依然常见。
2. 模块级文档字符串(Docstring)
文档字符串紧随文件头部声明之后,必须放置在任何可执行代码或导入语句之前。根据 PEP 257 规范,模块级文档应使用三对双引号 """ 包含,第一行为简明扼要的单行总结,随后空一行展开具体说明,列出该模块导出的类、异常、关键函数或环境变量需求。借助 Python 内置的 help(module_name) 或 Sphinx 等自动化文档工具,该字符串会自动提取为用户文档。
3. 模块元数据与常量
在导入语句下方,如果模块需要声明对外导出的符号列表,应显式定义 __all__ 列表。当外部通过 from module import * 导入时,只有包含在 __all__ 中的名称才会被引入当前作用域,这为模块封装提供了明确的边界。紧接着是模块级别的常量,常量名称应统一采用大写字母加下划线命名。
4. 主入口保护机制与 if __name__ == '__main__'
在 Python 中,每个模块内部都有一个内置变量 __name__。当该模块作为程序主入口直接运行时,解释器将 __name__ 赋值为字符串 "__main__";若该模块被其他文件以 import 方式引入,其 __name__ 则为模块自身的实际名称。使用 if __name__ == '__main__': 条件判断,能确保测试代码或主调度逻辑只在作为脚本独立执行时触发,而在被导入重用时不产生任何副作用。将启动代码收敛到 main() 函数中并在此处调用,是编写工业级脚本的标准实践。
二、PEP 8 核心排版与代码布局规范
PEP 是 Python Enhancement Proposal(Python 增强提案)的缩写,而 PEP 8 则是由 Guido van Rossum、Barry Warsaw 和 Nick Coghlan 共同制定的《Python 代码风格指南》。PEP 8 诞生的首要理念可以用《Python之禅》中的核心格言概括:代码被阅读的频次远远高于被编写的频次(Readability counts)。统一的代码风格不仅消除了团队协作中的个人排版差异,更让开发者能专注于业务逻辑本身。
1. 缩进与制表符(Indentation)
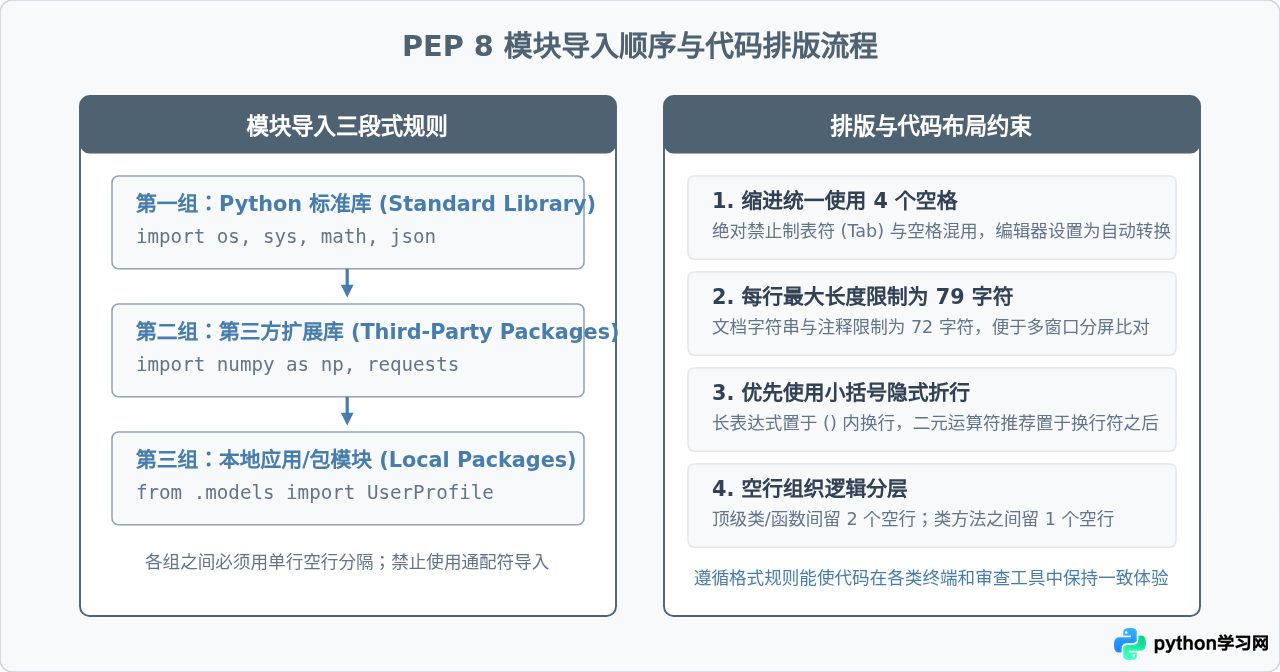
PEP 8 规定:所有缩进必须使用 4 个空格,严禁使用制表符(Tab)。在 Python 3 中,解释器已经完全禁止同一作用域内混用制表符与空格,否则会直接引发 TabError: inconsistent use of tabs and spaces in indentation 语法错误。现代编辑器(如 VS Code、PyCharm)均支持配置“按 Tab 键自动转换为 4 个空格”选项,务必在日常开发中开启此配置。
2. 行的最大长度与换行原则(Line Length)
PEP 8 建议将所有代码行的长度限制在 79 个字符 以内;对于文档字符串或长注释,则建议限制在 72 个字符 以内。这一规则源于传统终端显示限制,而在现代高分辨率大屏下,其核心价值转变为:允许开发者在同一屏幕上无损并排展开 2 至 3 个源文件进行代码比对或审查。
当单行语句过长需要折行时,PEP 8 首选圆括号、方括号或花括号内部的隐式续行,应尽量避免使用反斜杠 \ 作为显式续行符。示例如下:
# 推荐做法:利用圆括号实现隐式换行,运算符置于新行开头
total_score = (
    base_math_score
    + advanced_physics_score
    + extra_language_credits
    - penalty_points
)

# 推荐做法:长参数列表的悬挂缩进
def send_notification_email(
    recipient_email_address: str,
    email_subject_title: str,
    email_body_content: str,
    retry_on_failure: bool = True,
) -> bool:
    pass

# 不推荐做法:使用反斜杠换行(容易因行末意外空格导致语法错误)
total_score = base_math_score + \
              advanced_physics_score + \
              extra_language_credits
注意:二元运算符的换行位置
在旧版规范中,曾允许运算符写在行末。但自数学排版标准普及以来,PEP 8 明确推荐在二元运算符之前换行(Knuth 风格)。这样所有运算符垂直对齐在左侧,操作数与计算逻辑一目了然。
3. 空行的节奏与语义
空行在 Python 中不是单纯的视觉空白,而是具有明确逻辑分隔语义的标点:
- 顶层函数与类定义之间:保持 2 个空行。这能够让文件中的主要构造块边界分明。
- 类内部的方法定义之间:保持 1 个空行。
- 函数内部逻辑段落之间:可以根据逻辑步骤稀疏地插入 1 个空行,用于将“数据校验”、“计算处理”与“结果组装”等阶段区分开。切勿过度滥用连续空行。
4. 模块导入书写细节
导入语句必须严格位于模块文档之后、模块全局变量之前,并遵循以下细分准则:
- 单行单一导入:推荐写成
import os和import sys两行,而不是合并写为import os, sys。但从同一个模块导入多个类或函数时,允许合并书写,如from subprocess import Popen, PIPE。 - 分组空行分隔:严格分为标准库、第三方库、本地应用三组,组与组之间空 1 行。
- 绝对导入优先:推荐使用绝对路径导入(如
from myapp.dialogs import ConfirmDialog),相对导入仅在复杂内部包结构内部使用。 - 坚决杜绝通配符导入:严禁使用
from module import *。通配符导入会污染当前命名空间,隐藏具体依赖来源,极易引发变量名覆盖事故。
5. 空格的使用规范与禁忌
表达式与语句中空白字符的处理直接决定了代码的气质。下表汇总了常见的使用场景与对照要求:
| 场景 | 正确示例 | 错误反例 | 规范说明 |
|---|---|---|---|
| 括号内侧 | spam(ham[1], {eggs: 2}) |
spam( ham[ 1 ], { eggs: 2 } ) |
紧贴圆括号、方括号或花括号内侧不留空格。 |
| 标点符号前后 | if x == 4: print(x, y); x, y = y, x |
if x == 4 : print(x , y) ; x , y = y , x |
逗号、分号、冒号紧贴前一个字符,空格放在其后。 |
| 赋值与比较运算 | count = count + 1is_ready = val > 0 |
count=count+1is_ready=val>0 |
二元运算符(赋值、比较、布尔)两侧各留一个空格。 |
| 默认参数赋值 | def func(timeout=10, retry=True): |
def func(timeout = 10, retry = True): |
函数形参列表中指示默认值时,等号两侧不加空格。 |
| 类型注解冒号与箭头 | def calc(x: int) -> float: |
def calc(x :int)->float: |
形参冒号紧跟变量名,后留空格;返回值箭头两侧留空格。 |
三、PEP 8 命名约定与语义设计
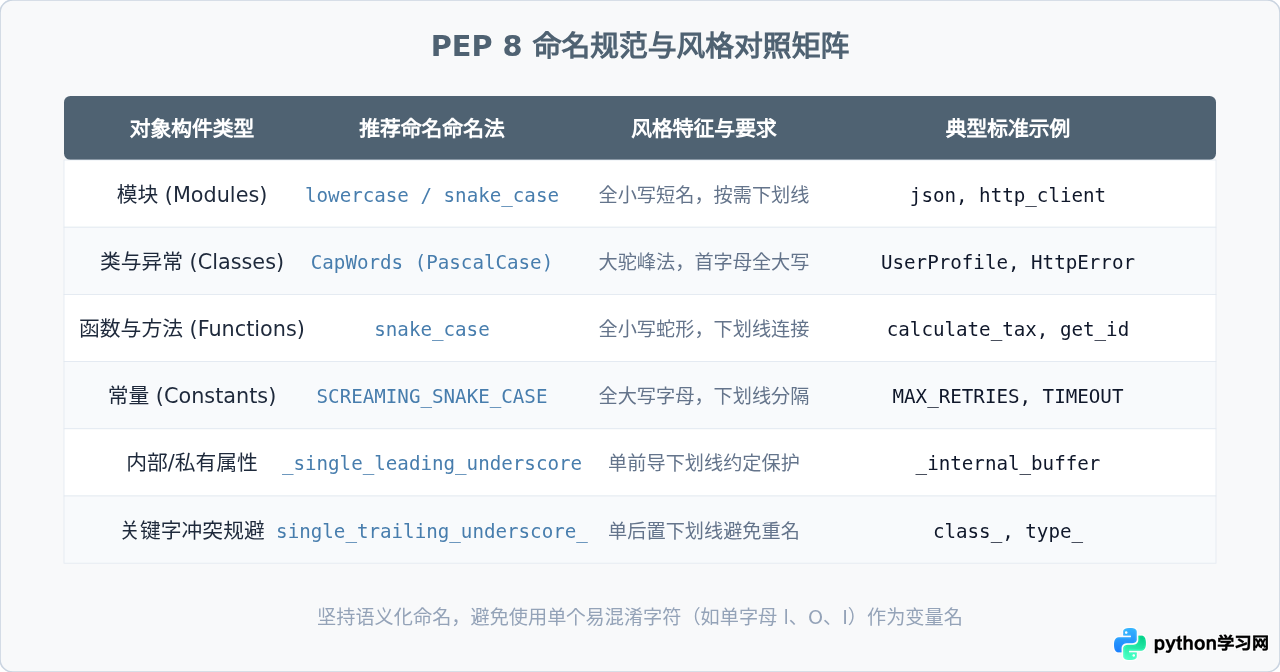
Python 是一门动态强类型语言,命名所传达的元信息对于代码阅读至关重要。PEP 8 针对不同的语言构件提出了明确的命名风格矩阵,消除随意的拼写与歧义。
1. 下划线模式的深层语义
在 Python 的命名哲学中,下划线 _ 扮演了极为丰富且关键的角色:
_single_leading(单前导下划线):弱“内部私有”约定。不会被from M import *导入,提示调用者该成员为实现细节。single_trailing_(单后置下划线):用于解决与 Python 保留关键字的冲突。例如当需要使用class作为参数名时,应写为class_。__double_leading(双前导下划线):触发解释器的“名称修饰”(Name Mangling)。当类属性被命名为__var时,解释器在底层将其改写为_ClassName__var,防止子类在继承时无意中覆盖父类同名属性。__double_leading_and_trailing__(双前后下划线):Python 特殊内置方法(Magic/Dunder Methods),如__init__、__str__、__call__。开发者严禁自定义此类命名的符号。
四、编写规范代码的自动化工具与工程实践
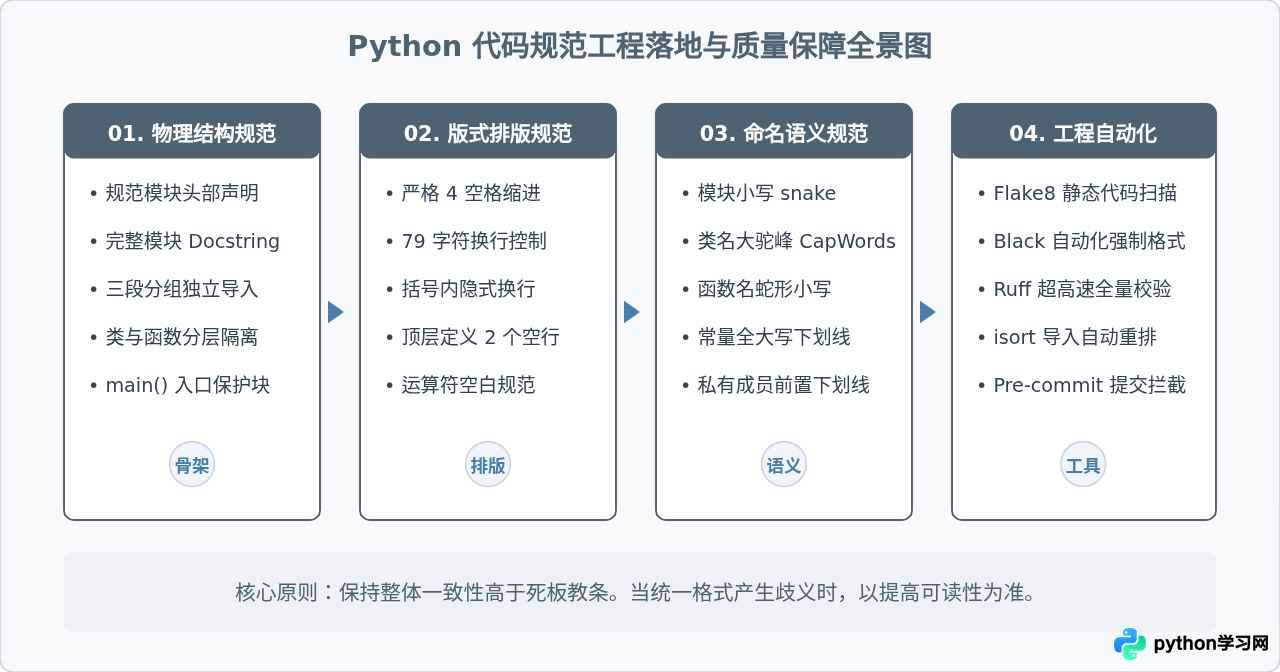
在实际团队研发中,纯粹依靠人工肉眼排查代码格式既低效又容易遗漏。现代 Python 生态已经提供了成熟的自动化工具链,将 PEP 8 规范的检查与修复无缝融入日常工作流。
1. 静态检查工具(Linters)
- Flake8:Python 社区最经典的静态代码风格检查器,聚合了 PyFlakes(逻辑错误检测)、pycodestyle(PEP 8 样式检查)和 McCabe(复杂度检测)。执行命令
flake8 script.py可以快速指出行宽越界、未使用的变量或违规空行。 - Ruff:近年来基于 Rust 编写的高性能静态分析器,速度可达传统工具的数十倍至百倍,全面兼容并覆盖了 Flake8、isort、pydocstyle 等绝大多数规则,已成为现代 Python 工程的首选检查工具。
2. 自动格式化工具(Formatters)
- Black:被誉为“不妥协的代码格式化器”(The Uncompromising Code Formatter)。它接管全部 AST 解析与重排,强制统一引号、行长换行、空格与多行尾逗号,彻底终结团队关于格式细节的口水战。
- isort:专门用于自动化梳理导入语句的工具,能够将所有
import按标准库、第三方库与本地模块精准分段并按字母顺序排序。
3. 本地与 CI 自动化集成
为了保证团队提交代码的纯净,通常利用 pre-commit 框架在本地 Git 提交时自动触发校验,只有通过 PEP 8 风格与静态检查的代码才允许提交至版本库;在持续集成(CI)流水线中,亦会加入针对代码风格的自动化 Gate 检查,从而从机制上筑牢工程代码质量的防线。
五、总结
Python 源文件的基本结构和 PEP 8 规范并非束缚开发者创造力的繁琐教条,而是 Python 社区二十多年经验凝聚而成的智慧结晶。清晰的六层物理结构为代码建立了坚实易读的骨架,而精细的缩进、空行、命名与导入规则,则赋予了代码如散文般流畅自然的阅读体验。在实际开发中,养成遵循标准结构的习惯,并借助 Black、Flake8 等工具将其工程化落地,能够让每一位开发者写出既符合官方标准又具备高工程维度的健壮代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









