

Kimi能处理多长代码文件?长文本上下文在编程中的实际应用
本文以 Windows 版 Kimi Code Desktop 为例,演示如何利用超长上下文窗口分析大型代码文件。通过核对模型容量、引用特定文件、提出只读分析指令及检查读取范围,展示如何在不盲目粘贴代码的情况下,精准定位长文件中的逻辑路径,并有效管理会话上下文。
面对动辄数千行的遗留代码或复杂模块,直接复制粘贴不仅容易超出输入限制,还会丢失文件间的依赖关系。Kimi Code 的长上下文能力并非简单地“吞下”更多字符,而是允许你在保留项目结构的前提下,对特定长文件进行深度阅读和逻辑梳理。这种做法的直接好处是,你能在保持代码完整性的同时,快速定位如空行处理、异常捕获等具体逻辑路径,而不必担心截断或上下文丢失。
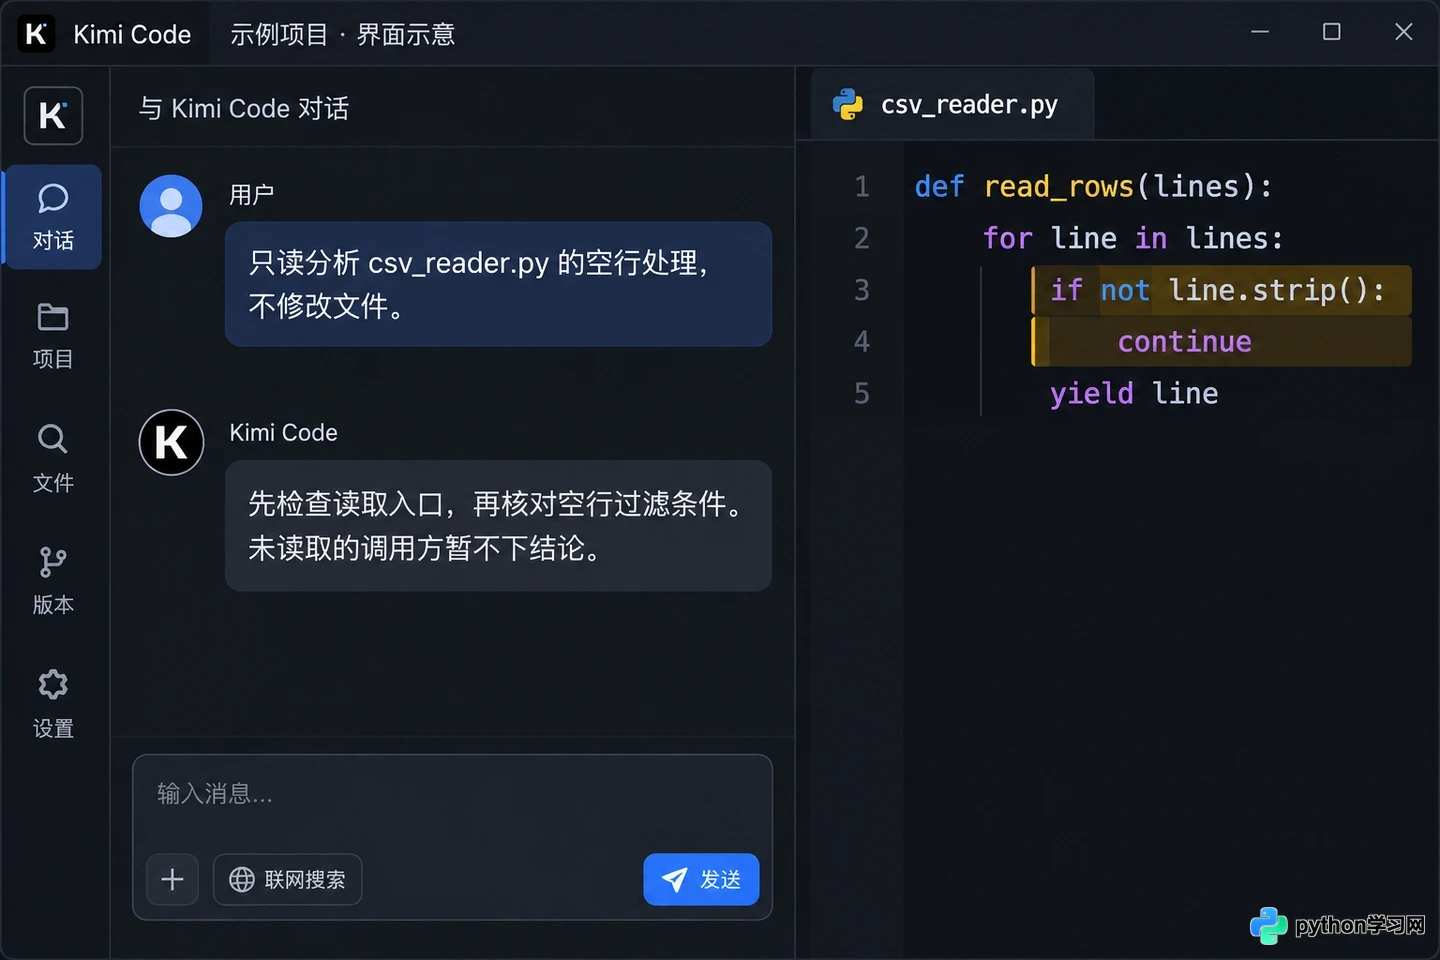
Kimi Code 结合项目结构分析长代码文件的逻辑路径
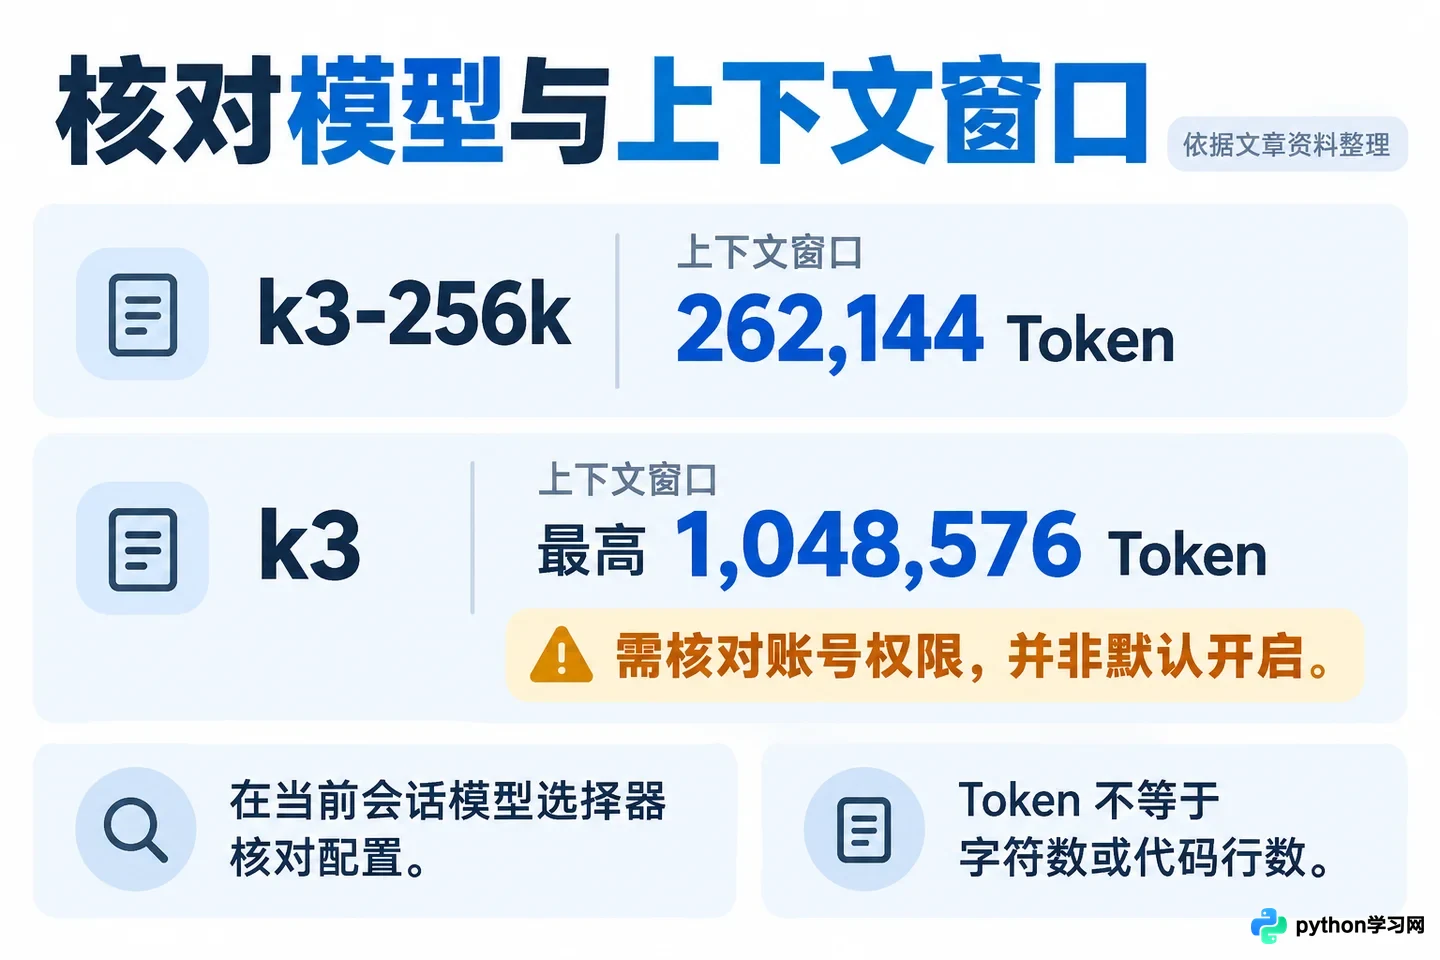
Token 是模型处理文本的基本单位,它不等于字符数,更不等于代码行数。注释、长字符串和不同编程语言的标识符都会影响 Token 的占用量。此外,上下文窗口还需容纳你的指令、历史对话以及工具返回的结果。因此,即使模型支持百万级 Token,也不意味着可以无限制地填满单个文件,合理的管理策略比单纯追求容量上限更为关键。
1. 核对当前模型与上下文窗口
在开始分析长代码前,首先要确认当前会话使用的模型及其对应的上下文容量。在 Kimi Code Desktop 的会话输入区域上方,点击模型选择器查看当前配置。
官方提供的模型中,k3-256k 拥有 262,144 个 Token 的上下文窗口;而 k3 模型在账号具备相应权限时,最高可扩展至 1,048,576 个 Token。需要注意的是,k3 的百万级上下文并非默认开启,需根据账号会员状态核实。新建会话时,务必记录所选模型,以便后续评估可处理的数据量。
1. 核对当前模型与上下文窗口
2. 打开项目工作区并定位文件
不要直接将长代码片段粘贴进聊天框,这样会切断文件与项目其他部分的联系。在左侧面板新建会话,点击输入区域上方的文件夹名称,打开工作区选择器。
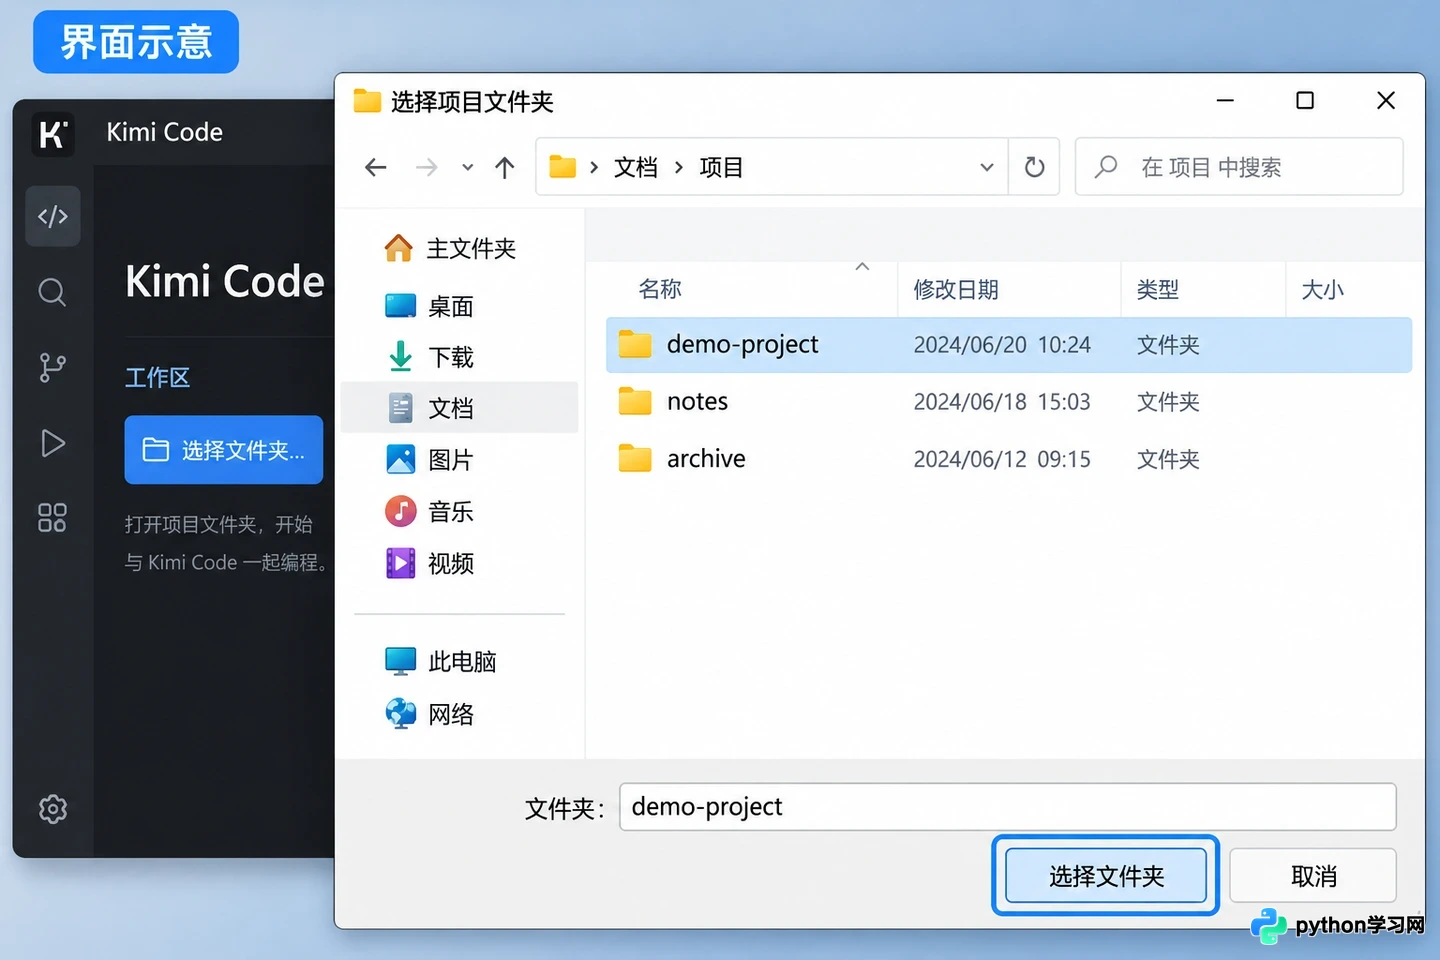
通过工作区选择器加载本地项目文件夹
通过【Choose folder…】选择本地项目文件夹,或在 Windows 环境下直接使用 Ctrl+O 快捷键打开。确认输入框上方显示的是目标项目名称后,再准备引用具体文件。本例假设项目中包含一个较长的 csv_reader.py 文件及其测试用例,我们的目标是分析其中对空行的处理逻辑,而非重构整个项目。
3. 引用文件并提出只读分析指令
在输入框中输入 @ 符号,从下拉列表中选择项目中的 csv_reader.py。如果存在相关的测试文件,也一并引用。引用操作能帮助 Agent 准确定位材料来源,但这并不等同于将整个目录一次性全部加载进活跃上下文。
随后,输入清晰的分析指令,明确任务边界。例如:
请只读分析已引用的 csv_reader.py 和相关测试,不修改文件。
目标:说明空行从读取到过滤的处理路径。
先定位入口函数,再列出涉及的函数、文件位置和关键条件。
若还需要调用方或配置,请指出具体文件并读取后再下结论。
没有读到的部分明确标注,不要把推测写成已确认行为。
发送指令后,观察模型的响应。理想的回答应聚焦于空行处理的调用链,而非对项目进行泛泛而谈的介绍。
4. 检查读取范围并补足上下文
模型返回分析结果后,点击回答中提到的文件路径或函数名,在右侧文件预览区进行对照。重点检查入口函数是否正确、分支条件是否遗漏,以及结论是否基于当前项目的实际代码。
如果发现模型仅读取了文件的一部分,或者空行处理逻辑涉及其他模块,应根据调用关系继续引用相关文件。避免将构建产物、依赖库目录或无关的历史日志塞入会话。当遇到截断提示或读取范围说明时,先补齐缺失的代码片段,再接受关于整体路径的判断。较大的上下文窗口适合跨模块比较,但仍需人工核对关键细节。
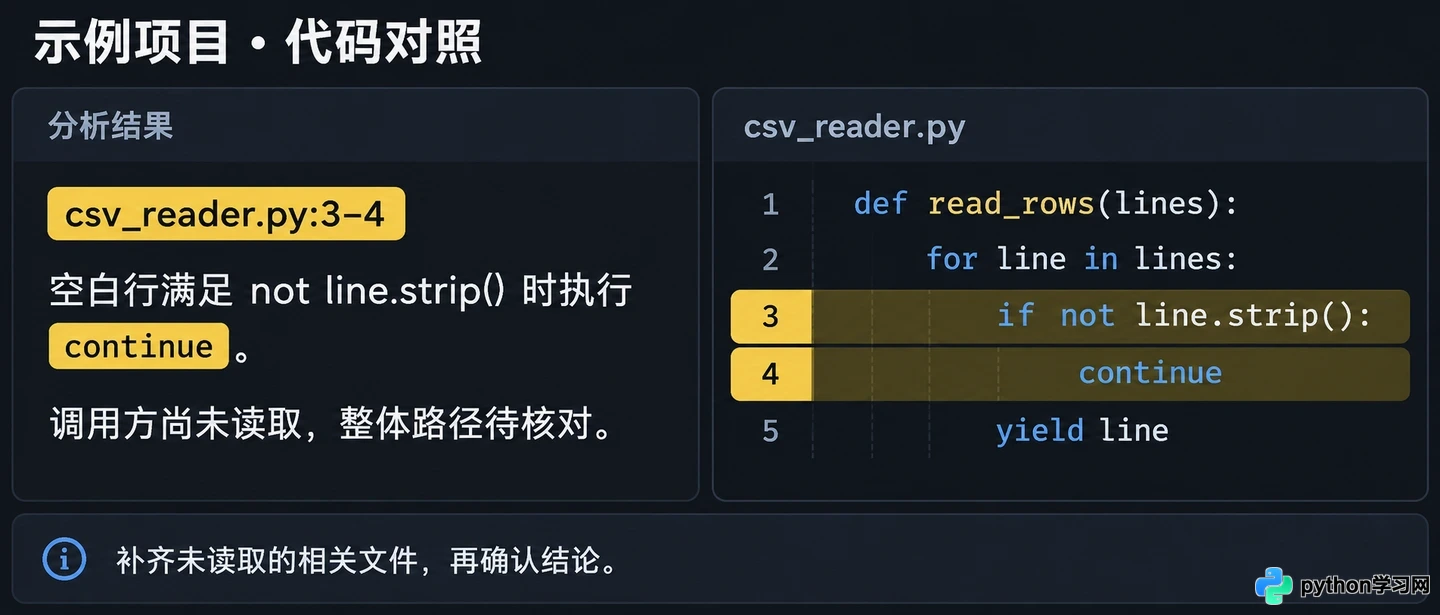
在文件预览区对照模型分析的函数与条件
5. 压缩会话并保留验证依据
随着多轮代码阅读和工具调用的进行,上下文占用会逐渐增加。当需要清理冗余信息时,在输入框中使用 /compact 命令。桌面版界面右侧通常会显示压缩后的状态信息。
压缩操作保留的是整理后的要点,而非原始代码的逐字记录。在继续任务前,可要求模型保留关于空行处理的结论、涉及的文件列表、未确认的问题以及后续验证要求。对于必须精确引用的代码段,应重新从工作区读取,而非仅依赖压缩后的记忆。
最后,建议在项目笔记中记录当前使用的模型、关键文件位置、已核对的处理路径以及尚未运行的测试用例。若后续需要修改代码,再基于这些依据提出具体需求,并检查实际差异和测试输出。通过这种方式,长上下文窗口才能真正转化为高效的编程辅助工具,而非仅仅是存储空间的堆砌。
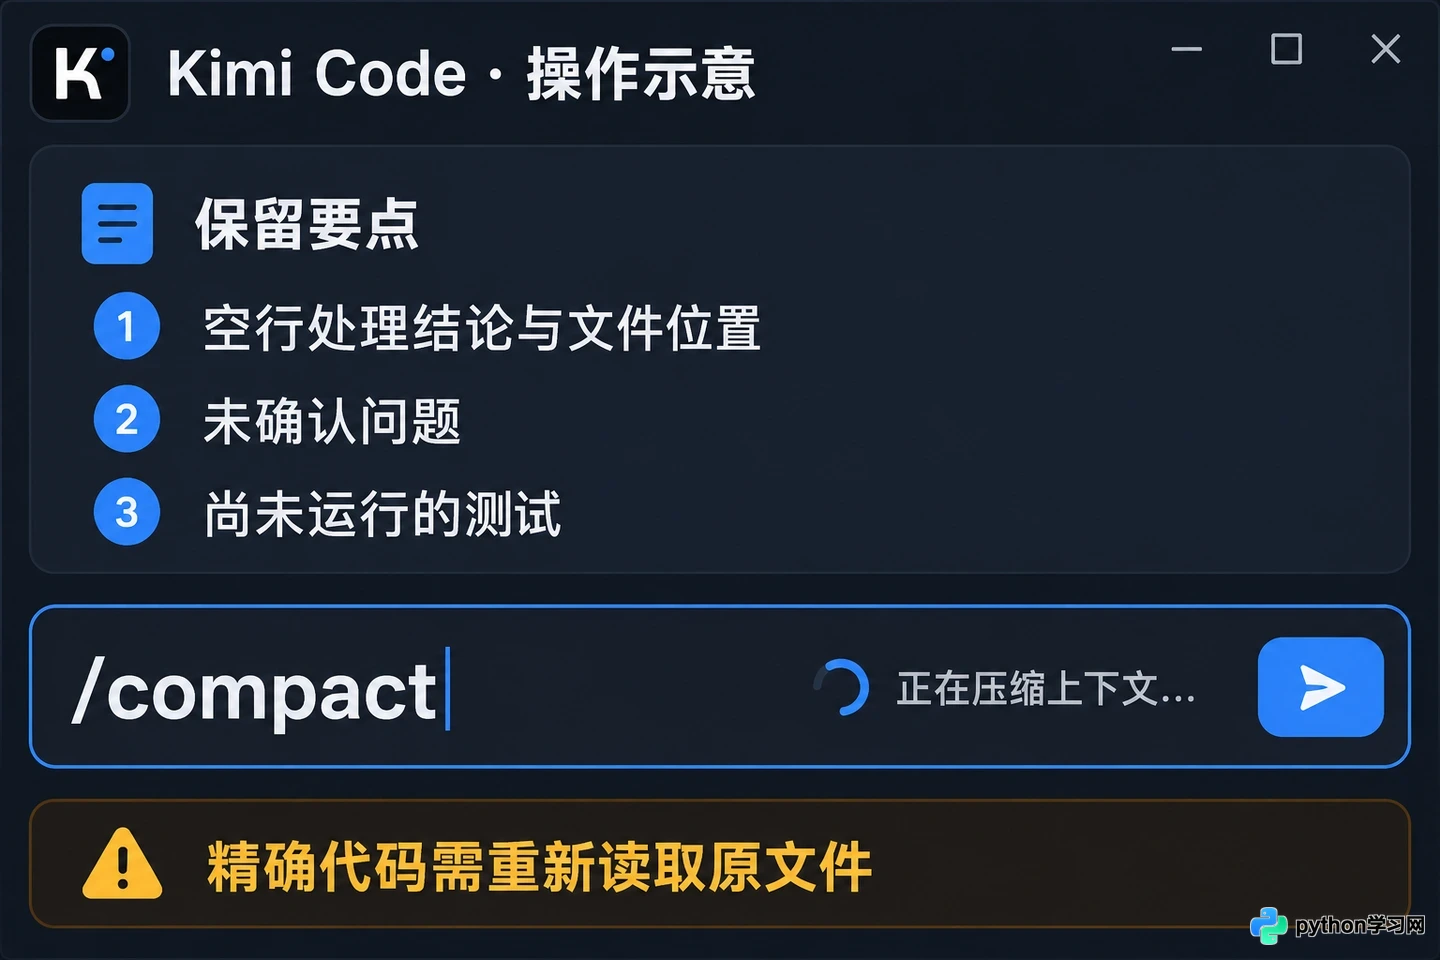
通过压缩命令清理冗余上下文并保持关键结论
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









