

为什么调用Python函数后得到None?检查是否遗漏return或赋值
深入解析在Python中调用函数得到None的核心原因。系统排查函数内部遗漏return语句、分支未覆盖、递归未透传,以及混淆list.sort()等原地修改方法与赋值操作,提供四步排查流程与防错清单。
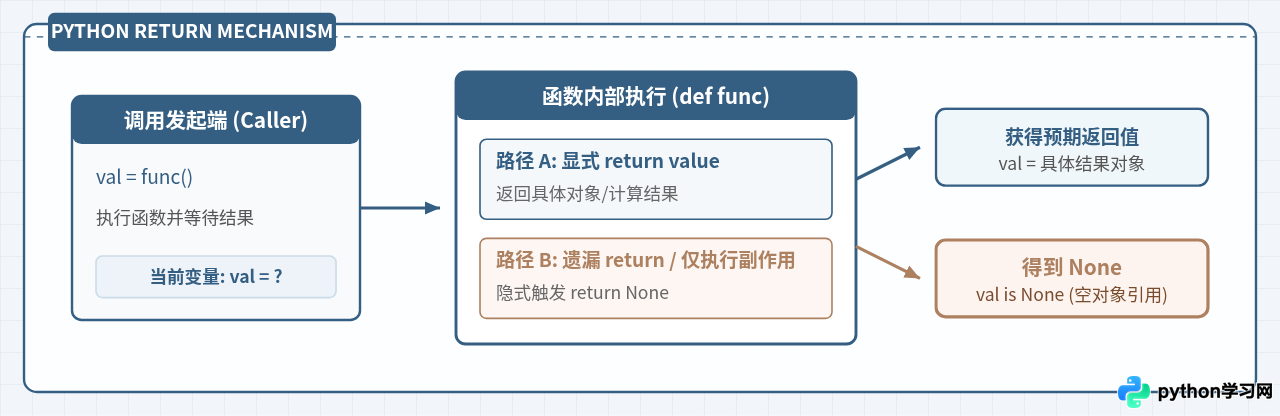
None,绝大多数情况下并不是程序逻辑产生了神秘的空值,而是由两类最普遍的编码习惯引发:第一,函数内部执行完毕但没有显式声明 return 语句(或分支路径中遗漏了 return),导致 Python 解释器隐式默认执行了 return None;第二,调用了专门进行“原地修改(In-Place)”的对象方法并错误地将返回值赋给了变量(如误写为 lst = lst.sort())。本文从 Python 函数的底层执行机制出发,逐项剖析遗漏 return 与误用赋值的具体场景,并提供一套四步排查流程与防错清单,帮助你在编码与排错时迅速定位并解决此类问题。
一、核心机制:Python 函数为什么一定会返回对象?
在许多编译型语言(如 C/C++ 或 Java)中,没有返回值的函数会被声明为 void 类型,调用这类函数时编译器会直接禁止将其结果赋给变量。然而,Python 是一门完全面向对象的动态语言,在 Python 中不存在“没有返回值”的函数或方法。
当 Python 虚拟机(CPython)执行一个函数体时,只要控制流到达了函数末尾而没有触发任何显式的 return 指令,解释器就会在字节码层级自动追加两条指令:LOAD_CONST (None) 与 RETURN_VALUE。换言之,在 Python 的语法体系中,不写 return 等同于写了 return None。
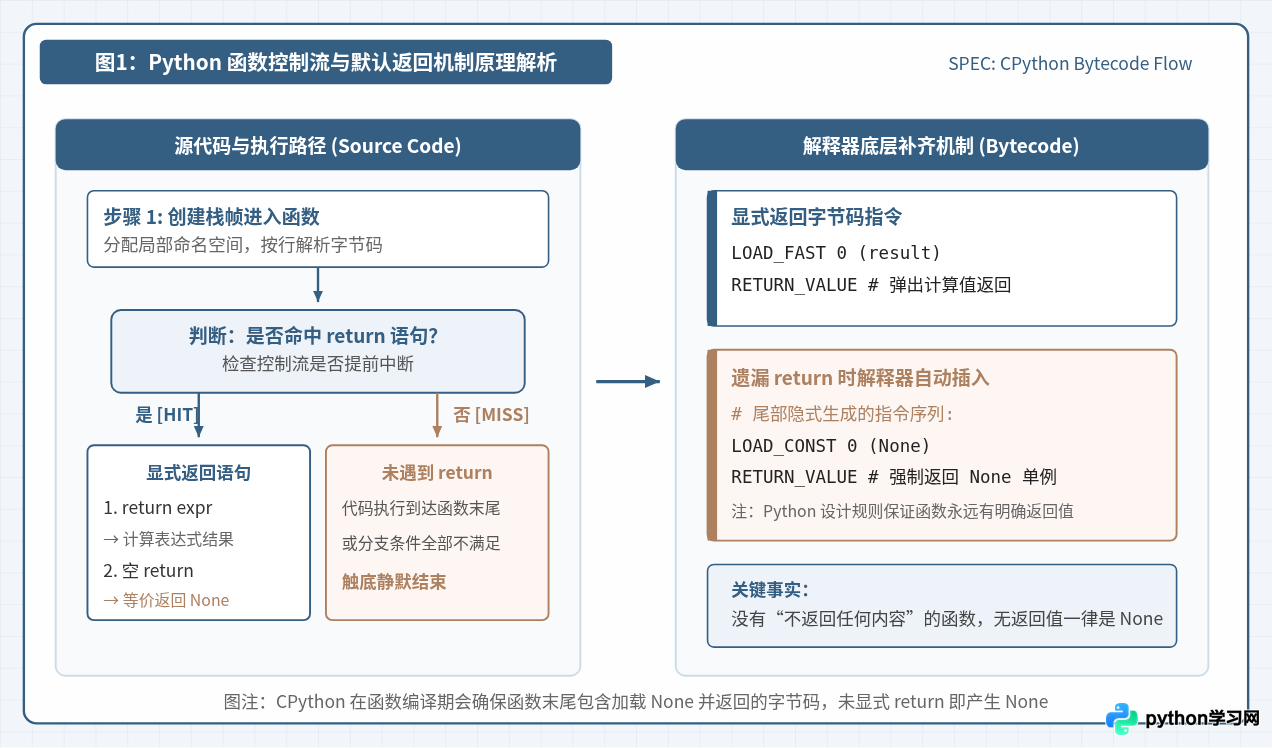
不仅如此,即使写了 return 关键字,如果其后没有跟随任何具体的表达式(例如只写了一个孤立的 return 用来提前中断执行),Python 同样会返回单例对象 None。理解这个底层机制是所有排查工作的基石:只要看到返回值是 None,就意味着在实际运行路径上,要么根本没有执行带值的 return,要么执行了一个计算结果本身就是 None 的语句。
二、原因排查一:函数内部遗漏 return 或控制流盲区
在自定义函数中,得到 None 最直观的原因出现在函数内部代码块。通常可分为三种典型场景:
1. 误将 print() 当作返回值
初学者容易将“屏幕输出”与“向调用方传递数据”混为一谈。print() 函数的作用是将内容序列化为字符串并输出到标准输出流(stdout),它本身的返回值固定为 None。如果在函数内部计算出了答案并通过 print() 打印,但末尾没有将变量 return 出去,外部调用接收到的就是 None。
def calculate_discount(price, rate):
    discounted = price * rate
    print("折后价格为:", discounted)  # 仅在控制台输出,没有向外传递

result = calculate_discount(100, 0.8)
# 控制台输出: 折后价格为: 80.0
print("接收到的结果:", result)
# 控制台输出: 接收到的结果: None
def calculate_discount(price, rate):
    discounted = price * rate
    return discounted  # 显式将结果移交给调用方

result = calculate_discount(100, 0.8)
print("接收到的结果:", result)  # 输出: 接收到的结果: 80.0
2. 条件分支(if/elif)未能穷尽所有路径
当函数内包含多个条件分支时,必须确保在所有可能的逻辑分支中都有明确的返回值。如果某些边界输入落入了未被捕获的空缺路径,代码就会直接贯穿至函数底部,触发隐式 return None。
def get_user_status(age):
    if age >= 18:
        return "Adult"
    elif age >= 12:
        return "Teenager"
    # 注意:当 age < 12 时,没有任何 elif 匹配,也没有 else 分支!

status = get_user_status(8)
print(status)  # 输出: None(落入分支盲区)
在上述代码中,当传入参数小于 12 时,程序悄无声息地滑落到函数结束,外部得到的便是 None。修正方法是务必补充完整的 else 块,或者在函数末尾声明统一的默认返回值。
3. 递归调用中忘记在递归语句前加上 return
递归函数是导致 None 返回值最隐蔽的“重灾区”。许多开发者在编写递归终止条件(Base Case)时记得写 return,但在递归调用自身时,却只写了 func(sub_args),遗漏了最外层的 return。
def find_item(data, target):
    for item in data:
        if item == target:
            return item
        if isinstance(item, list):
            find_item(item, target)  # 错误!递归得到了目标,但并未将其 return 给上层栈帧

found = find_item([1, [2, 3], 4], 3)
print(found)  # 输出: None
def find_item(data, target):
    for item in data:
        if item == target:
            return item
        if isinstance(item, list):
            res = find_item(item, target)
            if res is not None:
                return res  # 关键:逐层向上归约返回值
    return None  # 遍历完毕确实未找到时显式返回 None
三、原因排查二:混淆“原地修改(In-Place)”与“返回新对象”
如果排查了代码确认函数写了 return,或者报错发生在调用内置对象方法时,最核心的原因就是对 Python 的“原地操作(In-Place)”与“纯函数操作”机制产生了混淆。
Python 遵循严格的命令与查询分离(Command-Query Separation)设计原则:一个修改对象内部状态的方法,通常不应该返回被修改的对象本身。这种设计的目的是防止开发者产生“该操作创建了新对象”的误解,并提醒调用者该操作已经直接改变了原始数据。
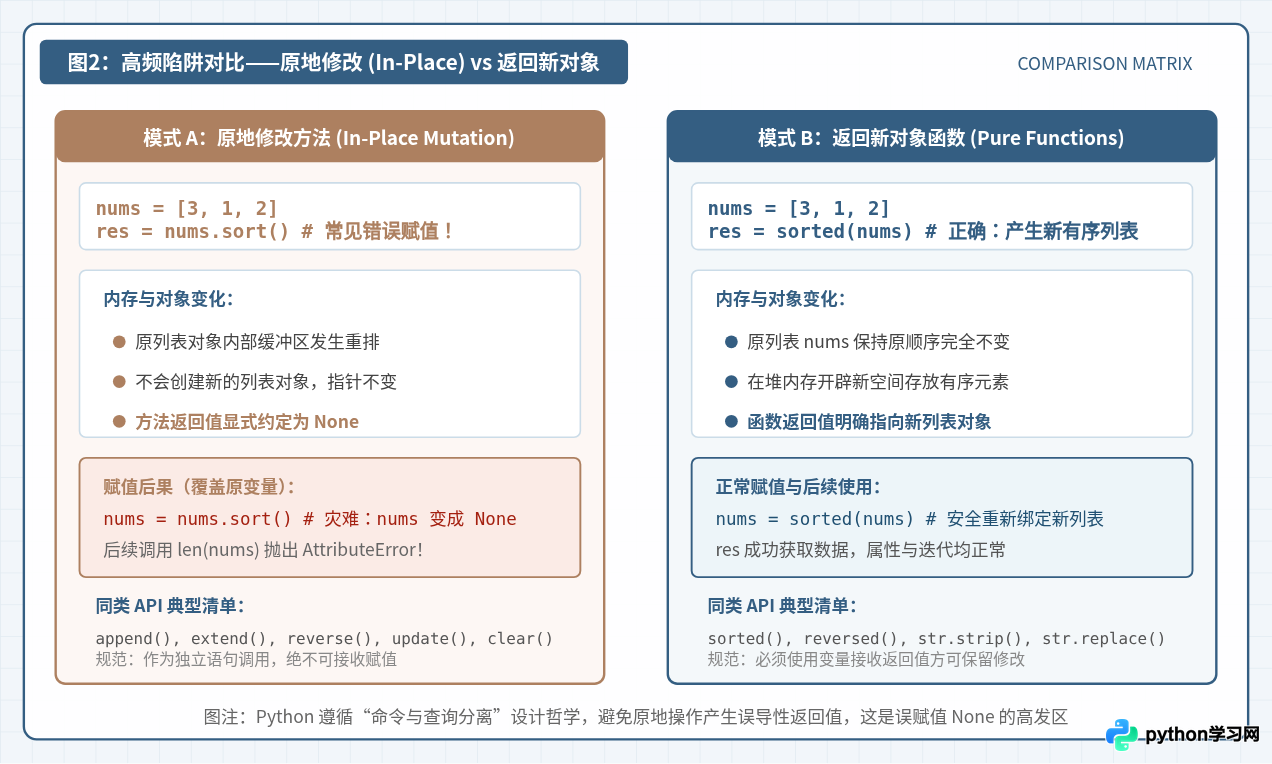
常见原地修改方法对比清单
| 内置类型 | 原地操作(返回 None,不可赋值) | 返回新对象(必须赋值接收) | 核心差异解释 |
|---|---|---|---|
| 列表 (List) | list.sort() |
sorted(iterable) |
sort() 直接重排原列表并返回 None;sorted() 生成全新有序列表。 |
| 列表 (List) | list.reverse() |
reversed(seq) |
reverse() 原地反转并返回 None;reversed() 返回反向迭代器。 |
| 列表 (List) | list.append(x) / extend() |
list + [x] |
追加元素是修改原容器,其返回值为 None。拼接运算符产生新列表。 |
| 字典 (Dict) | dict.update(other) |
{**d1, **d2} / d1 | d2 |
update() 直接扩充原字典并返回 None;合并语法生成合并后的新字典。 |
| 集合 (Set) | set.add(x) / discard() |
set | {x} |
集合的修改操作均为原地生效,返回值固定为 None。 |
my_list = my_list.sort() 或 my_list = my_list.append(10) 的代码!这种赋值不会让变量保留修改后的列表,而是直接把变量名重新绑定到了方法返回的 None 上,彻底破坏了原有数据!
四、原因排查三:链式调用断裂与副作用误赋
在面向对象编程中,“方法链(Method Chaining)”是一种常见的书写模式,例如 text.strip().lower().replace(" ", "_")。由于字符串(str)在 Python 中是不可变对象(Immutable),字符串的每一个方法都会返回一个新的字符串副本,因此可以顺畅地连续调用。
然而,在处理可变对象(如列表、集合、字典、NumPy 数组或自定义类)时,尝试将就地修改的方法串联起来,就会立即发生“链式断裂”:
# 尝试在一行内创建列表并排序:
items = [5, 2, 8, 1].sort()
# 错误后果:items 现在是 None!

# 接下来任何使用 items 的操作都会抛出异常:
length = len(items)
# 抛出: TypeError: object of type 'NoneType' has no len()

items.append(10)
# 抛出: AttributeError: 'NoneType' object has no attribute 'append'
当你遇到 AttributeError: 'NoneType' object has no attribute ... 这一 Python 经典报错时,十有八九是因为在上一行执行了返回 None 的操作,并将结果赋给了当前变量。
五、系统化四步诊断法:如何快速定位并修复 None
面对调用函数后非预期的 None,建议遵循以下标准四步排查流程,从现象层逐步下探至代码实现:
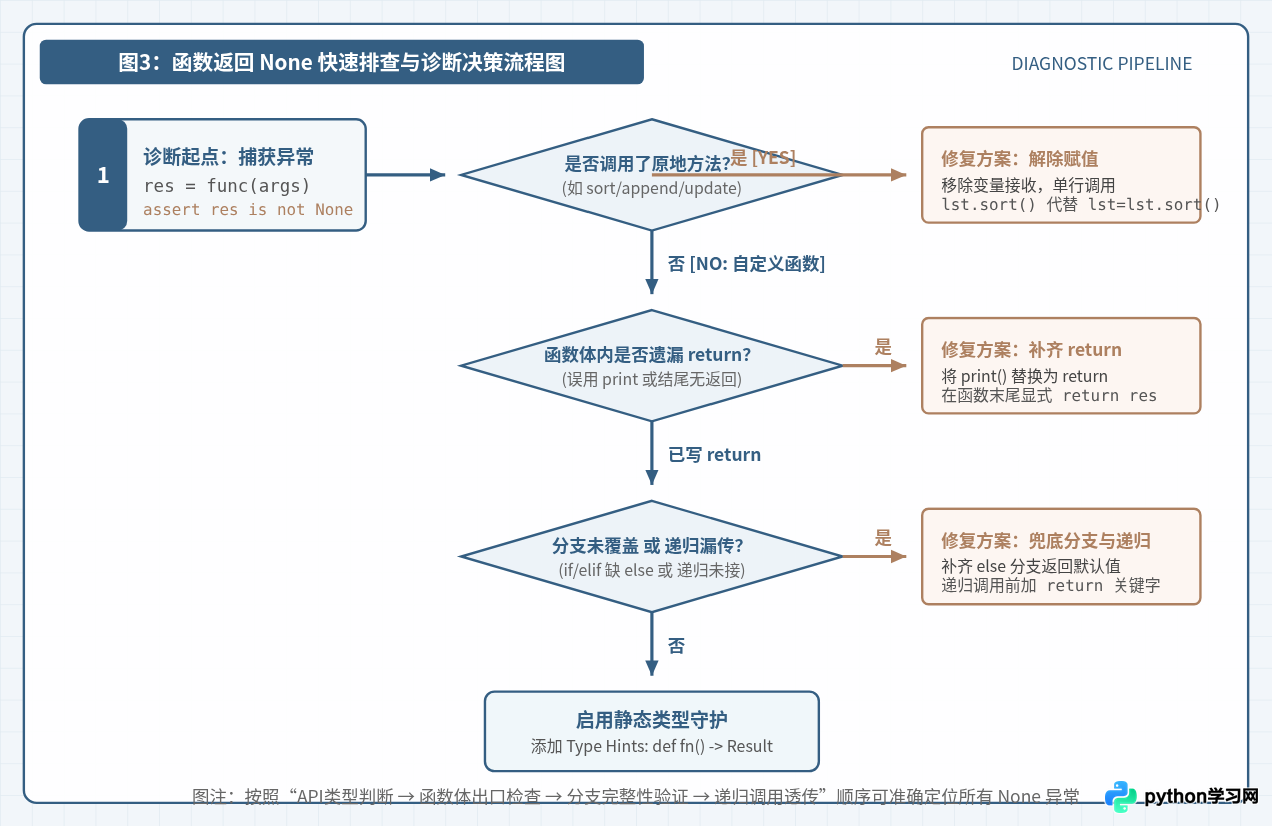
第 1 步:定位第一现场与变量类型检查
在怀疑返回空值的位置,显式打印变量的类型与表示形式。不要依赖肉眼假设,用事实确定异常点:
res = do_something(payload)
print(f"DEBUG: 类型={type(res)}, 实际值={repr(res)}")
if res is None:
    # 立即抛出或断言,防止错误向下游传播
    raise ValueError("do_something 意外返回了 None,请检查该函数的分支与退出点")
第 2 步:核实被调用 API 是否具有“原地修改”性质
检查产生 None 的那一行代码调用的方法名。如果该方法是列表、字典、集合的操作方法(例如 sort、append、reverse、update、add):
- 立刻删除赋值符号左侧的接收变量;
- 将其作为独立的单行语句执行(例如把
arr = arr.sort()改为单独的arr.sort())。
第 3 步:代码静态审查——分支覆盖与 return 穷尽
如果是你自己编写的自定义函数,直接跳转到函数体中核对所有出口:
- 检查尾部出口:函数最外层最后一行是否有
return <变量>? - 检查分支覆盖:每个
if和elif都有对应的return吗?是否存在未命中的情况?必须添加else: return default_value作为兜底。 - 检查递归调用:所有包含自我调用的代码行,开头是否都紧挨着
return?
第 4 步:引入类型注解与静态检查工具防患未然
动态语言的排错成本往往发生在运行期。利用 Python 3 的类型注解(Type Hints),配合 Mypy 或 Pyright 静态检查器,可以在代码编写阶段由 IDE 自动拦截未覆盖分支:
from typing import Optional

# 明确声明必须返回 int,如果遗漏 return,Mypy 会直接报错: Missing return statement
def calculate_tax(income: float) -> float:
    if income <= 5000:
        return 0.0
    elif income <= 20000:
        return (income - 5000) * 0.1
    # 若此处未写 else,静态检查工具将在编码阶段直接高亮警告!
    else:
        return (income - 20000) * 0.2 + 1500.0
六、总结与避坑防错清单
通过以上的原理剖析与排查流程,我们可以将 Python 函数调用与返回值的核心规则凝练为以下全景体系:
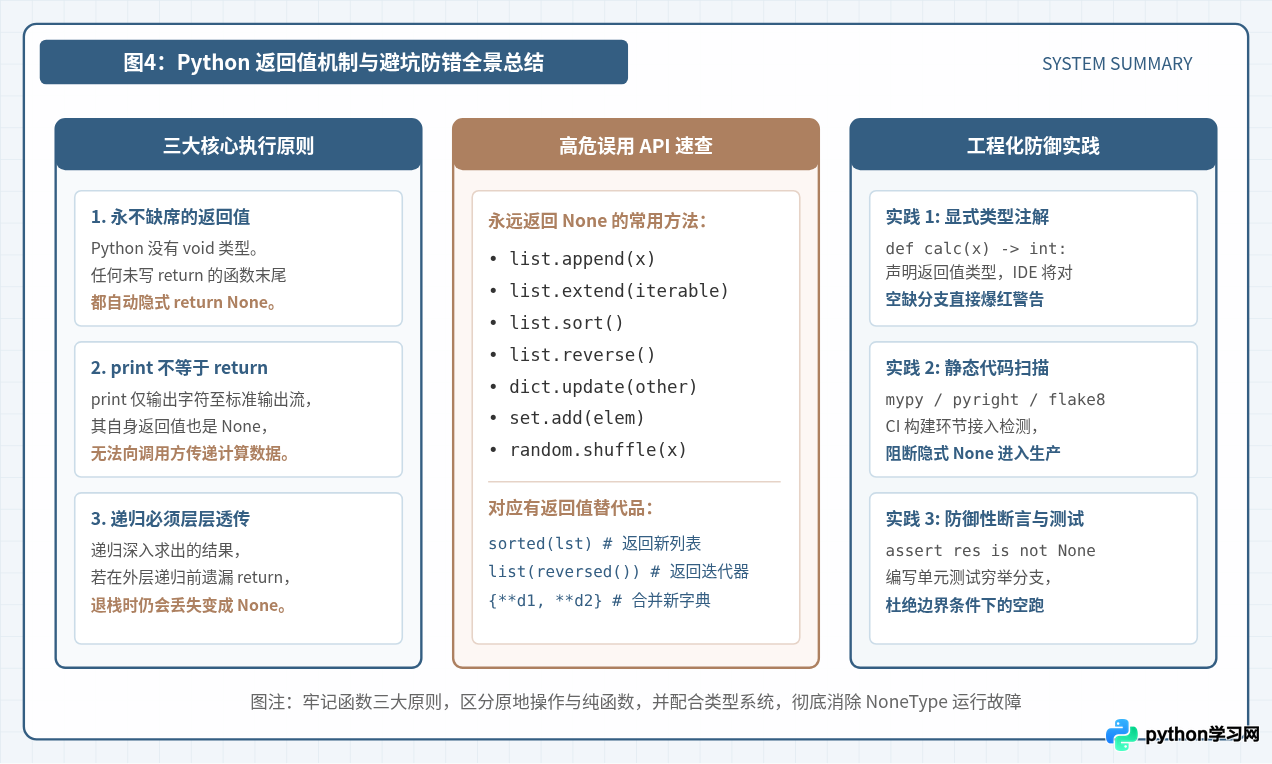
- 查原身:调用内置容器方法先看文档,原地修改不赋值,生成新对象必接收。
- 看末尾:写自定义函数时,时刻牢记最后一行是否要把工作成果交还给调用者。
- 防分支:条件分支多且杂,必须要有
else垫底;递归调用莫单跑,return逐层往外抛。 - 借工具:类型提示加上手,
-> ReturnType标分明,静态分析保无忧。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









