

python必背源代码二维列表创建和转置代码
深入解析 Python 二维列表创建与矩阵转置的核心必背源代码,拆解浅拷贝引用陷阱、zip(*)解包工作原理以及非规则矩阵的边界防御方案。
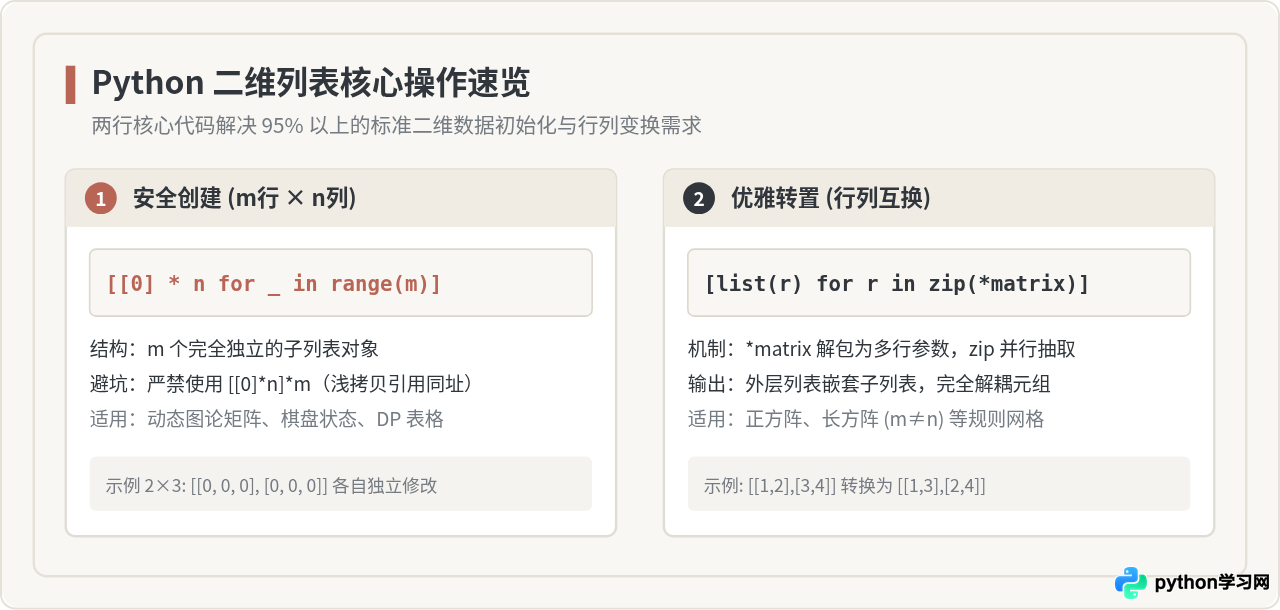
m 行 n 列初始矩阵的必背代码是 matrix = [[0] * n for _ in range(m)];将已有二维列表行列互换(转置)的必背代码是 transposed = [list(row) for row in zip(*matrix)]。掌握这两行源代码的内存机制与执行边界,可以彻底规避浅拷贝篡改与维度越界等经典缺陷。
一、二维列表创建:标准推导式与浅拷贝陷阱拆解
很多初学者在需要快速生成一个指定行数和列数的全 0 矩阵时,本能地会借用一维列表的乘法操作写出类似 [[0] * 3] * 3 的代码。这种写法虽然能在控制台打印出符合预期的 3×3 矩阵,但它在内存结构上埋下了严重的隐患。
1. 乘法初始化的致命缺陷(浅拷贝同一地址)
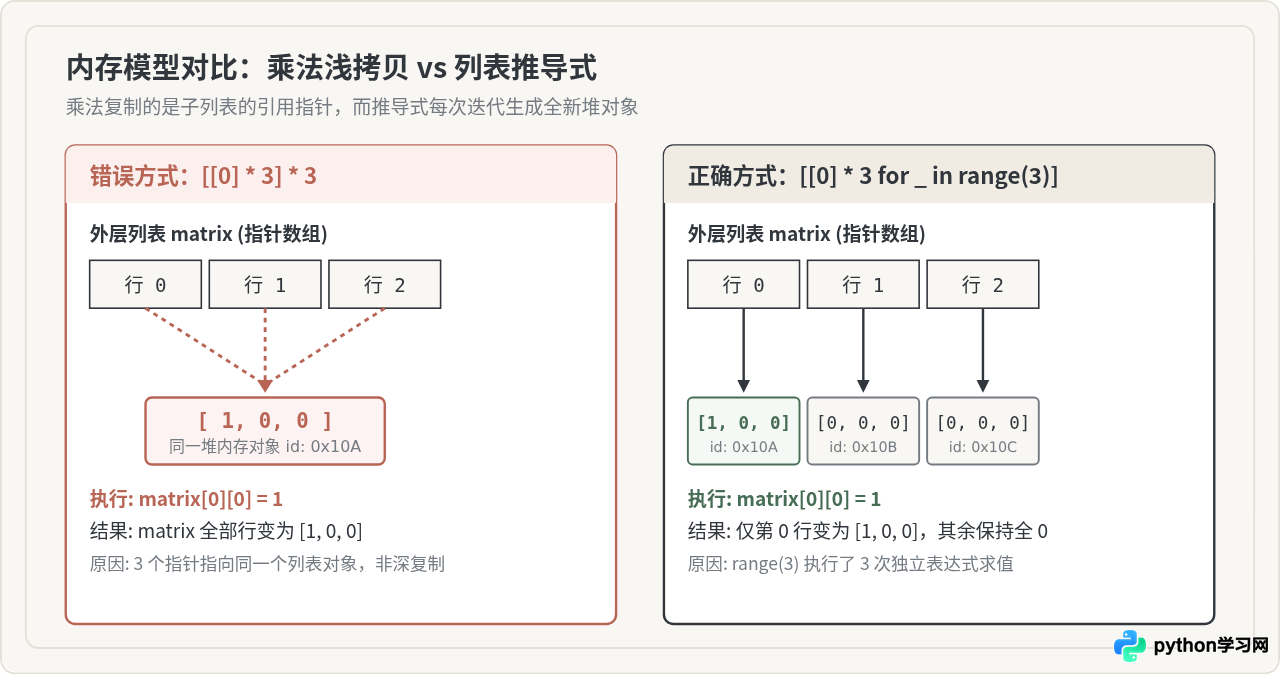
当执行 [0] * 3 时,Python 创建了一个包含 3 个整数 0 的列表对象。然而随后执行的外层 * 3,并没有克隆出 3 个全新的列表,而是把这个内部列表的内存引用地址连续复制了 3 次。其结果是,外层列表中的 3 个子元素实际上都指向同一个内存单元。
# 错误示范:看似成功创建 3x3 矩阵
matrix_wrong = [[0] * 3] * 3

# 尝试修改第 0 行第 0 列的元素
matrix_wrong[0][0] = 1
print(matrix_wrong)

# 示例输出:所有行的第 0 个元素全被同步修改!
# [[1, 0, 0], [1, 0, 0], [1, 0, 0]]
如上述示例输出所示,修改 matrix_wrong[0][0] 会导致所有行的首个元素全部变为 1。在编写棋盘搜索、图的距离矩阵或背包 DP 状态转移时,这种诡异的数据同步往往难以排查。
2. 必背标准写法:列表推导式(List Comprehension)
正确的做法是利用列表推导式让 Python 在每一次迭代时都重新求值,从而在堆内存中独立分配每一个子列表对象:
# 必背源代码:创建 m 行 n 列的独立二维列表(此处 m=3, n=4)
rows, cols = 3, 4
matrix = [[0] * cols for _ in range(rows)]

# 验证独立性:修改第 0 行第 0 列
matrix[0][0] = 99
print(matrix)

# 示例输出:仅第 0 行发生变化,其余各行数据保持原状
# [[99, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]]在这段代码中,range(rows) 驱动循环执行 rows 次,每次循环都会执行一次内层表达式 [0] * cols。因为每次求值都会在内存中新建一个列表,各行之间完全物理隔离,后续的赋值与读写操作互不干扰。
若每个网格的初始值并非固定常数,而是需要依据行号
i 和列号 j 动态计算(例如计算曼哈顿距离或坐标坐标编号),可以使用显式嵌套循环:
matrix = [[i * cols + j for j in range(cols)] for i in range(rows)]。其原理与推导式完全一致,均保证行对象独立。
二、二维列表转置:核心代码实现与执行原理解析
矩阵转置(Matrix Transpose)是指将矩阵的行变为列、列变为行。对于一个 m × n 的二维列表,转置后的形状为 n × m,且满足新矩阵 transposed[j][i] == matrix[i][j]。
1. 必背单行解法:zip(*matrix) 优雅组合
Python 提供了极为简洁且兼具底层 C 级性能的转置语法:利用星号解包操作符 * 配合内置函数 zip()。
# 原始 2 行 3 列的长方矩阵
matrix = [
    [1, 2, 3],
    [4, 5, 6]
]

# 必背源代码:优雅转置为 3 行 2 列
transposed = [list(row) for row in zip(*matrix)]
print(transposed)

# 示例输出:成功将 2x3 转换为 3x2
# [[1, 4], [2, 5], [3, 6]]
2. 核心原理拆解:为什么 zip(*matrix) 能实现转置?
这行简短代码能够实现矩阵转置,依赖于 Python 中两项关键特性的配合:
- 第一步:参数解包(* 操作符):
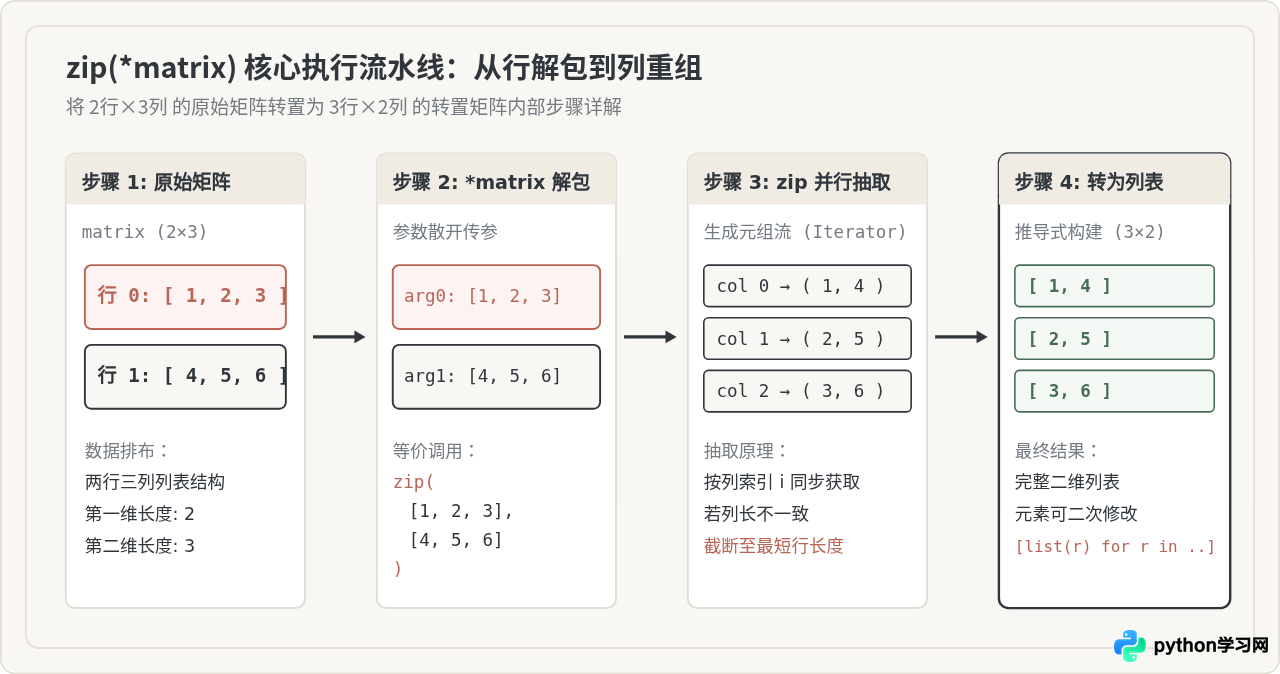
matrix本身是一个包含两个子列表的容器。调用zip(*matrix)相当于将外层列表“脱壳”,等价于向zip传入两个独立的参数:zip([1, 2, 3], [4, 5, 6])。 - 第二步:按索引并行配对(zip 函数):
zip的工作机制是同时遍历所有传入的可迭代对象。第一次循环分别取出各个序列的第 0 个元素,组成元组(1, 4);第二次取出第 1 个元素组成(2, 5);第三次取出第 2 个元素组成(3, 6)。这恰好对应原始矩阵的第 0 列、第 1 列和第 2 列。 - 第三步:显式还原为列表(list(row)):
zip生成的每一个元素都是元组(Tuple)。元组属于不可变对象,若直接使用list(zip(*matrix)),得到的是[(1, 4), (2, 5), (3, 6)]。为了让转置后的子序列依然能够被修改,必须在外层使用列表推导式结合list(row)重新封装为标准二维列表。
3. 备选方案:双层列表推导式转置
如果是在对内置函数有严格限制的基础教学环境或需要向初学者解释数学索引对应关系时,双层列表推导式是另一种完全可行的思路:
# 方案二:基于索引的双层推导式
matrix = [[1, 2, 3], [4, 5, 6]]
cols = len(matrix[0])

transposed_comp = [[row[i] for row in matrix] for i in range(cols)]
print(transposed_comp)

# 示例输出:[[1, 4], [2, 5], [3, 6]]
该写法的阅读逻辑是:外层循环遍历原矩阵的列索引 i(从 0 到 2),内层循环从每一行 row 中提取该列索引对应的元素 row[i] 汇聚成新的一行。虽然逻辑直观,但其循环完全在 Python 虚拟机解释层运行,性能较底层的 zip 略逊一筹。
三、工程防坑:矩形阵、非规则数组与空矩阵防御
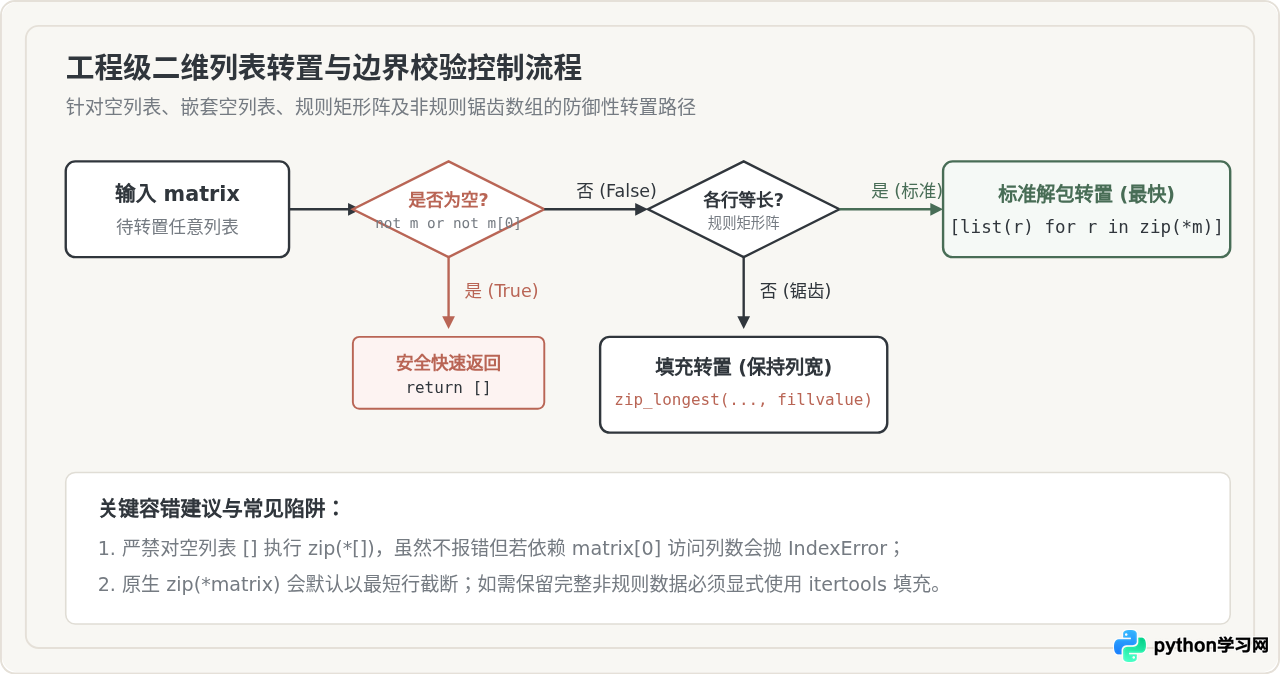
在算法练习或工业代码中,输入数据往往不可控。直接调用转置代码前,必须明确其适用边界与异常场景。
1. 空列表与空行防御
当输入为空列表 [] 时,执行 zip(*[]) 会得到空迭代器,[list(r) for r in zip(*[])] 会正常返回 []。但是,如果输入是 [[]](包含一个空列表的一维外层),解包后 zip([]) 同样返回空。如果使用依赖索引的推导式方案访问 matrix[0],则会抛出 IndexError。因此,健壮的封装应当先做非空检查:
def safe_transpose(matrix):
    # 针对 None、空列表 [] 或空行 [[]] 的防御判断
    if not matrix or not matrix[0]:
        return []
    return [list(row) for row in zip(*matrix)]
2. 非规则二维列表(锯齿形数组)处理
如果二维列表中各行的长度不一致(例如 matrix = [[1, 2, 3], [4, 5]]),标准 zip() 会以最短的序列为基准自动截断多余元素,导致第 3 列的 3 丢失。若业务需要完整保留所有列信息并对缺失位赋予默认值,可以使用标准库 itertools.zip_longest:
from itertools import zip_longest

matrix_jagged = [
    [1, 2, 3],
    [4, 5]
]

# 填充缺失值为 None
transposed_jagged = [list(row) for row in zip_longest(*matrix_jagged, fillvalue=None)]
print(transposed_jagged)

# 示例输出:保持了 3 列完整性
# [[1, 4], [2, 5], [3, None]]
四、方案综合对比与全景选型总结
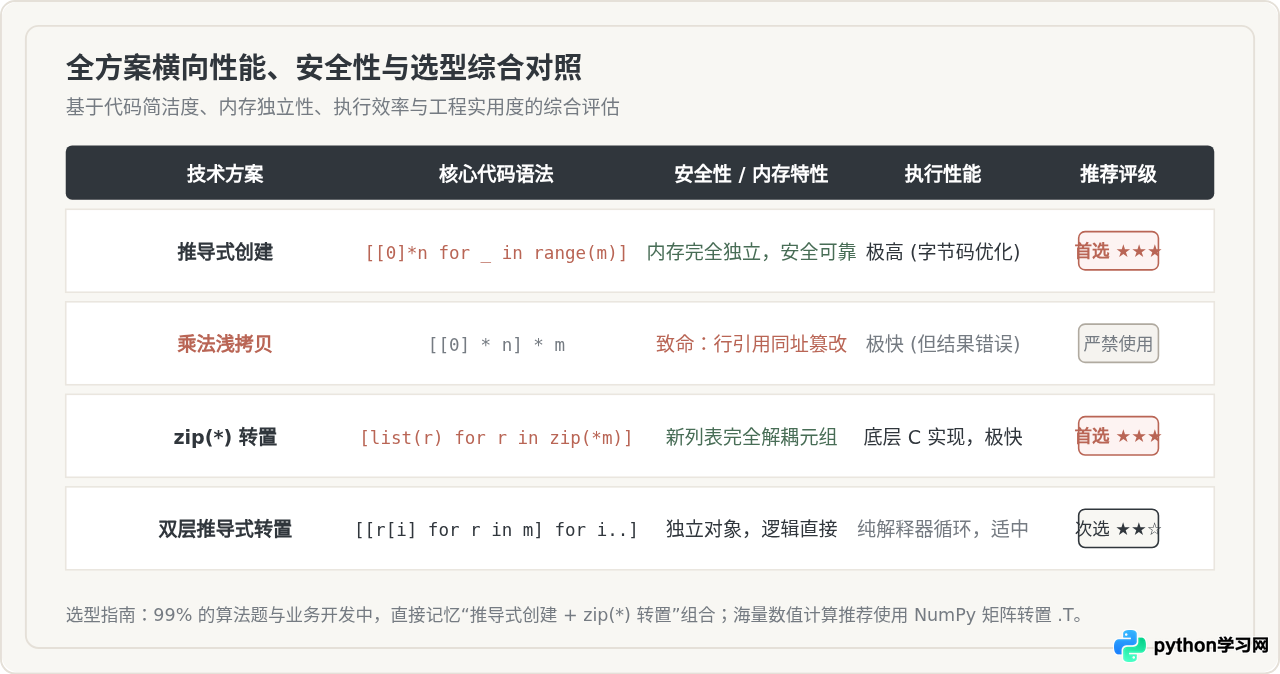
为了帮助读者根据具体业务场景快速做出合理选择,下表将本文介绍的各个二维列表创建与转置方案进行了全方位属性对比:
| 分类 | 实现方案 | 源代码示例 | 内存安全性 | 执行性能 | 工程建议 |
|---|---|---|---|---|---|
| 创建 | 列表推导式 | [[0] * n for _ in range(m)] |
完全独立 | 快(字节码优化) | 首选方案,适合任意规模初始化 |
| 乘法浅拷贝 | [[0] * n] * m |
危险同址 | 极快(但逻辑错误) | 严禁使用,仅修改一处会导致全列变动 | |
| 转置 | zip(*) 组合拳 | [list(r) for r in zip(*m)] |
新对象生成 | 极快(底层 C 循环) | 首选方案,标准 Pythonic 风格 |
| 双层推导式 | [[r[i] for r in m] for i in ..] |
新对象生成 | 中等(纯解释层循环) | 次选,教学或索引公式直译时使用 | |
| zip_longest | zip_longest(*m, fillvalue=..) |
新对象生成 | 快 | 仅适用于非规则长短不一的锯齿数组 |
五、全文结论与记忆口诀
在 Python 核心语法范畴内,熟练背诵并应用以下两行源代码即可涵盖绝大部分日常开发任务:
- 创建二维列表:记住“内乘外推导”——即
[[0] * n for _ in range(m)]。内层用乘法快速复制不可变整数,外层务必使用推导式生成独立的行对象。 - 转置二维列表:记住“解包配对转列表”——即
[list(r) for r in zip(*matrix)]。利用*解开行,用zip压成列,再用list保证元素的可变性。
当数据规模达到上千万级别且涉及大量线性代数计算时,原生列表遍历会受限于 Python 对象头和动态类型的开销,届时应平滑升级至专业科学计算库(如 import numpy as np; arr.T)。但在基础算法与日常业务开发中,本篇介绍的两行必背源代码依然是兼具优雅性与可靠性的最佳解法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









