

Python PEP 8规范:何时使用下划线命名,何时使用点调用
深入解析Python PEP 8代码规范中下划线命名的约定规则与点调用语法的本质区别,结合具体场景阐明标识符定义与命名空间寻址的协作逻辑。
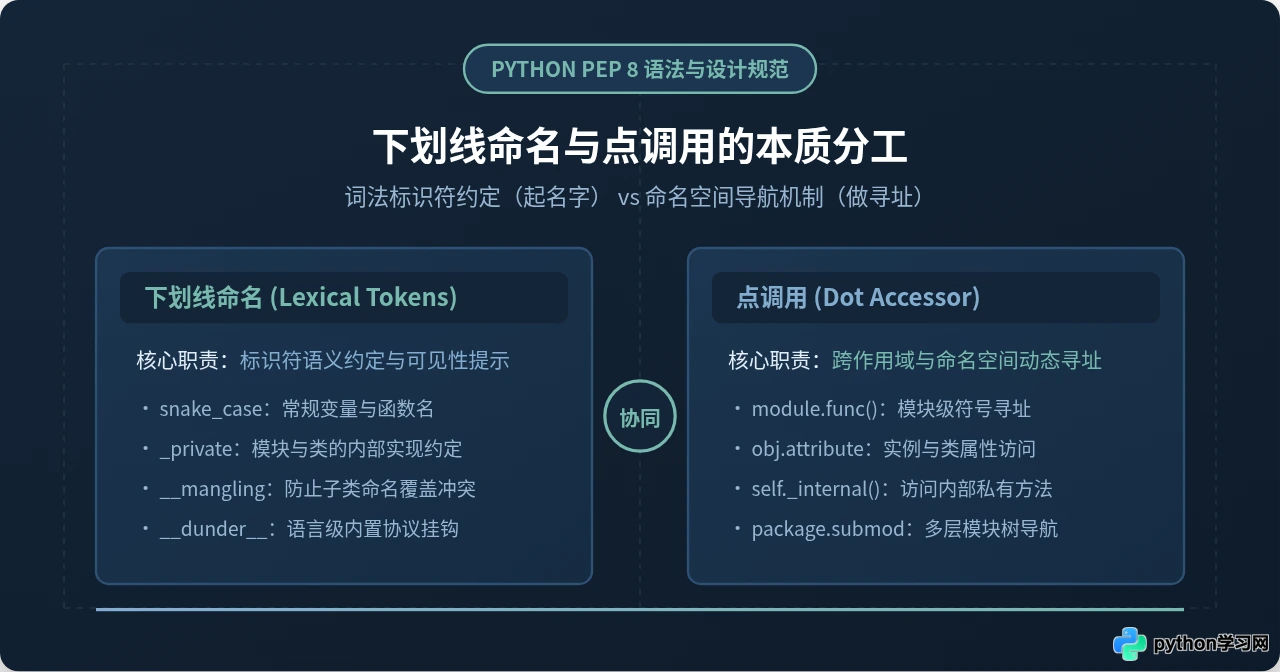
在编写 Python 代码时,许多开发者常被两种语法现象困扰:一是标识符中形式各异的下划线(例如 user_name、_internal_cache、__init__),二是用于访问属性和方法的点号(例如 user.profile.name、math.sqrt())。有人会困惑:何时该将一段业务逻辑写成下划线分隔的独立函数,何时该将其组织进对象通过点号调用?带单下划线的私有方法 _helper() 在使用时,为什么依然要通过 self._helper() 进行点调用?
核心结论在于:下划线命名是词法层面的“标识符命名规范”,用于规定变量、函数或类自身如何命名以表达语义和可见性;而点调用是语法层面的“命名空间寻址机制”,用于在模块、类和对象层级之间导航和解析成员。两者不是二选一的对立关系,而是一内一外、相互配合的工程机制。
一、核心概念厘清:命名标识符与命名空间寻址的分工
要准确遵循 PEP 8 规范,必须先厘清“名字是怎么拼写的”与“名字是怎么找到的”这两层底层逻辑。
在 Python 的词法分析阶段,下划线 _ 只是一个合法的标识符字符。PEP 8 规范通过约定下划线的位置和数量(如单前缀、双前缀、双环绕),赋予了标识符不同的可见性约束与语义提示。例如,_validate() 告诉外部调用者“这是一个内部辅助方法,请勿依赖”,但这仅属于约定,Python 解释器并不会在语法层面直接封锁其访问。
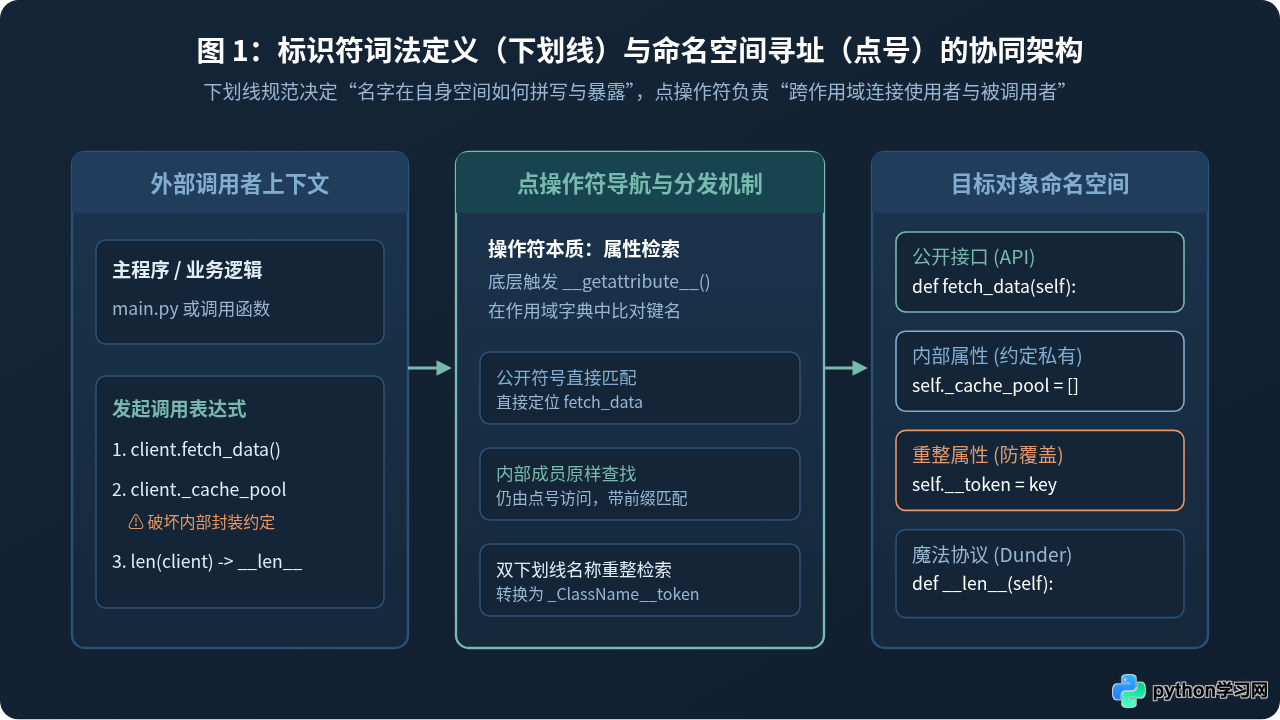
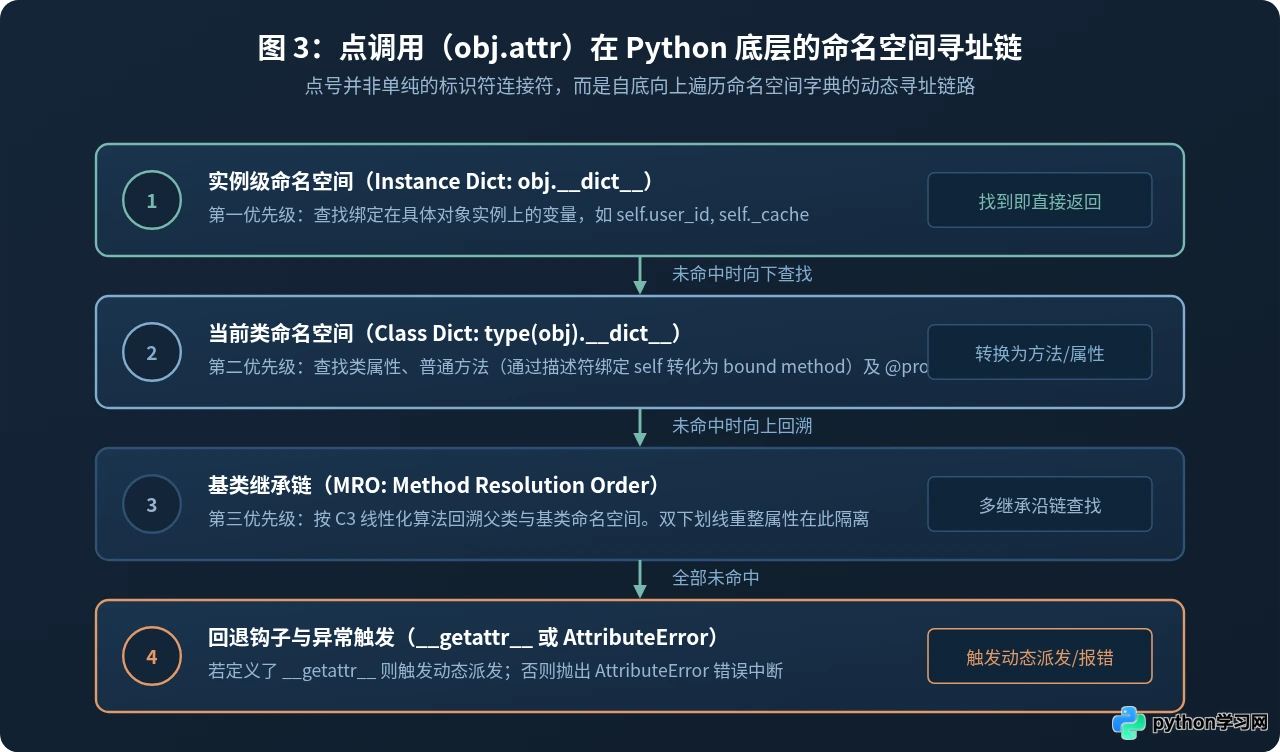
点操作符 . 则是 Python 语法层面的核心成员访问运算符。每当执行 a.b 时,Python 会触发属性检索协议(底层调用 __getattribute__),沿着命名空间字典自底向上查找符号 b。点调用的出现,意味着发生了跨命名空间(Scope)的成员访问——无论是从模块访问导出函数、从类访问静态属性,还是从实例访问绑定的成员方法。
二、PEP 8 下划线命名的六种标准模式与适用边界
PEP 8 对下划线的使用场景做出了明确而严谨的规定。在定义变量、函数、方法和模块时,应根据其实际作用域和对外契约严格匹配以下六种模式:
1. 标准小写加下划线(snake_case)
适用场景:所有普通变量、函数形参、模块级函数以及公有类方法。模块名(Python 文件名)也应采用简短的小写下划线命名(如 data_loader.py)。
# 示例:符合规范的常规变量与公有函数
user_account_id = 10024
max_retry_limit = 3

def calculate_tax_amount(base_income: float, rate: float) -> float:
    return base_income * rate
2. 单前导下划线(_single_leading_underscore)
适用场景:弱内部使用提示(Weak "internal use" indicator)。当某个函数或类属性仅供当前模块或类内部协作、不承诺向外部维护向后兼容时使用。
- 模块级影响:在模块顶层定义的
_helper_func(),在使用from module import *时会被自动忽略(除非在__all__中显式声明)。 - 类属性影响:提示子类或外部调用者该属性属于实现细节,应避免直接修改。
# data_pipeline.py 示例
def run_pipeline(data: list) -> list:
    """对外暴露的公开接口"""
    clean_data = _sanitize_records(data)
    return clean_data

def _sanitize_records(data: list) -> list:
    """仅供本模块内部使用的辅助函数"""
    return [item.strip() for item in data if item]
3. 单末尾下划线(single_trailing_underscore_)
适用场景:避免与 Python 关键字发生命名冲突。当最贴切的参数名称恰好是 Python 保留关键字(如 class、type、id、in)时,在末尾追加单下划线,而不是采用拼写错误或臆造缩写。
# 避免与内置关键字 class 和 def 冲突
def filter_by_schema(dataset: list, class_: str, timeout_: int = 30):
    return [row for row in dataset if row.get("type") == class_]
4. 双前导下划线(__double_leading_underscore)
适用场景:名称重整(Name Mangling)。仅在面向对象继承体系中,为了防止子类属性与父类属性发生意外命名冲突时使用。解释器会自动将 __attr 改写为 _ClassName__attr。
很多其他语言背景的开发者习惯用 __attr 模拟 private。Python 并不存在绝对私有机制,名称重整主要是为了多继承时避免覆写父类核心私有字段。滥用双下划线会导致单元测试 Mock 困难、调试堆栈可读性降低。常规内部属性应优先使用单下划线 _attr。
5. 前后双下划线(__double_leading_and_trailing_underscore__)
适用场景:Python 语言特有的“魔法对象”或协议方法(Dunder Methods,如 __init__、__repr__、__call__、__getitem__)。
严格规范:这些名称由 Python 官方核心规范保留。开发者绝不应擅自发明自定义的 __custom_method__,以免与未来版本的 Python 内置协议发生冲突。
6. 独立单下划线(_)
适用场景:作为占位符,显式指示“此变量在此处不会被使用”,常用于元组解包、忽略循环计数器或捕获无需使用的返回值。
# 示例:明确抛弃不需要的中间数据
records = [("Alice", 28, "Engineer"), ("Bob", 32, "Manager")]
for name, _, role in records:
    print(f"{name}: {role}")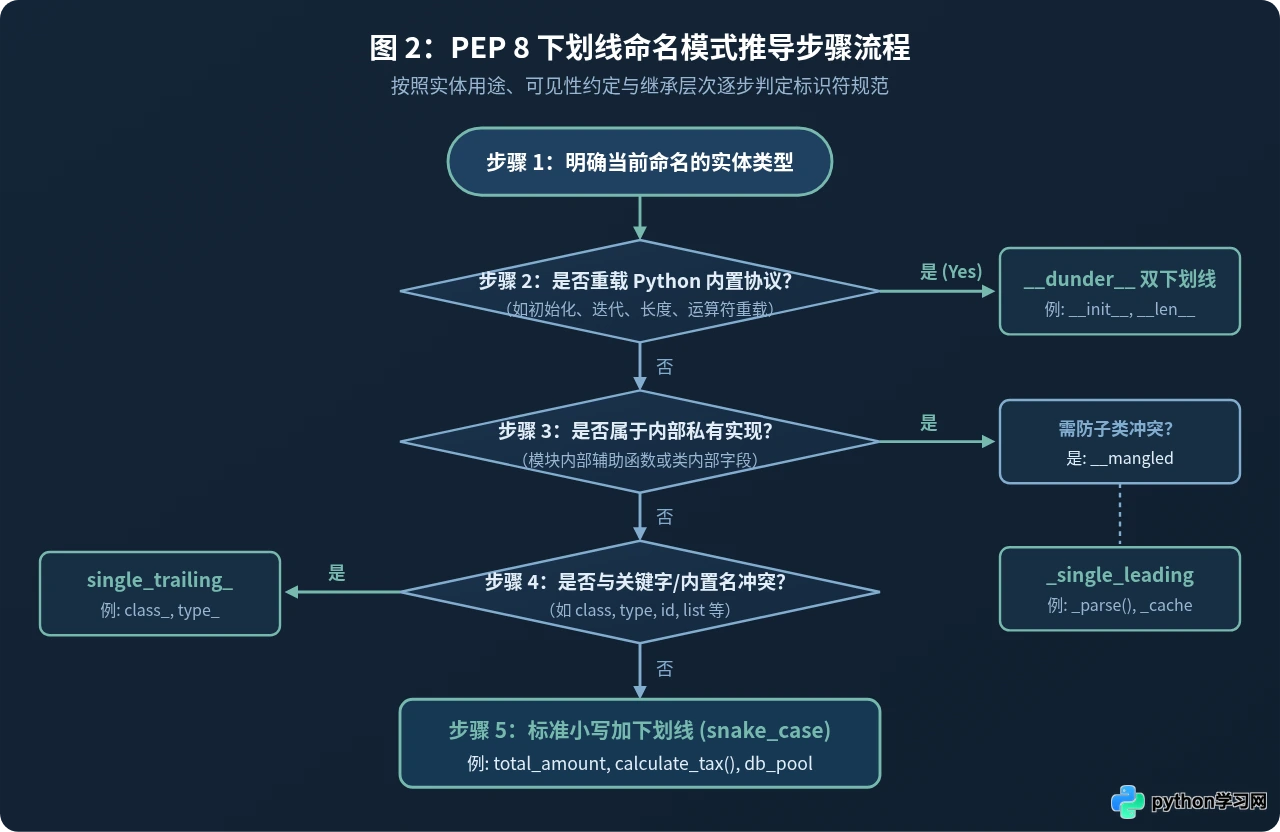
三、何时使用点调用:命名空间导航与对象职责划分
理解了下划线的命名规范后,何时应该使用点调用 . 便有了清晰的判断标准:只要存在明确的归属边界、跨越命名空间边界或需要由对象持有状态时,就必须使用点调用。
1. 跨模块调用服务能力
当功能被组织在独立的模块或包中时,应当通过模块名进行点调用,保持符号归属的透明清晰:
# 推荐做法:显式点调用,保持命名空间清晰
import json
import os.path

data = json.loads(payload)
exists = os.path.exists(file_path)

# 反模式:from json import *(彻底抹除点调用,破坏命名空间隔离)
2. 访问类实例的状态与行为
面向对象设计的核心在于“数据与操作的内聚”。如果一系列数据与方法是围绕某个具体实体紧密绑定的,就应该将其封装为类,并通过实例点调用:
class DatabaseConnection:
    def __init__(self, dsn: str):
        self.dsn = dsn
        self._is_connected = False
        self._pool = []

    def connect(self) -> None:
        """公有接口:点调用"""
        self._setup_socket()
        self._is_connected = True

    def _setup_socket(self) -> None:
        """内部方法:定义用下划线,调用依然使用点号 self._setup_socket()"""
        pass

# 使用示例
db = DatabaseConnection("sqlite:///:memory:")
db.connect()  # 点调用外部公有方法
注意上述代码中极其关键的细节:即使 _setup_socket 采用了单下划线内部命名,但在实例内部调用它时,依然必须写为 self._setup_socket()。这再次印证了核心逻辑:下划线是名字的拼写(说明其是内部私有),而点号是访问该名字的语法路径。
3. 点调用的底层寻址链
每次使用点调用 obj.name,Python 会执行标准的多层检索协议。如果所有命名空间均未命中,最终会调用 __getattr__ 或抛出 AttributeError。
四、最易混淆的四个典型决策场景
场景 1:内部辅助函数究竟做成顶层函数,还是类内部的 self._func()?
- 选择独立模块级下划线函数(
def _calc():):该函数是纯计算函数,不需要读写当前类的实例状态(self)。将其移出类作为模块私有函数,能有效降低类的方法膨胀,提高纯逻辑的可测试性。 - 选择类内部点调用方法(
self._calc()):该函数严重依赖实例内部字段(如self.config、self._cache),若剥离成独立函数需要传递大量self内部参数。
场景 2:扁平下划线变量 vs 结构化点调用对象
在设计业务数据时,初学者常写出类似 order_shipping_address_city 这样的超长下划线变量。PEP 8 推荐将具备层级关系的领域实体提炼为结构化模型(如 dataclass):
# 不推荐:冗长且扁平的下划线变量拼贴
order_recipient_name = "张三"
order_shipping_address_province = "浙江省"
order_shipping_address_city = "杭州市"

# 推荐:结构化对象,通过有意义的点调用表达层级
from dataclasses import dataclass

@dataclass
class Address:
    province: str
    city: str

@dataclass
class Order:
    recipient_name: str
    shipping_address: Address

order = Order(
    recipient_name="张三",
    shipping_address=Address(province="浙江省", city="杭州市")
)
# 点调用自然清晰
print(order.shipping_address.city)
场景 3:魔法方法的定义与调用差异
所有的双下划线魔法方法必须在类中以 __method__ 命名声明,但在外部调用时绝不应直接写点调用 obj.__len__(),而应使用对应的 Python 内置函数:
class CustomCollection:
    def __init__(self, items):
        self._items = list(items)

    def __len__(self) -> int:
        return len(self._items)

coll = CustomCollection([1, 2, 3])

# 推荐:通过 Python 内置协议间接分发(底层走 C 级槽位,性能更好且符合惯用法)
count = len(coll)

# 违背 PEP 8 风格:禁止直接点调用魔法协议方法
count_bad = coll.__len__()  # 避免如此编写
场景 4:链式调用的节制(笛米特法则)
点调用虽然能穿透层级,但多层深层调用(例如 user.get_department().get_manager().get_email())会导致调用方与深层结构过度耦合。PEP 8 建议在对象内部提供委托方法(例如 user.get_manager_email()),避免代码脆弱难以重构。
五、规范重构实战:从命名混乱到清晰整洁
下面看一段典型的反例代码,并演示如何将其重构为符合 PEP 8 标准的高质量代码:
# ===================== 重构前:命名与职责混淆的反模式 =====================
class data_handler:  # 错误1:类名应为 CapWords(驼峰命名)
    def __init__(self):
        self.DATA_LIST = []  # 错误2:实例属性不应使用全大写(全大写保留给常量)
        self.__secret_key = "k-1092"  # 错误3:无继承覆盖风险时,滥用双下划线导致测试困难

    def PROCESS_AND_SAVE_USER_DATA(self, user_name, user_age, user_city):
        # 错误4:普通方法不应使用大写;参数应结构化
        cleaned_name = user_name.strip()
        self.DATA_LIST.append({"name": cleaned_name, "age": user_age, "city": user_city})

    def get_len(self):  # 错误5:自定义获取长度方法,未挂钩 Python 内置 len() 协议
        return len(self.DATA_LIST)
重构后的代码严格遵循 PEP 8 的标识符命名约定,并通过合理的对象与点调用划分职责:
# ===================== 重构后:符合 PEP 8 的标准工程实践 =====================
from dataclasses import dataclass

@dataclass
class UserProfile:
    """数据实体使用结构化点访问"""
    name: str
    age: int
    city: str

class DataHandler:
    """类名遵循 CapWords 规范"""
    def __init__(self, secret_key: str):
        # 内部状态使用单前导下划线约定保护
        self._data_records: list[UserProfile] = []
        self._secret_key = secret_key

    def record_user(self, profile: UserProfile) -> None:
        """公有接口:清晰的 snake_case"""
        sanitized_profile = self._clean_profile(profile)
        self._data_records.append(sanitized_profile)

    def _clean_profile(self, profile: UserProfile) -> UserProfile:
        """内部实现:单下划线私有约定,内部通过 self._clean_profile 访问"""
        return UserProfile(
            name=profile.name.strip(),
            age=profile.age,
            city=profile.city.strip()
        )

    def __len__(self) -> int:
        """重载内置协议,供外部直接使用 len(handler) 调用"""
        return len(self._data_records)

# 外部调用实践
handler = DataHandler(secret_key="prod_safe_token")
user = UserProfile(name="  王小明  ", age=26, city="  上海市  ")

# 1. 公开方法点调用
handler.record_user(user)

# 2. 内置协议调用(绝不调用 handler.__len__())
total_users = len(handler)
print(f"当前已记录用户数: {total_users}")
六、总结与决策清单
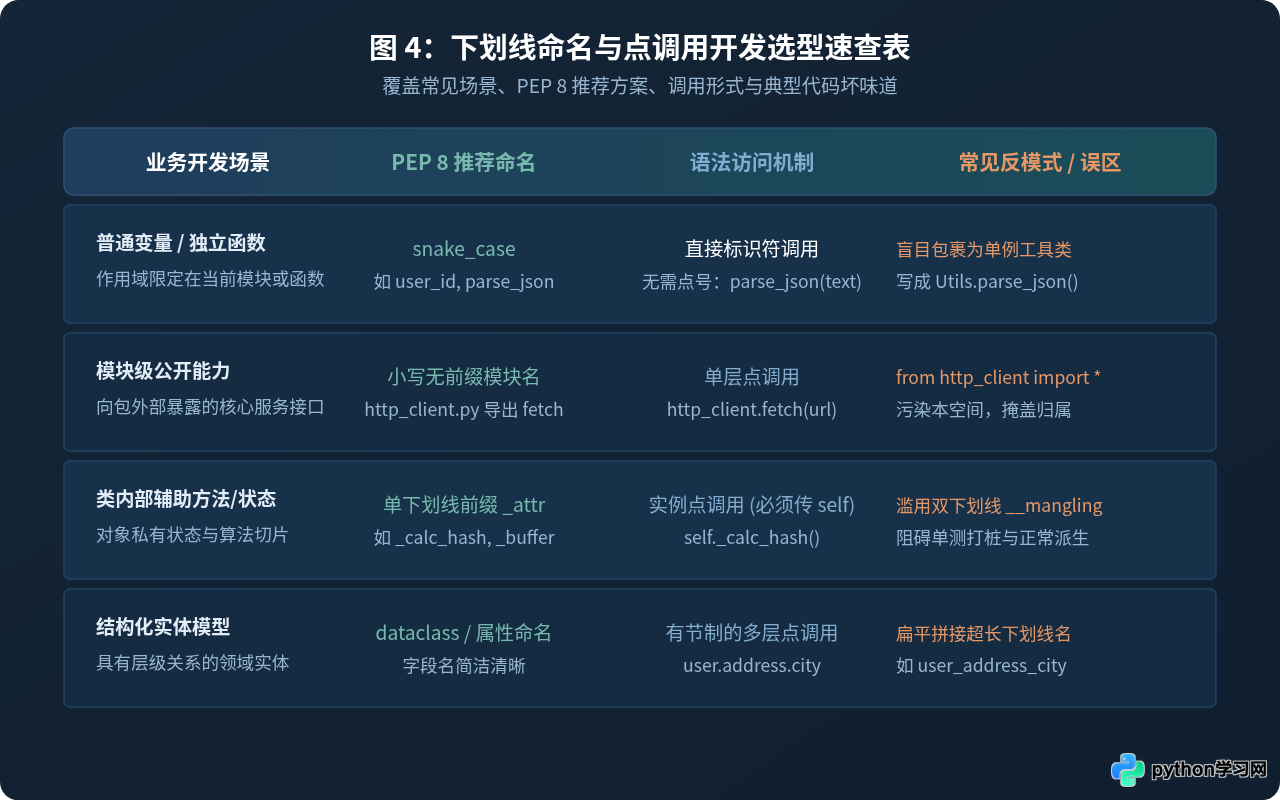
| 决策问题 | 选用方案 | 语法与书写示例 |
|---|---|---|
| 给普通变量、函数、参数起名 | 蛇形命名(snake_case) | total_count, fetch_user_list() |
| 类或模块内部的辅助实现 | 单下划线前缀(约定私有) | 定义: def _parse(self)调用: self._parse()(仍用点调用) |
| 变量名与保留字冲突 | 单下划线后缀 | class_, type_, id_ |
| 挂钩 Python 核心内置协议 | 双下划线环绕(Dunder) | 定义: def __iter__(self)调用: iter(obj)(禁止点调用魔法方法) |
| 访问跨作用域、模块或对象的成员 | 点调用运算符(.) | module.func(), instance.property |
| 多级关联数据表达 | 组合对象 + 有节制的点调用 | user.shipping_address.city |
在日常开发中,只要时刻记住“下划线用来定义名字的性质,点号用来指明名字的归属”,就能在编写 Python 代码时自然写出既符合 PEP 8 规范又具备良好架构弹性的优秀代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









