

Python爬虫中文乱码问题怎么处理
针对Python爬虫中常见的中文乱码问题,系统梳理乱码根源,提供标准排查步骤、核心解码方案(Requests/HTTPX/BeautifulSoup)及结果验证方法。
核心结论与解决路径:Python 爬虫抓取网页出现中文乱码,根源几乎都是“用错误的字符集去解码网络原始字节流”。解决该问题不需要盲目尝试各种转码函数,标准路径非常确定:获取未经加工的原始字节流 response.content,准确识别目标网页的真实编码(UTF-8、GBK、GB2312 或 GB18030),最后在程序中显式指定编码进行解码。掌握这个原则,所有类型的爬虫乱码均可在几行代码内彻底解决。
一、乱码从何而来:字符解码的本质逻辑
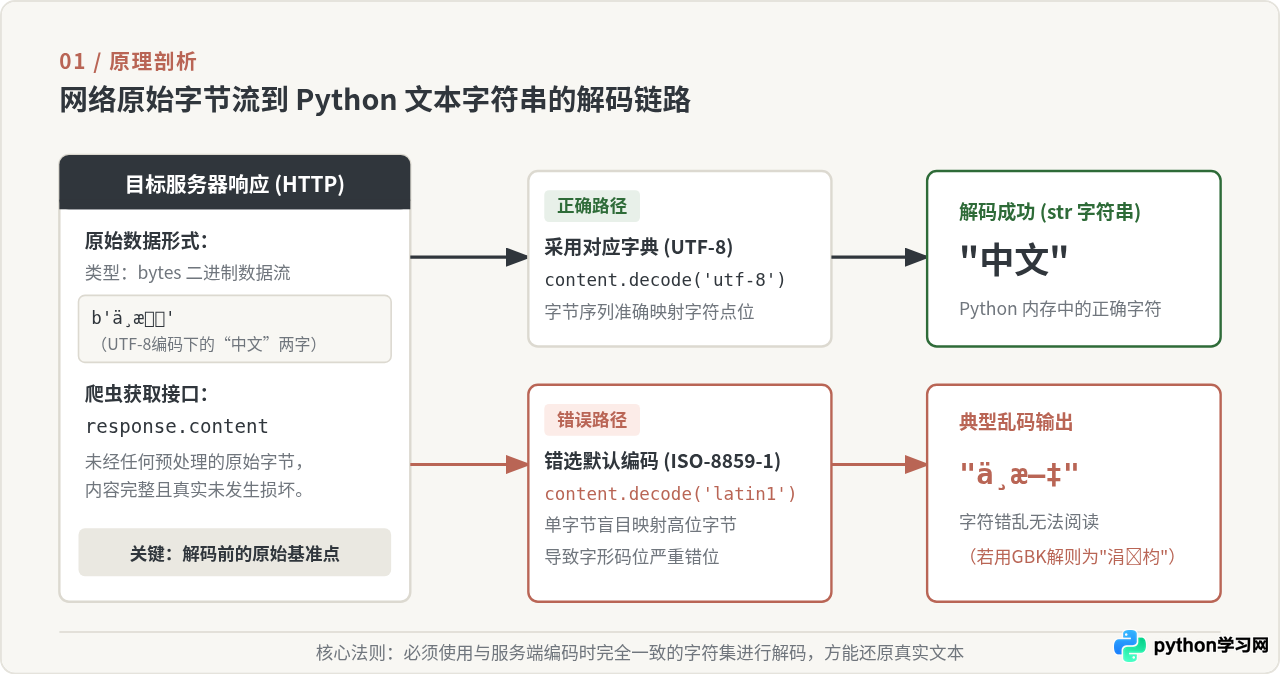
在排查乱码前,首先需要理清 HTTP 数据在网络传输与 Python 内存中的形态变化。网络上传输的一切 HTML 网页,在物理层面上都只是一长串二进制字节流(在 Python 3 中表示为 bytes 类型)。服务器在向外发送网页时,先按照某一套“密码本”(字符编码,例如 UTF-8 或 GBK)把人类可读的文字转换成字节;爬虫拿到这串字节后,必须使用完全相同的密码本,才能将其还原为 Python 内存中的 str(Unicode 字符串)。
一旦解码时选错了密码本,就会产生字符错位,表现为人类不可读的“乱码”。常见乱码形式与成因如下:
- 拉丁字母乱码(如
ä¸æ–‡):目标网页原本使用 UTF-8 编码(每个汉字占用 3 个字节),但爬虫库按照单字节的 ISO-8859-1(Latin-1)规范去解码,把 1 个汉字的 3 个字节拆开解读成了 3 个西欧字母。这是使用requests.get().text时最常见的乱码形态。 - 生僻方块字乱码(如
涓枃):目标网页原本为 UTF-8 编码,却被错误当成了双字节的 GBK 进行解码,两两字节强行拼凑出怪异字。 - Unicode 逃逸序列(如
中文):服务器返回的是 JSON 字符串字面量或转义字符,未经过反序列化或 Unicode 转义解析,并非真正意义上的编码错误。 - 锟斤拷乱码(
锟斤拷锟斤拷):字节流在某次错误解码时遇到了无法识别的字节,被替换为 Unicode 占位符�(即黑色问号菱形),随后再次被以 GBK 形式重新保存或展示,形成不可逆的损坏。
二、标准排查四步法:如何准确获知网页真实编码
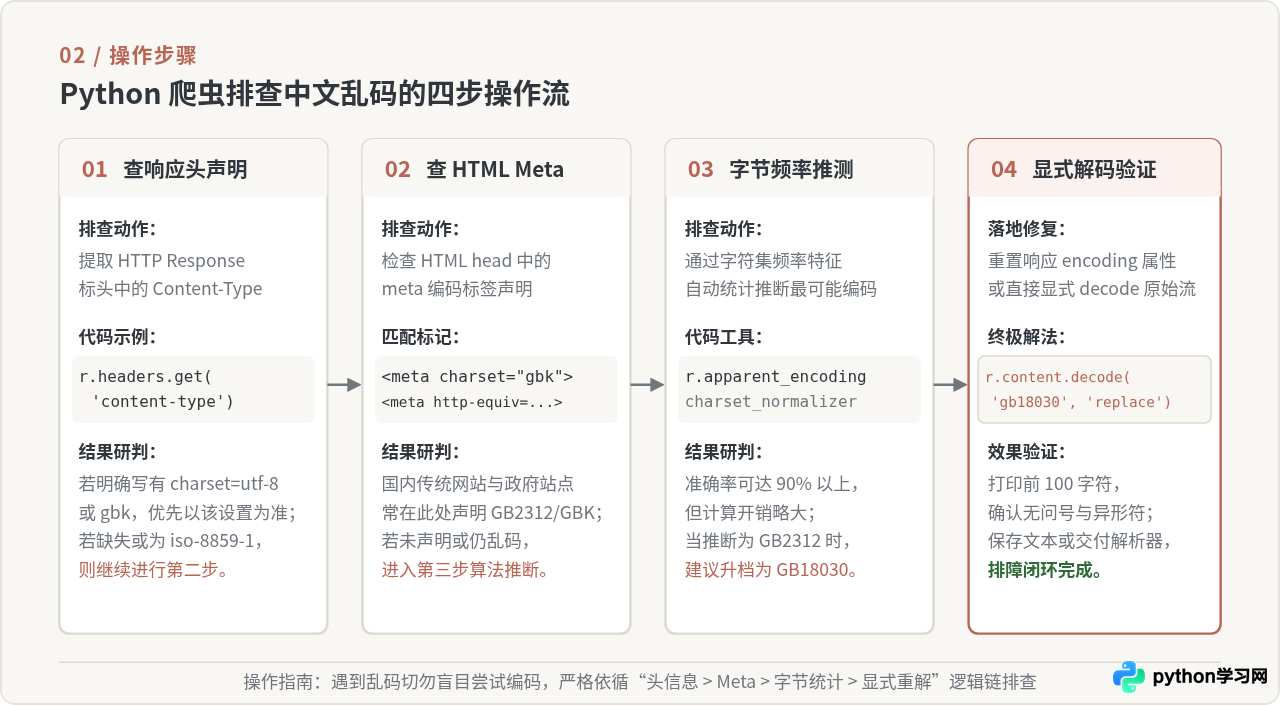
遇到乱码后,不要随意嵌套 .encode('gbk').decode('utf-8') 这类胡乱组合的语句。请严格依循以下四个步骤排查:
第 1 步:检查 HTTP 响应头中的 Content-Type
规范的 Web 服务器会在返回数据的头部明确标注字符集,例如 Content-Type: text/html; charset=utf-8。在 Requests 中可以直接查看标头:
import requests

r = requests.get('https://example.com')
print(r.headers.get('content-type'))
# 输出示例:text/html; charset=gbk
如果响应头中给出了明确的 charset,且该声明属实,Requests 会自动将 r.encoding 设为该值。但实际抓取中,大量网站的服务器并未在响应头配置 charset,或者配置了错误的默认值,导致爬虫陷入误区。
第 2 步:查看 HTML 源码中的 Meta 声明
当响应头缺失 charset 时,必须检查 HTML 网页内部 <head> 区域内的 Meta 标签。常见的声明形式有:
<!-- HTML5 规范声明 -->
<meta charset="gb2312" />

<!-- 传统 HTML4 规范声明 -->
<meta http-equiv="Content-Type" content="text/html; charset=gbk" />
大量国内政府网站、传统论坛和地方门户站点,虽然服务端没有配置 HTTP 响应头,但在 HTML 文档的 Meta 标签中明确写明了使用 gb2312 或 gbk。此时只要提取该字段,即可知道真实编码。
第 3 步:使用字符集统计算法推断(apparent_encoding)
如果响应头和 Meta 标签均未声明编码,或者网页声明的编码与实际内容不符,可以使用字符集推测算法。Requests 库内置了 r.apparent_encoding(底层基于 charset_normalizer 或 chardet),它会扫描响应内容的二进制特征与字节频率,推测出最匹配的编码:
print(r.apparent_encoding)
# 输出示例:GB2312 或 utf-8需要说明的是,apparent_encoding 是通过抽样分析实现的概率推断,耗时比直接读取头部稍长,但在绝大多数无标头声明的场景下准确率极高。
第 4 步:使用目标编码进行显式解码与验证
确定真实编码后,在 Python 中对原始数据执行显式解码。验证时,务必截取一段包含中文的文本(例如前 200 个字符)打印到控制台,确认中文显示清晰、标点符号规范且无任何替换问号,确认无误后再进行下一步的数据解析。
三、各大爬虫与解析库的实操解决方案
不同的请求与解析库在处理编码时有不同的默认行为,下面分别给出标准的解决代码。
1. Requests 库的标准解决方式
使用 Requests 抓取网页时,产生乱码的最主要诱因是 r.text 的机制。根据 HTTP 1.1 的历史规范(RFC 2616),如果服务端返回的 Content-Type 中没有指明 charset,Requests 会严格遵循规范,将 r.encoding 强行默认设置为 ISO-8859-1。这导致绝大部分未声明标头的现代中文网站直接以西欧编码输出乱码。
针对 Requests,有两种优雅的标准解决方案:
方案 A(自动推断赋值法):
import requests

url = "http://www.example.gov.cn"
response = requests.get(url)

# 将编码手动重置为自动探测到的真实编码
response.encoding = response.apparent_encoding
html = response.text
print(html[:200])
方案 B(直接解码原始字节流,最为稳妥):
import requests

url = "http://www.example.gov.cn"
response = requests.get(url)

# 跳过 response.text,直接拿 response.content (bytes) 用指定编码解码
html = response.content.decode('utf-8', errors='replace')
2. HTTPX 库与异步 aiohttp 的处理方式
现代请求库 HTTPX 与 aiohttp 抛弃了过时的 ISO-8859-1 回退机制。在没有指定编码时,它们通常默认尝试以 utf-8 解码。如果抓取到纯 UTF-8 网站,体验良好;但如果抓取到 GBK 网站,直接访问文本属性可能会抛出 UnicodeDecodeError。
在 HTTPX 中的规范写法如下:
import httpx

with httpx.Client() as client:
    r = client.get("http://www.example.com")
    # 如果目标是 GBK 网站,显式设置 encoding 属性
    r.encoding = "gb18030"
    html = r.text
3. BeautifulSoup 与 lxml 解析阶段的防乱码规范
很多开发者在获得 HTML 文本后,习惯写 BeautifulSoup(r.text, 'lxml')。这种做法存在隐患:如果 r.text 在上一步就已经按错误编码解码成了乱码字符串,BeautifulSoup 将无力回天。
最佳实践:直接向 BeautifulSoup 传入 r.content 二进制流。BeautifulSoup 内部集成了 UnicodeDammit 编码嗅探工具,当传入原始字节时,它会自动扫描 HTML 内部的 meta 标签并选择最恰当的编码转为 Unicode,还可以通过 from_encoding 参数显式提示:
from bs4 import BeautifulSoup
import requests

r = requests.get("http://www.example.com")

# 正确:传入原始二进制字节流,允许解析库自主嗅探或显式提示
soup = BeautifulSoup(r.content, 'lxml', from_encoding='gb18030')
print(soup.title.string)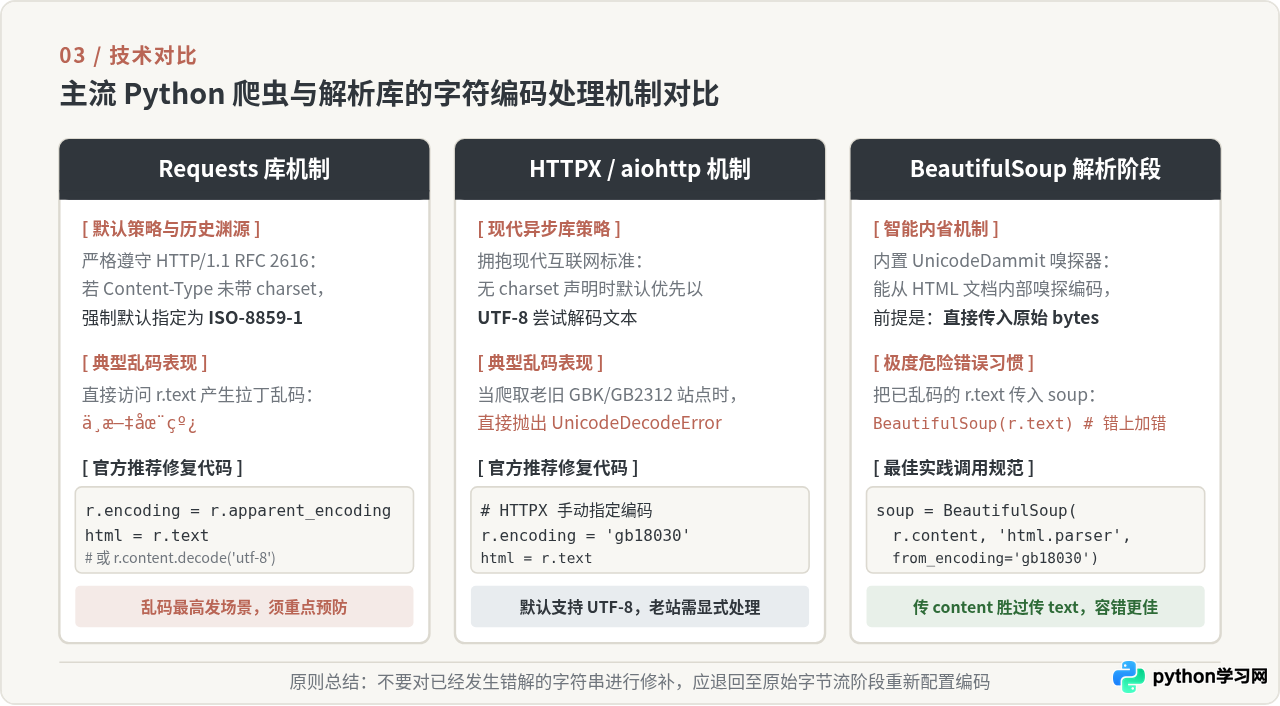
四、三类顽固与特殊乱码的处理细节
1. GB2312、GBK 与 GB18030 的兼容级联问题
很多老网站在 Meta 标签中声明了 charset="gb2312",但在文章内容中包含了生僻汉字(如“镕”、“赟”)、繁体字或特殊符号。GB2312 仅收录了 6763 个常用汉字,解码遇到生僻字时会直接抛出 UnicodeDecodeError: 'gb2312' codec can't decode byte...。
由于汉字编码是严格向上向下兼容的:GB2312 ⊂ GBK ⊂ GB18030。GB18030 是我国现行最完整的强制性国家标准,不仅完全兼容 GBK 和 GB2312,还收录了少数民族文字及数万个生僻字。在爬虫代码中,只要探测到或声明为 gb2312 或 gbk,建议统一写成 gb18030 进行解码,可以彻底避免生僻字中断采集。
2. 网页启用 Gzip / Brotli 压缩导致的伪“乱码”
有时候打印 response.text,看到的不是错位的文字,而是一堆毫无规律的二进制符号乱码(如 ...)。这并非字符编码问题,而是服务器返回了压缩数据,爬虫未能自动解压。
成因通常是请求头中手动添加了 'Accept-Encoding': 'gzip, deflate, br',但本地缺少解压模块(例如解压 br 压缩格式需要安装 brotli 库)。检查与解决方法:
- 使用 Requests 时,若非必要,无需在
headers中手动硬编码Accept-Encoding,Requests 会自动处理 gzip 和 deflate。 - 如果响应头指定了
Content-Encoding: br,运行pip install brotli,之后 Requests 即可自动识别并解压。
3. 响应包含 Unicode 转义序列(\uXXXX)
现代很多网站的动态 API 接口返回的内容形式为:{"message": "\u64cd\u4f5c\u6210\u529f"}。这属于 ASCII 范围内的 Unicode 逃逸字符串,而非编码故障。
正确做法是使用 json.loads(),Python 会在解析 JSON 时自动将 \uXXXX 还原为正常汉字;如果是纯文本字符串,可以使用内置的 unicode_escape 编解码器:
raw_text = r'\u4e2d\u6587\u6d4b\u8bd5'
# 正确转换:先编码为 latin1/utf-8 再以 unicode_escape 解码
clean_text = raw_text.encode('utf-8').decode('unicode_escape')
print(clean_text)
# 输出:中文测试
五、总结速查决策流程
遇到爬虫中文乱码时,按照下面的逻辑决策树依次判断与执行,即可在最短时间内恢复正常文本。
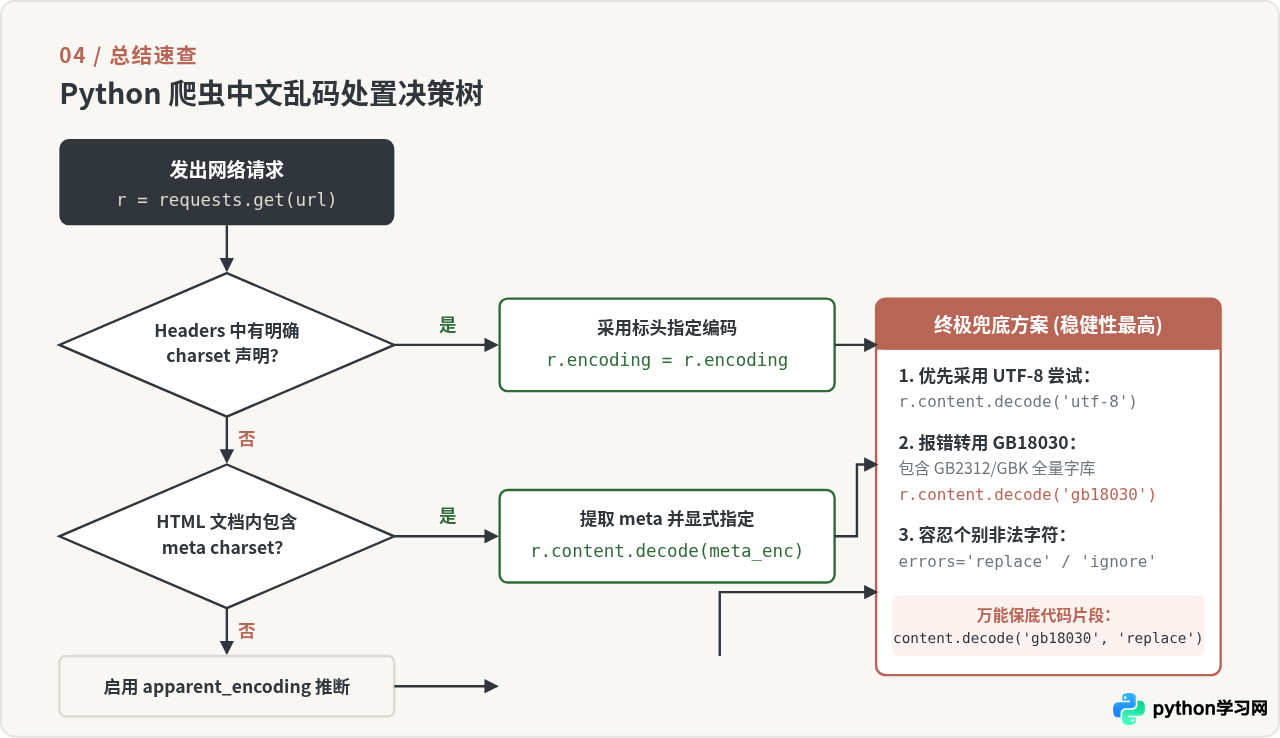
常见乱码特征与对应解决方案速查表
| 乱码外在表现 | 根本原因 | 排查方法 | 推荐解决代码 |
|---|---|---|---|
ä¸æ–‡æµ‹è¯•(西欧特殊字母) |
UTF-8 网页被误用 ISO-8859-1 解码 (Requests 默认陷阱) | 检查 r.headers,发现无 charset 或标注为 ISO-8859-1 |
r.encoding = 'utf-8'或 r.content.decode('utf-8') |
涓枃娴嬭bd(生僻古怪汉字) |
UTF-8 网页被强行当作 GBK/GB2312 解码 | 查看 HTML Meta,发现网页实际为 UTF-8 但解析器错选 GBK | r.content.decode('utf-8') |
\u4e2d\u6587\u6d4b\u8bd5(反斜杠 u 串) |
JSON 或 JS 返回的 Unicode 转义字符未反序列化 | 查看响应 Content-Type 是否为 application/json | r.json()或 text.encode().decode('unicode_escape') |
抛出 UnicodeDecodeError(中途报错崩溃) |
网页含生僻字,使用了容量过小的 GB2312 编码解码 | 检查报错位置,发现字符码位超出 GB2312 字符集区间 | 升级使用超集:r.content.decode('gb18030', 'replace') |
不可读乱字符与控制符\x1f\x8b... |
服务端返回 Gzip / Brotli 压缩数据,客户端未解压 | 检查 r.headers.get('content-encoding') 是否为 br/gzip |
移除自定义 Accept-Encoding,或 pip install brotli |
信 content 不信 text,信 gb18030 不盲目信 gb2312,解析直接传 bytes。牢记这三点,Python 爬虫在中文处理环节就能保持高度稳定。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









