

Jupyter Notebook适合运行所有Python脚本吗
深入探讨Jupyter Notebook与标准Python脚本(.py)的底层运行机制差异、适用场景边界及工程化规范,解答为什么Jupyter不适合运行所有Python脚本,并提供从探索原型向生产代码重构的完整指南。
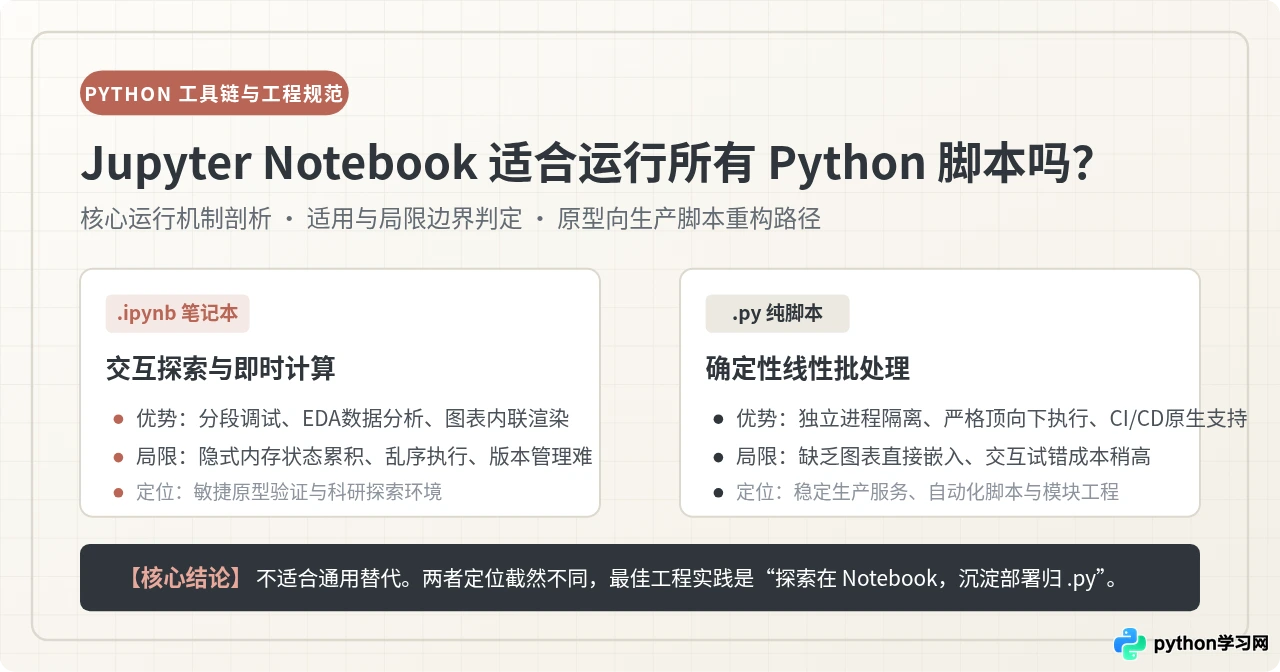
一、底层机制差异:有状态内核 vs 无状态独立进程
要搞清楚 Jupyter Notebook 为什么不能取代普通脚本,首先需要理解两者的底层执行机制存在本质分野。我们日常编写的标准 Python 脚本(.py)与在 Jupyter 中编辑的笔记本(.ipynb),在操作系统和解释器眼中的待遇截然不同。
当通过终端执行 python script.py 时,操作系统会启动一个崭新的 Python 解释器进程。代码严格按照从第一行到最后一行的线性顺序执行;执行结束时,该进程彻底退出,所占用的内存、文件句柄和网络连接被操作系统完整回收。这种执行模式被称为无状态的一次性批处理,其最大的价值在于确定性与可复现性。
而 Jupyter Notebook 采用的是客户端-服务器与持久内核(Kernel)架构。浏览器是前端展示层,后端由常驻的 IPython Kernel 维系。你在某个单元格中定义的变量、函数或加载的百兆数据集,会一直驻留在内存中,直到手动重启内核或关闭服务。
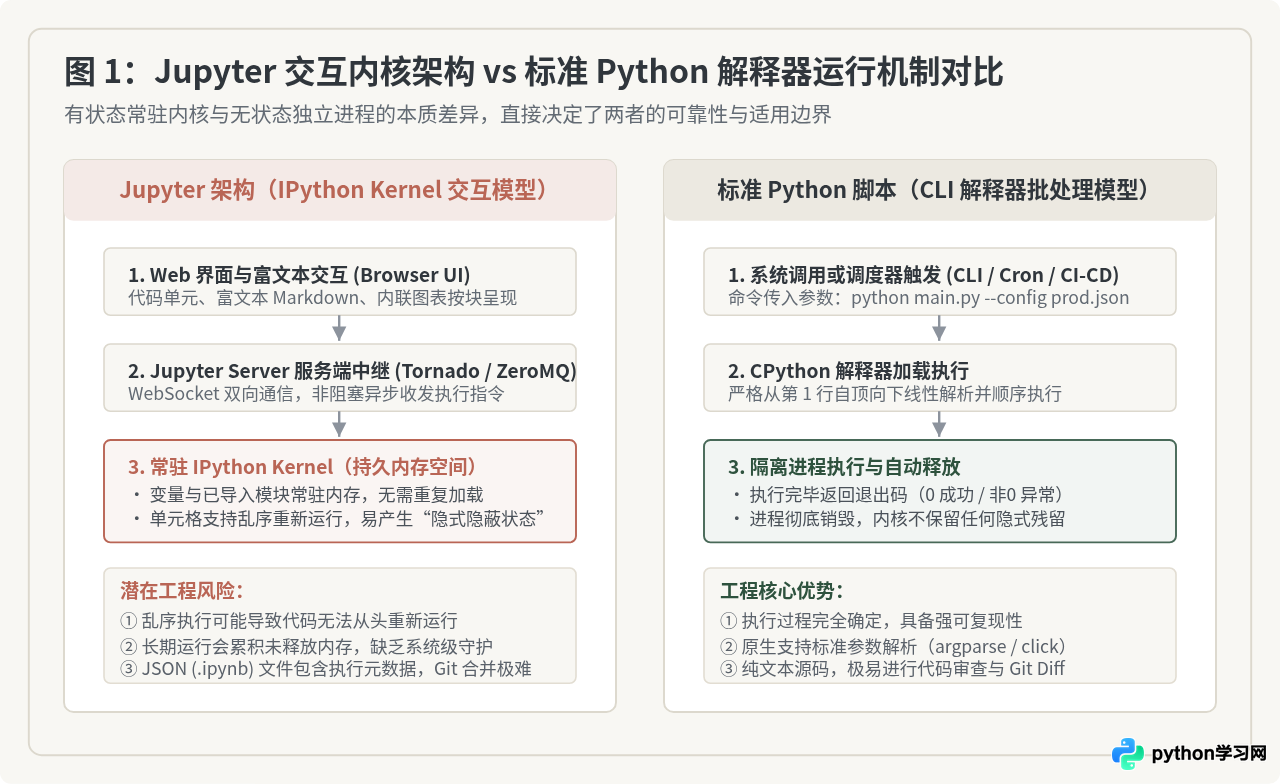
这种常驻机制赋予了 Jupyter 极高的人机交互效率,但随之而来的副产物是隐式状态累积与乱序执行风险:
-
乱序执行(Out-of-order Execution):在 Notebook 中,单元格可以按任意顺序反复点击运行。如果先运行了第 3 个单元格修改了全局变量
df,再去运行第 2 个单元格,代码的实际状态取决于使用者的点击顺序,而不是页面的书写排版。这极易产生在当前会话中能跑通、重启后却报变量未定义的“幽灵代码”。 -
文件载体本质差异:
.py是纯文本文件,每一行都是清晰的源码;而.ipynb本质上是一个巨大的 JSON 文档,其中不仅包含了代码,还混杂了每个单元格的执行计数、元数据配置以及内联图表的 Base64 编码字符串。这种结构对版本管理和自动化运维极不友好。
二、Jupyter Notebook 真正适合的三大核心场景
虽然 Jupyter 不是万能的,但在特定的工作流环节中,它的生产力远胜传统文本编辑器或纯脚本环境。具体而言,它最适合以下三类任务:
1. 探索性数据分析(EDA)与特征工程
在数据科学项目中,加载一个数百万行的数据集或训练一个复杂的特征工程流水线往往需要数分钟甚至更久。如果在纯脚本中调试,每次微调一个数据过滤条件,都必须重新运行脚本、重新读取磁盘数据。
而在 Jupyter 中,读取数据的代码单元只需执行一次,数据对象常驻内存,后续单元格可以毫秒级反复切片、查看描述统计。以下代码展示了典型的探索式切片:
# 单元格 1:仅需运行一次,大型数据常驻内存
import pandas as pd
import numpy as np

raw_df = pd.read_parquet("sales_records_2025.parquet")
print(f"数据加载完成,总行数: {len(raw_df)}")

# 单元格 2:反复试验与特征清洗,无需重复触发磁盘 I/O
filtered_df = raw_df.query("amount > 100 and region == 'East'")
filtered_df['log_amount'] = np.log1p(filtered_df['amount'])
filtered_df[['customer_id', 'amount', 'log_amount']].head()
2. 数据可视化与研究型报告呈现
Jupyter Notebook 原生集成了富媒体显示协议(Rich Display Protocol)。无论是 Matplotlib 绘制的静态折线图、Seaborn 的热力分布,还是 Plotly、Bokeh 的动态交互仪表盘,都可以直接内嵌在代码下方。配合 Markdown 单元格中的数学公式(LaTeX)与文字注解,整份文档本身就是一份兼具可执行性与可读性的完整实验报告。
3. 教学演示、算法原型试错与分段调试
对于复杂的深度学习或算法调试,开发者可以把数据加载、网络前向传播、损失计算、反向传播拆解到不同的单元格中。每一步都可以随时打印张量的形状(tensor.shape)和数值范围,直观观测中间变化,降低心智负担。
三、不适合在 Notebook 中运行的典型任务与深层痛点
一旦脱离了“交互试错”的语境,进入“工程化、自动化与无人值守”阶段,Jupyter Notebook 的优势便会迅速转化为阻碍。以下四类任务极不适合直接使用 Notebook 运行:
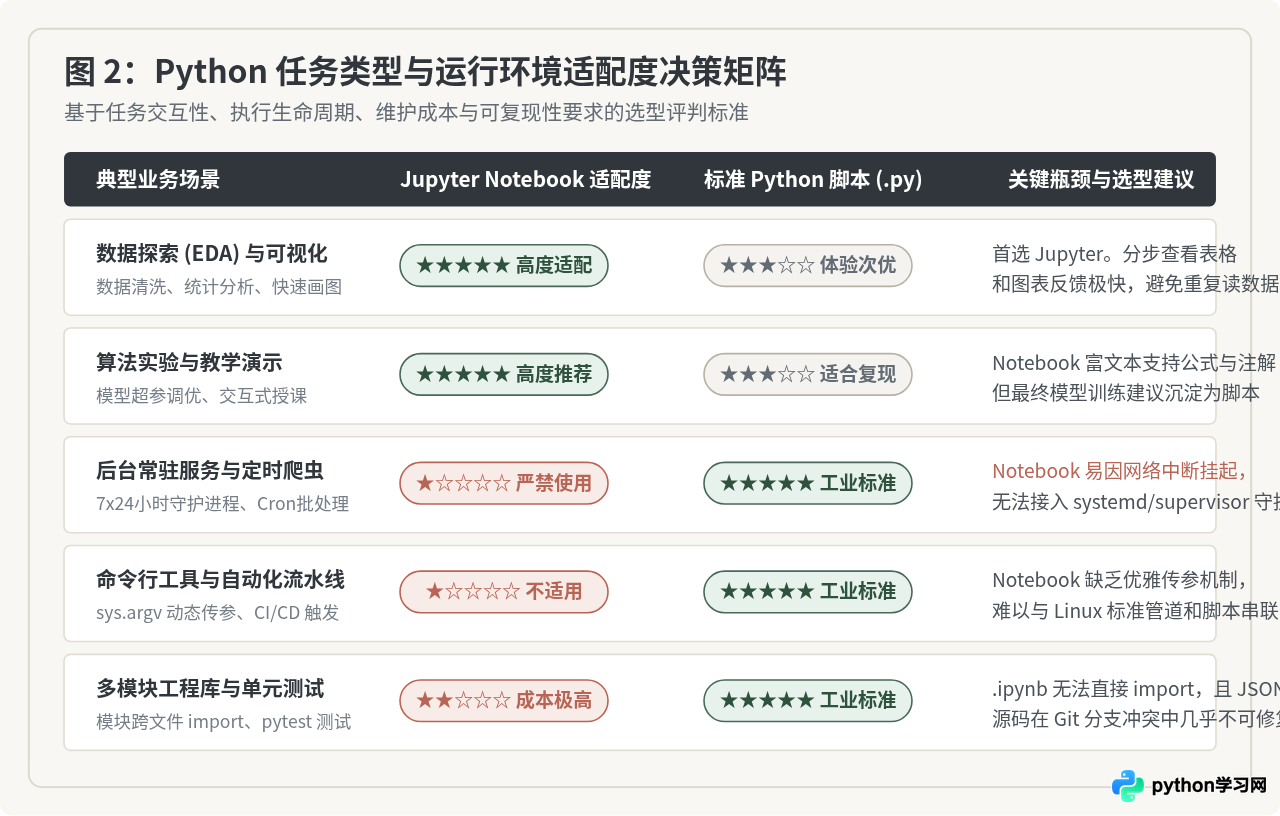
1. 长期常驻后台的服务与定时任务(Daemon & Cron)
例如 Web API 服务(FastAPI/Flask)、消息队列消费者(Celery/Kafka Worker)或定时采集的爬虫。将这类任务放在 Notebook 中运行存在严重隐患:
- 缺乏进程监控与故障自愈:Linux 生态中的
systemd、supervisord或 Docker 容器能够精准监控标准脚本的进程退出状态并自动拉起,但它们无法直接守护一个运行在浏览器网页后端的 Jupyter 单元格。 - 内存泄漏与孤儿进程:长时间运行的 Notebook 内核极易随着中间输出缓存积累而内存膨胀;如果浏览器意外关闭或网络断连,执行状态可能悬挂或意外中断。
2. 命令行工具(CLI)与参数化自动化流水线
标准的自动化脚本依赖外部传入参数执行不同批次,例如通过 argparse 或 sys.argv 接收命令行参数:
# 标准 Python 命令行脚本示例: export_data.py
import argparse
import sys

def parse_args():
    parser = argparse.ArgumentParser(description="业务指标导出工具")
    parser.add_argument("--date", required=True, help="统计日期,格式 YYYY-MM-DD")
    parser.add_argument("--env", default="prod", choices=["dev", "prod"], help="运行环境")
    return parser.parse_args()

if __name__ == "__main__":
    args = parse_args()
    print(f"正在以 [{args.env}] 环境处理日期: {args.date} 的数据...")
如果试图在 Jupyter Notebook 中运行上述逻辑,argparse 会直接报错,因为它会错误捕获 Jupyter 内核自身的启动参数(例如 -f /home/user/.local/share/jupyter/runtime/kernel-xxx.json)。虽然可以通过代码 Hack 绕过,但完全丧失了脚本原生与 Shell 管道(|、xargs)结合的优雅性。
3. 多文件模块化工程与跨文件导入
在规范的软件工程中,代码会按层次拆分为多个模块:database.py、models.py、utils.py。Python 原生语法支持 from utils import clean_text。
但 Python 无法直接 import 另一个 .ipynb 文件。尽管存在第三方包装库(如 ipynb),但这种做法破坏了静态代码分析、阻断了 IDE 的语法补全与跳转,且无法进行类型检查(mypy)和代码规范检查(flake8/ruff)。
4. 团队协同开发与 Git 版本控制
如前所述,.ipynb 是复杂的 JSON。即使你只修改了一行 Python 代码,保存时单元格的执行序号、输出时间戳、图片 Base64 编码都会发生变动,导致 Git Diff 中产生几百行无意义的变动标记。当两名开发者同时修改同一个 Notebook 时,Git 的自动合并几乎必然失败,手动解冲突往往会损坏 JSON 结构导致文件无法重新打开。
jupyter nbconvert --execute notebook.ipynb 跑定时批处理。这种方式不仅难以捕获精细的报错栈并向告警系统上报,而且一旦单元格产生大量图片输出,会导致执行生成的输出文件极其庞大,甚至耗尽磁盘空间。
四、实操指南:将 Notebook 原型重构为规范 Python 脚本
正确的做法不是非此即彼,而是将代码按生命周期有序流转。在数据分析和算法研发中,标准的工作路径是:在 Notebook 中完成逻辑探索与验证,随后通过四个标准化步骤将其沉淀为生产级 .py 脚本。
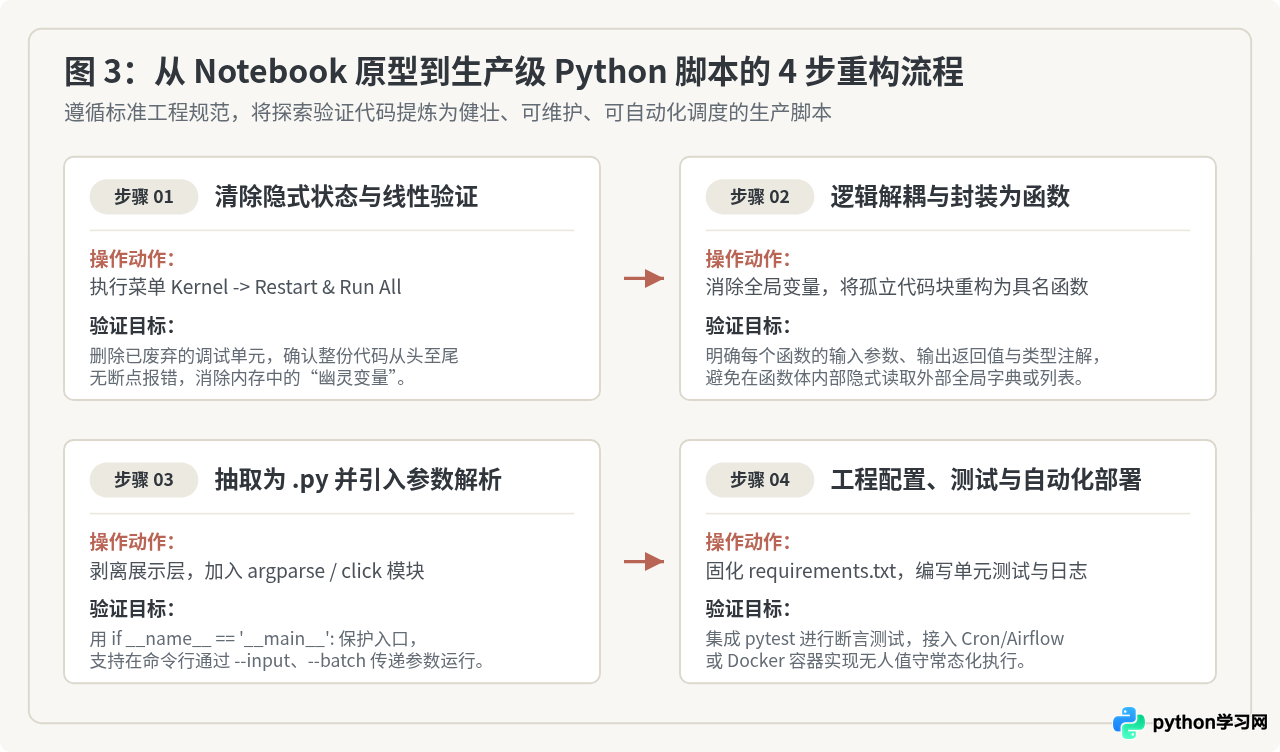
步骤一:清除隐式状态与自顶向下验证
在重构前,必须确保 Notebook 代码具有自洽性。打开顶部菜单栏,点击 Kernel -> Restart & Run All(重启并运行全部单元格)。
如果运行过程中任何一个单元格报错(例如提示某个变量未定义),说明之前代码依赖了乱序执行产生的残留变量。此时必须立即整理单元格顺序,删除无用的临时代码块,直至整份文档能够从第一行毫无阻碍地连续运行至最后一行。
步骤二:逻辑解耦与封装为具名纯函数
Notebook 中的代码往往直接操作全局变量。在重构阶段,需要把零散在各个单元格的操作提炼为职责单一的独立函数,显式传入输入并返回输出,彻底断绝全局依赖:
# 重构前(Notebook 风格:依赖全局变量)
# 某个单元格直接写死路径并修改全局 df
df = pd.read_csv("raw.csv")
df['clean_col'] = df['col'].str.strip()

# 重构后(模块化函数:输入输出清晰,利于测试)
def clean_records(input_path: str) -> pd.DataFrame:
    """读取指定路径数据并执行清洗逻辑"""
    data = pd.read_csv(input_path)
    data['clean_col'] = data['col'].str.strip()
    return data
步骤三:抽取为独立脚本并配置参数接口
将重构好的函数提取到独立的 .py 文件中,并使用标准入口保护结构:
# 文件名:pipeline.py
import argparse
import logging

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def process_pipeline(input_file: str, output_file: str) -> None:
    logging.info(f"开始处理文件: {input_file}")
    # 核心业务逻辑
    logging.info(f"处理完成,保存至: {output_file}")

if __name__ == "__main__":
    parser = argparse.ArgumentParser(description="批处理数据清洗流水线")
    parser.add_argument("-i", "--input", required=True, help="输入文件路径")
    parser.add_argument("-o", "--output", required=True, help="输出文件路径")
    args = parser.parse_args()

    process_pipeline(input_file=args.input, output_file=args.output)
步骤四:工程化配置、单元测试与自动化挂载
脚本固化后,通过虚拟环境(venv 或 conda)锁定依赖包版本并导出至 requirements.txt。为核心函数编写 pytest 单元测试用例,随后将脚本接入 Linux Crontab、Airflow 任务流或打包进 Docker 镜像中执行。
五、现代 Python 开发的双轨协同架构
成熟的工程团队从来不会在“只用 Notebook”或“只用 .py”之间做二极管式的选择,而是采用“双轨协同(Dual-track Collaboration)”架构:探索轨驱动创新与敏捷验证,工程轨承载稳定性与生产交付。
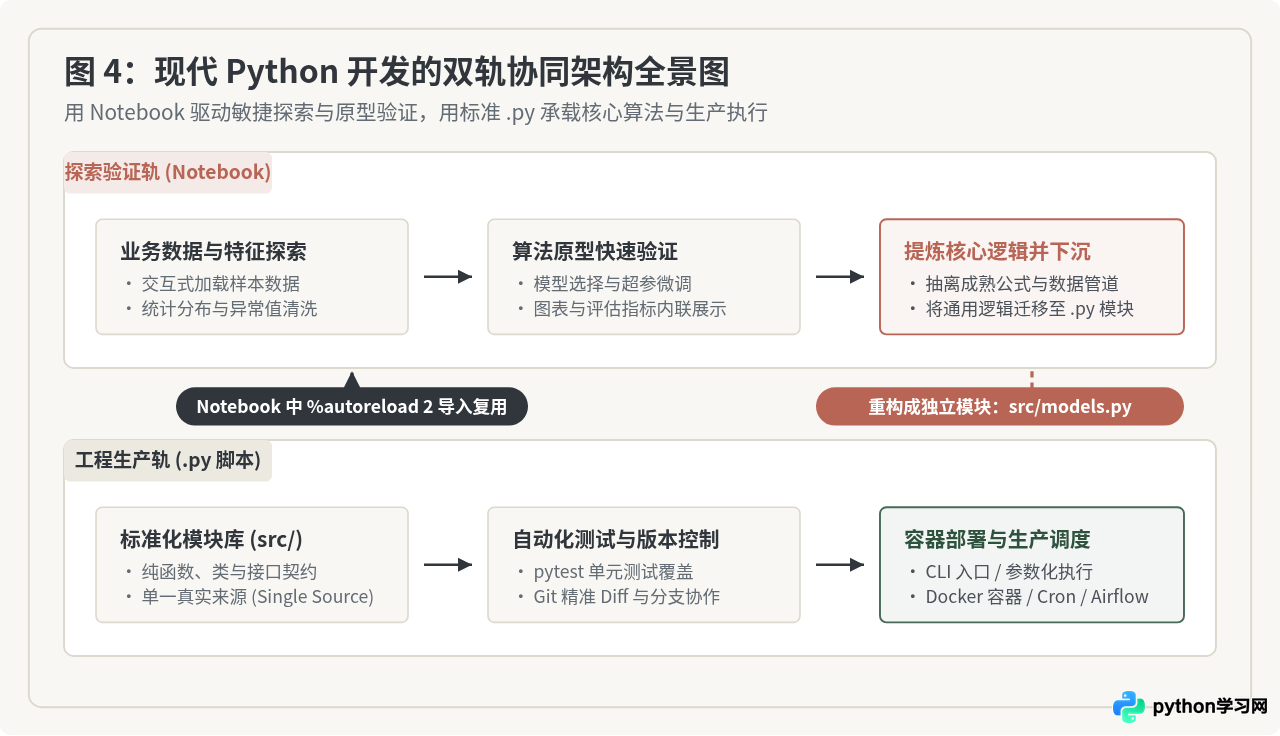
双轨协同的核心技术抓手在于“代码单向沉淀与动态反向调用”:
-
建立标准项目目录结构:
my_project/ ├── notebooks/ # 探索轨:存放 .ipynb 实验草稿 │ └── 01_eda_experiment.ipynb ├── src/ # 工程轨:存放标准化 .py 核心逻辑库 │ ├── __init__.py │ ├── data_loader.py │ └── feature_engine.py ├── tests/ # 自动化测试用例 │ └── test_feature_engine.py ├── scripts/ # 命令行调度与批处理入口 │ └── run_batch_job.py └── requirements.txt # 生产环境锁定依赖 -
在 Notebook 中使用动态重载扩展:
当把稳定逻辑下沉到
src/下的 Python 模块后,在 Notebook 头部开启 IPython 内置的动态重载扩展:
这种配合方式彻底消除了代码重复维护的困扰:Notebook 中只保留薄薄的一层图表绘制与调用展示代码,核心算子全部由经过单元测试的%load_ext autoreload %autoreload 2 # 此时直接导入 src 模块 from src.data_loader import load_clean_data # 当在 IDE 中修改了 src/data_loader.py 时,无需重启 Notebook 内核, # 下次单元格调用时会自动加载最新的代码实现!.py模块提供。 -
使用转换工具桥接协同:
如果团队成员习惯在 Notebook 中书写分析报告,但需要纳入 Git 版本追踪,可以使用开源工具
jupytext将.ipynb与配对的轻量纯文本脚本(如 Markdown 或 py:percent 格式)保持双向同步,既保留了交互界面的便利,又彻底解决了 Git 难以审查代码的痛点。
六、高频常见问题解答(FAQ)
.ipynb,并按顺序生成记录了全部运行结果与日志的新笔记本文件,且支持执行超时与错误重试控制。但请牢记,这主要适用于自动化数据分析报告生成,而不适合高并发的业务接口或实时常驻任务。
.py 文件并学习命令行调试。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









