

Python多重继承中方法重写顺序是怎么的
深入解析Python多重继承中的方法重写与解析顺序(MRO),详解C3线性化算法的合并规则、菱形继承的处理机制以及super()协同调用链的底层运作原理。
__mro__ 属性或 mro() 方法直接获取这个解析序列。
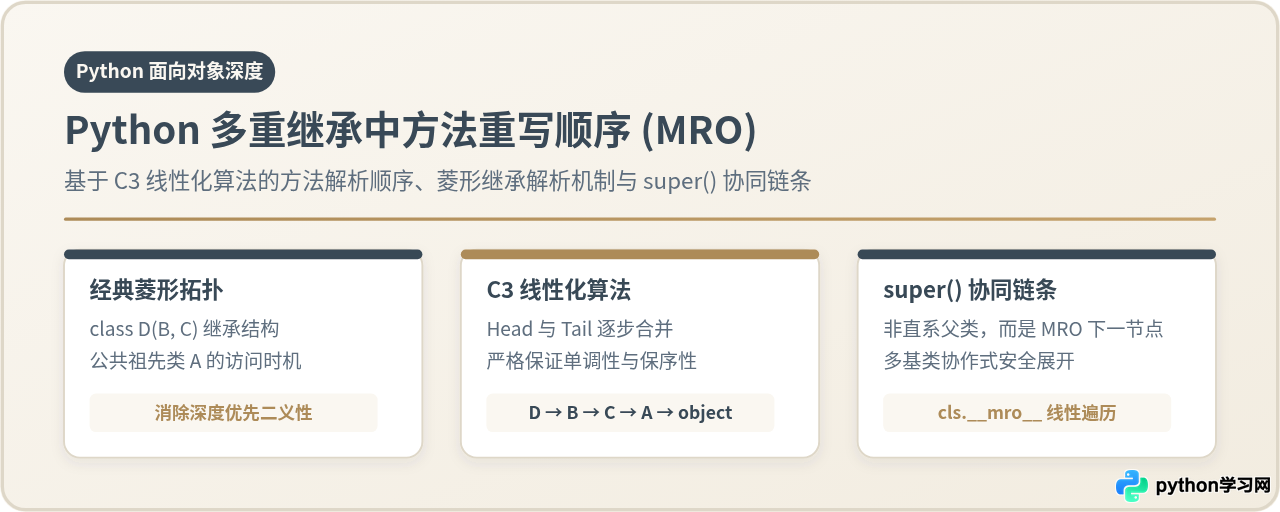
一、核心概念:什么是 MRO 与方法查找机制
当一个子类继承自多个基类,并且这些基类中存在同名方法时,Python 不会盲目猜测执行哪一个,也不会简单按树状深度优先随意穿梭。Python 会在类被解释器加载定义时,依据 C3 线性化算法 预先计算好一个固定排序的元组,这个元组被称为该类的 MRO(Method Resolution Order)。
当你在实例上调用某个方法或属性时,解释器的查找策略非常纯粹且明确:
- 实例自身检查:首先检查实例对象的
__dict__中是否有该实例属性; - MRO 列表依次查找:若实例没有定义,则从该实例所属类的 MRO 列表中,从第 0 个元素(即自身类)开始,依次向后检查每一个基类,直到找到匹配的方法名称为止;
- 触发重写生效:由于自身类或靠前类的检查排在前面,只要靠前的类中实现了该方法,就会立即采纳执行,从而实现了对后方基类同名方法的“重写(Override)”或遮蔽;
- 未找到报错:如果遍历到最顶层的根类
object依然没有找到该方法,则抛出AttributeError异常。
你可以通过以下简洁代码,查看当前 Python 环境中任何类的实际 MRO:
class Base:
    pass

class Sub(Base):
    pass

print(Sub.__mro__)
# 或调用类方法
print(Sub.mro())[<class '__main__.Sub'>, <class '__main__.Base'>, <class 'object'>]
二、经典菱形继承与 C3 算法的核心准则
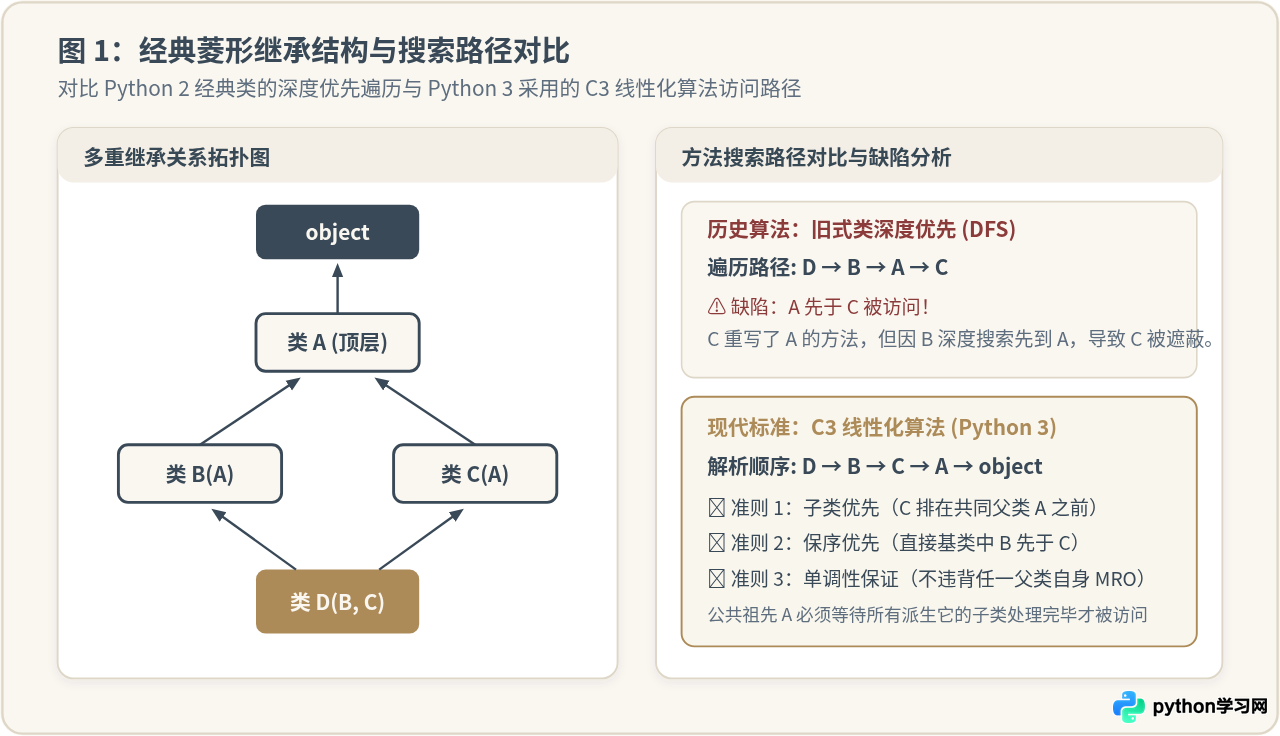
在单继承场景下,方法查找顺序非常简单,就是顺着父类层层往上直到 object。多重继承最关键的考验来自菱形继承(Diamond Inheritance)——即子类 D 同时继承自基类 B 和 C,而 B 和 C 又共同派生自根基类 A。
在早期的 Python 2 经典类(Classic Classes)中,解释器使用的是“深度优先、从左至右”(DFS)的搜索策略。在 class D(B, C) 中,搜索路径是 D → B → A → C。这引发了一个严重的缺陷:基类 A 的访问顺序竟然先于子类 C!如果 C 特意重写了 A 的某个方法,本意是提供更新的行为,结果却被 A 中陈旧的实现先截胡了。
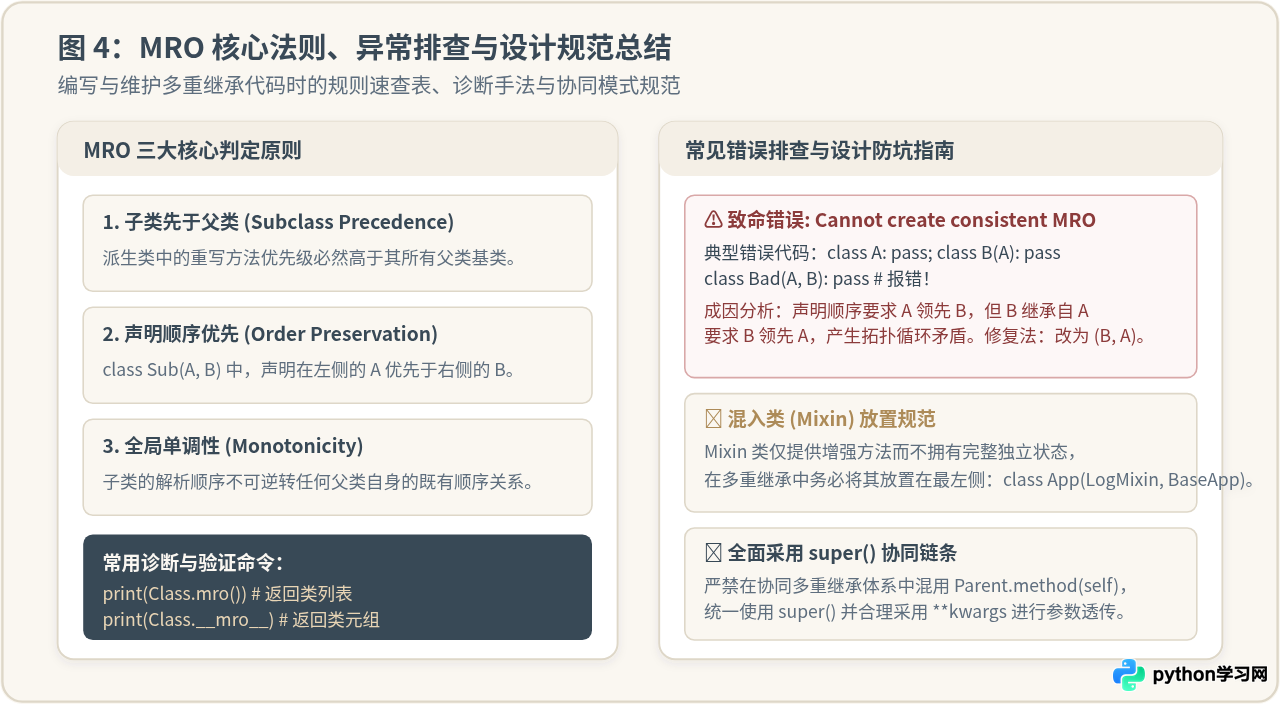
为了解决 DFS 破坏继承逻辑的问题,Python 从 2.3 版本开始引入并在 Python 3 中全面强制使用 C3 线性化算法。该算法必须严格遵守三大设计准则:
- 子类优先于父类(Subclass Precedence):子类的解析优先级必然高于它的直接和间接基类。在菱形继承中,C 是 A 的子类,因此无论如何 C 都必须排在 A 之前。
- 声明顺序优先(Preserving Order of Direct Superclasses):如果定义了
class D(B, C),在没有其他反向继承依赖的前提下,写在括号左边的类(B)必然优先于写在右边的类(C)。 - 全局单调性(Monotonicity):如果在基类 B 的 MRO 列表中类 X 优先于类 Y,那么在任何继承自 B 的子类中,类 X 也必须绝对优先于类 Y,绝不允许因为子类的继承组合而逆转父类自身确立的先后次序。
下面是一个经典的菱形继承代码示例,展示了各个类分别重写 greet() 方法时的表现:
class A:
    def greet(self):
        print("执行来自 A 的 greet")

class B(A):
    def greet(self):
        print("执行来自 B 的 greet")

class C(A):
    def greet(self):
        print("执行来自 C 的 greet")

class D(B, C):
    pass

# 查看 D 的解析顺序
print("D 的 MRO 顺序:", [cls.__name__ for cls in D.mro()])

# 实例化并调用 greet 方法
d = D()
d.greet()执行来自 B 的 greet
在上面的代码中,D 自身没有重写 greet(),依据 MRO 顺序 ['D', 'B', 'C', 'A', 'object'],解释器查找的下一个类是 B。由于 B 实现了 greet(),匹配成功,打印“执行来自 B 的 greet”,不会继续查找 C 或 A。如果我们在 B 中注释掉 greet,那么紧接着调用的就会是 C,最后才是 A。
三、深入推导:C3 线性化算法的逐步计算过程
许多开发者虽然知道 MRO,但在面对三层以上的复杂多重继承时,往往难以推断为什么某个类会排在另一个类之前。理解 C3 算法的核心在于掌握它的 Merge(合并) 逻辑。
1. 符号定义与合并公式
记 L[C] 为类 C 的线性化列表(即 MRO)。对于一个根类(如 object),其 L[object] = [object]。
对于继承了直接基类 \(B_1, B_2, \dots, B_n\) 的派生类 \(C\),其线性化公式为:
L[C(B1, B2, ..., Bn)] = [C] + merge( L[B1], L[B2], ..., L[Bn], [B1, B2, ..., Bn] )
其中,每个被合并的序列都由两部分构成:
- Head(表头):序列的第一个元素;
- Tail(表尾):除去第一个元素后,序列剩余的所有元素构成的集合。例如在序列
[B, A, O]中,Head 是B,Tail 是[A, O]。
2. Merge 的提取规则
merge() 函数按照从左到右的顺序逐一审视各个列表的 Head:
- 取当前第一个可用列表的 Head,检查它是否出现在其他任何列表的 Tail 中;
- 如果该 Head 没有在任何其他列表的 Tail 中出现,说明当前类没有作为其他类的后续基类被依赖,它是一个合法的候选者。将其输出到 MRO 结果中,并从所有包含它的待合并列表中删除该元素;
- 如果该 Head 不幸出现在了某个列表的 Tail 里,说明有更晚继承它的派生类尚未被处理,算法必须立即跳过该 Head,转向下一个列表的 Head 重复检查;
- 重复上述步骤,直到所有待合并列表都被清空,计算完成。如果遍历了所有候选 Head 发现都存在冲突,导致没有一个可以提取,则说明该继承拓扑破坏了单调性,Python 将在此刻抛出
TypeError。
3. 实际推导示例
我们以经典菱形结构 class A, class B(A), class C(A), class D(B, C) 为例(为表述简短,将 object 简记为 O):
- 基类 A:
L[A] = [A, O] - 基类 B:
L[B] = [B] + merge(L[A], [A]) = [B] + merge([A, O], [A]) = [B, A, O] - 基类 C:
L[C] = [C] + merge(L[A], [A]) = [C] + merge([A, O], [A]) = [C, A, O]
现在推导派生类 D 的 MRO:
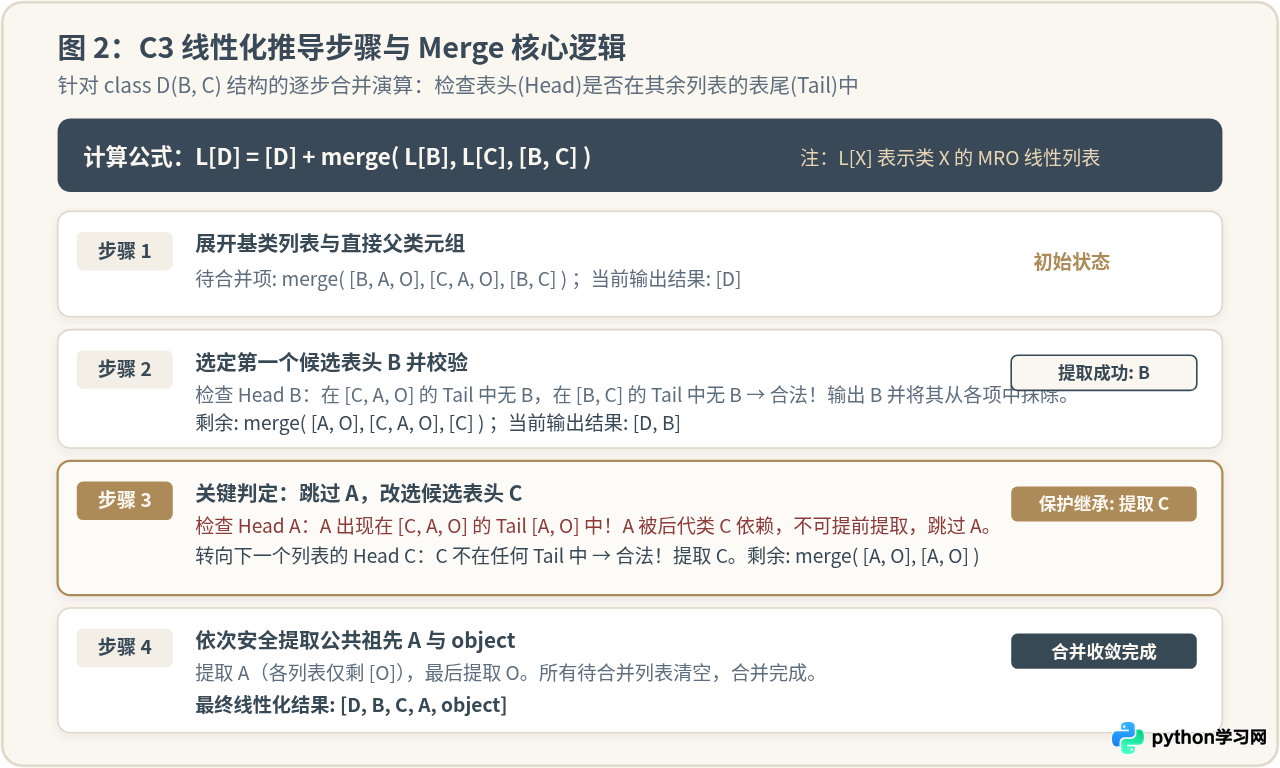
L[D] = [D] + merge( L[B], L[C], [B, C] )
     = [D] + merge( [B, A, O], [C, A, O], [B, C] )

第一轮:
  检查第 1 项表头 B:B 未出现在 [C, A, O] 的 Tail 中,也未在 [B, C] 的 Tail 中。
  提取 B,加入输出序列。当前结果: [D, B]
  剩余: merge( [A, O], [C, A, O], [C] )

第二轮(关键转折):
  检查第 1 项表头 A:A 出现在了第 2 项 [C, A, O] 的 Tail 中!
  不可提取 A,跳过!
  转而检查第 2 项表头 C:C 未出现在 [A, O] 的 Tail 中,也未在 [C] 的 Tail 中。
  提取 C,加入输出序列。当前结果: [D, B, C]
  剩余: merge( [A, O], [A, O] )

第三轮:
  检查表头 A:此时没有其它序列的 Tail 包含 A。
  提取 A,当前结果: [D, B, C, A]
  剩余: merge( [O], [O] )

第四轮:
  提取 O。所有列表清空!
最终 MRO 序列为: [D, B, C, A, O]
四、实战关键:super() 在多重继承中的动态协同链
许多开发者在多重继承中使用 super() 时,容易形成一个严重误解:以为 super() 指向的是代码书写上的“直系父类”。
事实上,super() 与代码编写时的静态父子关系无关,它是严格基于运行时实例对象的 MRO 列表动态向后寻址的。
在 class D(B, C) 中,当实例 d = D() 执行到 B 类内部的 super().method() 时,由于在实例 d 的 MRO 列表中紧跟在 B 后面的是 C,此时 B 中的 super() 调用的并不是 B 的直接父类 A,而是横向跳到了平级的 C!这种机制被称为 协同多重继承(Cooperative Multiple Inheritance)。
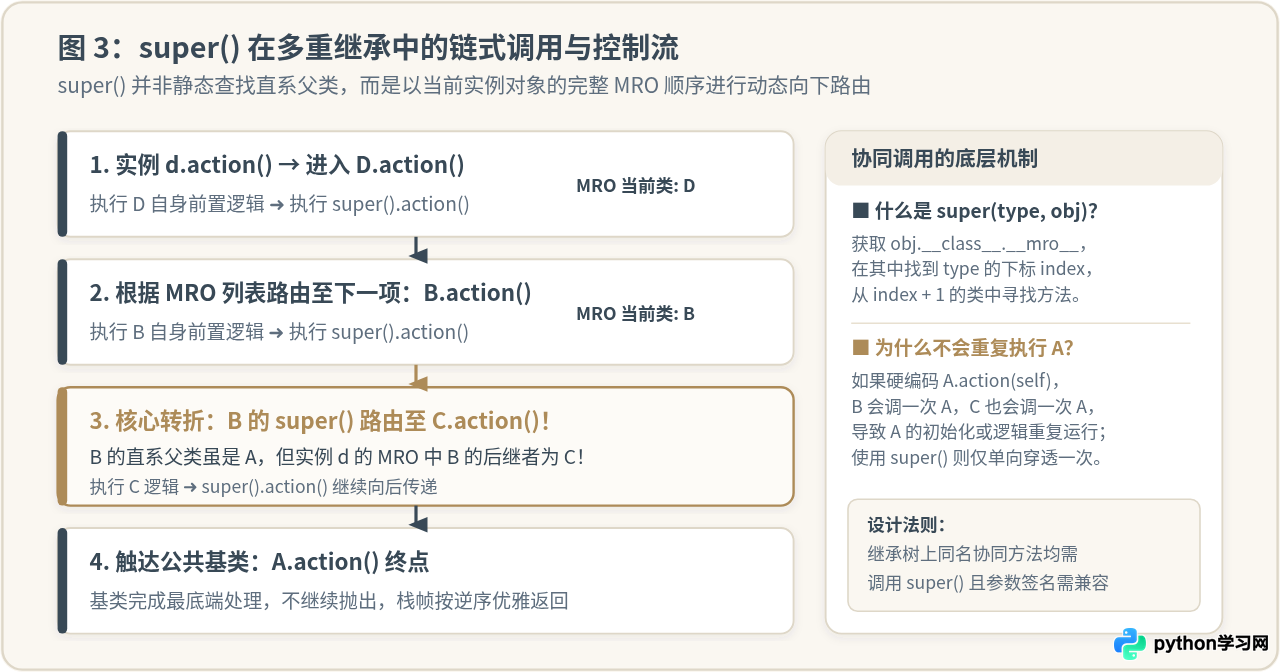
下面是一段完整的、可实际执行的代码,直观验证多重继承中每个类的 super() 如何串联起一条完整的执行流水线:
class Root:
    def action(self):
        print("[Root] 基础核心逻辑执行")

class LoggerMixin(Root):
    def action(self):
        print("[LoggerMixin] 开始记录操作日志")
        super().action()
        print("[LoggerMixin] 日志记录完成")

class ValidatorMixin(Root):
    def action(self):
        print("[ValidatorMixin] 开始校验参数安全性")
        super().action()
        print("[ValidatorMixin] 安全性校验通过")

class Service(LoggerMixin, ValidatorMixin):
    def action(self):
        print("[Service] 业务服务方法触发")
        super().action()
        print("[Service] 业务服务处理收尾")

# 观察解析顺序与链式输出
print("Service MRO:", [cls.__name__ for cls in Service.mro()])
s = Service()
s.action()[Service] 业务服务方法触发
[LoggerMixin] 开始记录操作日志
[ValidatorMixin] 开始校验参数安全性
[Root] 基础核心逻辑执行
[ValidatorMixin] 安全性校验通过
[LoggerMixin] 日志记录完成
[Service] 业务服务处理收尾
从输出可以清楚看到:
Service.action()率先介入,调用super().action()进入LoggerMixin;LoggerMixin的直系基类是Root,但它内部的super().action()并没有直接跳去Root,而是顺着 MRO 的下一个位置进入了ValidatorMixin;ValidatorMixin中的super().action()才进一步进入链条末端的Root;- 当
Root执行完毕后,调用栈依次回退,各层后置逻辑按镜像逆序完美执行,且基类Root的核心逻辑只被执行了一次,完全避免了重复调用的隐患。
五、常见陷阱、MRO 冲突报错与最佳实践
了解了 MRO 的运作机理后,在实际项目编码中,有两类最为典型的错误与设计陷阱需要特别规避。
1. MRO 拓扑冲突与 TypeError
如果编写的多重继承层级破坏了单调性或产生了闭环依赖,Python 在类定义阶段就会直接抛出报错。例如下面这个常见错误:
class Base:
    pass

class Derived(Base):
    pass

# 试图在子类中先声明 Base,后声明 Derived
class Wrong(Base, Derived):
passclass Wrong(Base, Derived) 的声明顺序,直接父类列表要求 Base 必须排在 Derived 之前;然而根据 Derived 本身的继承定义(Derived 继承 Base),准则 1 要求子类 Derived 必须排在父类 Base 之前。两者产生不可调和的逻辑死锁,C3 算法无法选出合法的 Head,因此解释器拒绝创建此类。
解决方法:调整继承参数顺序,让子类写在左侧:
class Correct(Derived, Base): pass。
2. 混用直接父类硬编码调用导致的多重执行
初学者常常在派生类的 __init__ 中写成 ParentA.__init__(self) 和 ParentB.__init__(self)。当 ParentA 和 ParentB 共享同一公共祖先时,公共祖先的初始化逻辑会被重复执行两次。一旦涉及数据库连接池初始化、计数器自增或外部资源分配,这种重复调用会引发严重的业务 Bug。必须彻底统一使用 super().__init__(**kwargs) 展开链式协同。
3. 工程设计建议清单
| 设计要点 | 规范做法 | 防范风险 |
|---|---|---|
| Mixin 类的摆放位置 | 将单一职责的 Mixin 类放在继承声明的最左侧,核心主基类放在最右侧 | 确保 Mixin 的扩展方法在 MRO 中处于优先拦截地位 |
| 链式方法调用 | 体系内同名覆盖方法统一使用 super().method() |
避免硬编码类名导致的调用穿透或公共祖先被重复执行 |
| 参数透传兼容性 | 在多重继承的 __init__ 或协同方法中,使用 *args, **kwargs 接收多余参数并向下透传 |
避免链条上下游参数列表不一致导致 TypeError: unexpected keyword argument |
| 排查验证手段 | 在引入复杂继承时,优先在测试用例中打印 Class.__mro__ |
直观排查解析路径是否符合业务设计的拦截意图 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









