

企业为什么选择Python?解读其在快速原型开发与系统整合中的价值
深入解析企业级技术栈中Python的核心价值,聚焦快速原型开发的高效验证逻辑与异构系统整合的“胶水枢纽”能力,提供真实的架构对比、落地步骤与代码实践。
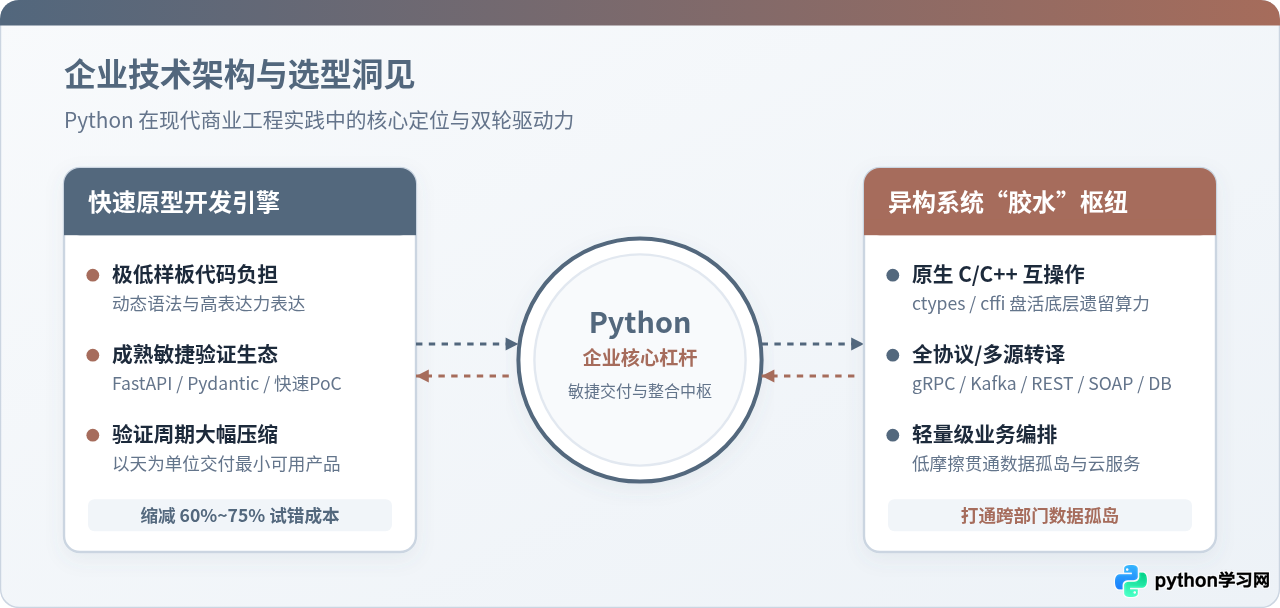
当工程决策者坐在会议室讨论技术选型时,考量往往不再是单线程下的基准跑分(Benchmark),而是商业组织运转的全生命周期总拥有成本(TCO)与市场机会窗口(Time-to-Market)。如果一套需要六个月才能搭建完成的高性能架构,在上线第一天就被市场证实方向错误,那么它的运行性能再快也无法弥补研发试错的沉没成本。
Python 在现代企业开发体系中的地位,恰恰建立在对这两大痛点的精准击破上。一方面,它以极其简炼的表达力和开箱即用的工具生态,让团队能在数天内将商业构想固化为可用原型;另一方面,它具备强大的底层互操作性与跨协议兼容能力,能够自然充当企业各时期遗留系统之间的调度枢纽。
一、敏捷验证:快速原型开发如何重塑交付节奏
传统企业软件研发中,验证一个新业务逻辑的过程往往极其繁重。在典型的重型工程体系下,开发者在写下第一行核心业务逻辑之前,必须先定义详尽的接口契约、编写繁杂的工程脚手架、配置依赖注入容器,并设计多层抽象对象。这种仪式感在成熟且边界稳定的核心系统中能防范混乱,但在需求尚未被市场验证的探索阶段,却带来了高昂的沟通与试错负担。
Python 打破这一枷锁的关键在于“零阻力表达”与“完备生态(Batteries Included)”。动态类型的灵活性允许开发者直接以最贴近业务领域模型的形态进行数据建模,而不需要为每一个临时结构体编写序列化与装配代码。
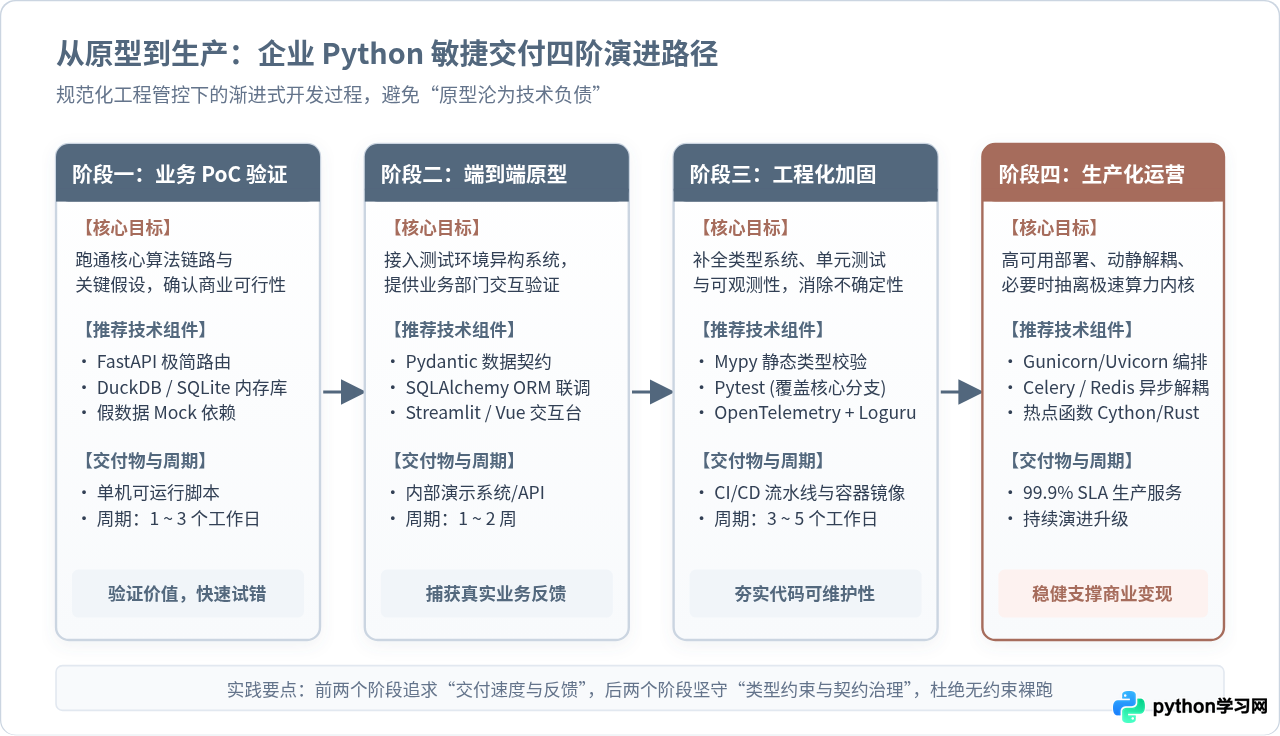
以现代 Python 框架(如 FastAPI、Pydantic 与 SQLAlchemy)为例,构建一个具备数据校验、异步 I/O 并可自动生成 OpenAPI 文档的企业级服务原型,往往只需要数十行代码。在阶段一和阶段二中,团队能够把全部精力聚焦在“商业规则是否跑通”与“上下游集成是否顺畅”上,而不是受困于环境配置。
生产级极简原型代码示例
以下代码展示了如何在没有复杂脚手架的前提下,快速构建一个具备类型约束、外部服务调用与业务容错的原型微服务:
from typing import Optional
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
import httpx

app = FastAPI(title="企业敏捷风控评分原型服务", version="0.1.0")

class AssessmentRequest(BaseModel):
    enterprise_id: str = Field(..., description="企业统一信用代码")
    declared_revenue: float = Field(..., gt=0, description="申报营业额(万元)")
    requested_credit: float = Field(..., gt=0, description="申请授信额度(万元)")

class AssessmentResponse(BaseModel):
    enterprise_id: str
    risk_level: str
    approved_limit: float
    rationale: str

@app.post("/api/v1/risk/assess", response_model=AssessmentResponse)
async def assess_risk(req: AssessmentRequest):
    # 模拟快速集成外部征信数据源(使用非阻塞 HTTP 异步客户端)
    async with httpx.AsyncClient(timeout=3.0) as client:
        try:
            # 原型期可灵活接入沙箱或生产灰度接口
            # res = await client.get(f"https://credit.internal/api/v1/score/{req.enterprise_id}")
            mock_credit_score = 720  # 假设获取到的外部征信基准分
        except httpx.RequestError:
            mock_credit_score = 600  # 优雅降级策略

    # 原型期迅速固化核心业务计算规则
    ratio = req.requested_credit / req.declared_revenue
    if mock_credit_score >= 700 and ratio <= 0.3:
        risk_level = "LOW"
        approved = req.requested_credit
        rationale = "征信表现良好,授信杠杆比例合规"
    else:
        risk_level = "MEDIUM"
        approved = req.requested_credit * 0.6
        rationale = "触发稳健风控阈值,按比例缩减授信"

    return AssessmentResponse(
        enterprise_id=req.enterprise_id,
        risk_level=risk_level,
        approved_limit=round(approved, 2),
        rationale=rationale
)mypy --strict 静态类型检查、补全单元测试覆盖,并将关键数据结构固化为不可变契约,以此兼顾探索速度与生产韧性。
二、“胶水语言”本色:异构系统整合与资产盘活
在现实世界的企业 IT 环境中,“全新纯净架构(Greenfield)”几乎是罕见的奢侈品。绝大多数中大型企业面对的现状都是林立的技术孤岛:运行了十余年的 C/C++ 核心定价库、庞大的 Java 传统单体 ERP、基于 Go 构建的高并发网关、部署在公有云上的各类 SaaS 服务,以及格式各异的底层数据库。
推倒重构这些老旧系统的财务成本与业务风险往往不可接受。企业的核心诉求不是消灭异构,而是如何以最低的摩擦力将它们“缝合”成一个有机整体。这就是 Python 被尊称为企业级“胶水语言(Glue Language)”的不可替代之处。
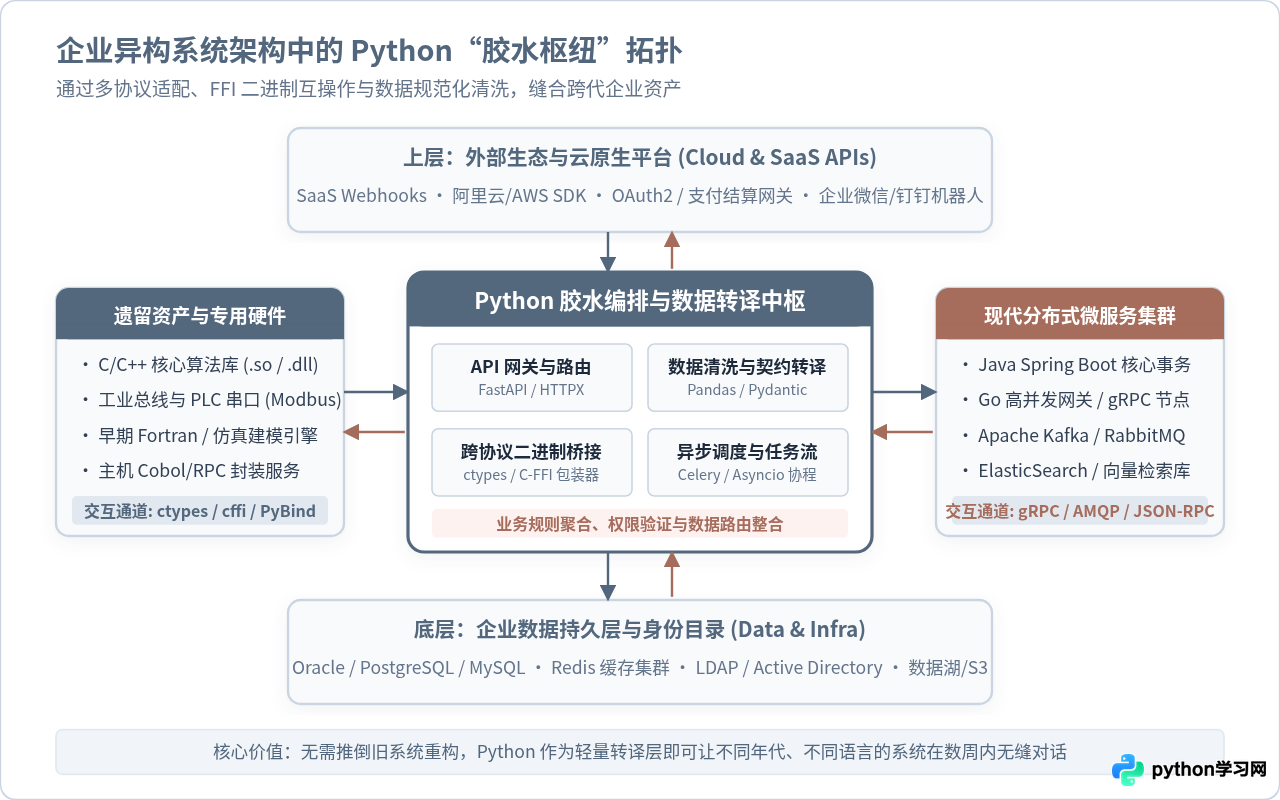
Python 实现异构系统低成本整合的底层支撑主要来自三个维度:
- 原生的外部函数接口(FFI):内置的
ctypes模块和cffi使得 Python 能够直接加载 C/C++ 编译生成的动态链接库(.so 或 .dll),直接在内存中传递指针和结构体,无需通过繁琐的网络 RPC 即可复用数十年积累的高性能算法资产。 - 全覆盖的协议栈与格式驱动:无论是处理古老的 SOAP/XML、Modbus 工业串口协议,还是现代的 gRPC、Apache Kafka、RabbitMQ,Python 社区均拥有工业级封装,几行代码即可完成报文的逆向解析与转译。
- 强大的内存数据变换中枢:结合 Pandas 与标准库的序列化设施,Python 能在内存中对不规范的数据进行流式清洗与类型对齐,作为跨系统之间的数据整流器。
系统整合实操:通过 ctypes 桥接遗留底层 C 动态库
假设企业内部保留了一套高性能的 C 语言金融收益测算模块,已被编译为 libfinancial_calc.so。业务团队需要在新业务中复用其算力,同时对外提供标准的现代化接口。利用 Python 进行底层桥接的代码极为清晰:
import ctypes
import os
from dataclasses import dataclass

# 1. 精确映射 C 语言中的结构体契约
class CalcParam(ctypes.Structure):
    _fields_ = [
        ("principal", ctypes.c_double),     # 本金
        ("annual_rate", ctypes.c_double),   # 年化利率
        ("term_months", ctypes.c_int32),    # 期限(月)
        ("repay_type", ctypes.c_int32)      # 还款方式:1-等额本息,2-先息后本
    ]

# 2. 安全加载企业动态库
lib_path = os.getenv("LEGACY_LIB_PATH", "./libfinancial_calc.so")
# calc_lib = ctypes.CDLL(lib_path)

# 3. 指定底层 C 函数的形参与返回类型,防止内存越界与崩溃
# calc_lib.execute_simulation.argtypes = [ctypes.POINTER(CalcParam)]
# calc_lib.execute_simulation.restype = ctypes.c_double

@dataclass
class SimulationResult:
    estimated_interest: float
    status: str

def bridge_legacy_calculation(principal: float, rate: float, months: int, repay_mode: int) -> SimulationResult:
    """包装遗留底层 C 库的高层企业胶水函数"""
    param = CalcParam(
        principal=principal,
        annual_rate=rate,
        term_months=months,
        repay_type=repay_mode
    )

    try:
        # result = calc_lib.execute_simulation(ctypes.byref(param))
        # 此处模拟底层动态库的高精度计算返回值
        result = round((principal * rate * (months / 12.0)), 4)
        return SimulationResult(estimated_interest=result, status="SUCCESS")
    except Exception as exc:
        return SimulationResult(estimated_interest=0.0, status=f"FFI_ERROR: {exc}")

# 执行示例
if __name__ == "__main__":
    res = bridge_legacy_calculation(1_000_000.0, 0.045, 12, 1)
    print(f"跨语言胶水调用成功 -> 测算利息: {res.estimated_interest} 元,状态: {res.status}")
三、架构权衡矩阵:理解 Python 的能力边界
成熟的技术选型绝不盲目宣称某种语言是“灵丹妙药”。了解一种工具在什么场景下不适用,往往比了解它的优势更为重要。Python 在企业环境中的优势边界非常清晰:它擅长I/O 密集型编排、探索性数据流水线与跨域连接,但在单核 CPU 密集型计算与超低微秒级延迟场景中,存在原生解释器开销与全局解释器锁(GIL)的固有制约。
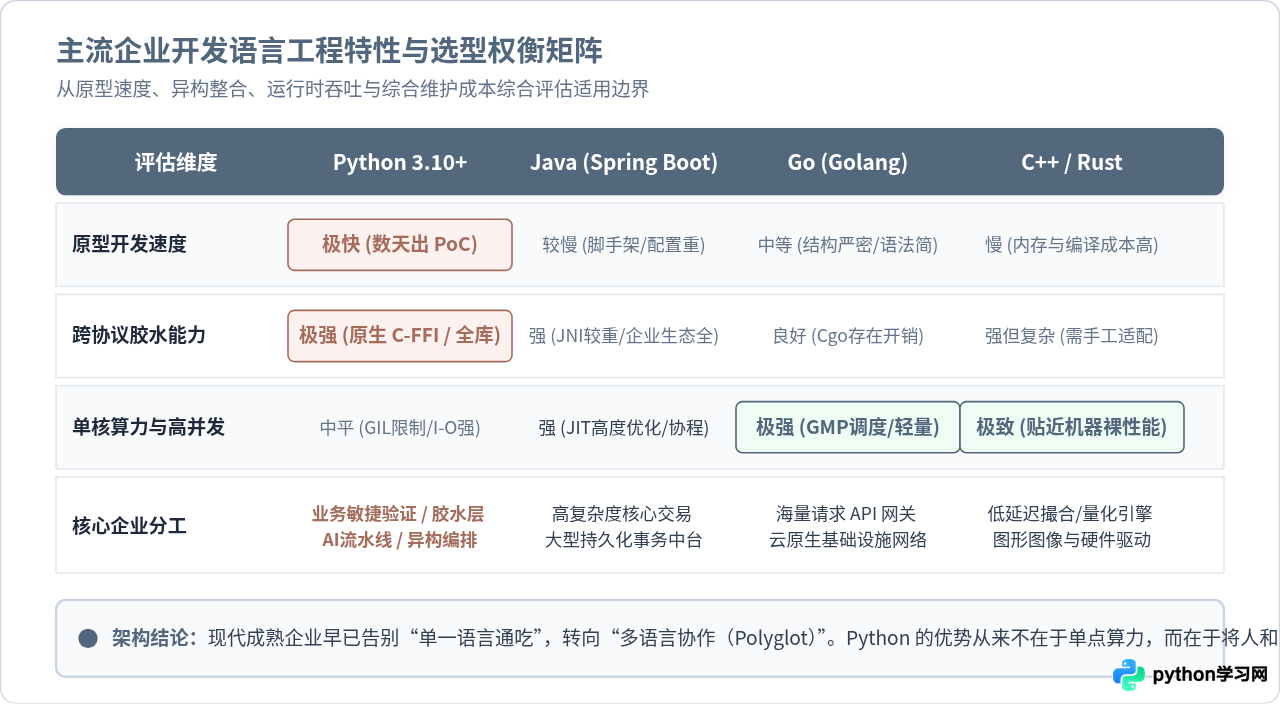
在企业级架构中,盲目要求“全站纯 Python”或“全站纯 Go/Java”都是违背工程经济学的偏颇做法。当下的行业共识是拥抱多语言协同(Polyglot Architecture):
| 层级 / 模块类型 | 首选技术栈 | 核心分工与选用理由 |
|---|---|---|
| 业务快速原型与试错层 | Python | 交付周期以天为单位,迅速捕捉市场反馈,避免死锁在前期框架脚手架中。 |
| 异构系统集成与数据调度层 | Python | 调用各类 FFI 二进制库、连接不同年代协议,执行 ETL 清洗与工作流调度。 |
| 高并发接入网关 / 通信协议面 | Go / Rust | 轻量协程与静态编译模型,专注承担海量网络连接与极低系统开销的请求分发。 |
| 核心交易账务与分布式重事务 | Java | 依靠极其严谨的编译期静态类型系统与成熟的分布式事务框架保障数据一致性。 |
| 底层计算密集型内核 | C++ / Rust / CUDA | 直接操控内存与硬件向量化指令,作为底层动态库供 Python 高层调用。 |
四、落地决策:企业采纳 Python 的演进指南
当企业面临一个具体项目的技术立项时,应当遵循怎样的方法论来决定是否采用 Python?综合软件工程生命周期与团队人力结构,企业可以通过以下决策路径进行推演:
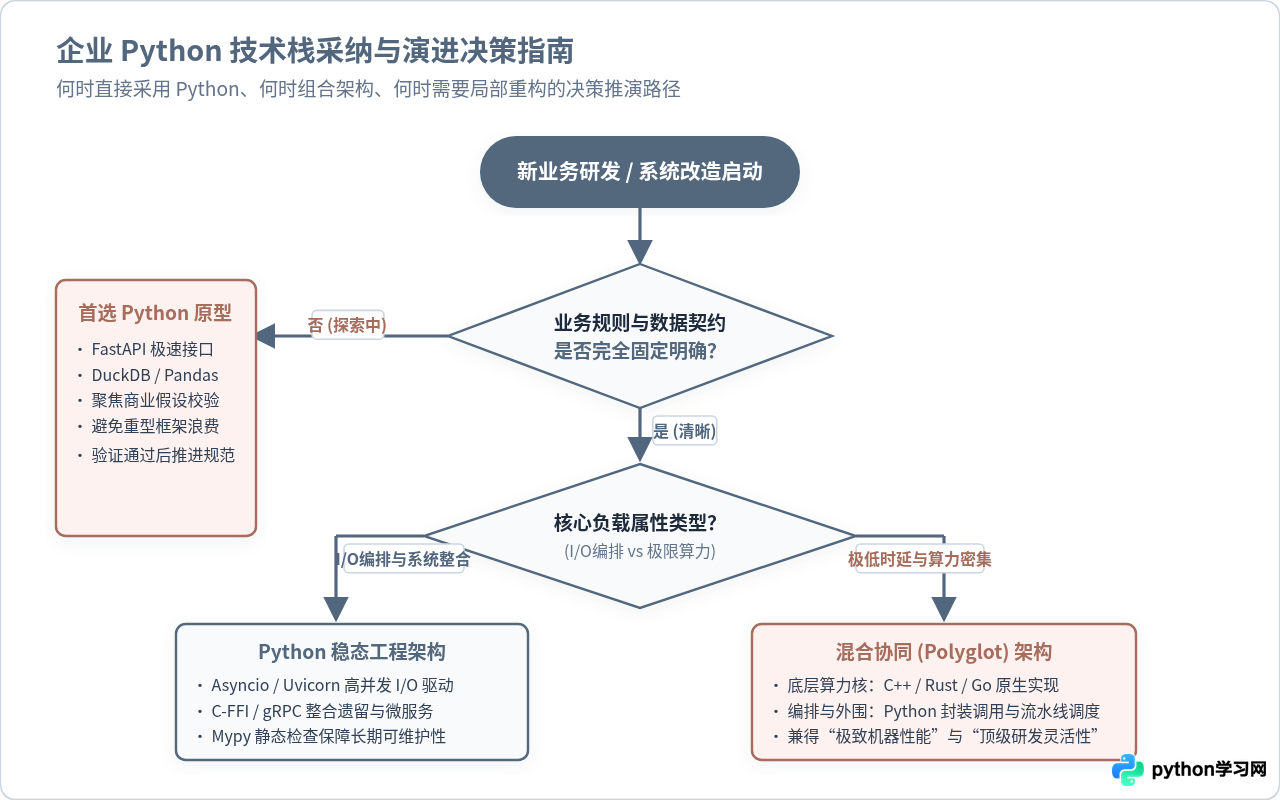
企业工程化治理的四条关键准则
为了保证 Python 项目能够健康地从原型期过渡到长期维护期,团队在日常工程实践中应严格落实以下基准规范:
- 强类型渐进约束:在新代码库中全面启用类型注解(Type Hints),并将其作为 CI/CD 流程中的硬性阻断项。利用
Pydantic处理系统边界输入,利用TypedDict和Dataclass规范内部传递。 - 端口与适配器设计(六边形架构):将业务核心计算与底层外部适配器(如数据库连接、外部 API、C 动态库)解耦。即便未来某一个核心热点需要用 Rust 或 Go 重写,只需替换适配器实现,而不影响外层编排流程。
- 确定性依赖锁定:严禁使用开放版本号的
requirements.txt,统一使用现代依赖管理工具(如uv或poetry)生成跨平台的lock文件,杜绝生产环境“浮动版本引发的不一致事故”。 - 合理划定异步与同步边界:对于常规 I/O 密集型网络通信,全面采用
asyncio机制;对于耗时的计算任务或阻塞型系统调用,坚决引入 Celery 等分布式队列分发到独立 Worker 节点,保持主事件循环的顺畅。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









