

Python是脚本语言吗:解释执行机制与定义解析
深入解析Python是否属于脚本语言,系统剖析从源码解析、抽象语法树生成到字节码编译及PVM虚拟机解释执行的完整机制,厘清脚本特性与通用编程语言的技术边界。
一、重新审视“脚本语言”:定义演化与技术光谱
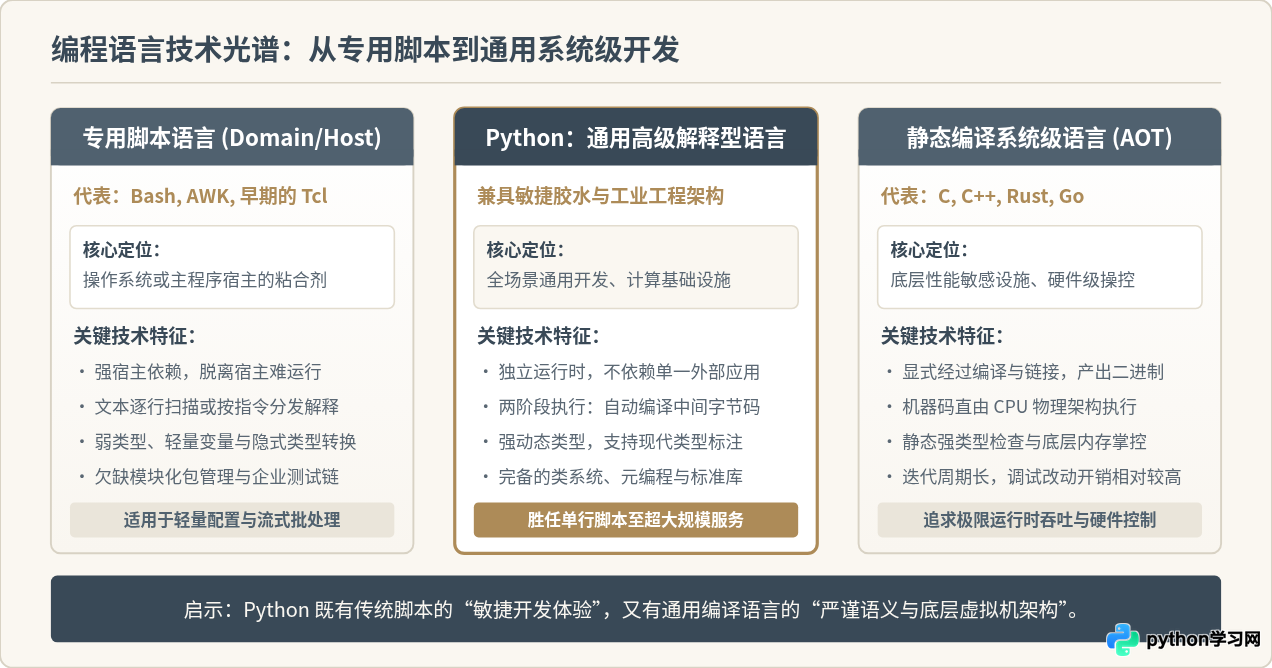
要回答 Python 是否为脚本语言,必须先厘清计算机科学语境下“脚本语言”(Scripting Language)的定义演化。在软件工程早期,“脚本”通常指依附于某个特定宿主系统(Host System)的轻量级胶水代码。例如,Unix Shell 依赖操作系统内核调度外部命令,sed 和 awk 依赖行缓冲流,浏览器的早期 JavaScript 用于操控宿主网页的 DOM 树。
传统的脚本语言通常具备三个典型标签:其一,高度依赖宿主,难以脱离宿主环境独立设计复杂的系统级逻辑;其二,执行方式多为直接的源码解释,按行或按语句扫描解析,缺少结构化的中间产物;其三,语法设计侧重短平快,往往牺牲模块封装、数据类型严谨性以换取短脚本的开发效率。
随着语言技术的发展,传统的边界已大幅模糊。Python 在诞生之初(1991年),设计者 Guido van Rossum 的初衷就是为了填补“Shell 脚本开发能力有限”与“C 语言系统开发过于繁重”之间的断层。Python 继承了脚本语言的易用性与交互性,但从一开始就引入了异常处理、函数定义、类机制以及基于 C 扩展的高性能模块,建立了完全独立的独立运行时系统(Standalone Runtime)。
二、核心解释执行机制:CPython 是如何运作的?
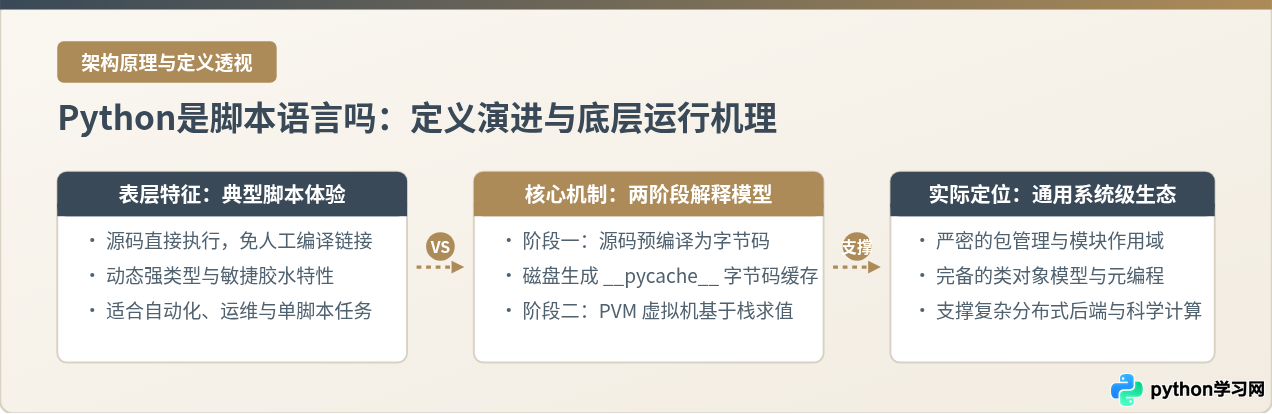
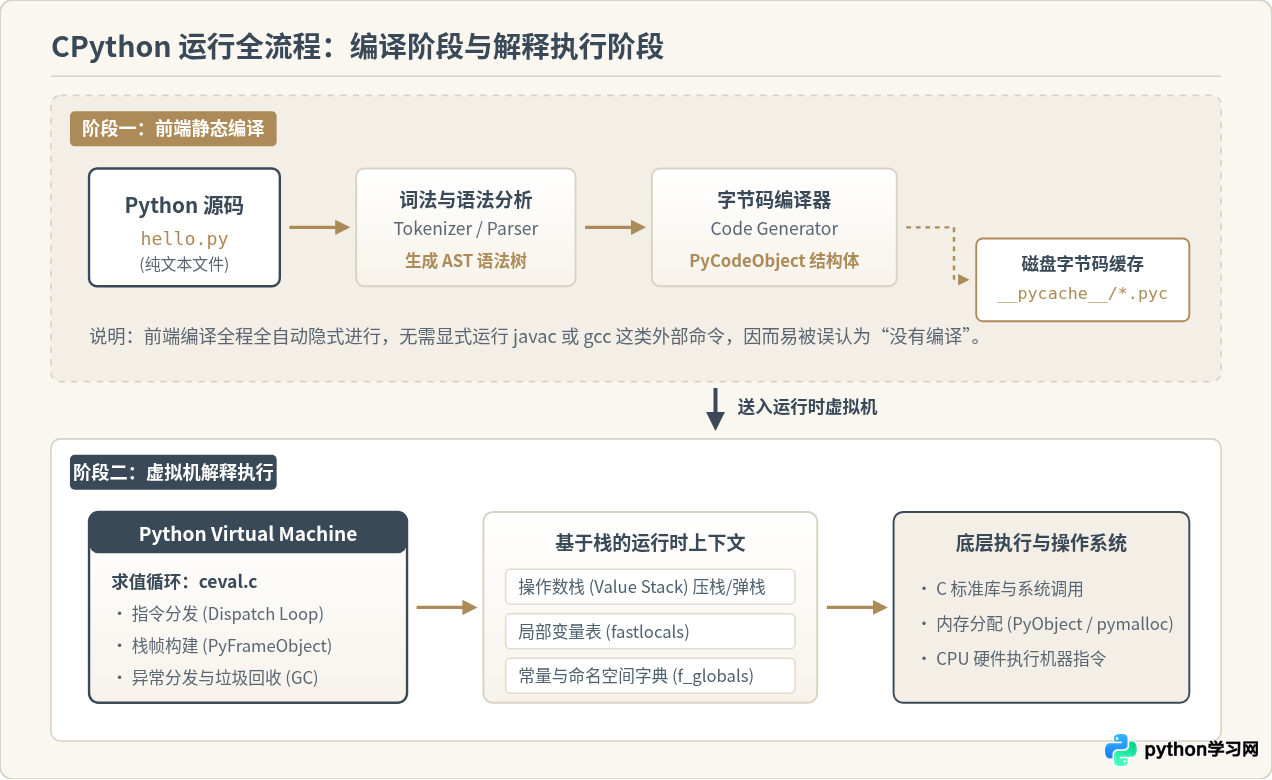
许多初学者误以为:输入 python main.py 后,操作系统或解释器会像读文章一样,一行一行读取 Python 文本并直接转成 CPU 指令执行。这是对“解释执行”最常见的误解。在官方标准实现 CPython 中,代码的执行严格划分为两个阶段:前端编译阶段与后端虚拟机解释阶段。
1. 前端编译:从源码到字节码
当你向 Python 解释器提交一段源码时,首先触发的不是执行,而是编译(Compilation):
- 词法分析(Lexing / Tokenizing):词法扫描器将原始文本字符串拆解为具有语法意义的标记单元(Tokens),如关键字
def、标识符、操作符等。 - 语法分析(Parsing):解析器验证标记序列是否符合 Python 语法规范,并构建起树状的抽象语法树(Abstract Syntax Tree, AST)。
- 生成控制流图与符号表(CFG & Symbol Table):分析变量的作用域(局部变量
local、自由变量free、全局变量global)。 - 字节码生成(Code Generation):编译器遍历 AST,将其转换成紧凑的平台无关指令集,即字节码(Bytecode),最终打包为代码对象(
PyCodeObject)。
2. 磁盘缓存:__pycache__ 与 .pyc 文件
为了避免在每次导入模块时重复执行前端编译,Python 会将编译生成的 PyCodeObject 序列化并写入磁盘,保存在同级目录下的 __pycache__ 文件夹中,后缀为 .pyc。该文件头部写入了对应的解释器魔数(Magic Number)和源文件修改时间戳(或哈希值)。当源文件未发生变动时,后续加载将直接越过语法分析与编译步骤,直接载入字节码,大幅加速启动耗时。
3. 后端解释:Python 虚拟机(PVM)的求值循环
编译完成后,字节码被送入 Python 虚拟机(Python Virtual Machine, 简称 PVM)。PVM 并不是像 VMware 或 VirtualBox 那样的硬件级系统模拟器,而是一个以 C 语言实现的进程内指令调度循环。在 CPython 源码中,其核心就是 Python/ceval.c 中的求值函数(在现代 Python 版本中为 _PyEval_EvalFrameDefault)。
PVM 是一个基于栈(Stack-based)的抽象计算模型。每次函数调用都会在调用栈上分配一个独立的栈帧(PyFrameObject)。栈帧中包含了局部变量数组(fast locals)、全局命名空间映射字典、常量元组以及供运算暂存的操作数栈(Value Stack)。PVM 依序读取字节码指令,根据操作码(Opcode)从栈顶弹出数据、执行 C 语言级函数计算,再将结果压回栈顶。
三、动手验证:用 dis 模块透视字节码与栈帧
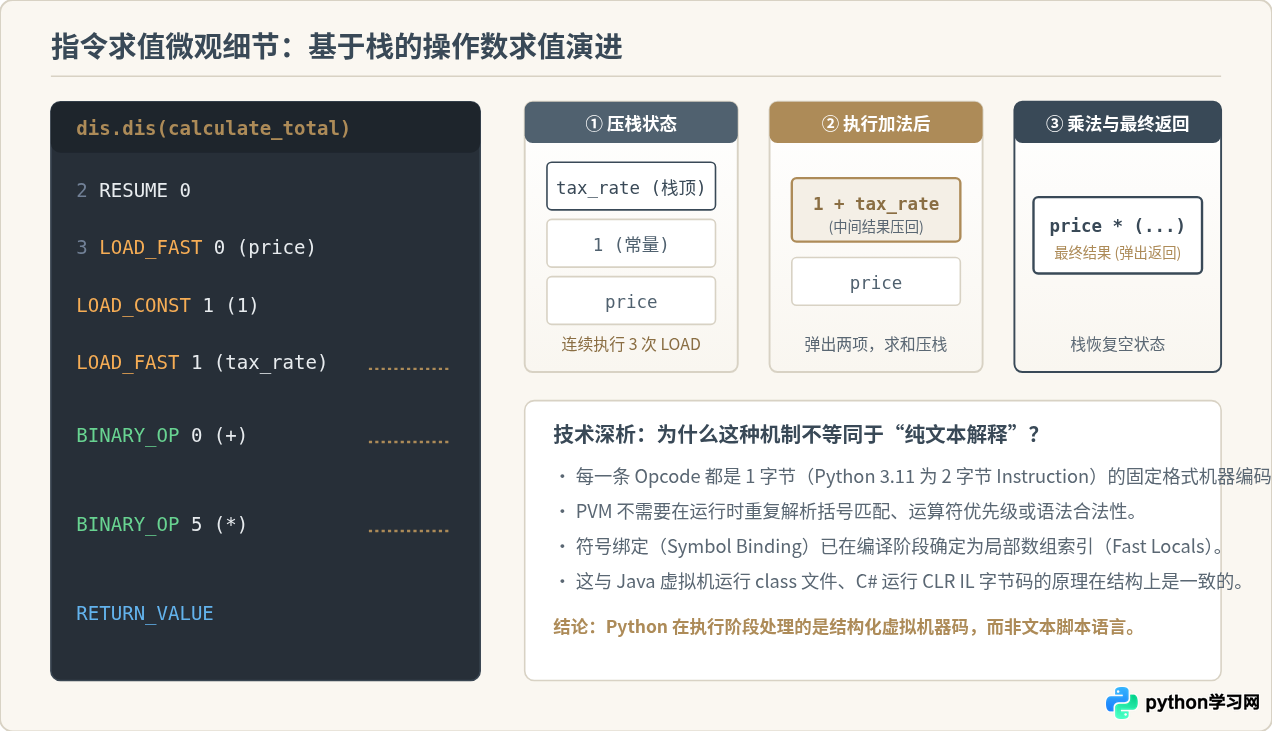
为了让抽象的虚拟机概念具象化,我们可以借助 Python 标准库中自带的反汇编模块 dis,直接观察函数编译出的中间字节码。下面的示例代码展示了一个简单的计算函数及其反汇编结果:
import dis

def calculate_total(price, tax_rate=0.08):
    return price * (1 + tax_rate)

# 调用 dis 模块反汇编函数的字节码
dis.dis(calculate_total)
在 Python 3.11+ 环境下运行上述脚本,得到的字节码输出如下(示例输出):
  2           0 RESUME                   0

  3           2 LOAD_FAST                0 (price)
              4 LOAD_CONST               1 (1)
              6 LOAD_FAST                1 (tax_rate)
              8 BINARY_OP                0 (+)
             12 BINARY_OP                5 (*)
             16 RETURN_VALUE
仔细分析这段输出,我们可以发现底层 PVM 的求值逻辑极其严密:
LOAD_FAST 0 (price):从当前栈帧的局部变量数组索引 0 中取出price,压入操作数栈顶。LOAD_CONST 1 (1):从常量表中取出常量1,压入操作数栈顶。LOAD_FAST 1 (tax_rate):从局部变量数组索引 1 中取出tax_rate压入栈顶。此时栈内从底向上依次为:[price, 1, tax_rate]。BINARY_OP 0 (+):PVM 弹出栈顶的两个元素(1和tax_rate),调度 C 底层实现将它们相加,然后将计算结果(1 + tax_rate)重新压入栈顶。BINARY_OP 5 (*):弹出price与相加后的中间结果,执行乘法,并将最终计算结果压入栈顶。RETURN_VALUE:弹出栈顶元素,作为当前函数的返回值交付给调用方。
四、关键认知辨析:打破围绕“脚本”的常见误解
澄清了执行机制之后,我们可以重新审视开发者群体中常见的关于 Python 的几个代表性认知偏差:
| 常见观点 | 真实技术成因剖析 | 工程边界与事实启示 |
|---|---|---|
| “Python 是脚本语言,所以不能做大型系统” | 现代 Python 拥有完备的模块管理、命名空间隔绝、面向对象继承、装饰器及从 3.5 起引入的类型标注(Type Hints)。通过 mypy 等工具可完成大型工程所需的静态类型检验。 |
Instagram、YouTube、Dropbox 等大型工程后端核心均由百万行级 Python 架构支撑,证明其具备支撑大型软件工程的完整能力。 |
| “Python 执行慢是因为它是脚本语言” | Python 运行耗时主要源于动态类型解析(每次运算均需检查对象的 ob_type)、对象装箱拆箱(哪怕一个整数也是堆分配的 PyLongObject)和全局解释器锁(GIL),而非“脚本”身份。 |
在数值密集与矩阵运算领域,通过接入 C/C++ 编写的底层扩展(如 NumPy、PyTorch),Python 能够无损调动硬件性能。 |
| “Python 代码只能由 CPython 逐行解释” | Python 是一门语言规范,CPython 只是官方的参考实现。Python 生态中存在多种针对不同性能需求的执行引擎与编译器。 | 例如 PyPy 使用元追踪 JIT(即时编译)技术,在运行时直接将高频字节码编译为原生机器码;Cython 则将 Python 代码直接编译为 C 拓展。 |
脚本语言与系统级语言的真正分水岭,正逐渐从“是否预编译”转移到“静态类型系统与内存布局透明度”。诸如 PyPy 等 JIT 引擎证明了即使是纯正的 Python 代码,也可以在运行时动态生成 x86/ARM 原生机器指令执行。因此,将 Python 单纯归为“无法编译的脚本”在现代编译器技术下已不符合事实。
五、全文总结
回到最初的问题:Python是脚本语言吗?
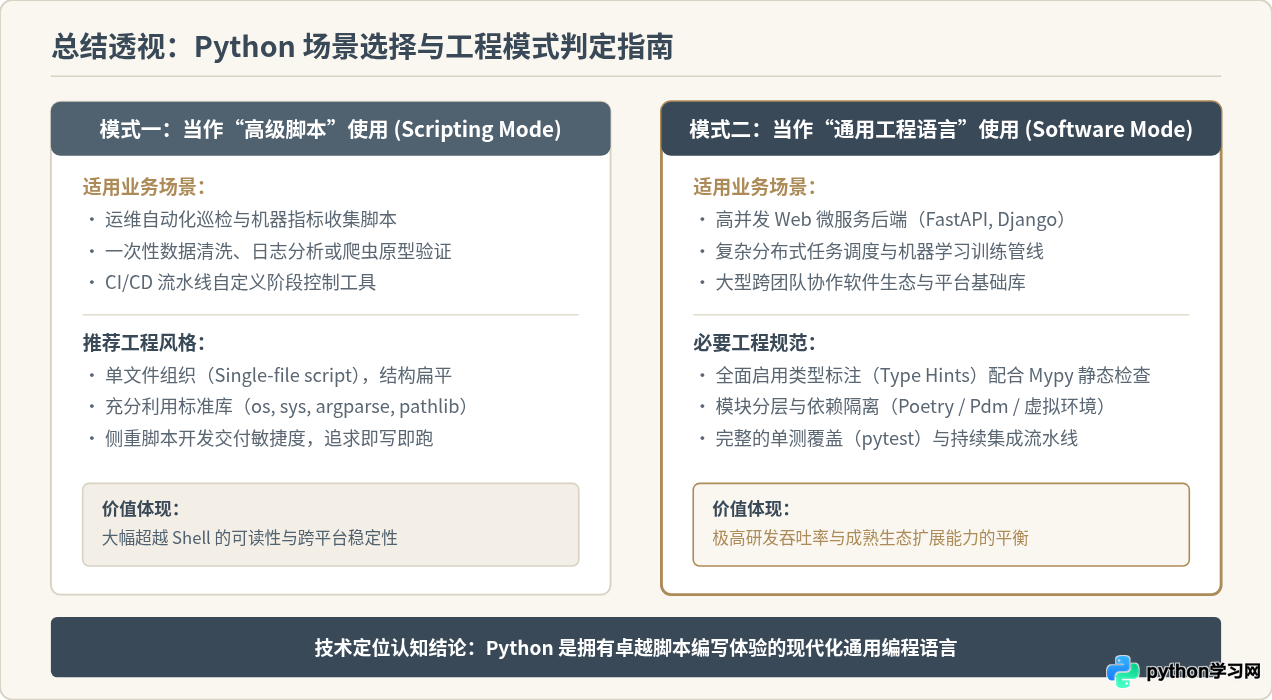
如果以“是否具备编写轻便自动化任务、免显式静态构建、快速交付的敏捷体验”为标准,答案是肯定的,Python 在日常应用中完全可以作为一把极其强大高效的瑞士军刀级脚本语言使用。
但如果以“计算机系统的执行架构、编译机理与通用工程能力”为标准,单纯将 Python 归为脚本语言则是不完整且具误导性的。它在底层运行着严密的两阶段流水线——将代码编译为中间字节码并在独立的栈式虚拟机中求值,同时提供了支撑超大型工业级系统的完整语言范式与包管理生态。理解这一点,有助于开发者跳出语言标签的刻板印象,在实际项目中更准确地选择架构模式与工程规范。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









