

为什么选择Python?易学性、社区生态与就业前景分析
围绕Python的易学性机制、社区与第三方库生态、主流就业岗位需求及学习落地路径,提供客观、详实的分析与决策建议。
假设你现在需要处理上百个格式杂乱的销售报表表格,或者打算为部门搭建一个自动抓取行业新闻的内部工具。摆在面前的技术方案有很多,但几乎所有技术讨论中都会优先出现 Python。选择一门编程语言不仅关乎“Hello World”怎么写,更决定了解决实际业务问题的协作成本与职业路径。本文直接围绕 Python 的语法易学性、社区工具生态、就业市场客观需求以及具体的学习落地步骤展开评估,帮助你判断它是否符合当下的技术投入目标。
一、易学性解析:低心智负担与高执行反馈
很多语言强调运行时的极致性能或静态类型系统的严谨性,但这往往伴随着冗长的模板代码与陡峭的底层概念门槛。Python 的核心设计理念是“可读性优先”。它省去了显式的内存分配、指针追踪与强制编译过程,允许开发者将注意力集中在算法逻辑本身,而非语言的机制开销上。
为了直观对比代码表达的复杂度,我们来看一个常规任务:从一组整数列表中筛选出偶数并计算平方。在部分静态编译语言中,需要定义类、声明类型、配置输入输出通道;而在 Python 中,通过内置的高级容器与列表推导式,两行代码即可完整实现业务逻辑:
# 任务:从原始序列筛选出偶数并计算平方
raw_numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]

# Python 列表推导式:表达筛选与转换
even_squares = [x ** 2 for x in raw_numbers if x % 2 == 0]

print("处理结果:", even_squares)
# 输出结果示例: [4, 16, 36, 64, 100]{}。这意味着代码格式从一开始就是语法规则的一部分,团队成员提交的代码天然具备一致的版式。
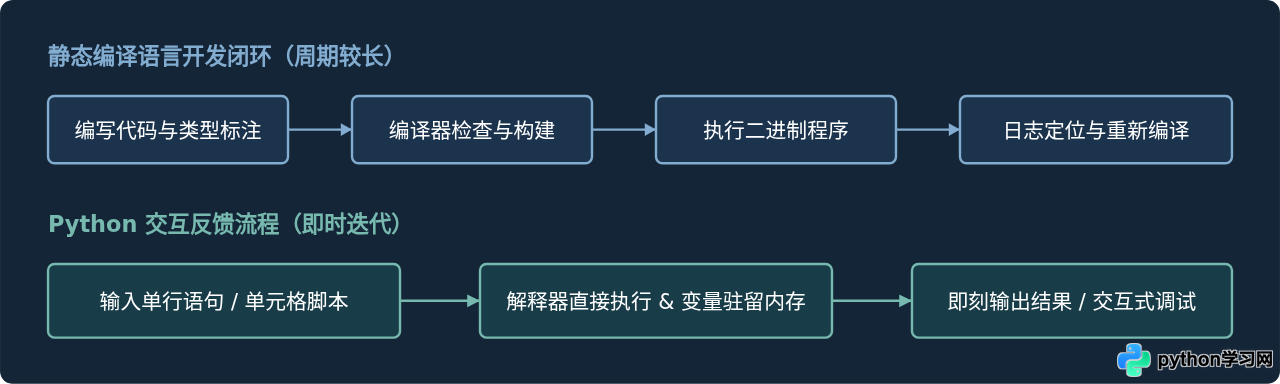
不仅语法直观,从编写源码到验证运行的反馈闭环也极短。静态语言通常经历“编辑代码 → 编译器类型检查 → 构建可执行程序 → 运行排错”的较长循环。Python 作为动态解释型语言,配备了内置交互式终端(REPL)与 Jupyter 笔记本环境,输入单行表达式即可实时查看中间变量状态,将试错成本降到最低。
二、社区与生态:胶水语言与全栈标准工具链
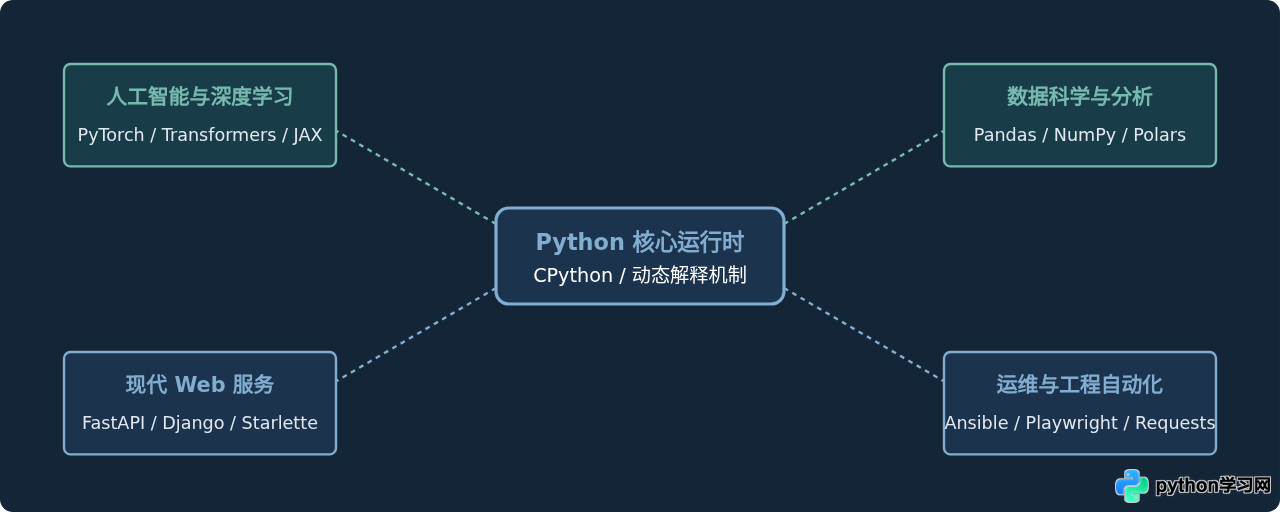
单纯语法简单不足以维持持续的技术生命力。Python 真正的技术壁垒在于官方包索引平台 PyPI(Python Package Index)上累积的几十万个即插即用库。作为典型的“胶水语言”,Python 的底层核心允许深度集成由 C、C++ 或 Rust 编写的高性能模块,这使它同时具备了脚本语言的编写灵活性与底层语言的运算性能。
在不同工程领域,Python 已经沉淀出了标准化的事实技术底座:
- 数据科学与统计计算:NumPy 提供了底层连续内存的高性能矩阵运算;Pandas 构筑了通用的结构化数据分析基石;Matplotlib 与 Seaborn 承担多维度图表生成。
- 机器学习与人工智能:主流框架如 PyTorch、TensorFlow 均将 Python 作为首选调用 API;在大语言模型领域,LangChain、Transformers 与 vLLM 等工具链几乎全部围绕 Python 优先发布。
- Web 开发与自动化测试:FastAPI 借助类型提示实现了现代异步高性能接口开发;Django 提供了开箱即用的后台管理与 ORM 系统;Playwright 与 Selenium 覆盖了端到端自动化。
三、就业前景分析:岗位类型、技能壁垒与客观局限
在就业市场中,不能把“掌握 Python 语法”直接等同于“具备求职竞争力”。Python 在行业中主要扮演两种角色:一种是核心工程语言,另一种是跨岗位复合赋能工具。不同方向对核心技能树的深度要求差异显著。
| 岗位方向 | 典型业务场景 | 除 Python 外的核心技能门槛 | 市场竞争特点 |
|---|---|---|---|
| AI / 算法工程师 | 大模型微调、推荐系统、CV/NLP 落地 | 线性代数、微积分、CUDA、分布式训练 | 学历与数学门槛极高,非纯写代码 |
| 数据分析师 | 业务洞察、指标搭建、报表管道处理 | SQL、业务理解、Tableau/PowerBI | 入门人群广泛,单纯会写脚本易遇瓶颈 |
| 后端 / API 研发 | 微服务开发、内部业务平台、数据接口 | MySQL、Redis、Docker、Linux、架构设计 | 大型互联网企业以 Java/Go 为主,中小型更重全栈 |
| 自动化测试与运维 | CI/CD 管道配置、监控脚本、测试平台 | Kubernetes、Shell、网络协议、测试框架 | 岗位稳定,结合 DevOps 技能后替代率较低 |
四、实践落地:从开发环境搭建到基础工作流
了解价值后,最有效的前进方式是搭建一个标准、可复现的本地运行环境。当前生产环境中,强烈建议使用轻量且高速的现代工具管理环境,避免系统全局 Python 污染。
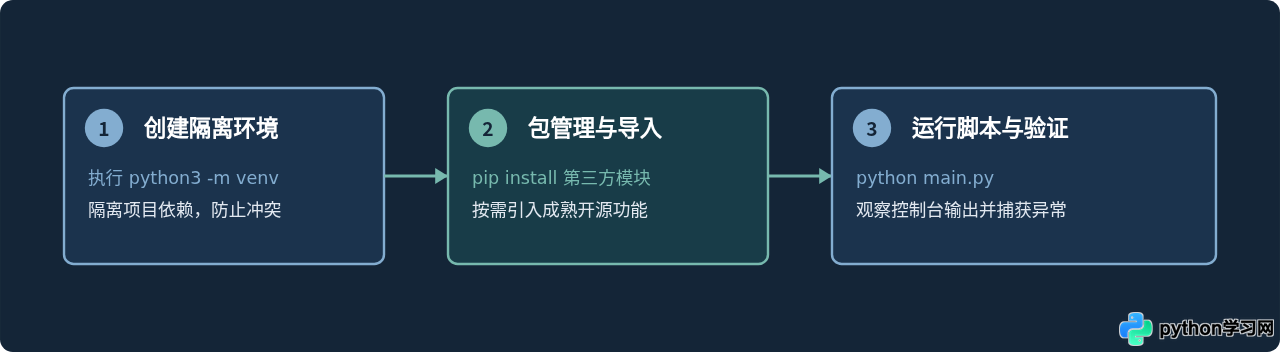
以下基于通用终端环境,演示从隔离环境创建到执行脚本的标准操作步骤:
第 1 步:创建并激活虚拟环境
在终端(Linux/macOS 终端或 Windows PowerShell)中打开工作目录,使用 Python 内置的 venv 模块隔离项目依赖:
# 1. 检查 Python 版本(建议 3.10 及以上)
python3 --version

# 2. 在当前目录下创建名为 my_project_env 的隔离环境
python3 -m venv my_project_env

# 3. 激活虚拟环境
# Linux / macOS:
source my_project_env/bin/activate
# Windows PowerShell:
# .\my_project_env\Scripts\Activate.ps1
执行完成后,终端提示符前应出现 (my_project_env) 标识,表示当前所有第三方包的安装都将被限制在独立工作区内。
第 2 步:安全安装第三方工具库
在激活的环境内,使用 pip 安装数据处理与自动化最常用的请求库:
pip install requests pandas终端应返回下载、哈希校验及安装成功的日志反馈。安装后可通过 pip list 确认当前环境已安装的模块列表及其具体版本号。
五、理性决策与学习进阶路径
决定投入时间学习 Python 前,建议根据最终目标确立阶段性里程碑。不要陷入无止境的基础语法记忆,而应采用以目标产出驱动的推进方式。
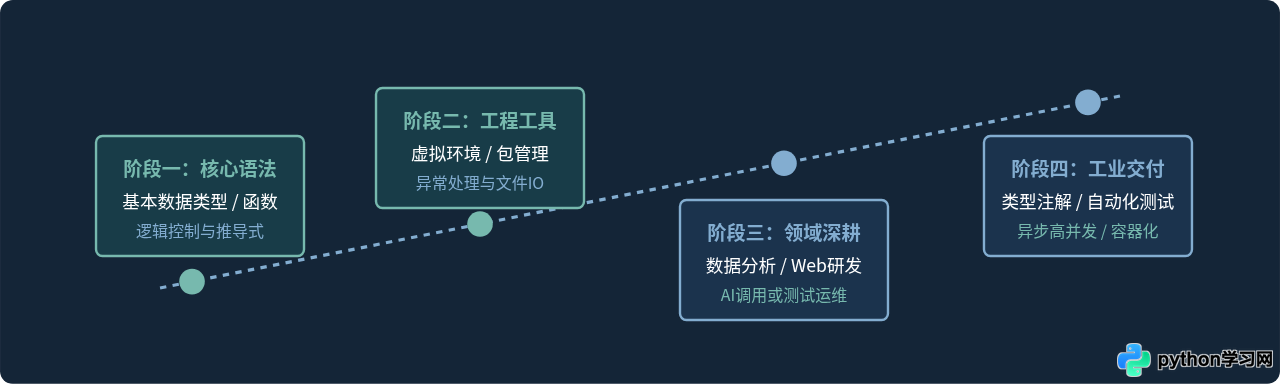
一条被普遍验证的学习路径包括以下四个阶段:
- 语法基石阶段(约1-2周):掌握条件判断、循环语句、基础数据结构(列表、字典、元组、集合)与函数定义。能独立编写解决具体算术逻辑的脚本。
- 环境与工具链阶段(约1周):熟悉命令行交互、
pip源配置、虚拟环境管理,学会阅读官方文档与标准库函数签名。 - 垂直场景专攻阶段(约3-4周):根据自身诉求选择一个分支(如利用 Pandas 进行日常数据自动化清洗,或使用 FastAPI 编写后端数据接口),不盲目跨界铺开。
- 工程规范阶段(长期):引入类型注解(Type Hints)、单元测试(pytest)、代码格式化工具(Ruff/Black)与异步并发(asyncio),构建工业级项目的规范交付意识。
综上所述,选择 Python 的本质是选择一种开发效率极高、工具支持极其完善、具备跨领域通用属性的解决问题方式。它虽在底层性能和并发开销上有既定物理限制,但凭借其在人工智能、数据分析和系统集成领域的不可替代性,依然是当前兼顾个人学习曲线与职场复利极具性价比的技术路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









