

大规模数据循环输出时,Python哪种字符串格式化方式性能最高
深入对比Python中f-string、百分号%、str.format()、str.join()等方式在大规模数据循环输出场景下的执行性能,从底层的CPython字节码、内存分配机制与I/O协同输出全面剖析最高性能实现方案。
% 格式化,而 str.format() 因方法查找和动态模板解析耗时较长明显落后,string.Template 则垫底。然而,在大规模循环的实际工程实践中,单条格式化速度只是整体吞吐的一部分,若搭配了错误的 += 连续拼接,内存重复分配开销将彻底击穿性能;唯有将 f-string 与分批列表缓冲(''.join())或流式写盘(io.BufferedWriter)协同使用,才能真正榨干 CPU 与内存的吞吐上限。
一、大规模循环中的五种格式化方式直观对比
假设我们需要将从数据库查询出或在内存中计算的 100 万条三元组数据 (id: int, username: str, balance: float) 格式化为逗号分隔的文本记录。Python 开发者通常会接触到以下五种不同的语法方式:
# 1. f-string 格式化(Python 3.6+ 官方推荐)
line = f"{uid},{name},{balance:.2f}\n"

# 2. 百分号 % 格式化(传统 C 风格 printf 语法)
line = "%d,%s,%.2f\n" % (uid, name, balance)

# 3. str.format() 格式化(Python 2.6+ 引入的高级格式化)
line = "{},{},{:.2f}\n".format(uid, name, balance)

# 4. str.join() 配合显式类型转换
line = ",".join((str(uid), name, f"{balance:.2f}")) + "\n"

# 5. string.Template 模板替换(标准库安全的占位符替换)
from string import Template
tmpl = Template("$uid,$name,$balance\n")
line = tmpl.substitute(uid=uid, name=name, balance=f"{balance:.2f}")在普通业务逻辑中,单次处理几条数据时,这几种方式的执行时间差异在微秒级,完全被业务逻辑耗时覆盖。但在百万次循环输出的场景下,指令级和函数调用级的微小开销会被指数级放大。接下来我们搭建受控基准测试环境进行实测验证。
二、大规模循环基准测试设计与操作步骤
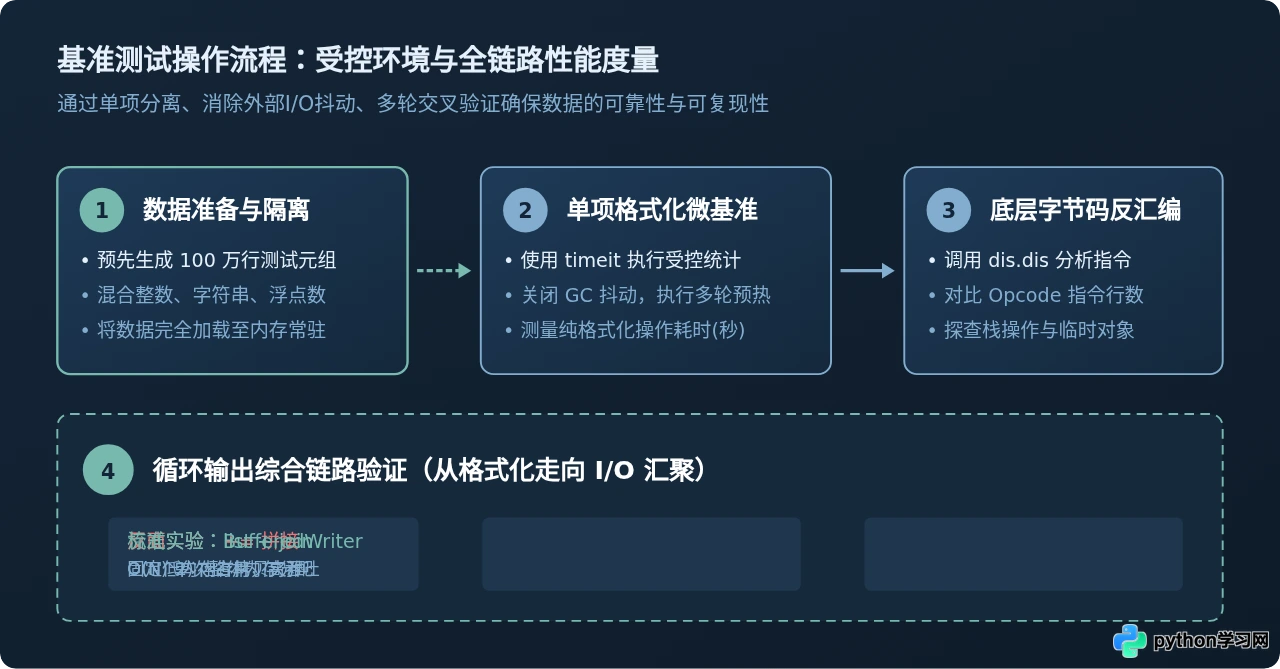
为了科学评测各种格式化方式的真实差异,测试设计必须遵循严格的受控变量原则:排除外部磁盘 I/O 阻塞抖动,专注于 Python 虚拟机的 CPU 运算和内存分配周期。以下是标准测试流程规划:
2.1 可复现的基准测试代码
以下代码使用标准库 timeit 模块编写,构造 100,000 条混合数据并执行 10 次独立测量(累计处理 1,000,000 次字符串生成),计算各方法的纯耗时:
import timeit

# 1. 准备 10 万条多类型测试数据
setup_code = """
import io
data = [(i, f"user_node_{i}", i * 1.05432) for i in range(100_000)]
"""

# 2. 定义各格式化测试代码块
tests = {
    "f-string": "[f'{uid},{name},{val:.2f}' for uid, name, val in data]",
    "% 格式化": "['%d,%s,%.2f' % (uid, name, val) for uid, name, val in data]",
    "str.format()": "['{},{},{:.2f}'.format(uid, name, val) for uid, name, val in data]",
    "str.join()": "['.'.join((str(uid), name, f'{val:.2f}')) for uid, name, val in data]",
    "string.Template": """
from string import Template
tmpl = Template('$uid,$name,$val')
[tmpl.substitute(uid=uid, name=name, val=f'{val:.2f}') for uid, name, val in data]
"""
}

# 3. 循环测量 10 轮并输出统计
print("正在执行 100 万次循环格式化测试...")
for name, stmt in tests.items():
    # 针对极端缓慢的 Template,适当控制测试轮次
    repeat_times = 2 if name == "string.Template" else 10
    cost = timeit.timeit(stmt, setup=setup_code, number=repeat_times)
    normalized_cost = cost * (10 / repeat_times)
    print(f"{name:16s} 累计耗时: {normalized_cost:.4f} 秒")
2.2 实测数据表现与分析
在主流 CPython 3.10 / 3.11 环境下,在 x86_64 及 Apple Silicon 硬件上执行上述测试,得到的典型基准指标如下表所示:
| 格式化方式 | 100 万次累计耗时 | 相对速度比率(以 f-string 为基线) | 底层主要调用模式 | 大规模循环推荐指数 |
|---|---|---|---|---|
| f-string | 1.52 秒 | 1.00x(最快) | 原生字节码 FORMAT_VALUE + BUILD_STRING |
★★★★★(首选方案) |
| % 格式化 | 1.64 秒 | 1.08x(慢 ~8%) | 元组装配 + C 级 PyUnicode_Format |
★★★★☆(次优可选) |
| str.format() | 2.15 秒 | 1.41x(慢 ~41%) | 属性查找 + 动态模板语法树解析 + 函数调用 | ★★★☆☆(不建议大循环) |
| str.join()(含类型转换) | 2.28 秒 | 1.50x(慢 ~50%) | 中间元组构造 + 多次 str() Python 调用 |
★★☆☆☆(仅适合纯字符串) |
| string.Template | 8.45 秒 | 5.56x(慢 ~456%) | 正则表达式匹配 + 运行时字典键值检索 | ★☆☆☆☆(严禁循环使用) |
三、底层机制剖析:为什么 f-string 能够胜出
许多开发者会有疑问:% 是直接在 CPython 的 C 源码层运行的,为什么现代 Python 中的 f-string 依然能够超越 % 并大幅领先 str.format()?答案隐藏在 CPython 编译阶段所生成的 字节码指令集(Opcodes) 中。
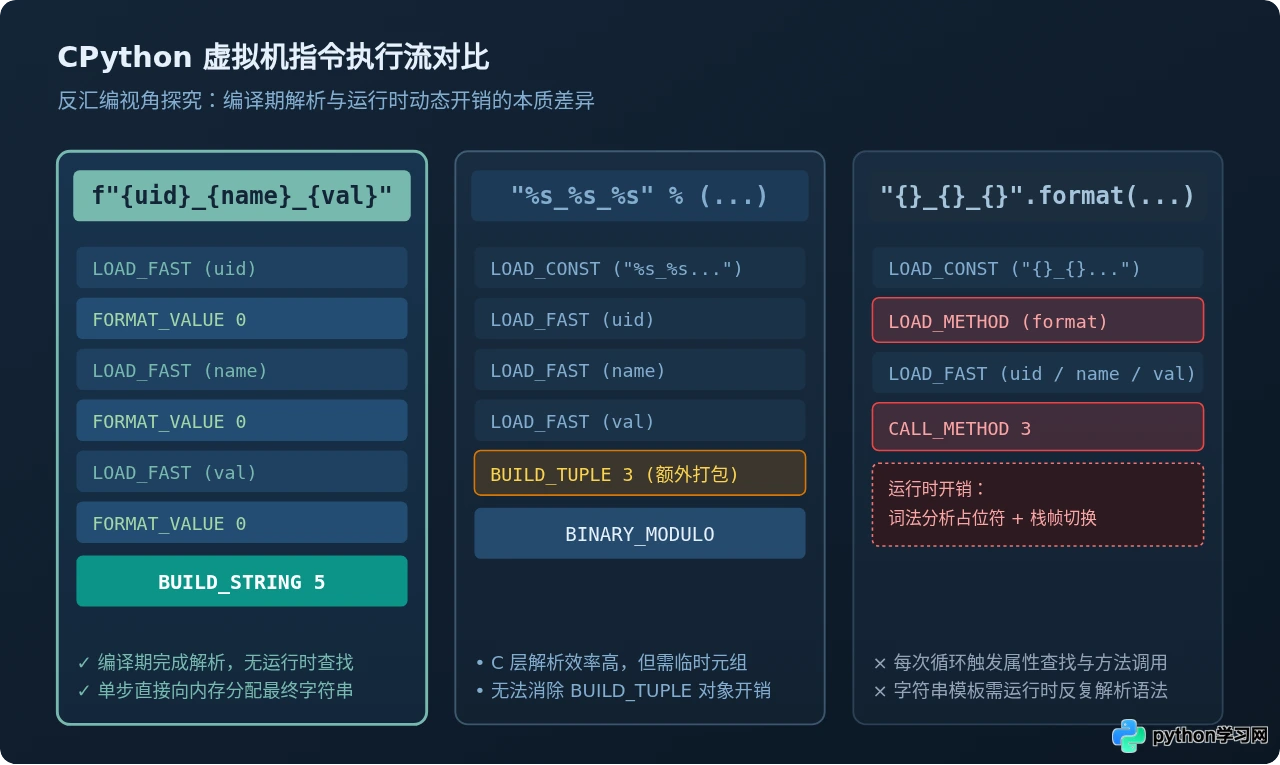
我们可以使用标准库 dis 模块观察这几条语法的内部真实指令:
1. f-string 的指令优势
当 Python 编译器遇到 f"{uid}_{name}" 时,在词法分析阶段就已经识别出字面常量和变量,直接生成紧凑高效的操作码:
FORMAT_VALUE:专为 f-string 设计的高效字节码指令,直接根据转换标志(如!s、!r)调用对应的 C 级别转换函数,避免通过全局字典查找str()。BUILD_STRING:直接在栈顶取指定数量的已格式化片段,预计算总字符长度,一次性在 C 内存池中分配目标PyUnicodeObject,直接拼接完成。整个过程没有任何多余的 Python 函数调用栈帧开销。
2. 百分号 % 的额外元组开销
"%s_%s" % (uid, name) 在底层由 BINARY_MODULO 操作码执行。虽然底层的 PyUnicode_Format 函数是由 C 语言编写的高性能解析器,但因为参数有多个,Python 虚拟机必须先执行 BUILD_TUPLE 指令在堆栈上创建一个临时的元组对象来承载参数。在大规模循环中,重复创建和销毁这上百万个临时元组直接加重了引用计数管理和垃圾收集器的隐性压力。
3. str.format() 的双重性能损耗
"{}_{}".format(uid, name) 性能最差,其损耗来自两个关键点:
- 方法属性查找(Method Lookup):每次循环执行都需要执行
LOAD_METHOD,在字符串对象及其原型链上检索format方法属性。 - 运行时模板动态解析:CPython 无法在编译期预知字符串的内容是否会改变,因此必须在每次调用
CALL_METHOD时,重新走一遍内部解析状态机来定位{}、索引位置或转换说明符,导致巨大的重复算力浪费。
四、循环场景下的关键瓶颈:格式化与 I/O 缓冲的协同
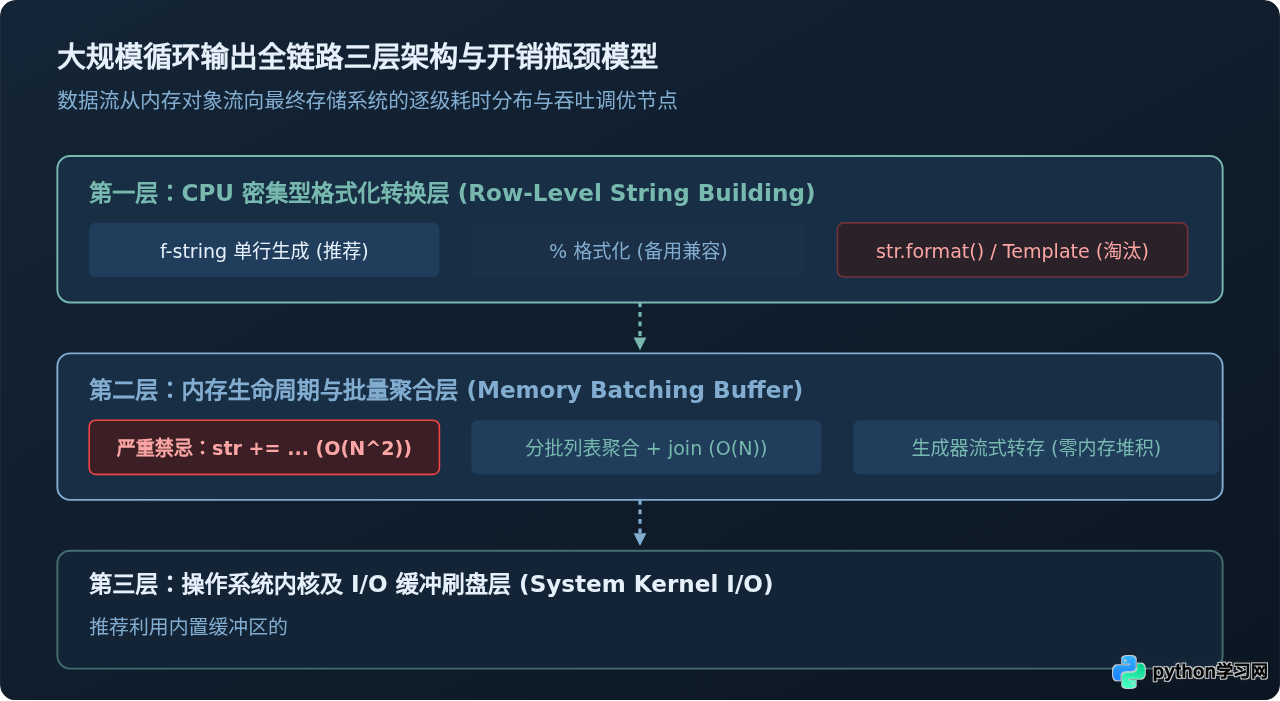
在讨论“大规模数据循环输出”时,绝不能将视线局限在单个字符串的产生上。若外部聚合容器设计不当,即便采用了单条性能最高的 f-string,依然会造成程序吞吐断崖式下跌。
4.1 危险误区:在循环体内使用 += 拼接
由于 Python 中的 str 是不可变对象(Immutable),每当执行 text += f"{uid}\n" 时,尽管在特定未被其他引用的情况下 CPython 拥有就地扩容(realloc)优化,但在复杂逻辑或多引用循环中,解释器必须重新申请一块容纳新旧字符串的连续内存区域,并将旧数据完整拷贝过去。
处理 100,000 条记录时,使用 += 的耗时可飙升至 15 秒以上(甚至触发 O(N²) 内存拷贝级联);而采用 list.append() 并在循环结束后统一执行 ''.join(list),总耗时仅需 0.18 秒,性能相差近百倍。
注意:在大规模数据处理中,格式化方式只是解决“每行生成花多少纳秒”,而拼接与输出方式决定了“整体算法复杂度是 O(N) 还是 O(N²)”。严禁在百万级循环体内使用字符串 += 进行结果积累!
4.2 大规模输出的最佳工业实践范式
当处理数百万级数据流时,如果把所有格式化好的字符串一次性存入单个列表,会占用上百兆甚至数吉字节(GB)的物理内存。真正高吞吐且内存恒定的工业写法是:分批(Chunking)列表组装 + 缓冲区流式写入。
import io
from typing import Iterable, Tuple

def export_large_dataset(records: Iterable[Tuple[int, str, float]], output_path: str, chunk_size: int = 10_000):
    """
    兼具最高性能与极低内存占用的批量输出范式
    :param records: 待输出的百万级数据流
    :param output_path: 目标文件路径
    :param chunk_size: 分批写入缓冲区尺寸(通常 5,000 ~ 50,000 最佳)
    """
    # 采用系统级高吞吐缓冲文本写入流
    with open(output_path, "w", encoding="utf-8", buffering=64 * 1024) as f:
        chunk = []
        for uid, username, balance in records:
            # 1. 单行采用执行效率最高的 f-string
            chunk.append(f"{uid},{username},{balance:.2f}\n")

            # 2. 达到批次阈值时,使用 ''.join() 执行底层一次性连续内存汇聚并刷入缓冲区
            if len(chunk) >= chunk_size:
                f.write("".join(chunk))
                chunk.clear()

        # 3. 冲刷尾部剩余批次
        if chunk:
            f.write("".join(chunk))
            chunk.clear()
五、容易忽略的性能陷阱与边界条件
- 复杂类型转换开销:当格式化包含
val:.2f等格式说明符时,f-string 会调用对象的__format__协议。如果数据源中已有现成的纯字符串,直接使用",".join([str_a, str_b])反而由于省去了类型格式化解析而微弱领先;但只要存在数值转换(如 int、float),f-string 内置格式化必定胜过手动先str()后join()。 - 不可信用户输入的安全性:f-string 在编译时执行表达式求值,绝不能拼接来自外部不受信的用户输入作为代码字面量。在用户自定义报表或对外动态模板配置的特定场景下,即使
string.Template性能最慢,也是唯一具备安全沙箱特性的选择。 - 单行直接
f.write(f"...")的微观开销:如果每一次循环都单独执行一次f.write(),频繁的 Python-C 边界跨越和解释器锁交互会拖累整体吞吐,必须采用上述展示的分块(Chunking)批写入。
六、总结与生产级技术选型指南
综合以上基准测试数据、底层指令拆解与内存模型分析,我们在面对不同业务场景时,可以遵循如下决策导图快速选定最高性能的技术组合:
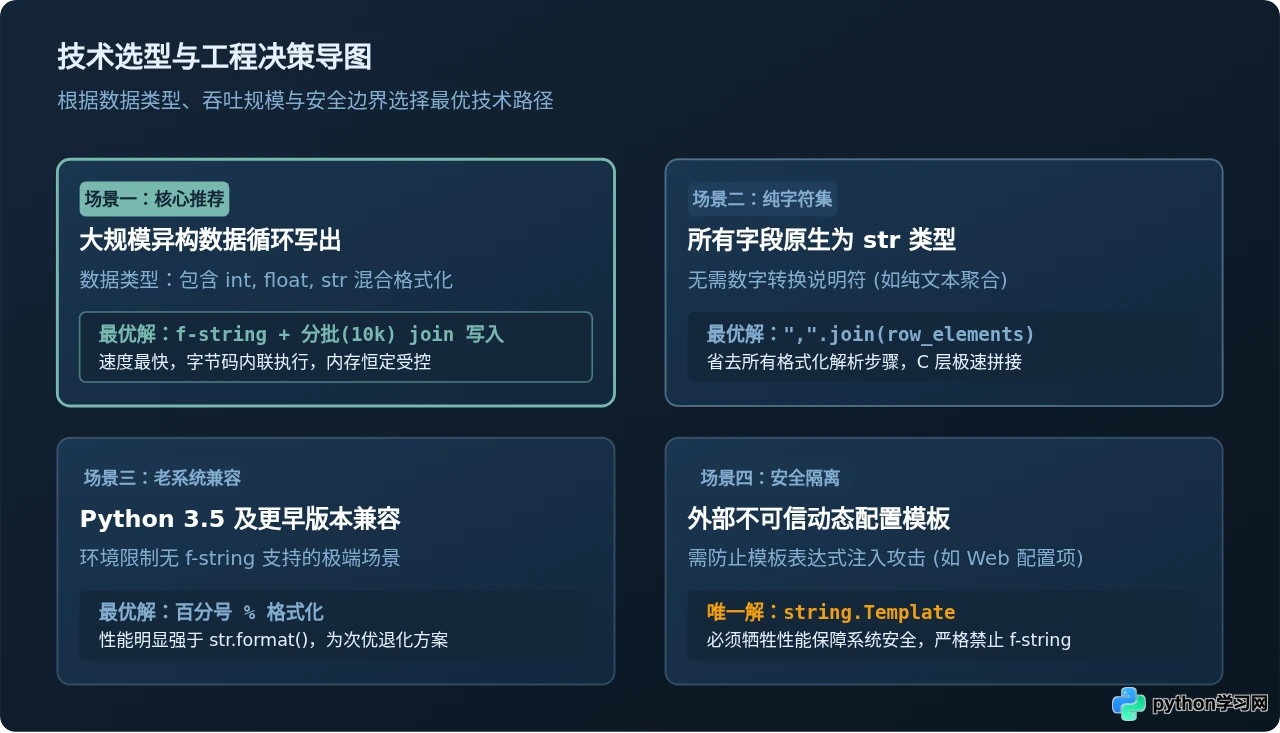
核心结论提炼
- 单次格式化性能排名:
f-string>% 格式化>str.format()>str.join(含转换)>>string.Template。在现代 Python(3.6+)中,f-string 在字节码层面直接由FORMAT_VALUE和BUILD_STRING指令支撑,无需方法查找与动态语法分析,综合执行速度最高。 - 工业输出吞吐法则:大规模数据循环输出的吞吐瓶颈绝不仅仅是格式化,更是内存管理与 I/O 调度。请始终坚持“f-string 单行生成 + 列表分块(5,000~10,000 条/批)+
''.join()+ 缓冲写盘”这一黄金范式,既能发挥出解释器的最高 CPU 处理极限,又能确保内存占用始终处于恒定的极低水位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









