

怎么从零搭建Python Web项目:Django博客系统源码解析
详解怎么从零搭建Python Web项目,围绕Django博客系统完整拆解虚拟环境搭建、工程目录结构、Post数据模型设计、路由分发、函数视图与类视图源码对比、模板渲染及常见问题排查。
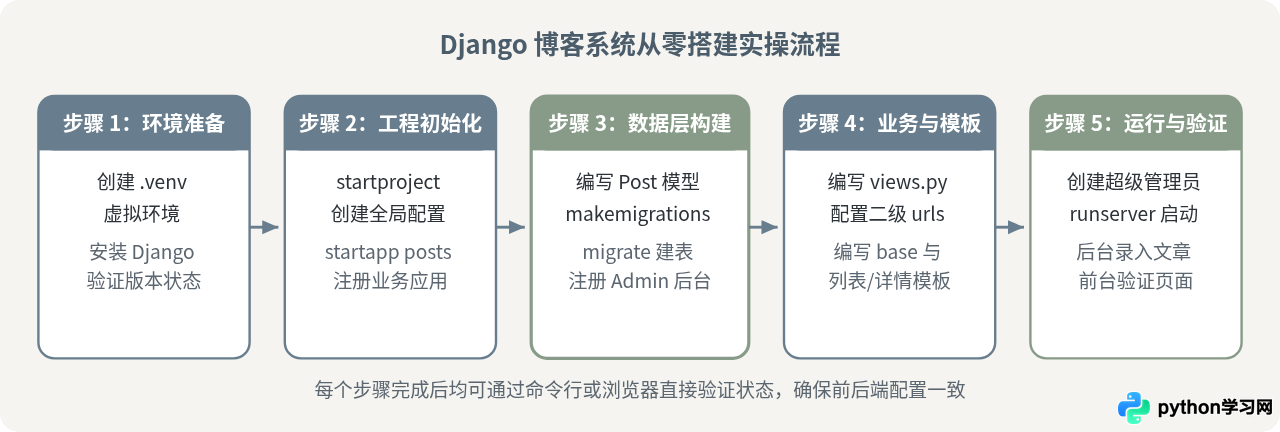
从零搭建一个可运行的 Python Web 博客项目,核心路径分为五步:创建隔离的 Python 虚拟环境并安装 Django、生成全局项目容器与业务应用、通过 ORM 模型定义文章表结构并执行数据库迁移、编写路由与视图处理 HTTP 请求、配合 HTML 模板完成页面渲染。本文将按实际搭建顺序逐步构建一个名为 blog_project 的完整博客系统,并逐文件解析配置、数据模型、路由分发、视图逻辑与模板渲染的源码联动机制。
一、环境准备与项目骨架初始化
搭建 Python Web 项目的第一步是为当前工程创建独立的虚拟环境,并生成 Django 工程目录与业务应用模块。这样做可以把当前博客项目的依赖包版本与操作系统全局 Python 环境隔离开,避免不同项目之间因 Django 版本差异产生冲突。
首先确保本地已安装 Python 3.10 及以上版本。打开系统终端,创建一个工作目录 django_blog 并进入该目录,使用 Python 内置的 venv 模块创建名为 .venv 的虚拟环境,激活后安装 Django:
mkdir django_blog
cd django_blog
python3 -m venv .venv

# macOS / Linux 激活虚拟环境
source .venv/bin/activate

# Windows PowerShell 激活虚拟环境(如在 Windows 下操作)
# .\.venv\Scripts\Activate.ps1

pip install "django>=4.2,<5.2"
python -m django --version5.1.2确认输出版本号后,在当前目录(django_blog)下执行项目初始化命令。注意命令末尾有一个英文句号 .,它的作用是把管理脚本 manage.py 直接生成在当前根目录,而不是额外多套一层同名文件夹:
django-admin startproject blog_project .
python manage.py startapp posts这两条命令分别完成了两个层级的初始化:startproject blog_project . 创建了负责全局配置与根路由调度的容器;startapp posts 创建了专门处理博客文章业务的独立应用(App)。Django 之所以将“项目(Project)”和“应用(App)”拆开,是因为一个 Web 站点除了文章发布模块外,后续还可能扩展评论、用户中心或标签统计模块,按应用拆分能够让各模块的数据模型和视图代码互不干扰。
此时还需要创建存放 HTML 模板的公共目录 templates/posts。创建完成后的完整目录结构如下:
django_blog/
├── .venv/                  # 独立虚拟环境目录
├── manage.py               # 命令行入口脚本(启动服务、数据迁移等)
├── blog_project/           # 项目全局配置包
│   ├── __init__.py
│   ├── asgi.py
│   ├── settings.py         # 全局设置(应用注册、数据库、模板路径、时区)
│   ├── urls.py             # 根路由配置文件
│   └── wsgi.py
├── posts/                  # 博客文章业务应用包
│   ├── __init__.py
│   ├── admin.py            # 后台管理配置
│   ├── apps.py
│   ├── migrations/         # 数据库迁移记录目录
│   ├── models.py           # 文章数据表模型定义
│   ├── tests.py
│   ├── urls.py             # 需手动新建:posts 应用的二级路由文件
│   └── views.py            # 业务逻辑与请求响应处理
└── templates/              # 需手动新建:全局模板目录
    └── posts/
        ├── base.html       # 需手动新建:公共母版文件
        ├── post_list.html  # 需手动新建:文章列表页模板
        └── post_detail.html# 需手动新建:文章详情页模板
修改全局配置文件 settings.py
新建的应用和模板目录不会自动生效,必须打开 blog_project/settings.py 完成三处核心配置:将 posts.apps.PostsConfig 加入 INSTALLED_APPS 列表;在 TEMPLATES 的 DIRS 中指定根目录下的 templates 文件夹;将语言和时区改为中文与北京时间。
from pathlib import Path

BASE_DIR = Path(__file__).resolve().parent.parent

# 1. 注册 posts 业务应用
INSTALLED_APPS = [
    "django.contrib.admin",
    "django.contrib.auth",
    "django.contrib.contenttypes",
    "django.contrib.sessions",
    "django.contrib.messages",
    "django.contrib.staticfiles",
    "posts.apps.PostsConfig",  # 新增:将博客文章应用纳入 Django 管理
]

# 2. 配置全局模板搜索目录
TEMPLATES = [
    {
        "BACKEND": "django.template.backends.django.DjangoTemplates",
        "DIRS": [BASE_DIR / "templates"],  # 修改:指向根目录下的 templates 文件夹
        "APP_DIRS": True,
        "OPTIONS": {
            "context_processors": [
                "django.template.context_processors.debug",
                "django.template.context_processors.request",
                "django.contrib.auth.context_processors.auth",
                "django.contrib.messages.context_processors.messages",
            ],
        },
    },
]

# 3. 数据库默认使用内置 SQLite,无需安装外部数据库服务即可直接运行
DATABASES = {
    "default": {
        "ENGINE": "django.db.backends.sqlite3",
        "NAME": BASE_DIR / "db.sqlite3",
    }
}

# 4. 设置中文界面与东八区时间
LANGUAGE_CODE = "zh-hans"
TIME_ZONE = "Asia/Shanghai"
USE_I18N = True
USE_TZ = TrueINSTALLED_APPS 中添加 "posts.apps.PostsConfig",后续执行数据库迁移命令时 Django 会直接忽略 posts/models.py 中的模型,且不会主动报错提示漏注册,只会显示 No changes detected。
二、Django MTV 架构与博客源码调用链路解析
在编写具体的业务源码前,先理清 Django 内部处理一次网页访问的真实文件调用顺序。Django 采用 MTV(Model-Template-View)架构模式:Model(数据模型)负责与数据库表交互,View(视图)负责接收 HTTP 请求、调用模型获取数据并决定返回哪个页面,Template(模板)负责将视图传入的数据填充到 HTML 结构中。在这三者之外,还有一个 URL 路由分发器(URLconf)承担“交通枢纽”的角色。
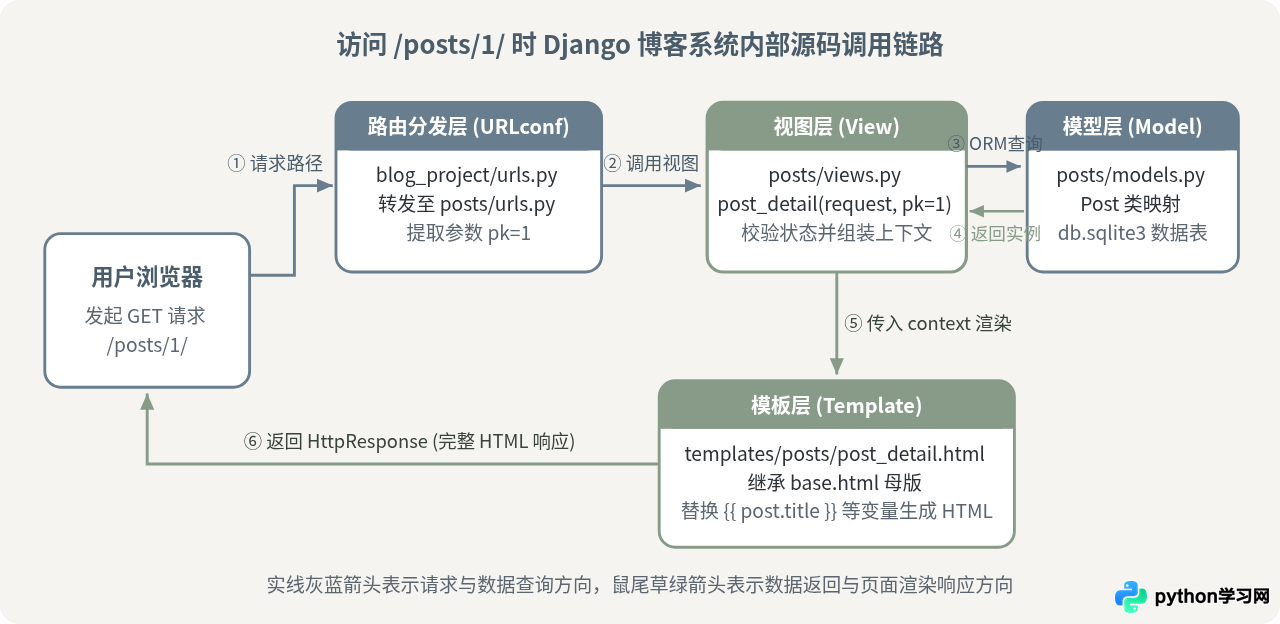
如上图所示,当读者在浏览器访问某篇博客文章地址(例如 http://127.0.0.1:8000/posts/1/)时,请求并不会直接打开某个 HTML 文件,而是依次流经以下源码文件:
- 根路由(
blog_project/urls.py)接收请求路径,通过include()函数把请求转交给博客应用的二级路由文件posts/urls.py。 - 二级路由(
posts/urls.py)匹配规则posts/<int:pk>/,从中提取出文章主键值pk=1,并调用视图函数post_detail(request, pk=1)。 - 视图(
posts/views.py)通过Post.objects查询接口向模型(posts/models.py)索取主键为 1 且状态为“已发布”的文章记录。 - 模板(
templates/posts/post_detail.html)接收视图传来的post对象,把标题、作者、发布时间和正文填入 HTML 标签,最终由视图打包为HttpResponse返回给浏览器。
三、数据模型层(Model)源码设计与数据库迁移
理解了调用链路后,我们先编写处于数据底座位置的 posts/models.py。在 Django 中,无需手写冗长的 CREATE TABLE SQL 语句,只需定义一个继承自 models.Model 的 Python 类,Django 的 ORM(对象关系映射)就会自动将其转换为数据库表。
一个实用的博客文章模型需要包含标题、正文、作者、创建时间、更新时间以及发布状态(区分草稿与正式发布)。打开 posts/models.py,写入以下完整源码:
from django.db import models
from django.contrib.auth.models import User
from django.urls import reverse


class Post(models.Model):
    class Status(models.TextChoices):
        DRAFT = "DF", "草稿"
        PUBLISHED = "PB", "已发布"

    title = models.CharField("文章标题", max_length=200)
    author = models.ForeignKey(
        User,
        on_delete=models.CASCADE,
        related_name="blog_posts",
        verbose_name="作者",
    )
    summary = models.CharField("文章摘要", max_length=300, blank=True)
    content = models.TextField("文章正文")
    status = models.CharField(
        "发布状态",
        max_length=2,
        choices=Status.choices,
        default=Status.DRAFT,
    )
    created_at = models.DateTimeField("创建时间", auto_now_add=True)
    updated_at = models.DateTimeField("更新时间", auto_now=True)

    class Meta:
        ordering = ["-created_at"]
        indexes = [
            models.Index(fields=["-created_at"]),
        ]
        verbose_name = "博客文章"
        verbose_name_plural = "博客文章"

    def __str__(self):
        return self.title

    def get_absolute_url(self):
        return reverse("posts:post_detail", kwargs={"pk": self.pk})
模型源码关键设计解析
- 外键关联与级联规则(
ForeignKey):author字段关联了 Django 内置的User用户模型。参数on_delete=models.CASCADE表示当某个作者账号被删除时,该作者名下的文章也随之清理;related_name="blog_posts"允许后续通过user.blog_posts.all()反向查询某位作者写的全部文章。 - 枚举状态控制(
Status(models.TextChoices)):使用枚举类限制status字段只能存储"DF"(草稿)或"PB"(已发布)。这样作者在后台撰写未完成的文章时可以保存为草稿,前台视图只筛选status=Post.Status.PUBLISHED的记录展示给读者。 - 元数据与索引(
class Meta):博客列表通常按发布时间倒序排列(最新发布的文章在最上面),因此设置ordering = ["-created_at"](减号代表降序),并为该字段建立数据库索引以提升列表查询效率。 - 标准 URL 反查方法(
get_absolute_url):通过reverse("posts:post_detail", kwargs={"pk": self.pk})动态生成文章详情页链接。这样在模板中只需调用{{ post.get_absolute_url }},即使未来修改了 URL 路径格式,也不必逐一改动 HTML 模板。
注册管理后台并执行数据库迁移
为了让博客拥有立即可用的文章发布后台,打开 posts/admin.py,将 Post 模型注册到 Django Admin,并配置列表展示列、状态过滤器和标题搜索框:
from django.contrib import admin
from .models import Post


@admin.register(Post)
class PostAdmin(admin.ModelAdmin):
    list_display = ["id", "title", "author", "status", "created_at", "updated_at"]
    list_filter = ["status", "created_at", "author"]
    search_fields = ["title", "summary", "content"]
    date_hierarchy = "created_at"
    ordering = ["status", "-created_at"]
保存上述两个文件后,回到终端执行迁移生成与同步命令,将 Python 类真正转化为 db.sqlite3 中的数据表:
python manage.py makemigrations posts
python manage.py migrateMigrations for 'posts':
posts/migrations/0001_initial.py
+ Create model Post
+ Create index posts_post_created_183a3b_idx on field(s) -created_at of model post
Operations to perform:
Apply all migrations: admin, auth, contenttypes, posts, sessions
Running migrations:
Applying contenttypes.0001_initial... OK
Applying auth.0001_initial... OK
...
Applying posts.0001_initial... OK其中 makemigrations 负责对比 models.py 的代码改动并生成迁移蓝图文件 posts/migrations/0001_initial.py;migrate 则读取该蓝图并在 SQLite 数据库中真正创建 posts_post 数据表。
四、视图层(View)与路由层(URLconf)源码解析与对比
数据表就绪后,接下来编写处理用户请求的视图文件 posts/views.py 和路由配置文件。在 Django 源码实践中,编写视图有两种主流方式:函数视图(Function-Based Views,简称 FBV)和通用类视图(Class-Based Views,简称 CBV)。理解两者的差异及适用场景,是读懂各类 Django 项目源码的关键。
两种视图实现方式在一致条件下的源码对比
假设我们要实现完全相同的两项博客功能:① 查询所有状态为“已发布”的文章并按每页 5 篇分页展示;② 根据文章主键 pk 查询单篇已发布文章详情,若文章不存在或仍为草稿则返回 404 状态码。下面展示两种方式在一致业务条件下的源码形态:
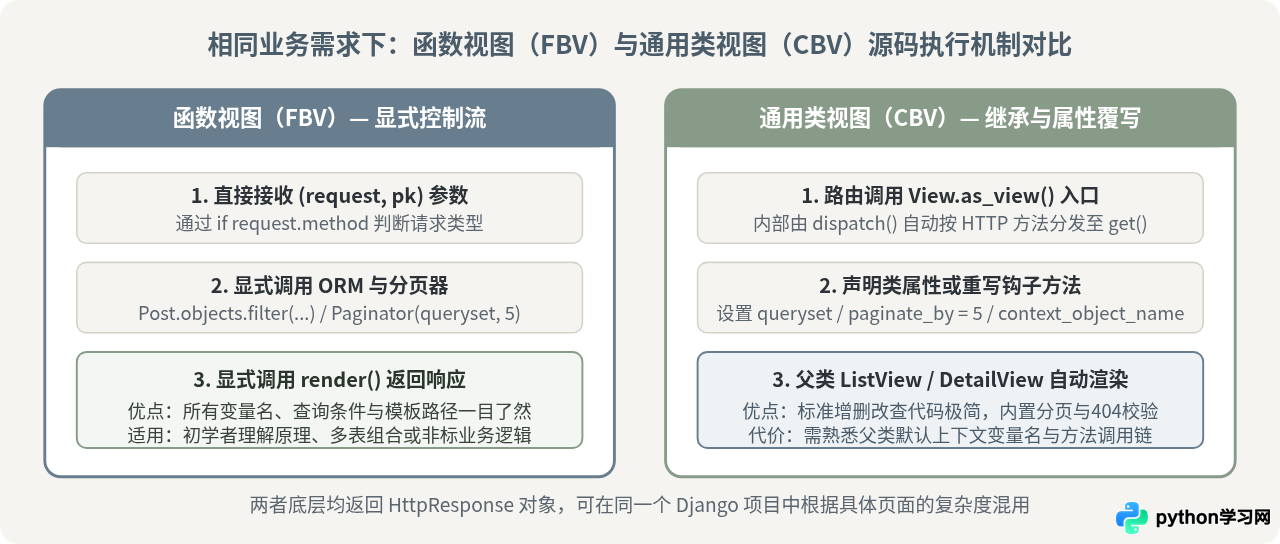
这两种写法为什么重要?因为在阅读开源 Django 项目或维护团队代码时,如果不知道 CBV 父类隐藏的默认规则(例如 ListView 默认把列表变量命名为 object_list,而 FBV 通常由开发者显式命名为 posts),很容易在修改 HTML 模板时出现页面空白却不报错的情况。
| 对比维度 | 函数视图(FBV) | 通用类视图(CBV:ListView / DetailView) |
|---|---|---|
| 数据获取与404处理 | 显式调用 Post.objects.filter(...) 与 get_object_or_404(),每一行逻辑直接可见。 |
通过定义 queryset 属性或重写 get_queryset(),DetailView 自动根据 pk 触发 404。 |
| 分页逻辑实现 | 需手动导入 Paginator,从 request.GET.get("page") 读取页码并传给模板。 |
仅需声明类属性 paginate_by = 5,父类自动向模板注入 page_obj 和 is_paginated。 |
| 模板变量命名影响 | 完全由 render(request, tpl, context) 中的字典键名决定,无隐式默认值。 |
若不显式指定 context_object_name,模板必须使用默认的 object_list 或 object。 |
| 选择依据与适用边界 | 适合初学阶段理清请求响应全链路,或单个页面需要同时聚合多个无关模型、处理复杂表单校验的场景。 | 适合结构高度标准的单模型列表页、详情页及标准增删改查页面,减少重复样板代码。 |
编写 posts/views.py 完整源码
为了让整个项目的每一处数据流转都清晰透明,我们在正文的实际运行代码中采用函数视图(FBV)实现列表页与详情页,并在下方附上等效的 CBV 对照写法供参考。打开 posts/views.py,写入以下完整代码:
from django.shortcuts import render, get_object_or_404
from django.core.paginator import Paginator
from .models import Post


def post_list(request):
    """博客文章列表视图:仅查询已发布文章,并使用 select_related 预加载作者信息"""
    queryset = Post.objects.filter(
        status=Post.Status.PUBLISHED
    ).select_related("author")

    paginator = Paginator(queryset, 5)  # 每页展示 5 篇文章
    page_number = request.GET.get("page", 1)
    page_obj = paginator.get_page(page_number)

    context = {
        "posts": page_obj,
        "page_obj": page_obj,
    }
    return render(request, "posts/post_list.html", context)


def post_detail(request, pk):
    """博客文章详情视图:按主键 pk 查找已发布文章,不存在或为草稿时返回 404"""
    post = get_object_or_404(
        Post.objects.select_related("author"),
        pk=pk,
        status=Post.Status.PUBLISHED,
    )
    return render(request, "posts/post_detail.html", {"post": post})
在上面的源码中,有两处细节直接关系到博客系统的运行安全性与数据库性能:
- 使用
select_related("author")避免 N+1 查询问题:由于模板中需要显示每篇文章的作者名{{ post.author.username }},如果不加select_related("author"),展示 5 篇文章除了查询 1 次文章表外,还会额外向用户表发起 5 次单独查询。加上该方法后,Django 会使用 SQL 的LEFT OUTER JOIN一次性把文章和作者信息查出。 - 在
get_object_or_404中同时限定status=Post.Status.PUBLISHED:如果只按pk=pk查询,知道 URL 规律的访客只需在地址栏尝试输入草稿文章的 ID(例如/posts/2/),就能越权看到尚未公开的草稿。将状态过滤条件一并放入查询中,访问草稿 ID 时会自动返回 404 页面。
如果你想对比了解通用类视图(CBV)如何实现完全等价的功能,可以参考下面这段等效代码(无需重复写入文件,仅作源码对照):
from django.views.generic import ListView, DetailView
from .models import Post


class PostListView(ListView):
    queryset = Post.objects.filter(status=Post.Status.PUBLISHED).select_related("author")
    context_object_name = "posts"  # 显式指定变量名为 posts,与 FBV 模板保持一致
    paginate_by = 5
    template_name = "posts/post_list.html"


class PostDetailView(DetailView):
    queryset = Post.objects.filter(status=Post.Status.PUBLISHED).select_related("author")
    context_object_name = "post"
    template_name = "posts/post_detail.html"
配置二级路由与根路由源码
视图函数写好后,需要在 posts 目录下新建 urls.py 文件,将具体的访问路径绑定到视图函数上,并声明应用命名空间 app_name = "posts":
from django.urls import path
from . import views

app_name = "posts"

urlpatterns = [
    path("", views.post_list, name="post_list"),
    path("posts//", views.post_detail, name="post_detail"),
]
接着打开全局路由文件 blog_project/urls.py,通过 include("posts.urls", namespace="posts") 将站点根路径接入博客应用的二级路由:
from django.contrib import admin
from django.urls import path, include

urlpatterns = [
    path("admin/", admin.site.urls),
    path("", include("posts.urls", namespace="posts")),
]
这里路由转换器 <int:pk> 会发挥双重作用:首先它只匹配正整数路径(如 /posts/1/),遇到非数字路径(如 /posts/abc/)会直接跳过匹配;其次它会自动把捕获到的字符串 "1" 转换为 Python 整数 1,作为关键字参数 pk=1 传给 views.post_detail。
五、模板层(Template)源码编写与母版继承
路由与视图接通后,最后一步是在根目录下的 templates/posts/ 文件夹中编写 3 个 HTML 模板文件。Django 模板引擎支持母版继承(Template Inheritance):把网站头部导航、页脚和公共 CSS 样式抽离到 base.html 中,列表页与详情页只需通过 {% extends "posts/base.html" %} 填入各自的业务区域,避免在多个页面重复维护相同的导航栏代码。
1. 公共母版文件:templates/posts/base.html
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>{% block title %}Django 个人技术博客{% endblock %}</title>
  <style>
    body {
      margin: 0;
      font-family: "PingFang SC", "Microsoft YaHei", sans-serif;
      background: #F5F4F0;
      color: #2C3237;
      line-height: 1.7;
    }
    header {
      background: #687D8D;
      color: #FFFFFF;
      padding: 18px 24px;
    }
    header .nav-container {
      max-width: 820px;
      margin: 0 auto;
      display: flex;
      justify-content: space-between;
      align-items: center;
    }
    header a {
      color: #FFFFFF;
      text-decoration: none;
      font-weight: 600;
    }
    .container {
      max-width: 820px;
      margin: 28px auto;
      padding: 0 20px;
    }
    .card {
      background: #FFFFFF;
      border-radius: 8px;
      padding: 24px;
      margin-bottom: 18px;
      border: 1px solid #E3E1DC;
    }
    .meta {
      font-size: 13px;
      color: #687D8D;
      margin-bottom: 10px;
    }
    a.post-link {
      color: #2C3237;
      text-decoration: none;
    }
    a.post-link:hover {
      color: #687D8D;
    }
    .pagination {
      margin-top: 20px;
      font-size: 14px;
    }
  </style>
</head>
<body>
  <header>
    <div class="nav-container">
      <a href="{% url 'posts:post_list' %}">我的 Django 博客</a>
      <a href="/admin/">管理后台</a>
    </div>
  </header>
  <div class="container">
    {% block content %}{% endblock %}
  </div>
</body>
</html>
2. 博客列表页模板:templates/posts/post_list.html
{% extends "posts/base.html" %}

{% block title %}文章列表 - Django 个人技术博客{% endblock %}

{% block content %}
  {% for post in posts %}
    <article class="card">
      <h2 style="margin-top: 0;">
        <a class="post-link" href="{{ post.get_absolute_url }}">{{ post.title }}</a>
      </h2>
      <div class="meta">
        作者:{{ post.author.username }} | 发布于:{{ post.created_at|date:"Y-m-d H:i" }}
      </div>
      <p>
        {% if post.summary %}
          {{ post.summary }}
        {% else %}
          {{ post.content|truncatechars:120 }}
        {% endif %}
      </p>
    </article>
  {% empty %}
    <div class="card">
      <p>当前还没有已发布的文章,请先登录后台发布第一篇博客。</p>
    </div>
  {% endfor %}

  {% if page_obj.paginator.num_pages > 1 %}
    <div class="pagination">
      {% if page_obj.has_previous %}
        <a href="?page={{ page_obj.previous_page_number }}">上一页</a>
      {% endif %}
      <span>第 {{ page_obj.number }} / {{ page_obj.paginator.num_pages }} 页</span>
      {% if page_obj.has_next %}
        <a href="?page={{ page_obj.next_page_number }}">下一页</a>
      {% endif %}
    </div>
  {% endif %}
{% endblock %}
3. 博客详情页模板:templates/posts/post_detail.html
{% extends "posts/base.html" %}
{% block title %}{{ post.title }} - Django 个人技术博客{% endblock %}
{% block content %}
<article class="card">
<h1 style="margin-top: 0;">{{ post.title }}</h1>
<div class="meta">
作者:{{ post.author.username }} |
发布时间:{{ post.created_at|date:"Y-m-d H:i" }} |
最后更新:{{ post.updated_at|date:"Y-m-d H:i" }}
</div>
<div class="post-body">
{{ post.content|linebreaks }}
</div>
<p style="margin-top: 28px;">
<a href="{% url 'posts:post_list' %}">← 返回文章列表</a>
</p>
</article>
{% endblock %}在模板源码中,有三个实用的模板标签与过滤器值得注意:
{% for post in posts %} ... {% empty %}:当数据库中还没有任何“已发布”文章时,会自动渲染{% empty %}分支中的友好提示,无需在外层额外包裹一层{% if posts %}。{{ post.content|truncatechars:120 }}:如果作者没有填写文章摘要summary,自动截取正文前 120 个字符并在末尾加上省略号作为列表预览。{{ post.content|linebreaks }}:将纯文本正文中存储的换行符\n安全地转换为 HTML 的<p>和<br>标签,同时默认保持对恶意脚本标签的 HTML 转义,防止 XSS 跨站脚本攻击。
六、启动服务、结果验证与常见问题排查
全部源码编写完成后,先在终端创建一个超级管理员账号,然后启动 Django 内置开发服务器:
python manage.py createsuperuser
python manage.py runserver
执行 createsuperuser 时,按终端提示依次输入用户名(如 admin)、邮箱(可直接回车跳过)和密码(输入密码时终端不显示星号,输完直接回车即可)。随后执行 runserver,看到以下输出即代表服务启动成功:
Watching for file changes with StatReloader
Performing system checks...

System check identified no issues (0 silenced).
November 04, 2026 - 20:30:00
Django version 5.1.2, using settings 'blog_project.settings'
Starting development server at http://127.0.0.1:8000/
Quit the server with CONTROL-C.
分步验证项目运行效果
- 验证空列表页状态:打开浏览器访问
http://127.0.0.1:8000/,页面顶部应显示“我的 Django 博客”导航栏,正文卡片显示“当前还没有已发布的文章,请先登录后台发布第一篇博客。”。 - 登录后台发布文章:点击右上角“管理后台”或直接访问
http://127.0.0.1:8000/admin/,输入刚才创建的管理员账号密码。进入后点击“博客文章”右侧的“增加”,填入文章标题、选择作者、输入多段正文,将“发布状态”下拉框从默认的“草稿”改为“已发布”,点击右下角“保存”。 - 验证列表与详情联动:再次访问
http://127.0.0.1:8000/,即可看到新发布的文章卡片;点击文章标题,浏览器地址跳转到http://127.0.0.1:8000/posts/1/,完整展示分段后的文章正文与发布时间。
常见报错与排查方法
-
报错 1:访问首页提示
TemplateDoesNotExist at / (posts/post_list.html)
原因与排查:首先检查blog_project/settings.py中TEMPLATES的"DIRS"是否已填写[BASE_DIR / "templates"];其次核对文件夹层级是否为django_blog/templates/posts/post_list.html,常见失误是漏建了中间的posts子目录,直接把 HTML 放在了templates/根目录下。 -
报错 2:后台已经保存了文章,但前台首页依然显示“当前还没有已发布的文章”
原因与排查:这是因为Post模型的status字段默认值为Status.DRAFT(草稿),而views.post_list中明确过滤了status=Post.Status.PUBLISHED。回到/admin/后台打开该文章,将“发布状态”修改为“已发布”后保存即可显示。 -
报错 3:渲染页面时提示
NoReverseMatch at / Reverse for 'post_detail' not found
原因与排查:检查posts/urls.py顶部是否声明了app_name = "posts",以及路由项中name="post_detail"的拼写是否与models.py中reverse("posts:post_detail", kwargs={"pk": self.pk})完全一致。
七、Django 博客系统源码结构与核心要点总结
回顾整个搭建与源码解析过程,一个结构清晰的 Django Web 项目并不是把所有代码堆砌在单个文件里,而是通过明确的职责划分让配置、数据、路由、视图和模板各司其职。下图汇总了本项目全部核心源码文件的职责边界、关键配置点与上线前的检查项:
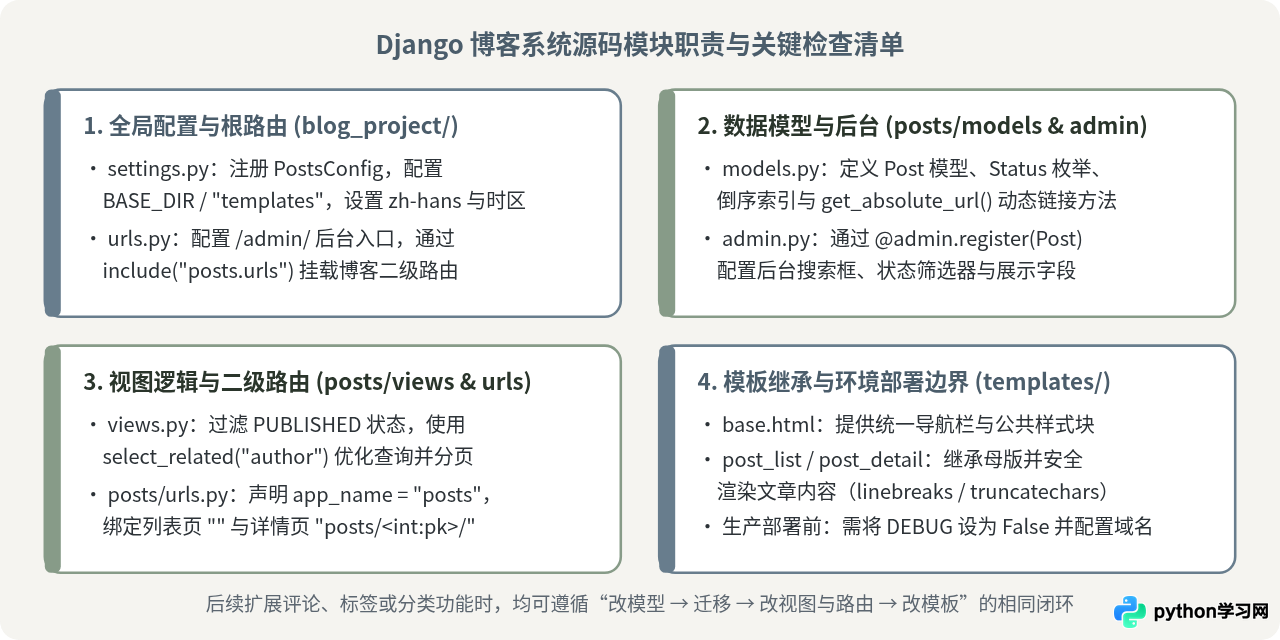
最后需要注意适用环境边界:本文中使用的 python manage.py runserver 与默认的 DEBUG = True 配置专门用于本地开发与调试。如果后续需要将这套博客系统部署到公网云服务器,应当在生产环境中将 settings.py 里的 DEBUG 设为 False,在 ALLOWED_HOSTS 中填入实际域名或服务器 IP,并通过环境变量读取 SECRET_KEY,同时使用 Gunicorn 或 uWSGI 配合 Nginx 托管服务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









