

Python长语句换行报错SyntaxError怎么解决
在Python中编写长语句时直接回车往往会导致SyntaxError报错。本文详解Python物理行与逻辑行解析机制,提供标准定位排查步骤,对比隐式换行与显式换行的适用场景,并给出长条件、长函数传参、长链式调用等典型场景的规范改写示例与避坑清单。
在编写 Python 代码时,当单行逻辑表达式过长、函数入参较多或者链式调用过深时,我们常常需要换行以保证代码整洁度并符合 PEP 8 规范。然而很多初学者直接按下回车换行后,终端往往会抛出 SyntaxError: invalid syntax、SyntaxError: unexpected EOF while parsing 或 SyntaxError: unexpected character after line continuation character。造成这一报错的本质原因,是 Python 词法分析器默认将物理换行符视作单条语句的终结标志。解决该问题的标准方法只有两类:优先采用基于圆括号的“隐式行拼接”,以及在特定限制下使用反斜杠的“显式行拼接”。
一、换行报错的原因与三步定位法
Python 解释器在读取源代码时区分“物理行”(Physical Line)与“逻辑行”(Logical Line)。在文本编辑器中,每按一次回车键就产生一个物理行。默认情况下,Python 认定一个物理行就是一个独立的逻辑语句。如果一个长语句在中间断开,而解释器在断开处未发现合法的未闭合界定符或续行标记,词法分析器就会直接在此处尝试闭合语句,进而因为缺少操作数、参数或括号而触发 SyntaxError。
面对此类报错,不需要盲目重写整段代码,可以遵循以下三步进行快速定位与排查:
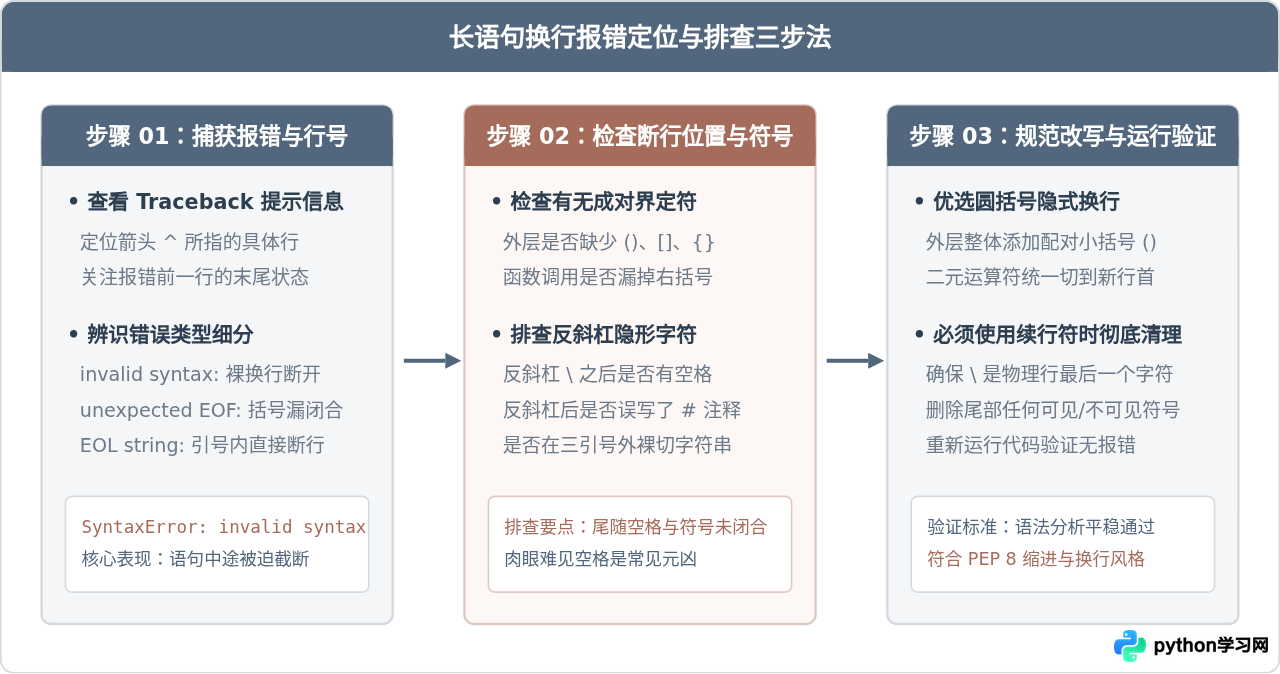
常见的报错典型代码表现如下:
# 错误示例 1:在二元运算符后直接裸换行(无外层括号)
total_score = user_basic_score + exam_score + bonus_score
              + extra_activity_score
# 终端报错:
# SyntaxError: invalid syntax (指向第二行的加号)

# 错误示例 2:反斜杠后无意输入了一个空格
total_score = user_basic_score + exam_score + \
              bonus_score
# 终端报错:
# SyntaxError: unexpected character after line continuation character
二、核心解决方法:隐式换行与显式换行
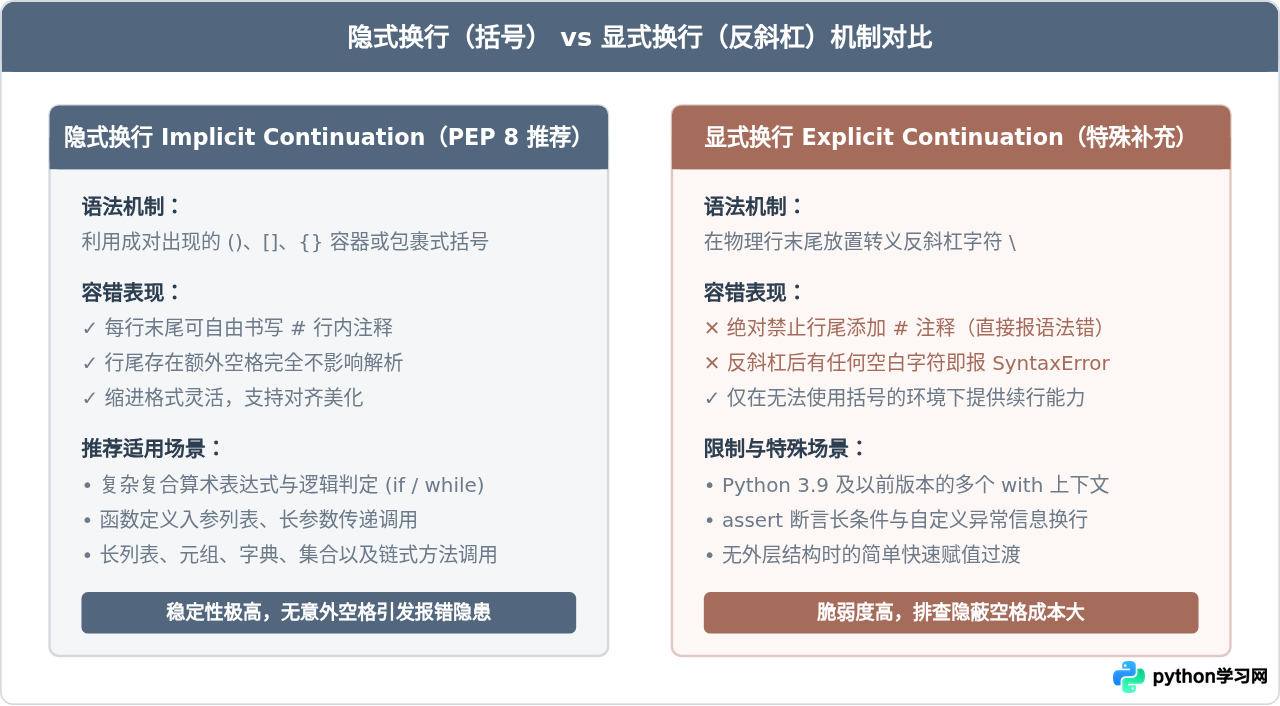
Python 官方语法规格说明书中定义了两种行拼接机制:隐式行拼接(Implicit Line Joining)和显式行拼接(Explicit Line Joining)。
1. 隐式换行(推荐使用)
在圆括号 ()、方括号 [] 或花括号 {} 内部,Python 允许跨越多行编写表达式,而不需要使用任何续行符。这是 PEP 8 官方风格指南强烈推荐的做法。只要最外层存在未闭合的括号,解释器在扫描到对应的闭合括号前,会将所有包含的物理行默默缝合成一个完整的逻辑行。
2. 显式换行(慎重使用)
在语句末尾显式添加反斜杠 \,通知解释器“下一行是当前行的延续”。虽然反斜杠在语法上完全有效,但它极其脆弱:反斜杠必须是该物理行的绝对最后一个字符。如果在反斜杠之后存在任何不可见的空格、Tab 制表符,或者紧随了 # 注释,Python 都会直接抛出 SyntaxError。
三、长语句典型场景的规范改写模式
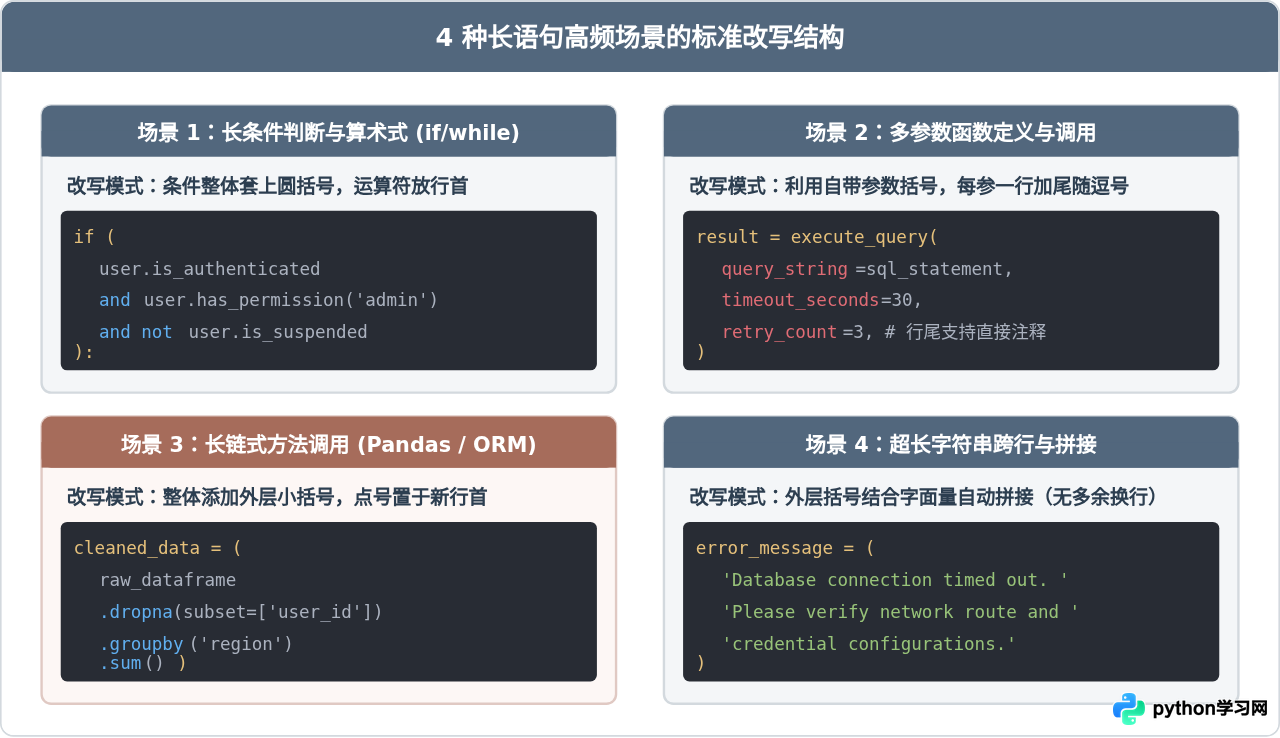
在实际开发中,引发换行报错的长语句主要集中在四大常见场景。通过采用标准改写模式,可以彻底避免 SyntaxError 并提升可读性。
1. 算术长表达式与条件判断
在编写数学公式或 if 长判断时,千万不要在表达式裸露状态下直接换行。正确的做法是用小括号将整体条件包裹起来,并遵循 PEP 8 推荐:二元运算符(如 +、-、and、or)置于新行行首,这样从垂直视觉上就能清楚辨识每个条件的结合逻辑:
# 规范推荐:外层括号包裹,运算符位于行首
is_eligible = (
    user.age >= 18
    and user.credit_score > 650
    and not user.has_pending_violation
)
2. 长参数列表函数调用
函数的括号本身天然就构成了隐式行拼接环境。换行时只需注意:将每个实参单独放在一行,每行参数末尾保留逗号,最后一个参数后也可以保留尾随逗号(Trailing Comma)。这样后续增减参数时 git diff 也更清晰:
# 规范推荐:参数独立成行,末尾保留尾随逗号
response = requests.post(
    url="https://api.example.com/v1/orders",
    headers={"Authorization": f"Bearer {token}"},
    json={"order_id": order_id, "amount": total_amount},
    timeout=10,
)
3. 链式调用(Pandas / ORM)
数据分析库中经常出现长串链式过滤和分组。若直接在点号 . 前后裸换行,解释器常报错。将整个调用用一对小括号包裹后,点号 . 就能自然放在新行开头对齐:
# 规范推荐:外层括号包裹,点号置于行首
summary = (
    sales_df.query("status == 'completed'")
    .filter(items=["user_id", "payment_amount", "created_at"])
    .groupby("user_id")
    .agg({"payment_amount": ["count", "sum"]})
)
4. 长字符串分行
很多开发者在跨行写长字符串时,习惯直接按回车,从而遭遇 SyntaxError: EOL while scanning string literal。此时若使用三引号 """,文本中会真实引入换行符和缩进空格,常常污染目标格式。最优雅的做法是使用圆括号包裹多个相邻的独立单引号或双引号字符串字面量,Python 编译期会自动将它们无缝合并为单行字符串:
# 编译期自动拼接,最终变量中绝不含多余的换行符与缩进空格
prompt_text = (
    "请结合以上业务上下文,"
    "输出符合格式要求的 JSON 数据,"
    "不要添加任何额外的自然语言解释。"
)
四、常见误区与避坑自查清单
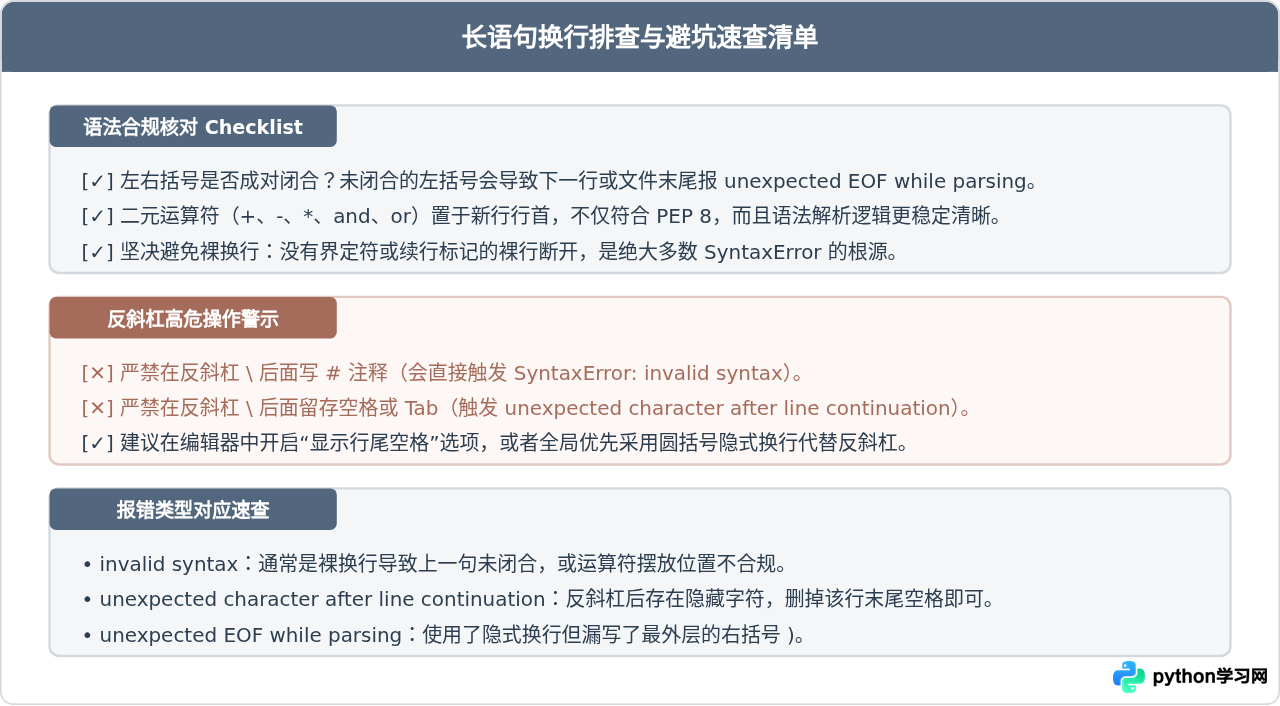
如果在长语句换行时漏掉了闭合括号,Python 解释器在报错时标记的往往并不是漏写括号的那一行,而是随后代码的某一行甚至文件的最后一行(
unexpected EOF while parsing)。当你看到文件末尾报语法错,但末尾代码完全正常时,请务必回头检查前面使用多行换行的长语句,确认是否括号成对闭合。
五、总结
处理 Python 长语句换行报错,根本原则在于明确通知词法分析器“当前逻辑行尚未结束”。在平时的工程实践中:
- 能使用圆括号
()包裹的场景(包括长条件判定、数学公式、链式调用),一律优先使用圆括号隐式换行; - 尽量避免使用反斜杠
\,以绝后患地消除由于编辑器不可见空格导致的隐蔽报错; - 长字符串采用外层小括号结合相邻字面量自动拼接,杜绝在单双引号内直接回车带来的
EOL报错。
只要掌握并遵循上述规律,在换行维护代码美观的同时,就能彻底告别各类令人困惑的 SyntaxError。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









