

AI音乐生成效果不理想怎么办?参数调整与迭代策略

很多创作者在初次尝试AI音乐生成时,常遇到节奏拖沓、乐器混杂或风格完全跑偏的情况。这并非工具能力不足,而是输入指令与模型理解之间存在偏差。通过精确控制提示词结构和关键参数,可以将随机性转化为可控的创作变量,快速逼近理想听感。
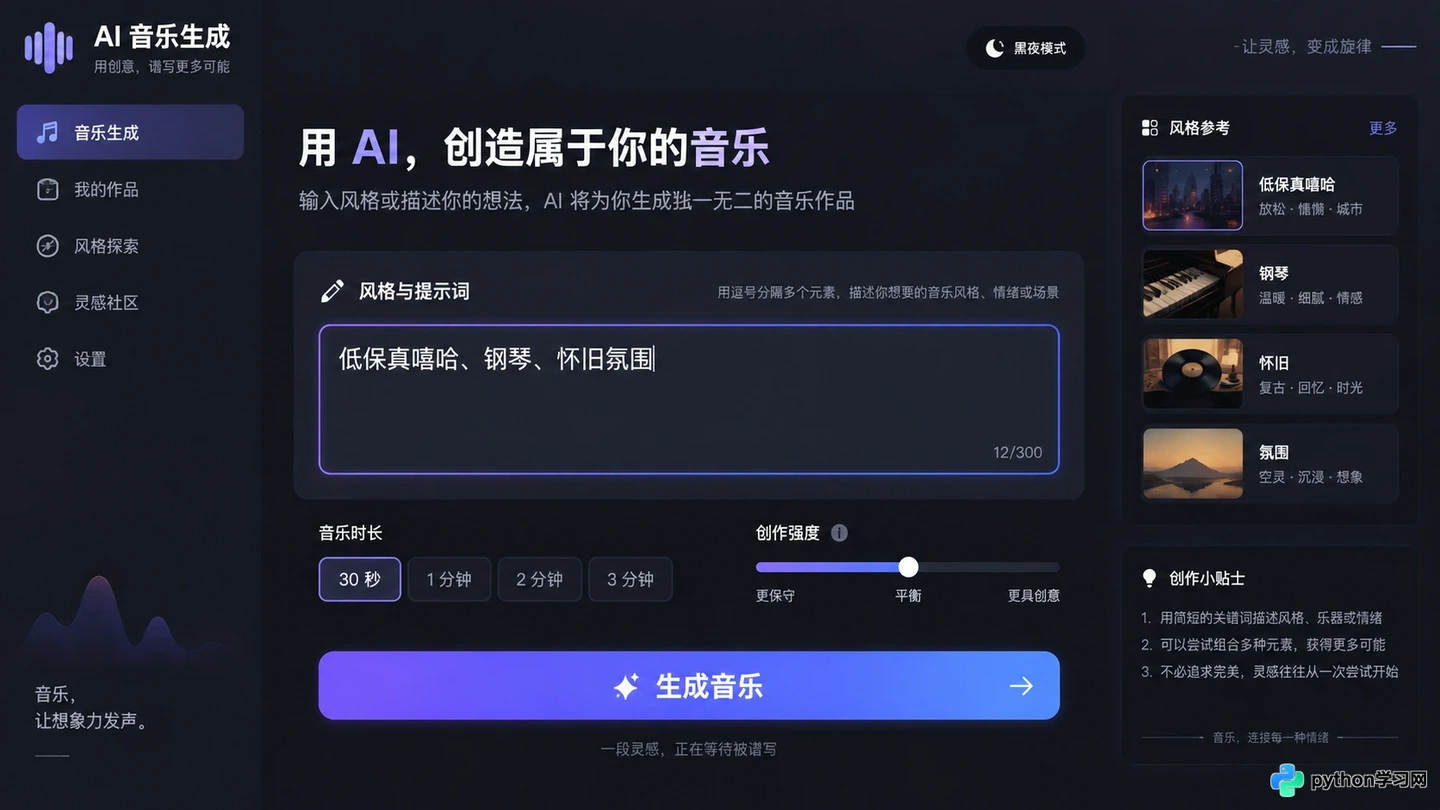
AI音乐生成工具的主界面,突出显示风格与提示词输入框
AI音乐模型通常基于大量元数据训练,对特定流派标签、乐器名称和结构术语敏感。要获得可编辑、高质量的结果,核心在于将模糊的“好听”转化为模型可识别的具体指令,并通过小步快跑的迭代方式验证效果。
确保你已注册并登录主流AI音乐平台(如Suno或Udio),准备好清晰的创作意图,包括目标流派、情绪基调及大致结构。
- 结构化提示词编写
不要只输入“一首快乐的歌”。有效的提示词应包含三个层级:流派风格、乐器配置和情绪氛围。在【Style of Music】或【Prompt】输入框中,先定义核心流派,如“Lo-fi Hip Hop”或“Cyberpunk Synthwave”。
接着补充具体乐器,例如“piano, soft drums, vinyl crackle”。最后添加情绪形容词,如“melancholic, nostalgic”。这种分层描述能让模型更准确地锁定音色库。避免使用抽象词汇如“震撼”,改用“heavy bass, epic orchestral”等具体声学特征描述。
- 启用自定义模式与歌词控制
默认模式下,AI会自动生成歌词和旋律,容易导致结构不可控。切换到【Custom Mode】(自定义模式),可以分别填写【Lyrics】和【Style】。
若需要纯音乐,在歌词栏输入 [Instrumental] 标签。若需人声,使用元标签明确结构,如 [Verse](主歌)、[Chorus](副歌)、[Bridge](桥段)。这些标签能强制模型按照标准歌曲结构生成,避免段落混乱。观察生成预览,确认人声进入点是否与预期一致。
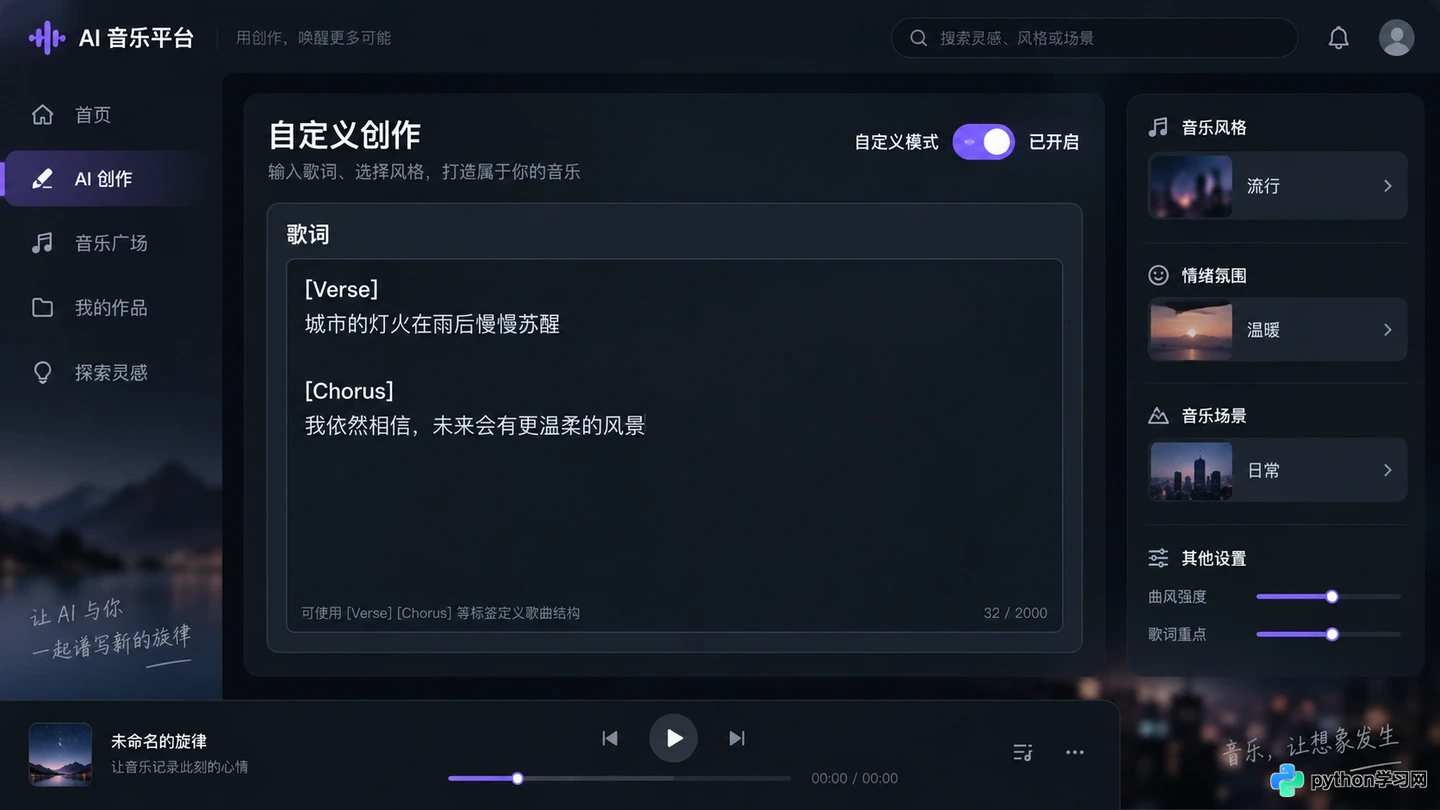
自定义模式中用于控制歌曲结构的元标签设置
- 调整关键生成参数
部分平台提供高级设置。关注【Temperature】(温度值)或类似创造性参数。较低数值(如0.5-0.7)会使输出更稳定、符合常规逻辑,适合背景乐;较高数值(如0.8-1.0)会增加意外性和创意,适合探索新风格。
若发现节奏不稳,检查是否启用了【High Quality】或【Extended】选项。虽然耗时增加,但高采样率能显著减少音频伪影和截断感。对于Suno V3等模型,确保勾选最新模型版本以获得更好的连贯性。
- 分段生成与延伸策略
一次性生成长曲往往导致后半段质量下降。采用“种子延伸”策略:先生成前30-60秒的核心片段,满意后使用【Extend】功能继续创作。
在延伸时,保持风格标签一致,但可微调情绪。例如,主歌部分用“calm, acoustic”,延伸副歌时改为“energetic, full band”。这样能确保整首曲子在音色统一的前提下,拥有动态变化。每次延伸前,试听上一段的结尾,确保过渡自然。
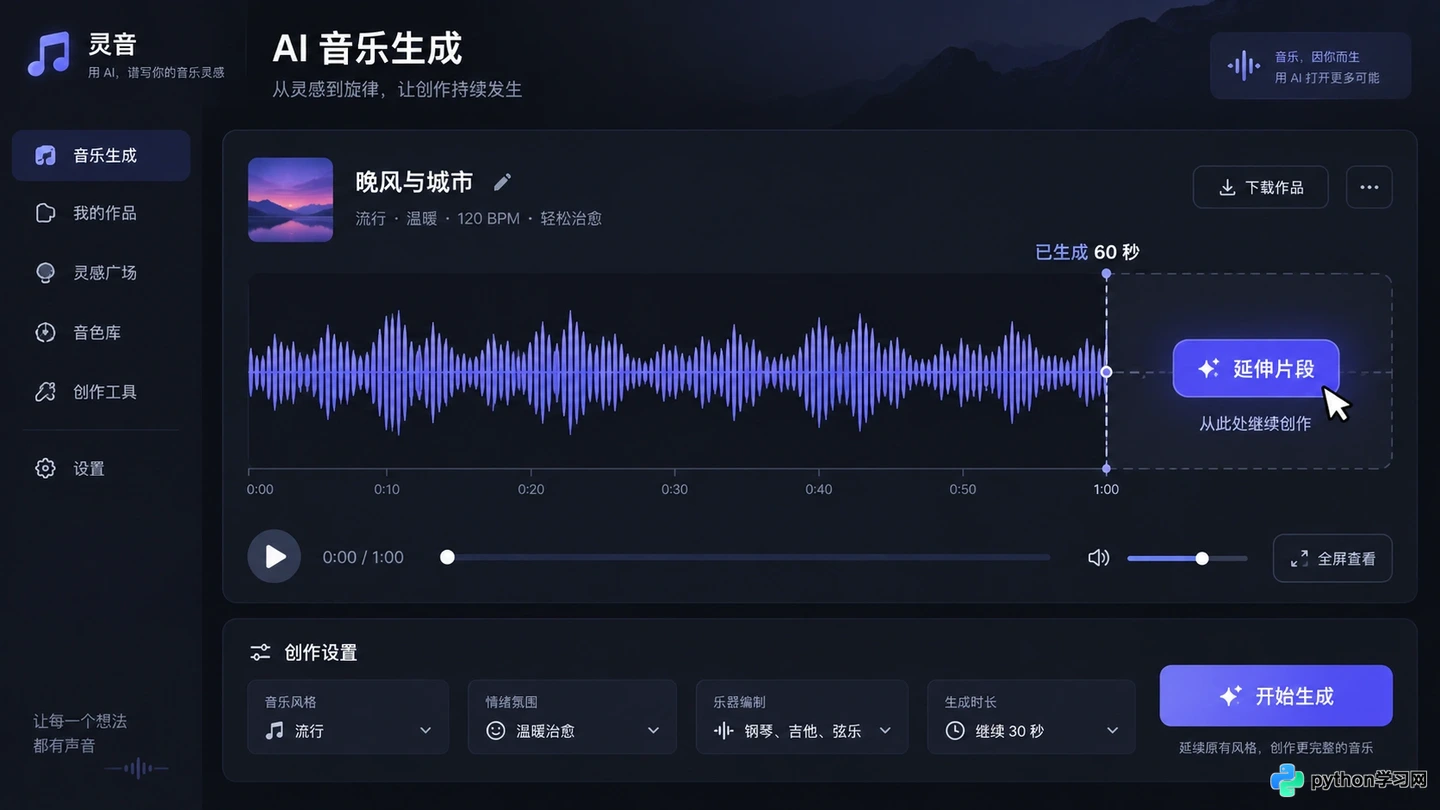
基于已有片段使用Extend功能进行续写操作
- 迭代优化与负面提示
如果生成结果包含不想要的元素,如嘈杂的人声或错误的乐器,需在下一轮迭代中明确排除。虽然部分平台暂无直接的负面提示词框,但可在风格描述中加入对比限定,如“no vocals, minimal percussion”。
保留每次生成的Seed(种子值)或链接。当某次结果接近理想但有小瑕疵时,基于该种子进行微调比重新随机生成更高效。记录哪些标签组合产生了最佳贝斯线或鼓点,建立个人的提示词库。
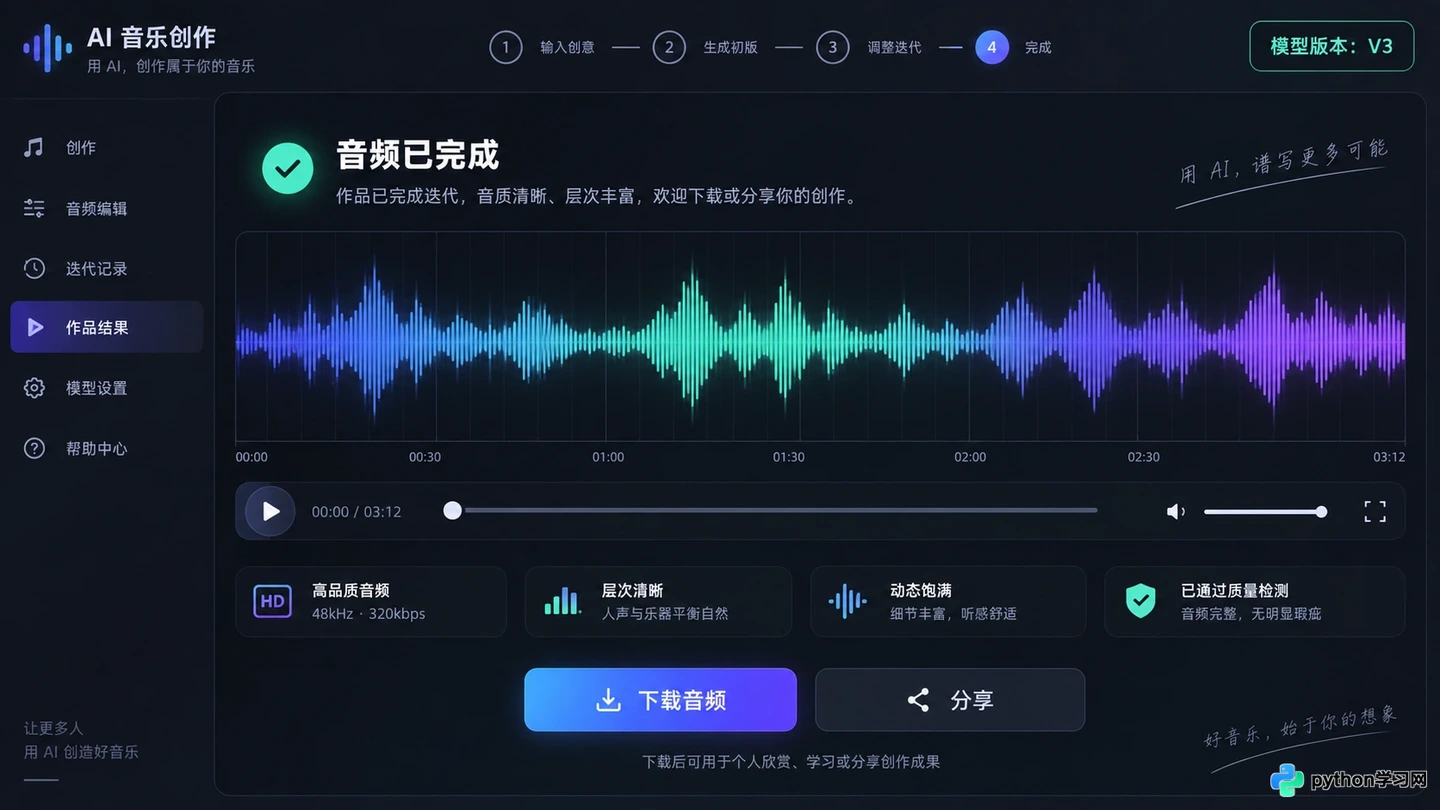
完成迭代后的高质量音频波形及导出界面
完成上述调整后,再次生成并对比前后差异。理想的AI音乐工作流不是一次命中,而是通过“生成-监听-修正提示词-再生成”的循环,逐步剥离不需要的元素,保留核心创意。保存最终满意的项目文件,以便后续进行后期混音或母带处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









