

Python高频面试题汇总:核心概念与常见陷阱解析

在 Python 技术面试中,面试官往往不会停留在表面语法的熟练度上,而是通过一系列典型代码题来考查候选人对底层运行机制的理解。本文围绕变量与对象模型、可变默认参数生命周期、深浅拷贝边界、作用域与闭包延迟绑定,以及 GIL 全局解释器锁五大高频核心考点,通过完整代码示例、执行过程推导与清晰图解,逐一还原问题本质并给出工程实践中的标准避坑策略。
一、变量与对象模型:变量是“标签”而非“盒子”
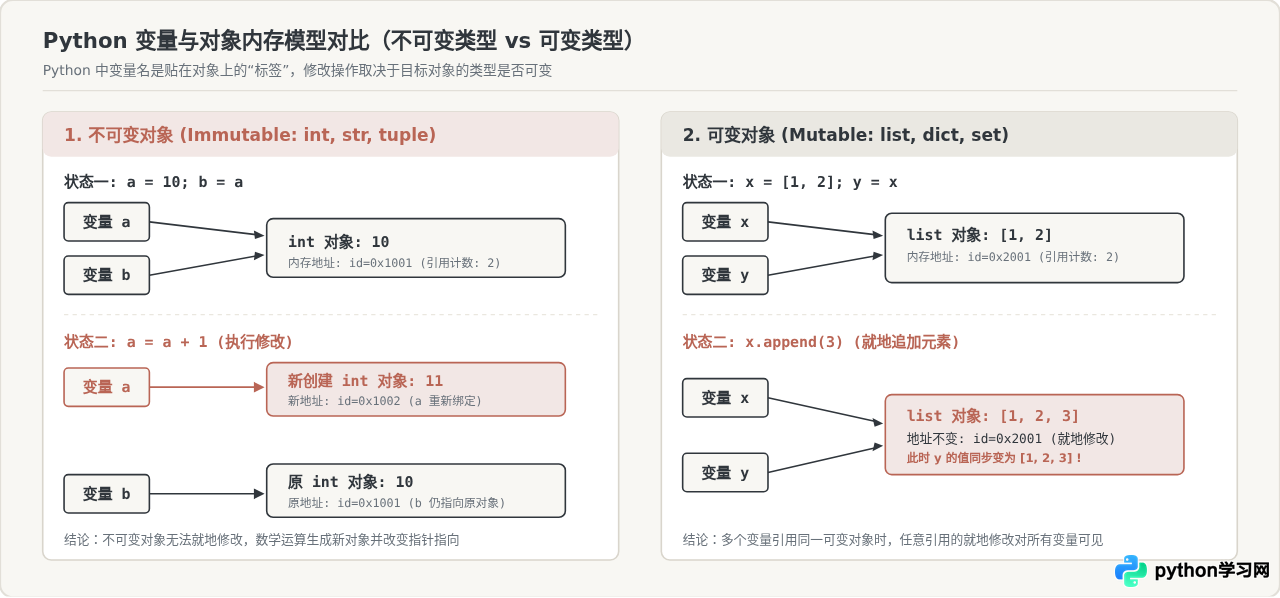
许多初学者或从 C/C++ 转过来的开发者容易认为“变量是容纳数据的内存格子”。但在 Python 的对象模型中,所有数据都以对象形式存在于内存堆中,变量仅仅是贴在对象上的名称标签(引用)。这个机制决定了 Python 参数传递的本质既不是纯粹的按值传递(Pass by Value),也不是按引用传递(Pass by Reference),而是按对象引用传递(Pass by Object Reference / Call by Sharing)。
1. is 与 == 的核心区别
面试中经常以此切入考查内存机制:
==比较的是值是否相等(Value Equality),内部通过调用对象的__eq__()方法实现。is比较的是对象身份(Object Identity),即两个变量是否指向同一块物理内存地址(等价于id(a) == id(b))。
# 示例 1:值相等但内存对象独立
a = [1, 2, 3]
b = [1, 2, 3]

print(a == b)  # 输出: True (内容相同)
print(a is b)  # 输出: False (各自在内存堆中申请了独立列表容器)
print(id(a), id(b))  # 输出两个不同的十六进制内存地址
2. 可变对象 vs 不可变对象
Python 数据类型严格区分为两大类:
- 不可变类型(Immutable):包括
int、float、str、tuple、frozenset、bytes。一旦创建,其内存中的值不可改变。当对变量重新赋值或进行加减运算时,Python 不会修改原内存,而是申请新对象并将变量名重新绑定。 - 可变类型(Mutable):包括
list、dict、set以及自定义类实例。对象内部的状态允许就地修改(In-place mutation),内存地址id()保持不变。
CPython 解释器在启动时预先分配了 [-5, 256] 范围内的所有整数对象,并对符合特定规则的短字符串开启全局驻留池。因此 x = 100; y = 100; x is y 会返回 True,但这属于 CPython 解释器的底层实现细节与内存优化,在工程业务逻辑中判断数值相等绝不能使用 is,必须使用 ==。
二、经典陷阱一:可变对象作为函数默认参数
这是 Python 面试与日常代码审查中最臭名昭著的陷阱之一。考官通常给出类似下面的代码并询问输出:
def append_to(element, target=[]):
    target.append(element)
    return target

print(append_to(1))   # 预期: [1]    实际: [1]
print(append_to(2))   # 预期: [2]    实际: [1, 2] ?!
print(append_to(3))   # 预期: [3]    实际: [1, 2, 3] ?!
1. 陷阱的本质原因:定义期绑定
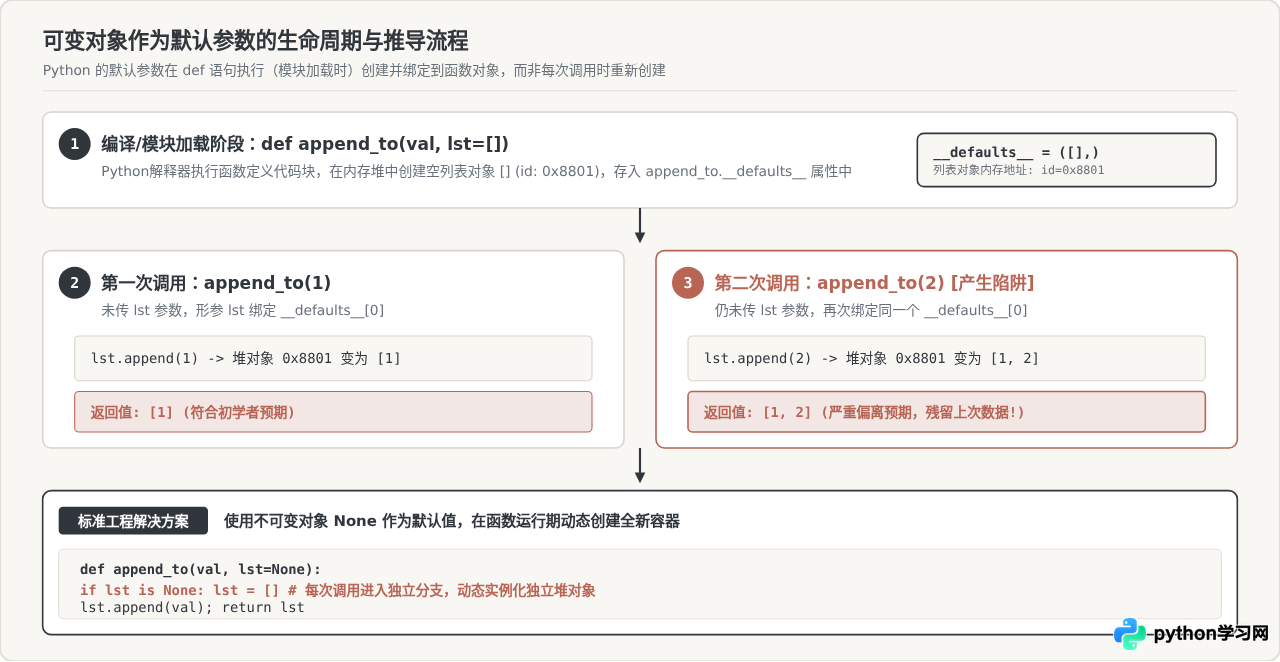
产生这一现象的根本原因在于:Python 中的默认参数是在 def 语句执行(即模块加载/函数定义期)时求值并初始化的,而不是在每次调用函数时计算。
当 Python 解释器编译并载入该函数时,它创建了一个函数对象,并将默认参数列表求值后的对象绑定到该函数的 __defaults__ 属性上(若为关键字参数则在 __kwdefaults__ 中)。因为列表是可变对象,每次不传参调用 append_to() 时,形参 target 都会指向同一个已存在于内存堆中的列表,导致历次调用的状态被持续累积。
2. 标准工程方案:None 占位与动态初始化
工程中必须严格避免在函数签名中使用 []、{} 或 set() 作为默认值,统一遵循“以 None 守卫,函数内按需惰性初始化”的规范:
def append_to(element, target=None):
    if target is None:
        target = []
    target.append(element)
    return target

print(append_to(1))  # 输出: [1]
print(append_to(2))  # 输出: [2] (完全隔离)
三、经典陷阱二:浅拷贝与深拷贝的层级边界
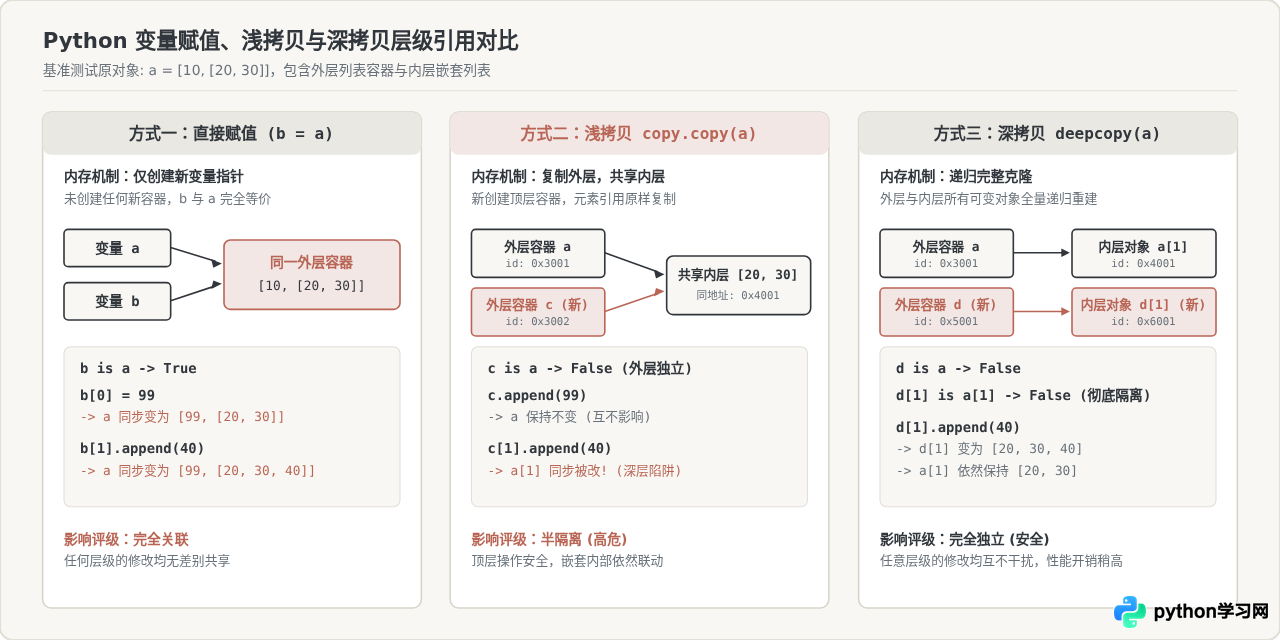
复制数据结构时,直接赋值、浅拷贝与深拷贝的处理层级截然不同:
- 直接赋值(
b = a):不产生任何新对象,仅给原对象新增一个变量别名。 - 浅拷贝(
copy.copy(a)或a[:]/dict.copy()):在内存中申请一个新的顶层容器对象,但容器内部包含的子元素仍沿用原有的内存引用。 - 深拷贝(
copy.deepcopy(a)):递归地复制所有嵌套的层级容器与可变对象,完成全链路的数据解耦与彻底隔离。
当对纯不可变对象(如纯字符串或全由数字组成的元组 (1, 2, 3))调用 copy.copy() 甚至 copy.deepcopy() 时,Python 为了节约内存并提升效率,不会创建新对象,而是直接返回原对象的引用(即 copy.copy(t) is t 为 True)。只有当不可变元组内部包含了列表等可变对象时,deepcopy() 才会真正递归克隆。
四、作用域机制与闭包延迟绑定
Python 查找变量时严格按照 LEGB 规则 依次由内向外检索:
- L(Local):当前函数内部的局部作用域。
- E(Enclosing):嵌套函数的外层闭包函数作用域。
- G(Global):当前模块文件级别的全局作用域。
- B(Built-in):Python 内置模块作用域(如
len、range、print等)。
1. 经典的循环闭包延迟绑定(Late Binding)
这是一道区分度极高的高频面试题:
# 考题代码:
funcs = [lambda x: i * x for i in range(4)]
results = [f(2) for f in funcs]
print(results) # 初学者往往猜测 [0, 2, 4, 6],实际输出却是 [6, 6, 6, 6]!产生这一结果的原因在于:Python 闭包中捕获的是外层变量的引用(通过 cell 对象),而不是创建函数当时该变量的值。当列表推导式完成时,循环变量 i 的最终值停留在了 3。后续在第二行真正调用 f(2) 执行计算时,函数才会去查找 i 的当前值,此时每个闭包函数查到的 i 都已经是 3,因此计算结果全是 3 * 2 = 6。
2. 两种标准解决方案
要打破延迟绑定,使每个闭包记录循环当时的值,有两种常见做法:
# 方案 A(最常用):利用默认参数在定义期立即求值的特性完成变量固化
funcs_fixed_a = [lambda x, i=i: i * x for i in range(4)]
print([f(2) for f in funcs_fixed_a])  # 输出: [0, 2, 4, 6]

# 方案 B:使用 functools.partial 偏函数提前绑定实参
from functools import partial
funcs_fixed_b = [partial(lambda multiplier, x: multiplier * x, i) for i in range(4)]
print([f(2) for f in funcs_fixed_b])  # 输出: [0, 2, 4, 6]
五、并发核心:GIL 工作原理与高频追问
GIL(Global Interpreter Lock,全局解释器锁)是 CPython 解释器层面设置的一把互斥锁。它的历史成因是 CPython 的内存垃圾回收依赖引用计数机制(Reference Counting),若允许多个线程在原生内核层面并发操作同一对象,引用计数的增减将极易产生竞争破坏内存一致性,因此 CPython 通过 GIL 保证同一进程中同一时刻只有一个线程能够持有解释器执行字节码。
1. “既然有 GIL,Python 多线程能保证线程安全吗?”
答案是坚决不能! 这是面试官最常设下的陷阱。GIL 仅仅保护了 CPython 解释器自身的内部状态不被损坏,而绝不等于业务代码层面的原子性与线程安全。
例如最基础的累加语句 count += 1,在 Python 字节码层级并不是单步原子操作,而是包含了 4 条指令:LOAD_GLOBAL(读取当前值)、LOAD_CONST(加载常数 1)、INPLACE_ADD(加法计算)、STORE_GLOBAL(写回变量)。CPython 在执行字节码过程中,会定期在线程之间释放并重新竞争 GIL(默认每执行 5 毫秒,可通过 sys.getswitchinterval() 查询)。如果线程在读取之后、写回之前被系统强制调度,变量的更新就会被覆盖丢失:
import threading

count = 0

def unsafe_increment():
    global count
    for _ in range(100000):
        count += 1  # 非原子操作,多线程竞争下必然小于 200000

t1 = threading.Thread(target=unsafe_increment)
t2 = threading.Thread(target=unsafe_increment)
t1.start(); t2.start()
t1.join(); t2.join()
print(f"最终计数: {count}") # 实际输出往往在 130000 ~ 170000 之间波动!标准防范:多线程写入共享变量时,必须显式使用 threading.Lock() 互斥锁包围临界区。
2. 并发场景工程架构选型
| 场景类别 | 任务特征 | GIL 的实际影响 | 推荐并发模型 |
|---|---|---|---|
| I/O 密集型 | 网络爬虫、文件读写、数据库查询、API请求 | 极小。线程发起系统底层阻塞调用(如 socket 等待)时会自动主动释放 GIL,其它线程继续执行 | threading 多线程 或 asyncio 异步协程 |
| CPU 密集型 | 图像/音视频编码、大型矩阵运算、加密解密 | 极大。多线程不仅无法利用多核 CPU,反而因频繁争夺 GIL 和线程上下文切换导致性能比单线程更慢 | multiprocessing 多进程架构 或 采用 C/Rust 扩展释放 GIL |
| 高并发长连接 | Websocket 消息推送、高频微服务网关 | 无损。单线程事件循环驱动,避免系统级线程栈内存开销 | asyncio + uvloop 异步非阻塞事件驱动 |
六、高频知识点与避坑策略全景总结
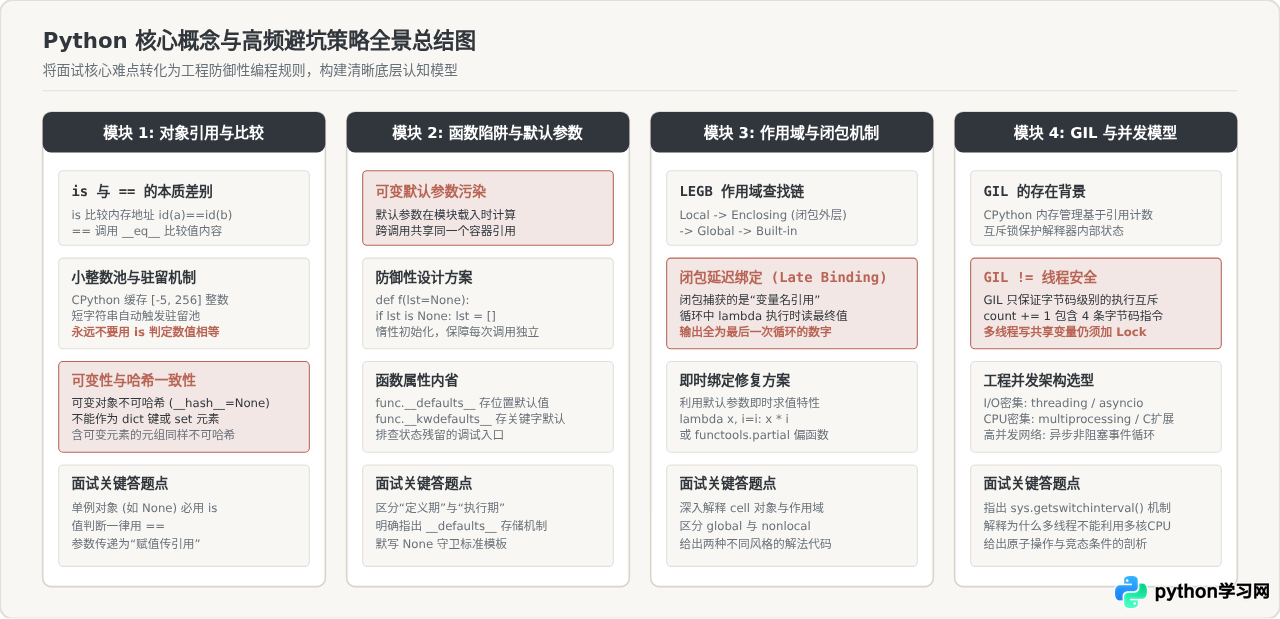
综上所述,Python 面试中的核心概念考查并不是孤立的技术条目,而是相互交织的完整体系:
- 从变量标签模型出发,能够透彻解释为何不可变类型不会产生修改副作用、以及为何参数传递是传对象指针;
- 从函数对象与编译期初始化出发,能够自然理解可变默认参数为何在跨调用间残留数据;
- 从容器指针与嵌套层级出发,能够精准划定浅拷贝与深拷贝的隔离边界;
- 从词法作用域与环境捕获出发,能够轻松化解循环闭包中的延迟求值问题;
- 从CPython 引用计数与字节码调度出发,能够清晰阐明 GIL 的保护边界与多线程并发的数据竞争根源。
掌握这套底层认知模型,不仅能在面试中清晰还原底层因果,更能在日常工程实践中写出健壮、严谨且无防御漏洞的高质量代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









